本文讨论的是 unidbg 在单 Unicorn 后端下模拟多线程 native 程序时的通用架构问题。文中的命令、线程、回调与返回值均为抽象示例,不对应任何具体应用、接口或业务数据。
本文是前文《给 unidbg 装上原生时间片:如何让模拟器真正跑起多线程》的后续。
第一版多线程方案,也就是先前的那篇文章,解决了一个最直观的问题:让主任务和 native worker 能够按原生时间片轮流执行。它把 unidbg 从依赖 syscall、JNI 回调等偶然 safe point 的协作式调度,推进到了可被指令预算稳定打断的抢占式轮转模型。
但是,“线程能够轮流执行”并不等于“多个 native 调用能够安全重叠”。当两个 Java 宿主线程向同一个 Unicorn backend 提交命令时,系统还必须回答一组更困难的问题:当前是谁在驾驶 backend?新调用如何请求通行权?旧调用暂停后由谁恢复?返回值和终态属于哪一代调用?一个调用释放 JNI local reference 时,会不会清掉另一个暂停调用仍在使用的对象?
第二版方案开始引入 backend owner、handoff、command result 和超时终态,但仍然保留了大量全局槽位和按命令号匹配的兼容逻辑。它能处理部分交接,却不能从结构上保证调用身份、运行上下文、JNI 引用和终态的一致性。
最终方案不再把“任务”作为唯一调度单位,而是在任务之上增加一层 invocation-owned runtime:每次 native 调用都拥有独立的 record、generation、submitter、carrier、immutable context、terminal 和 JNI reference scope。backend 仍然只有一个,但调用可以通过 FIFO 申请、在真实 safe point 交接、暂停和显式恢复。
可以把整个演进理解成一座单车道桥:
项目地址:6dcK9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6Y4K9i4c8Z5N6h3u0Q4x3X3g2U0L8$3#2Q4x3V1k6E0P5s2W2G2L8#2u0Q4x3V1k6#2L8X3W2V1j5X3N6Q4x3X3c8E0N6h3I4@1K9i4c8Z5M7X3g2S2k6r3W2F1k6H3`.`.
第一版方案的核心是 native timeslice:C 后端在执行一定数量的 guest 指令后主动停止,Java 调度器保存当前任务上下文,再从可运行队列中选择下一个任务。
这层设计是必要的。没有可预测的 native safe point,worker 能否获得执行机会只能依赖 syscall、hook 和回调返回,调度器只能不断猜测“什么时候适合切线程”。时间片让停止变成了 backend 的明确能力。
但第一版解决的是“车能不能轮流开”,并没有建立调用级交通规则。
第一版的完整执行链可以概括为:
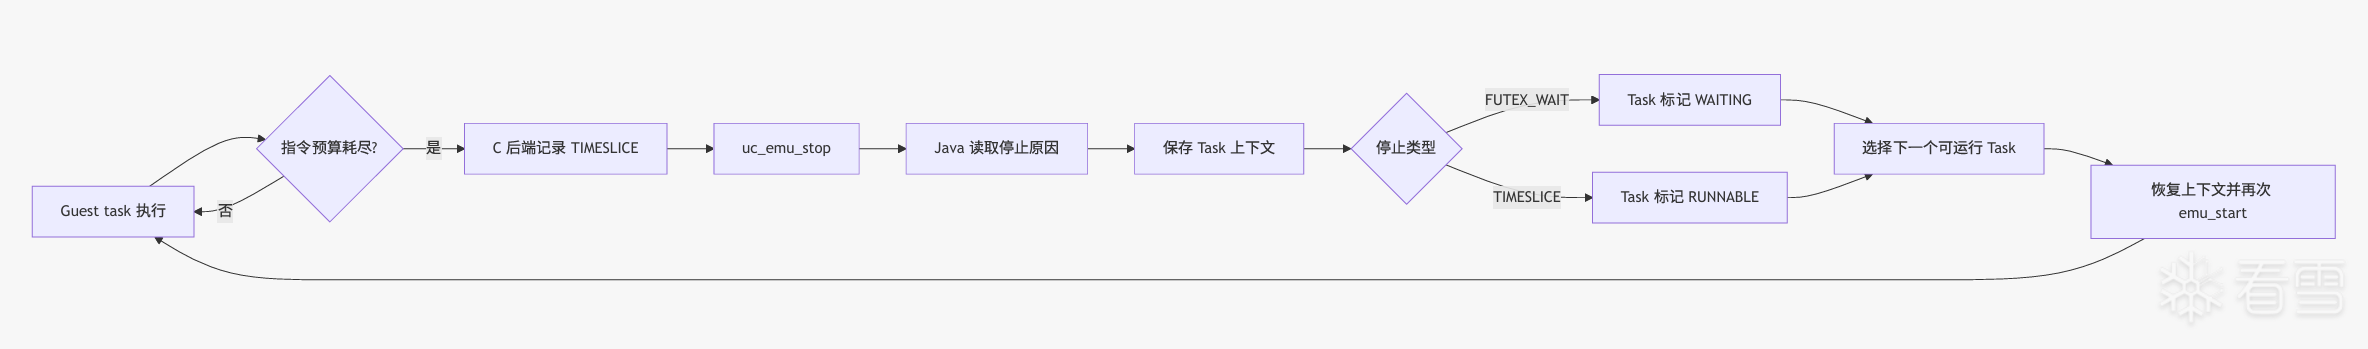
这张图里的主语始终是 Task。它能说明“下一个运行谁”,却无法说明“这次 native 调用是谁、它的结果最终交给谁”。这正是后续重构需要补上的一层。
回头看第一版,最容易产生的误解是:既然后来又做了架构重构,那么 native timeslice 一定是失败的。事实恰好相反——时间片本身完成了它被设计出来时的目标。
第一版已经能够验证以下能力:
这些验证共同证明了一件重要的事:单 backend 上的 native 协作式抢占已经成立。
问题在于,我们当时把这个结论向前多推了一步:
这两句话看起来只差半步,实际上跨过了一条架构边界。Task 是调度对象,回答“下一刻让谁运行”;Invocation 是调用对象,回答“谁发起、谁拥有、谁等待、谁接收结果、谁负责清理”。时间片只解决了前一个问题。
如果把单 backend 比作一座一次只能通过一辆车的窄桥,第一版做成的是红绿灯系统:灯会按时变色,车辆也确实能够交替前进。但“能轮流上桥”不代表整套运输系统已经完备,因为我们还没有为每一趟运输建立独立车牌、货单、收件人和签收回执。
所以,第一版“不对”的准确含义不是时间片算法错误,而是:它通过的是 Task 轮转验收,却被拿去承担 Invocation 正确性。验收标准比真实并发语义窄了一层。
真正推动第二次重构的,不是某一处代码看起来不够优雅,而是一组无法用“线程没有跑起来”解释的运行现象。
一次 native 调用进入调度器后,可以把承载其入口和最终返回的主任务称为 carrier,把它依赖的其他 guest 任务称为 worker。最初的怀疑很自然:carrier 长时间没有返回,是不是 worker 根本没有创建、没有入队,或者一直没拿到 backend?
被动观测很快排除了这种简单解释:
换句话说,桥上的红绿灯在工作,辅助车辆也确实开上了桥。可是 carrier 仍可能长期停留在这样的状态:
这四个条件同时出现非常关键:
如果只看最终的 timeout,很容易得到“native 卡死”的结论;如果把任务状态、实际派发和 wall time 放在一起看,则会发现另一种可能:调用不是不可返回,而是在单 backend 的共享调度窗口中,还没获得足够且连续的推进机会,宿主就先取消了观察。
这也是第一版第一次暴露出模型裂缝的地方。Task 状态都可以是“合法的”,调度器也可以持续工作,但调用整体仍然没有一个能够被准确描述的生命周期。
发现“worker 已运行、carrier 未完成”以后,不能立刻把原因归结为 timeout,更不能直接把 timeout 调大。我们按照因果位置逐层排除了几类解释。
任务创建记录、可运行状态变化、实际 dispatch 以及上下文前进共同证明,worker 已经进入了调度闭环。若 worker 从未运行,修复方向应当是线程创建或队列;但证据表明问题发生在这些步骤之后。
另一个直觉方案是提高 carrier 优先级,甚至只调度 carrier,期待它尽快返回。受控验证显示,carrier 会走到一个真实的依赖等待点:它需要某个 worker 更新共享状态或释放同步条件才能继续。
这说明 carrier 和 worker 不是“主任务与噪声”的关系,而是协作关系。只让 carrier 上桥,就像让货车独占桥面,却把负责开闸的工程车永远挡在桥外;货车得到再多绿灯,也只能停在关闭的闸门前。
因此,问题不能通过“把所有时间都给 carrier”解决。正确目标不是单方面提高优先级,而是在保持协作推进的同时,准确计算每一次调用的等待与完成。
我们还验证过几类常见调度补丁的思路:提高某类任务的选中概率、改变队列顺序、强制把任务改成可运行、在退出前增加 drain window,或者在观察即将到期时再多跑若干轮。
这些措施可能改变某一次运行的路径,甚至让失败出现得更早或更晚,但它们无法建立稳定的因果闭环:
一个补丁只有在回答“它修复了因果链的哪一层”时才是架构修复。仅仅让某次运行通过,不足以证明队列顺序或某个额外唤醒就是根因。
被动记账揭示了最容易被忽视的一点:第一版的 deadline 是全局 wall deadline。它从宿主进入调度循环时开始计时,期间不只计算 carrier,还计算全部 worker、任务切换、hook、日志和 Java 调度开销。
因此,在一个看起来很长的观察窗口里,carrier 实际得到的 backend 执行份额可能只占一小部分。宿主时钟已经走完,并不等于 carrier 真正执行了同等时长。
一次受控验证中,放宽全局 wall cutoff 后,原本被判定超时的 carrier 能够继续推进并自然返回。这证明了一个必要事实:旧 deadline 确实可能杀死一个本来可返回的调用。
但这仍不意味着“把固定时间改大”就是最终答案。换一组任务组合或调度顺序后,同一个固定额度仍可能失效。于是结论进一步收窄:
这一区分很重要。延长 timeout 是参数修补;把提交等待、backend 占用、协作调度和调用终态分别建模,才是语义修复。
把上述证据合在一起,可以得到比“调度偶尔超时”更准确的结论:
第一版真正缺少的,是位于 Java 提交者与 native Task 之间的调用实体。没有这个实体,系统无法可靠回答:
桥梁系统的故障至此才算被准确描述:红绿灯没有坏,车辆也不是完全不动;缺的是每趟运输的身份与所有权。没有车牌,两辆同型号车会混淆;没有独立货单,后车可能覆盖前车的货物记录;没有准确回执,桥中央的一次临时停车也可能被误报成“已经送达”;所有车辆共用一个倒计时,则某辆车还没真正开多久,就可能因为别的车占桥而被判超时。
后面四个缺陷,正是这个总问题在代码中的具体表现:调度单位只有 Task、预算使用全局 wall time、交通状态与调用终态混淆,以及 JNI local reference 仍采用 VM-wide 生命周期。
第一版调度器认识的是 Task:
每个任务具有 RUNNABLE、WAITING、FINISHED 等状态,调度器按照时间片和 futex 状态轮转任务。
但是一次 Java 调用和一个 Task 并不总是一一对应:
如果系统只有 Task,没有 Invocation,就无法精确表达:
第一版常见的做法是以 command number 或当前 active command 作为关联键。这在严格串行时看起来可用,一旦允许重叠就会产生歧义。
桥梁比喻中,这相当于调度器能识别“卡车”“轿车”,却没有车牌和通行证。两辆同型号车辆先后上桥,收费站只能看到它们都叫 command-X,无法判断回执应该交给谁。
第一版通常以一次调度循环的 wall clock 作为命令预算:
这段逻辑简单,但它混合了至少四类时间:
在真机上,多个线程能够并发运行;在单 backend 中,它们必须串行分享同一段 wall time。如果把总 wall time 直接当成 carrier 的生命周期预算,就可能出现如下情况:
从宿主视角看已经过去 8 秒,从 carrier 视角看它可能刚执行了一小部分。于是 timeout 不再表达 native 生命周期,只表达“所有任务共同消耗了多少宿主时间”。
简单增大 timeout 也不能成为可靠修复,因为不同运行中的 worker 数量、等待路径和共享状态演化不同。某次运行在更大窗口内自然返回,并不能证明某个固定数值就是正确的 native 生命周期。
时间片方案增加了多种 backend 停止原因:
这解决了“emu_start() 为什么返回”的问题,但上层很容易错误地把“backend 已停止”理解成“native 命令已完成”。
实际上:
一辆车在桥中央被红灯拦停,不等于它已经抵达终点。EMU_STOP 应该触发保存现场和交接,而不是生成一个“已完成”的业务回执。
传统顺序 JNI 调用常用一个 VM 级 local-reference map:
顺序执行时,这个模型没有问题:调用开始时加入参数对象,调用结束时统一清理。
重叠调用下会出现严重污染:
这种错误很隐蔽,因为它最终可能表现为 JNI 空指针、数组访问失败,甚至被兼容路径包装成普通数值返回。表面看像业务参数错误,根因却是 local reference 的生命周期仍停留在单调用时代。
第二版在时间片调度之上增加了 command service:引入 backend owner、handoff、显式 result、watchdog 和 command terminal。相比第一版,它已经意识到“谁在驾驶 backend”和“命令是否完成”是两个独立问题。
但这一版仍处于从 task-centric 向 invocation-centric 过渡的中间态。许多正确概念被放进了全局字段、单槽 Map 和日志字符串中,因此能够处理单次交接,却难以保证重叠调用的严格隔离。
第二版通常会增加类似字段:
这些字段分别解决某一个局部问题:
问题在于它们没有被同一个 invocation 对象统一拥有。一次调用的身份散落在:
当同一 command 发生第二次调用时,旧 terminal、旧 watchdog 或旧 fault 可能覆盖新调用。代码不得不增加越来越多的判断:
这类字符串匹配只能作为 legacy fallback,不能作为并发所有权模型。
第二版常见的数据结构是:
它隐含了一个假设:同一 command 同时最多只有一条记录。
现实中可能出现:
如果新 record 覆盖旧 record,会产生三类问题:
即使把 value 改成 List<Record>,如果消费时仍只传 command,也无法解决歧义。真正的索引必须包含 carrier identity、generation 和 original submitter。
为了在 carrier 创建前预留 generation,第二版可能采用:
顺序调用时没有问题,并发 caller 会看到一个危险窗口:reservation 已进入 FIFO,但 carrier 尚未绑定。此时另一个线程也可能 reserve、bind 或取消,导致 FIFO head 与真实 carrier 关系不稳定。
如果 command、context、generation 和 carrier 不是在同一把 dispatcher 锁内建立,就不能保证:
第二版虽然有 reservation 概念,但还没有把 atomic create-and-bind 作为生产路径的不变量。
许多 native stub、JNI router 或环境模拟逻辑需要知道当前执行的 command、origin 和 detail。第二版往往通过全局字段或 System property 暴露:
问题是 caller 创建了 B,不等于 B 已经取得 backend admission。A 可能仍在 guest 中运行。如果 B 在提交时就写全局字段,A 的 JNI stub 会突然读到 B 的上下文。
ThreadLocal 也不是完整答案,因为 guest task、backend owner 和 Java submitter 不一定运行在同一个宿主线程上。运行上下文必须绑定 logical admission,而不是绑定“最近一次谁写了变量”。
第二版虽然定义了 CommandResult,但 caller 仍可能这样工作:
这里的 value 来自一次 native 调用,result 来自全局槽位。重叠时二者可能不属于同一 generation。
真正的 exact outcome 必须是一个不可拆分的整体:
任何一项无法匹配,都不应构造成功 outcome。
传统兼容路径经常在 native exception 后返回 -1:
随后 scheduled task 看到一个非空 Number,可能把它记录为:
这样 caller 会认为命令自然完成,只是返回了一个特殊数值。对 tracked invocation 而言,这是错误的终态传播。异常必须成为该 invocation 自己的 FAULT,不能借用 legacy 数值返回通道。
最终重构不再继续增加全局 gate、优先级或 timeout 例外,而是改变系统的核心抽象:
Task 负责“代码在哪里继续执行”,Invocation 负责“这次调用是谁、拥有什么、最终结果交给谁”。
最终方案以六条不变量为设计起点。
Unicorn backend 不是可重入服务。任何时刻只有一个 owner 可以调用 emu_start() 或继续 guest 执行。其他 submitter 必须通过 handoff 请求获得 logical admission。
调用身份至少由以下字段构成:
command number 只是业务类别,不是调用身份。
创建、绑定或排队都不能让 context 对 guest runtime 可见。只有取得 logical admission 的 invocation 才能投影 context;暂停和终态必须立即撤销。
exact outcome 只能由 record 自己保存的 terminal 构造。不得从全局 last-result 补 identity,也不得把 caller 看到的 value 和另一个槽位的 terminal 拼起来。
每次 tracked 调用拥有独立 local-reference scope。scope 只有在 carrier 已退役且 caller 已解析 outcome 后才释放。
PARKED、YIELDED、BACKEND_STOP 和 HANDOFF_REQUIRED 都是交通状态,不是 command terminal。TIMEOUT、FAULT、CANCELLED 也不能被转换为 COMPLETED。
最终架构可以拆成三层。
三层的职责必须严格分离:
最终方案的三层关系如下:
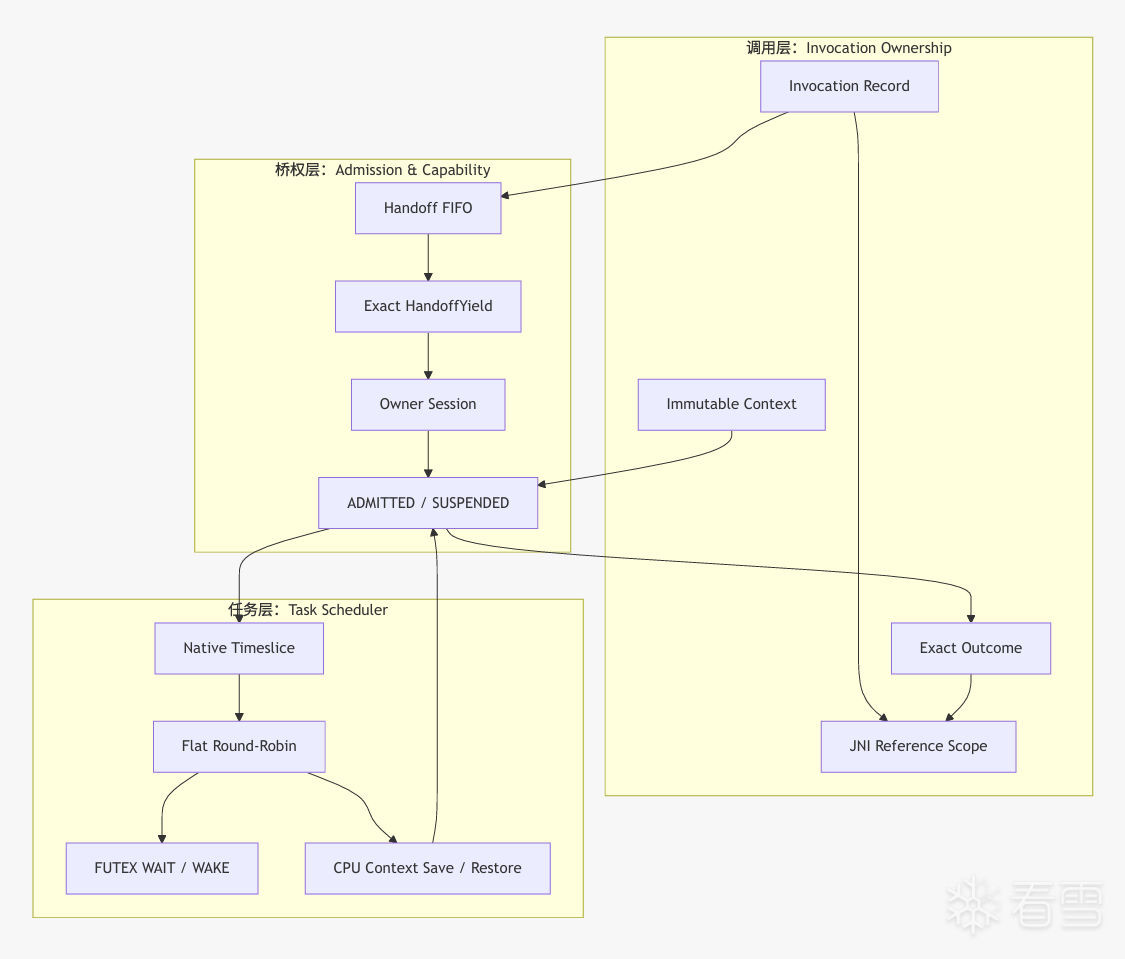
最下层仍然保留第一版文章中的 native timeslice 和 Task 调度器;最终版不是推翻第一版,而是在它之上补齐调用所有权和生命周期。
用桥和车的比喻,可以把主要对象映射如下:
这一章按照代码落点说明最终方案如何实现。示例保留核心逻辑,省略日志、兼容分支和非关键参数。
首先要避免一个枚举同时表达“命令是否结束”和“为什么暂停”。最终结果模型把 State 与 Kind 分开:
State 回答“是否已经形成 command terminal”,Kind 回答“具体发生了什么”。
这个拆分非常重要。若把 BACKEND_STOP 放进 completed 状态,handoff 会被错误地包装成自然返回;若把 CANCELLED 当 TIMEOUT,则一次宿主观察结束会被误写成 guest 生命周期失败。
结果匹配不能只比较 command:
这样即使两个调用使用相同 command,也不会串槽。
最终 record 聚合一次调用的全部关键身份:
为什么这些字段必须在一个对象里?因为它们的生命周期一致:
如果把它们拆进多个全局 Map,系统只能靠约定维持一致,很难形成可验证的不变量。
carrier 创建后还要检查 guest argument 中的 command:
最终建立三个相等关系:
错误在进入 backend 前失败,比运行几秒后再从异常日志猜 command 污染可靠得多。
对于已能创建 carrier 的 active mailbox 路径,不再先 reserve 再 bind,而是在 dispatcher 同一把锁中完成:
这里 carrier identity 是权威索引:
recordsByCommand 只负责查询候选集合,不再假设一个 command 只有一个 record。真正完成、fault 和 terminal 消费优先按 carrier 找到精确 record。
只有 FIFO head 可以 admitted:
FIFO 解决的是 logical admission 顺序,不等同于 Task 调度器的 round-robin。一个 invocation 一旦 admitted,普通时间片轮转不会释放它的调用级身份。
仅仅收到 EMU_STOP 还不够。系统必须证明:旧 owner 在当前 owner session 的某个真实 safe point 保存了现场,并同意让路。
记录凭证时进行精确检查:
在真正 suspend A 时,再次校验 owner session 和 safe-point sequence:
这防止旧 handoff 凭证在新的 owner session 中被重复使用。
新 requester 只有在以下条件同时成立时才请求 emu_stop():
emu_stop() 返回不生成 COMPLETED。它只促使 owner 的 emu_start() 回到 Java,随后 dispatcher 才能:
构造后不允许修改:
context 的可见性由 admission 控制,而不是由 caller 写入时间控制:
因此:
现有项目可能已经有大量 System.getProperty() reader,无法一次性全部改造。可以使用一个严格的 projection adapter:
撤销时精确恢复之前的“存在状态和值”:
它不是新的全局状态源,而是 legacy reader 的迁移桥。长期目标仍然是让行为代码通过 admitted context reader 取值。
context 是 Java-side ownership token,不应该塞进 guest Object... args,否则会改变 native ABI。
调用链采用 overload 显式传递:
底层仍按原 JNI positional ABI 编组:
CommandInvocationContext 只附着到 scheduled mailbox record,不进入 guest 寄存器。
构造器必须拒绝任何拼接结果:
这里使用对象 identity:
即使另一个结果拥有完全相同的 command、generation 和 submitter,只要它不是 record 实际保存的 terminal,也不能冒充本次 outcome。
dispatcher 完成 record 时统一补 ownership:
后续重复 terminal producer 只能得到已有 terminal,不得覆盖:
这关闭了 watchdog TIMEOUT、natural completion 和 fault retirement 之间的双发布竞争。
先定义一个与具体 VM 解耦的生命周期接口:
Android DVM 提供具体实现:
tracked JNI 参数不再进入 VM-wide map:
guest JNI 运行时也根据当前 running carrier 找到 scope:
因此 addLocalObject() 和 getObject() 自动路由:
真正释放必须同时满足:
为什么两个条件缺一不可?
这与旧的 finally { vm.deleteLocalRefs(); } 有本质区别:旧代码清空整个 VM 的 local refs,新代码只确认本 invocation 的 outcome 已解析;实际释放仍等待 carrier retirement。
在 emulator 的 RuntimeException 处理路径中,先判断当前 running task 是否拥有 tracked invocation:
dispatcher 将 fault 绑定到 carrier:
原 submitter 后续只消费自己 record 的 pending fault:
Legacy runtime exception 仍走旧兼容路径,避免一次重构破坏所有历史调用。
是否进入 tracked mailbox 应由 call site 明确声明,而不是根据“dispatcher 当前是否活跃”猜测:
显式 route 有三个好处:
真实程序经常使用 persistent single-thread executor:
一个 job 可以包含多条命令:
注意:persistent worker identity 不等于 persistent backend admission。
正确模型是:
每条 native command 都创建独立 record,worker FIFO 只保证业务提交顺序。不能把整个 job 合并成一个大 record 或长时间独占 backend,否则会抹掉主分支与 worker 分支之间真实存在的 safe-point overlap。
调度架构正确之后,还需要保证运行结果可评价。JUnit PASS 只代表测试方法结束,不代表 native transaction 完整。
一个简单可靠的账本使用 UTF-8 JSONL:
创建文件时使用 CREATE_NEW,防止覆盖旧运行:
每条事件通过单 writer 顺序写入并立即 flush:
典型事件包括:
完整性判定只看最后一条:
如果 writer 失败,finish() 或 close() 必须向测试抛出 IOException,不能出现“控制台日志看起来正常,但权威账本没有落盘”的假成功。
代码结构只有在完整时序中才能看清。下面用 A、B 两次调用说明最终模型。
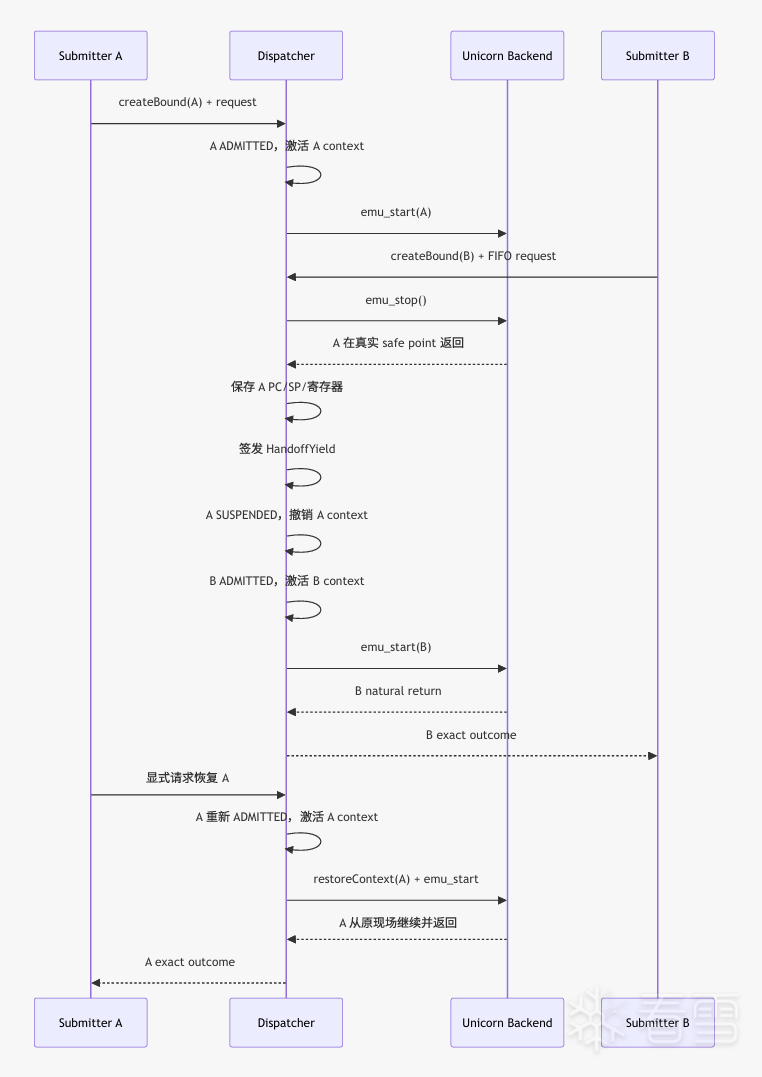
这张时序图刻意把 emu_stop() 和 natural return 画成两种不同事件:前者只负责把 owner 拉回 safe point,后者才有资格形成 COMPLETED。
此时:
B 仍然只是 BOUND:
这是 admitted-only 语义最重要的时刻。B 的 Java caller 已经存在,但 guest 仍在执行 A,所以任何 runtime reader 都必须继续看到 A。
B 是 FIFO head,并发现 backend owner 属于已 admitted 的 A,于是调用:
这不是终态,只是让 A 的 active emu_start() 回到 Java。
dispatcher 获得当前 owner-session generation 和 safe-point sequence:
A 的 carrier 没有 destroy,reference scope 也没有释放。A 只是暂时离开桥面。
B 的 terminal 必须带有:
任何全局 last result 都不能替代它。
A 不会被 dispatcher 自动塞回 FIFO。原 submitter 再次请求 admission:
最终形成可验证序列:
假设一个 persistent worker 需要提交六条 native command,同时主分支可能在中间提交一条 command。
错误模型:
这会抹掉真实 overlap,使主分支无法在 worker command 之间取得执行机会。
正确模型:
Java executor FIFO 与 backend handoff FIFO 是两个正交层:
架构重构最危险的地方,是 synthetic 测试通过后立刻宣称复杂业务已经修好。正确做法是分层验证,每层只证明自己的合同。
应覆盖:
使用最小 AArch64 guest 程序验证:
必须断言:
应覆盖:
应覆盖:
一次长运行只有满足以下条件才可评价:
如果 stdout 被截断,而 JSONL 没有 RUN_END,结论只能是:
不能用 JUnit PASS 或日志前半段推断业务成功、失败或架构充分性。
推荐迁移顺序:
不建议全仓机械替换 activeCommand。某些读取只是日志标签,某些读取会改变 JNI 返回形状,两者的迁移风险完全不同。
它解决的是 unidbg 单 backend 多线程模拟的通用基础设施问题:
这套架构没有承诺:
多线程基础设施正确,只说明“车辆、桥权、货单和回执没有串错”。车辆为什么没有装上某批货物,仍然可能是更上层的业务状态问题。
我个人是从 AI 时代才开始接触逆向的,分享一点自己的实践心得,并且本文也在ai的帮助下撰写。
如果只把 AI 当成即时问答工具,协作很容易陷入循环。第一轮花很长时间解释背景,第二轮因为上下文增长开始遗忘旧约束,第三轮又提出已经验证失败的方案,几轮之后,历史假设可能被误写成当前事实。代码确实改了不少,但没有人能准确回答每一次修改究竟证明了什么。这并不完全是模型是否会写代码的问题,更关键的是工程有没有建立可继承的记忆系统。聊天记录适合讨论,却不适合作为唯一事实源;它会被截断和压缩,重要信息也会散落在不同轮次中。真正可持续的做法,是把协作所需的状态、证据、禁区和结论写进仓库,让任何一轮新的分析都从同一个基线出发。
因此,我们没有维护一篇包揽所有内容的“万能说明书”,而是让不同文档承担不同职责。 AGENTS.md 保存协作规则,说明进入任务前要读什么、哪些文件能够修改、哪些操作需要额外授权,以及实验产物应放在哪里。它更像施工现场的安全规范,解决的是“应该怎样工作”,而不是“今天具体做到了哪里”。
progress.md 是按时间增长的工程账本。一次实验修改了什么、没有修改什么,观察到了哪些原始现象,结论能够覆盖到哪一层,下一步停在哪里,都应当在这里留下记录。它保存的不是一份经过修饰的成功故事,而是完整的决策轨迹。后来的协作者不必依靠一句“这里以前试过”,而是可以查到当时试了什么、控制条件是否成立,以及为什么那个结果不能继续外推。
experiment_outcomes_and_pivots.md 专门保存负向知识。一般的开发记录喜欢写“最后怎样成功”,却很少认真记录“哪些路为什么不通”。在复杂重构中,失败实验并不是垃圾,它会缩小候选空间。提高优先级、延长 timeout、强制 wake、扩大全局锁或者增加兼容 fallback,这些都是面对并发异常时很容易再次想到的方案。如果历史已经证明它们只能改变表象,转向账本就应明确写出原假设、反证和新的方向。这样,新一轮 AI 在读取状态后,需要提出能够区分新解释的验证,而不是把旧补丁换一个参数再做一遍。
CURRENT_STATE.md 承担的角色更接近总工程师确认后的最新图纸。时间线账本可以不断追加观察,但稳定状态不应随着每次未经复核的实验来回摆动。把“实验记录”和“当前可信结论”分开,是为了防止一条单样本结果立刻改写整个架构叙事。它也明确提醒 AI:发现新的可能性并不等于已经获得修改全局结论的权力。
随着进展账本越来越长,仅靠读取文件末尾也会逐渐丢失阶段脉络,截至今天,我项目的 progress.md 已经30多万行,如果想让一个从来没接触过项目的ai进站了解项目去读这个文件,显然并不可能,所以我们又用 summarization/07 这类按月份和日期组织的文档保存阶段检查点。它们的核心不是压缩当天日志,而是建立一种可继承的推理架构——每篇文献都遵循一套稳定的结构契约:
这些文档组成了一套分层的工程记忆。规则文档负责限制行为,当前状态负责提供稳定基线,进展账本负责保存时间线,转向账本负责阻止路线循环,阶段摘要负责跨越上下文边界,对外文章则负责把内部经验脱敏后重新组织为可传播的方法。它们并不是重复记录同一件事,而是在不同粒度上回答不同问题。新一轮协作也不需要把整个仓库和全部历史一次性塞给 AI,只要从稳定状态、近期进展和相关阶段摘要恢复现场,再根据当前问题有方向地读取源码即可。
有了这套记忆系统,每次开始工作都可以执行同一个“进站”过程。先读取最新状态和历史转向,再对照禁止清单,随后确认本轮问题位于因果链的哪一层,明确允许修改的文件和能够接受的证据,最后才开始分析或实现。完成后,代码通过测试只是第一层检查,还要确认测试究竟证明了什么、哪些结论仍未覆盖,并在明确停点结束。这样做可以抑制一种很常见的冲动:看到某处出现差异,就自动向上游追踪;看到一个 timeout,就马上延长等待;看到一个全局字段,就顺手做全仓替换。每一步都必须先回答,它修复或验证的是因果链中的哪一层。
第一版原生时间片方案解决了 unidbg 多线程模拟最基础的问题:没有稳定 safe point,就谈不上可控调度。它让主任务和 worker 不再完全依赖偶然 syscall 才能轮转,是从补丁式 drain 走向调度基础设施的关键一步。
第二版命令服务进一步意识到 backend 不能被多个宿主线程同时驾驶,也开始区分 timeout、fault、handoff 和 completion。但只要调用身份仍散落在全局 result、command 单槽、active fields 和日志字符串中,重叠调用就没有严格的隔离边界。
最终重构真正改变的是系统的主语:过去所有逻辑都在问“下一个 Task 跑谁”,现在系统还会问“正在运行的是哪一次 Invocation,它为什么有资格进入 backend,它暂停时应保存什么,它的结果和 JNI 引用最终交给谁”。
红绿灯只能让车轮流过桥。要让一座单车道桥长期、安全地承载复杂交通,还需要通行证、流水号、排队规则、货单隔离、交接凭证和不可抵赖的出桥记录。
对于 unidbg 的单后端多线程模拟来说,真正困难的从来不是“多跑几个 worker”,而是让每一次暂停、恢复、返回、超时和失败,都精确地属于正确的那次调用。
而对于长期的人机协作来说,真正困难的也不是让 AI 多生成几段代码,而是让每一次观察、假设、修改、验证和转向,都精确地写入正确的工程记忆,并能被下一轮工作完整继承。
以上是我个人在 unidbg 调度模型上的一点粗浅思考,受限于水平和经验,难免有疏漏或偏颇之处,欢迎读者批评指正。
本文仅讨论 unidbg 开源框架自身调度模型的通用架构设计。文中所有命令编号、回调与返回值均为抽象占位符,不对应任何特定程序、接口或业务数据。本文不提供、不指引、不协助绕过任何具体安全防护措施。
| 观测事实 |
能证明什么 |
不能证明什么 |
| worker 被创建、入队并实际执行 |
Task 调度闭环已经工作 |
调用一定能完成 |
carrier 仍为 RUNNABLE |
carrier 不是简单睡死 |
它已经获得足够执行机会 |
| 常规 wait/wake 路径发生 |
基础同步事件可被处理 |
所有调用生命周期都被正确建模 |
| 放宽 wall cutoff 后能够自然返回 |
旧 deadline 会过早终止可返回调用 |
某个更大的固定数值永远正确 |
| carrier 独占时反而进入依赖等待 |
worker 是必要协作者 |
提高 carrier 优先级可以替代并发语义 |
| 架构对象 |
比喻 |
职责 |
| Native timeslice |
红绿灯 |
定期让车辆停到安全位置 |
| Backend capability |
桥梁驾驶权 |
保证同一时刻只有一个执行者 |
| CommandInvocationRecord |
独立通行证 |
记录车辆身份、状态和回执 |
| Generation |
通行证流水号 |
区分同一 command 的多次调用 |
| Handoff FIFO |
桥头排队车道 |
防止后来的请求插队 |
| HandoffYield |
交警签发的让行凭证 |
证明旧 owner 在哪个 safe point 让路 |
| CommandInvocationContext |
车辆货单 |
只在车辆真正上桥时可见 |
| CommandInvocationOutcome |
出桥回执 |
value 与 terminal 的不可拆分结果 |
| InvocationReferenceScope |
独立行李舱 |
隔离 JNI local references |
| 维度 |
第一版时间片 |
第二版命令服务 |
最终 Invocation Runtime |
| 核心目标 |
让 Task 轮流运行 |
避免多人同时驾驶 backend |
让重叠调用拥有精确生命周期 |
| 调度单位 |
Task |
Task + command |
Task + Invocation |
| backend 停止 |
timeslice / futex |
stop + owner handoff |
exact safe-point yield |
| backend 权限 |
调度循环隐式拥有 |
owner thread |
OwnerSession + logical admission |
| 调用身份 |
command 或 active field |
command + 若干 generation 槽 |
carrier + command + generation + submitter |
| 请求顺序 |
Task round-robin |
全局 handoff 状态 |
Invocation FIFO |
| 运行上下文 |
全局 active fields |
global/ThreadLocal 混合 |
immutable admitted-only context |
| 返回结果 |
Number/null |
value + global result heuristic |
record-owned exact outcome |
| 异常 |
可能兼容为 -1 |
pending global fault |
invocation-owned FAULT |
| JNI local ref |
VM-wide map |
VM-wide map |
invocation scope |
| scope 释放 |
JNI finally 全清 |
carrier/task 清理 |
carrier retired AND outcome acknowledged |
| timeout |
总 wall time |
watchdog + 多个全局槽 |
exact terminal,operation cancellation 分离 |
| 可评价证据 |
stdout |
stdout + JUnit |
durable terminal ledger |
已经证明:多个 Task 可以被打断、保存、恢复和轮转
错误外推:多个重叠 native invocation 因此一定能正确完成
carrier.state = RUNNABLE
carrier.waitAddress = 0
carrier.finished = false
observation = expired
如果任务本来就在 RUNNABLE,强制 wake 没有增加新信息;
如果 carrier 依赖 worker,永久优先 carrier 反而会破坏协作;
如果完成权没有归属,调整队列也不能保证结果交给正确调用;
如果 wall timeout 的含义错误,增加 drain 只是延后同一个问题。
不是旧数值太小;
也不是新数值还不够大;
而是用所有 Task 共享的 wall time,表达某一次 Invocation 的生命周期,本身就不成立。
main task
worker task #1
worker task #2
scheduled function task
这个 scheduled task 属于哪一次调用?
这个 TIMEOUT 是当前 generation 的,还是上一轮残留的?
这个 worker fault 应该交给哪个 submitter?
同一个 command 再次出现时,能否覆盖旧结果?
long start = System.currentTimeMillis();

while (hasRunnableTask()) {
    Task task = pickNextTask();
    task.dispatch(emulator);

    if (System.currentTimeMillis() - start >= timeoutMillis) {
        return null;
    }
}
命令总窗口:8 秒
carrier 实际获得 backend:1.2 秒
worker 与框架开销:6.8 秒
结果:carrier 被判 TIMEOUT
enum BackendStopReason {
    NORMAL,
    TIMESLICE,
    EMU_STOP,
    FAULT
}
private final Map<Integer, ObjRef> localObjectMap = new HashMap<>();

void deleteLocalRefs() {
    for (ObjRef ref : localObjectMap.values()) {
        ref.obj.onDeleteRef();
    }
    localObjectMap.clear();
}
调用 A:把 Object[] 参数加入 localObjectMap
调用 A:在 safe point 暂停
调用 B:把自己的参数加入同一个 localObjectMap
调用 B:完成并调用 deleteLocalRefs()
调用 A:恢复执行
调用 A:通过原 handle 读取 Object[],得到 null
private Thread backendOwnerThread;
private CommandResult lastCommandResult;
private CommandResult commandTerminalResult;
private Map<Integer, CommandResult> terminalByCommand;
private Task pendingFaultTask;
private CommandResult pendingFaultResult;
当前 task
当前 command number
当前 submitter thread
某个 generation 字段
全局 last result
某个 keyed terminal map
日志 detail 中的 cmd=...
if (result.getDetail().contains("cmd=" + cmd)) {
}
Map<Integer, CommandRecord> recordsByCommand;
Map<Integer, CommandResult> terminalsByCommand;