-
-
[原创]试分析 ReadProcessMemory的实现原理(用户态到内核)
-
发表于: 6小时前 203
-


简单分析ReadProcessMemory的实现原理和SYSCALL,忽略了很多细节,借助AI分析,存在大量错误或不严谨
在 Windows 系统中,ReadProcessMemory 的完整执行路径大致如下:
[Ring 3] 应用程序

  └── Kernel32.dll / KernelBase.dll (ReadProcessMemory)

        └── Ntdll.dll (NtReadProcessMemory 或 ZwReadProcessMemory)

              └── 软中断 / 快速系统调用 (syscall)

[Ring 0] 内核层

  └── **KiSystemCall64Shadow**

        └── NtReadProcessMemory (内核函数)

              └── MmCopyVirtualMemory (执行实际的内存读取与权限检查)

                        └── MiCopyVirtualMemory(真正的跨进程内存拷贝)
ReadProcessMemory 函数 (memoryapi.h) - Win32 apps
用于从一个进程的虚拟内存空间中读取数据,复制到另一个进程的缓冲区中。
BOOL ReadProcessMemory(
  HANDLE  hProcess,           // 目标进程的句柄
  LPCVOID lpBaseAddress,      // 目标进程中要读取的起始内存地址
  LPVOID  lpBuffer,           // 接收数据的本地缓冲区指针
  SIZE_T  nSize,              // 要读取的字节数
  SIZE_T  *lpNumberOfBytesRead // 实际读取到的字节数(可选输出参数)
);
0 环境准备:
zh-cn_windows_11_enterprise_ltsc_2024_x64_dvd_cff9cd2d.iso 网盘
- 从中拿出win11的所需dll和ntoskrnl,本次分析核心在ntoskrnl,可直接IDA分析ntoskrnl.exe
- windbg动态调试配置kdnet Secure boot bcdedit
- 编写程序,见附件
- target.exe:分配内存、显示地址和内容
- reader_writer.exe:调用跨进程读写 API
C:\Windows\System32\kernel32.dll KernelBase.dll ntdll.dll ntoskrnl.exe
- wrk1.2.4 源码查看MmCopyVirtualMemory
用户态调试
大部分跨进程操作,调度等都是需要进入 Ring0 的,比如跨进程读API:ReadProcessMemory。
入口点通常是 kernel32.dll 的 ReadProcessMemory,最后调用了 kernelbase.dll的 ReadProcessMemory。
动态:IDA调试,编写好的程序,ReadProcessMemory下断点
 kernelbase_ReadProcessMemory:
 sub     rsp, 48h                        ; CODE XREF: KERNEL32.DLL:kernel32_ReadProcessMemory↓j
                                         ; DATA XREF: KERNEL32.DLL:off_7FFFAC42B6B0↓o
 lea     rax, [rsp+30h]
 mov     qword ptr [rsp+30h], 0
 mov     [rsp+20h], rax
 call    cs:off_7FFFAAD29D18             ; off_7FFFAAD29D18 dq offset ntdll_NtReadVirtualMemory
 nop     dword ptr [rax+rax+00h]
 mov     rcx, [rsp+70h]
 test    rcx, rcx
 jz      short loc_7FFFAAB47625
 mov     rdx, [rsp+30h]
 mov     [rcx], rdx

 loc_7FFFAAB47625:                       ; CODE XREF: KernelBase.dll:kernelbase_ReadProcessMemory+2B↑j
 test    eax, eax
 js      short loc_7FFFAAB47634
 mov     eax, 1
 add     rsp, 48h
 retn
查看ntdll_NtReadVirtualMemory,内部syscall
off_7FFFAAD29D18 dq offset ntdll_NtReadVirtualMemory proc near
mov     r10, rcx                        ; CODE XREF: KernelBase.dll:kernelbase_ReadProcessMemory+17↑p
                                        ; DATA XREF: KernelBase.dll:off_7FFFAAD29D18↑o
mov     eax, 3Fh ; '?'
test    byte_7FFE0308, 1
jnz     short loc_7FFFAD702535
syscall                                 ; Low latency system call
retn
; ---------------------------------------------------------------------------
loc_7FFFAD702535:                       ; CODE XREF: ntdll_NtReadVirtualMemory+10↑j
int     2Eh                             ; DOS 2+ internal - EXECUTE COMMAND
                                        ; DS:SI -> counted CR-terminated command string
retn
ntdll_NtReadVirtualMemory endp
静态:知道在kernelBase,直接搜索函数名ReadProcessMemory即可

NtReadVirtualMemory 是通过标志位选择走 syscall 指令或者 int 0x2E 指令。
阶段 1:用户态准备与硬件跃迁(**ntdll.dll****) **
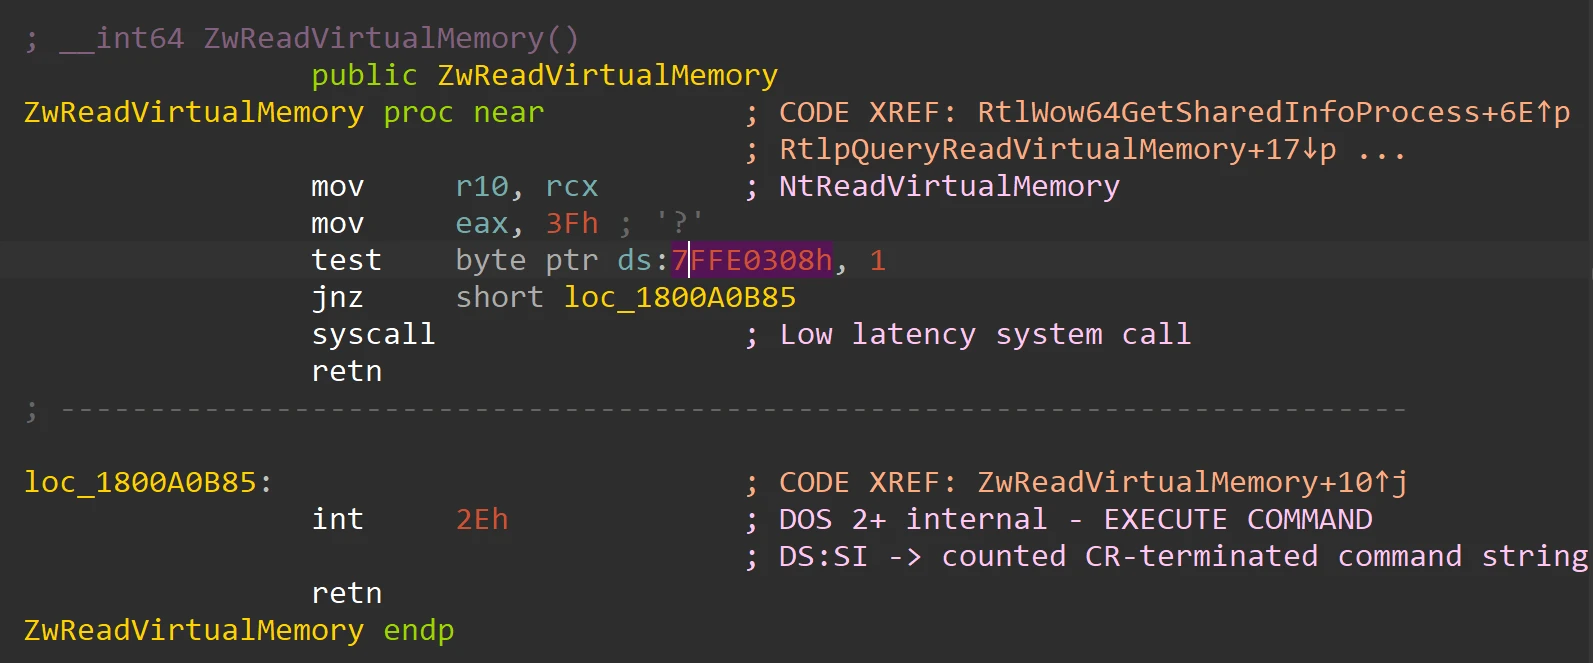
- 保存首个参数:执行
mov r10, rcx。因为随后的syscall指令会用返回地址覆盖RCX,必须提前备份第 1 个参数。 - 加载系统调用号:执行
mov eax, 3Fh。0x3F是NtReadVirtualMemory的服务号(SSN)。 - 发起系统调用:检查
KUSER_SHARED_DATA(0x7FFE0308)后执行**syscall**。 - CPU 硬件自动动作:
- 将用户态返回地址(
RIP)存入RCX,标志寄存器(RFLAGS)存入R11。 - 从
IA32_LSTARMSR 寄存器读取内核入口地址并跳转。 - 将代码段寄存器(
CS)切换为 Ring 0 权限。
- 将用户态返回地址(
** 硬件层面:通过 MSR 寄存器定位入口地址**
CPU 执行 syscall 指令时,硬件会自动读取 **IA32_LSTAR**(Model Specific Register,编号 0xC0000082)寄存器中的地址,并将 RIP 跳转到该处执行。
- 内核调试器查询:在 WinDbg 中连接内核调试后,直接执行
rdmsr c0000082即可查看该寄存器的值。 - 符号解析:将返回的 64 位地址用
ln <地址>或u <地址>反汇编。在开启了 KVA Shadow(熔断漏洞缓解机制)的现代 Windows 10/11 系统上,该地址直接指向**nt!KiSystemCall64Shadow**。
syscall**-nt!KiSystemCall64Shadow**
总结:用户态通过
ntdll准备好系统调用号(SSN)并触发syscall指令;CPU 硬件提权并跳转到内核影子入口;内核完成页表与栈切换、保存现场后,通过查询 SSDT 表定位并执行真正的内核函数。
操作:梳理参数准备,寄存器,安全检查,主要看查表和call r10(内核函数)如何实现
阶段 2:内核安全隔离层(**KiSystemCall64Shadow**)
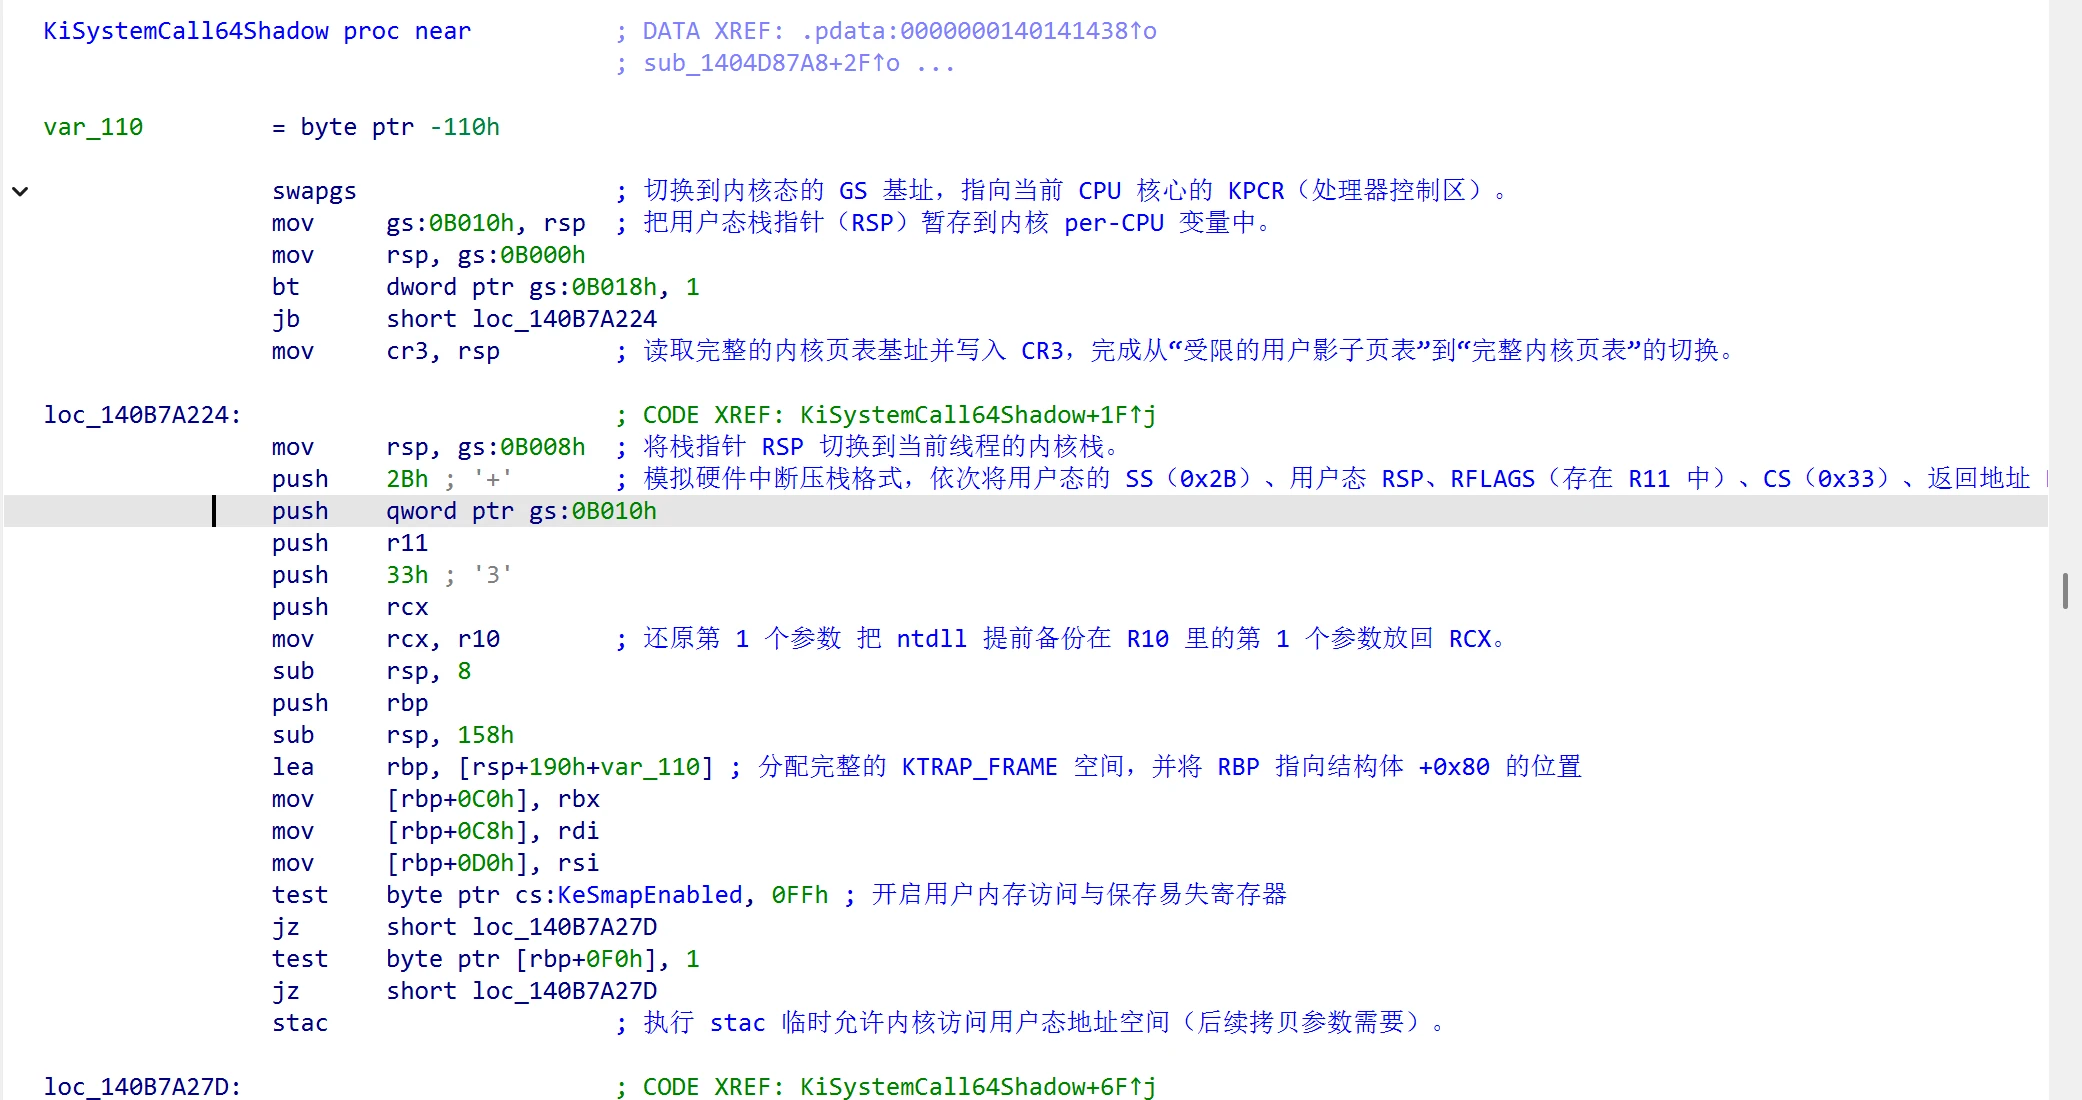
切换寄存器,末尾,系统调用
- 存在背景:为防御 CPU 熔断漏洞(Meltdown),现代 Windows 开启了 KVA Shadow(内核虚拟地址影子机制),用户态能看到的内核页表极度受限。
- 核心动作:
- 执行
**swapgs**:切换GS段寄存器基址,使内核能访问当前 CPU 核心的KPCR(处理器控制区)结构,从而找到内核栈指针。 - 切换
**CR3**** 寄存器**:将页表基址从“受限的用户影子页表”切换为“完整的内核页表”。 - 完成后,跳转进入真正的系统调用处理流程(
KiSystemServiceUser)。
- 执行
阶段 3:构建陷阱帧(**KiSystemServiceUser**)
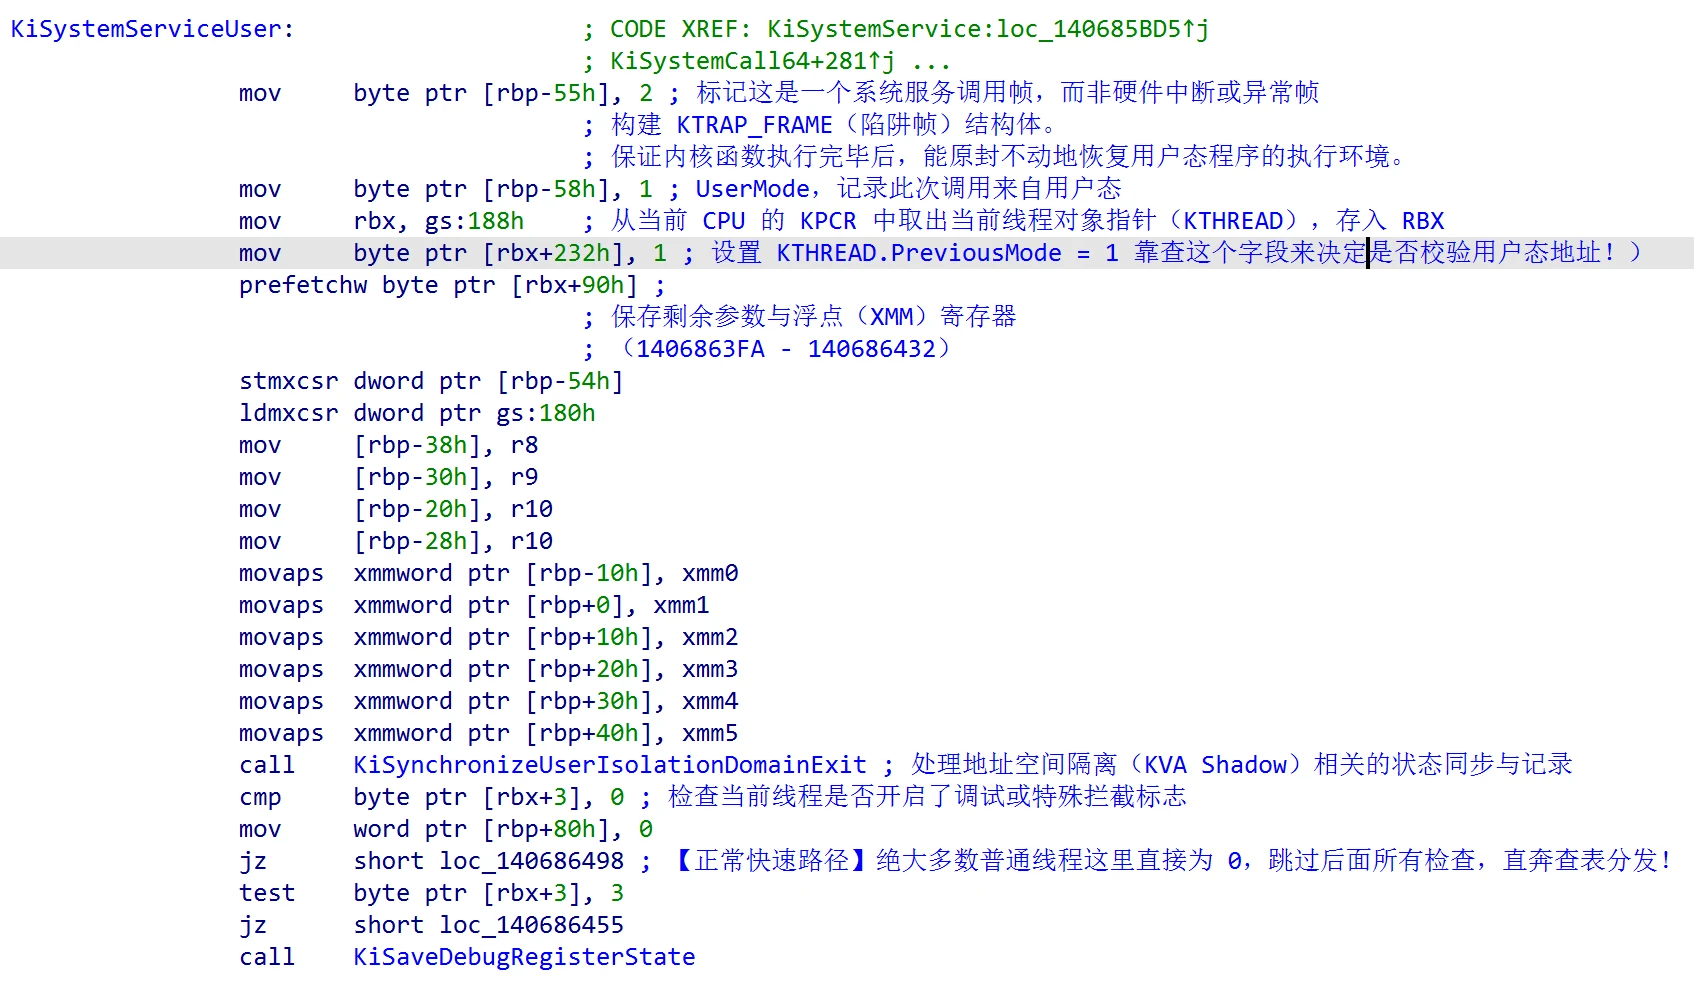
- 分配内核栈空间:在当前线程的内核栈上开辟区域,构建
**KTRAP_FRAME**(陷阱帧)结构体。 - 保存用户态现场:将用户态的所有通用寄存器、栈指针(
RSP)、返回地址等全部压入KTRAP_FRAME。 - 目的:保证内核函数执行完毕后,能原封不动地恢复用户态程序的执行环境。
loc_140686498 ; 【正常快速路径】:决定查普通内核表
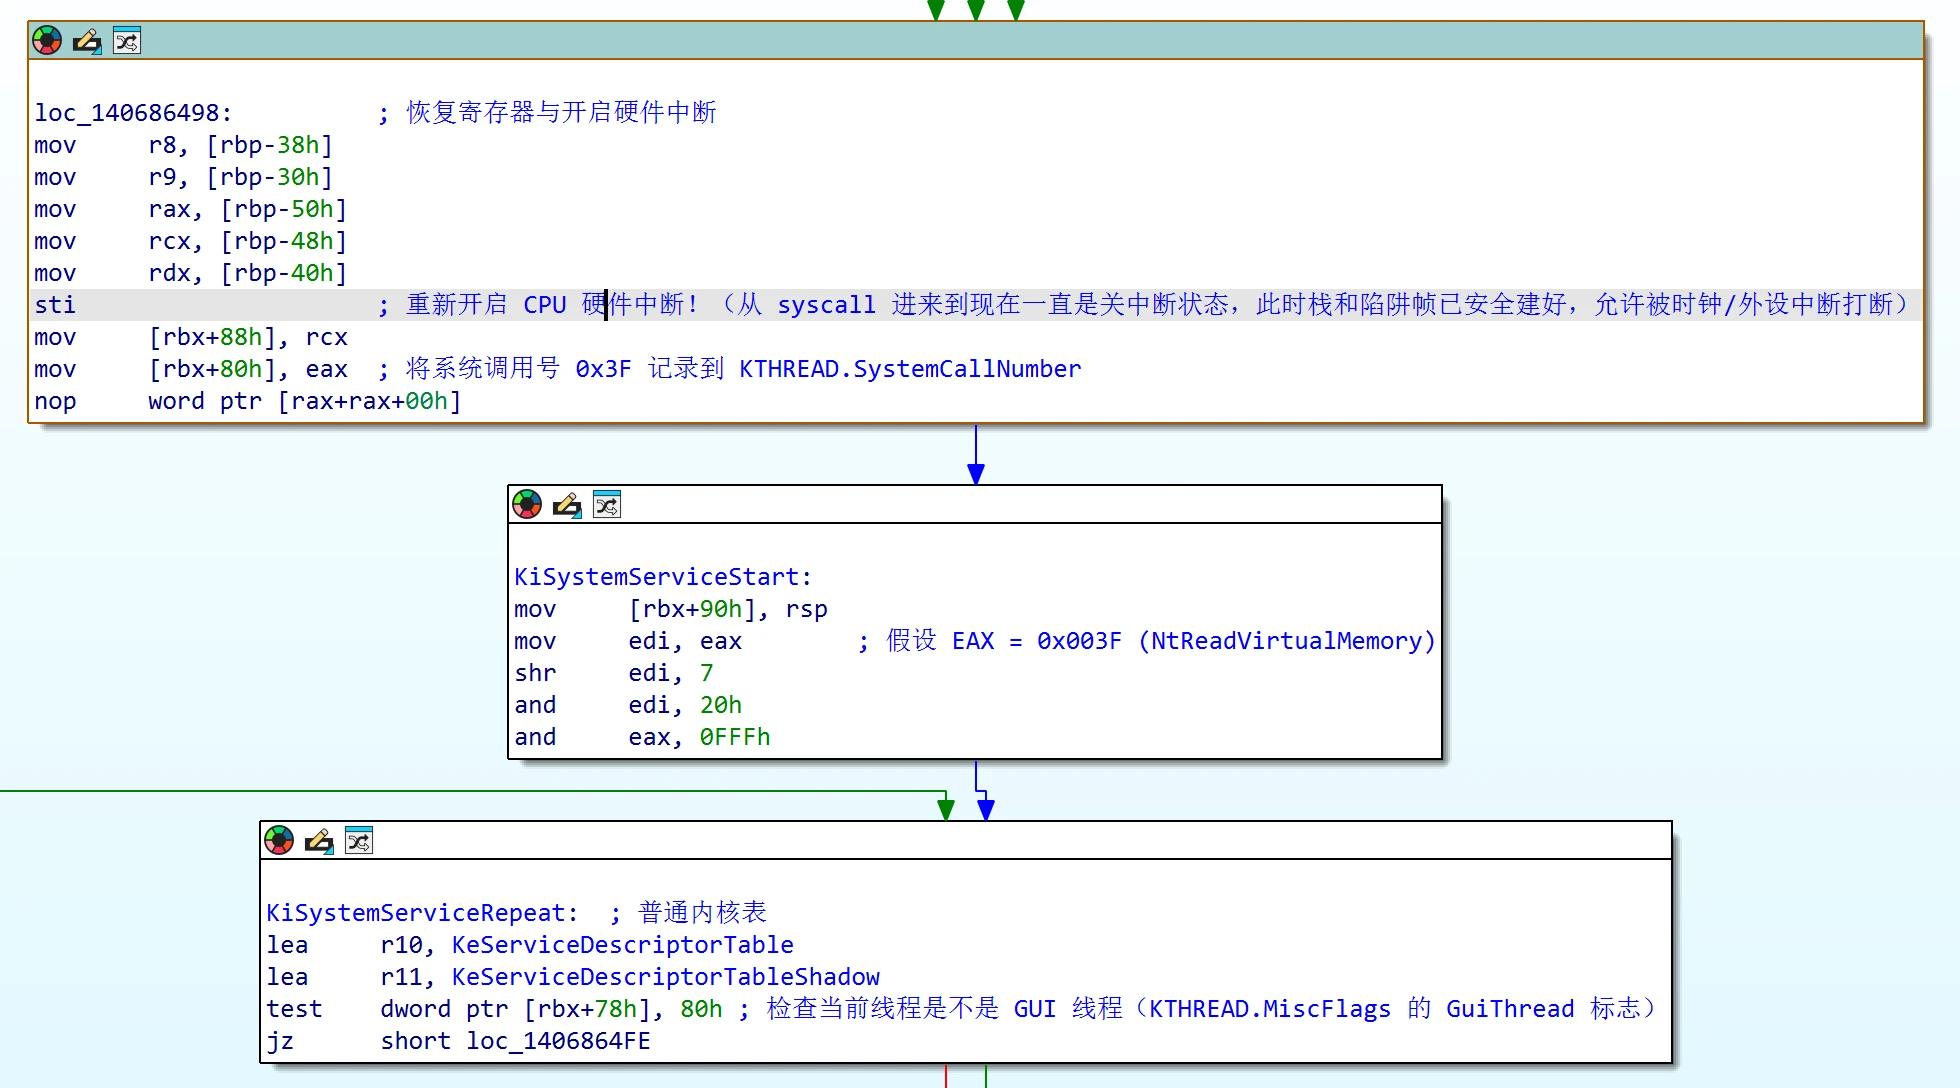
阶段 4:查表分发与参数拷贝(**KiSystemServiceRepeat**** & **KiServiceTable**)**
mov     r10, [r10+rdi]  ; 取出表结构中的 ServiceTableBase(即 KiServiceTable 的基址)
movsxd  r11, dword ptr [r10+rax*4] ; 取出 0x3F 对应的 32 位偏移值
mov     rax, r11
sar     r11, 4          ; 右移4位,去掉低4位的参数个数信息
add     r10, r11        ; 加上表基址,R10 现在就是 nt!NtReadVirtualMemory 的地址!
cmp     edi, 20h ; ' '
jnz     short loc_140686570
- 定位 SSDT 表:以系统调用号
0x3F为索引,查找内核系统服务描述符表(KeServiceDescriptorTable)。 - 计算目标函数地址:
- 内存中的 SSDT 表项是一个 32 位有符号整数。
- 高 28 位:目标函数相对于
KiServiceTable基址的偏移量(通过sar r11, 4算术右移得到)。 - 低 4 位:该内核函数在栈上的额外参数个数(通过
and eax, 0Fh取出)。
- 拷贝栈上参数(
**KiSystemServiceCopyEnd**):- x64 调用约定前 4 个参数走寄存器,
NtReadVirtualMemory有 5 个参数,低 4 位为1。 - 内核校验用户栈指针合法性(对比
MmUserProbeAddress防越权)后,将第 5 个参数从用户栈拷贝到内核栈。
- x64 调用约定前 4 个参数走寄存器,
- 最终跳转:执行
**call r10**(或防 Spectre 攻击的间接跳转跳板),正式进入**nt!NtReadVirtualMemory**。
00000001400D4EF0 KiServiceTable+0x3f * 4
00000001400D4FEC                 dd 9B7C00h
0x140000000 + 0x009B7C00 PAGE:00000001409B7C00 NtReadVirtualMemory proc near
注意:在系统启动阶段,内核初始化函数 KiInitializeSystemCall 会遍历整个 KiServiceTable(一共四百多个系统调用),对每一个表项做一次原地改造 ,KiServiceTable 里存放的不是右移 4 位的偏移量,而是直接的 RVA
至此syscall结束,开始进入NtReadVirtualMemory的分析。
NtReadVirtualMemory和MiReadWriteVirtualMemory
NtReadVirtualMemory上面就是写内存,都调用MiReadWriteVirtualMemory;二者只是ACCESS_MASK DesiredAccess 不同
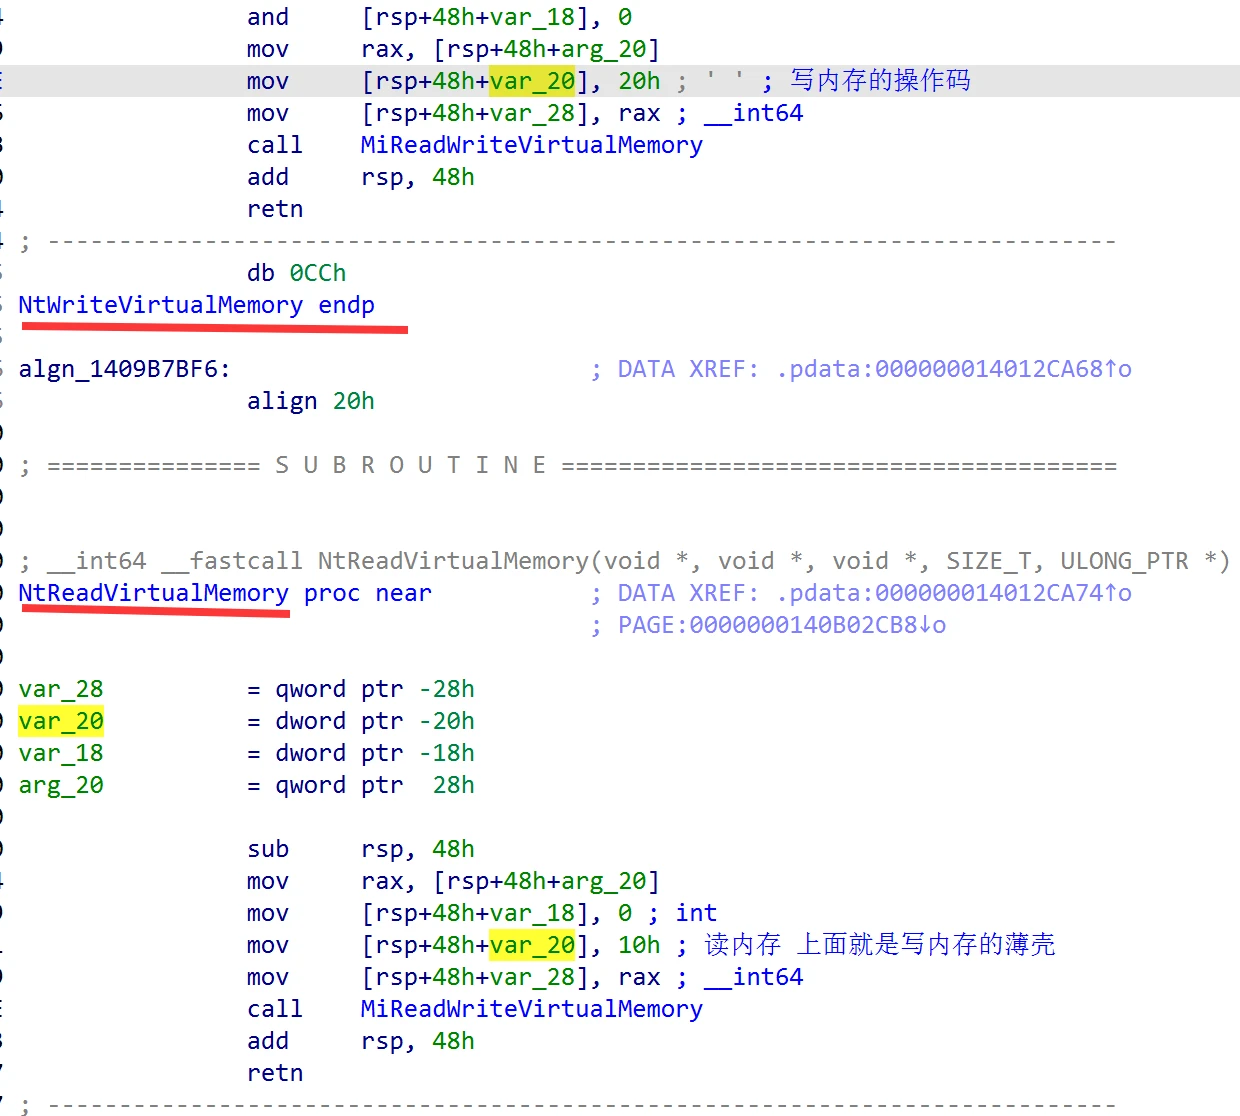
以下开始分析MiReadWriteVirtualMemory
补全函数声明,变量命名,F5种没有汇编的__try { // __except
- 前面依然是参数检查
- if ( DesiredAccess == 16 ) v11 = CopyFlags | 1; // 标记数据流向为“从远程进程读到本地”
- CopyFlagsa = CurrentThread->PreviousMode
- 如果是x64 用户态,合法地址上限是 0x7FFFFFFEFFFF,检查地址长度范围, 触发一次内存读写访问
- ObpReferenceObjectByHandleWithTag( // 用句柄取得目标进程对象
- 读写均调用,MiCopyVirtualMemory,参数反转,CopyFlags有差异
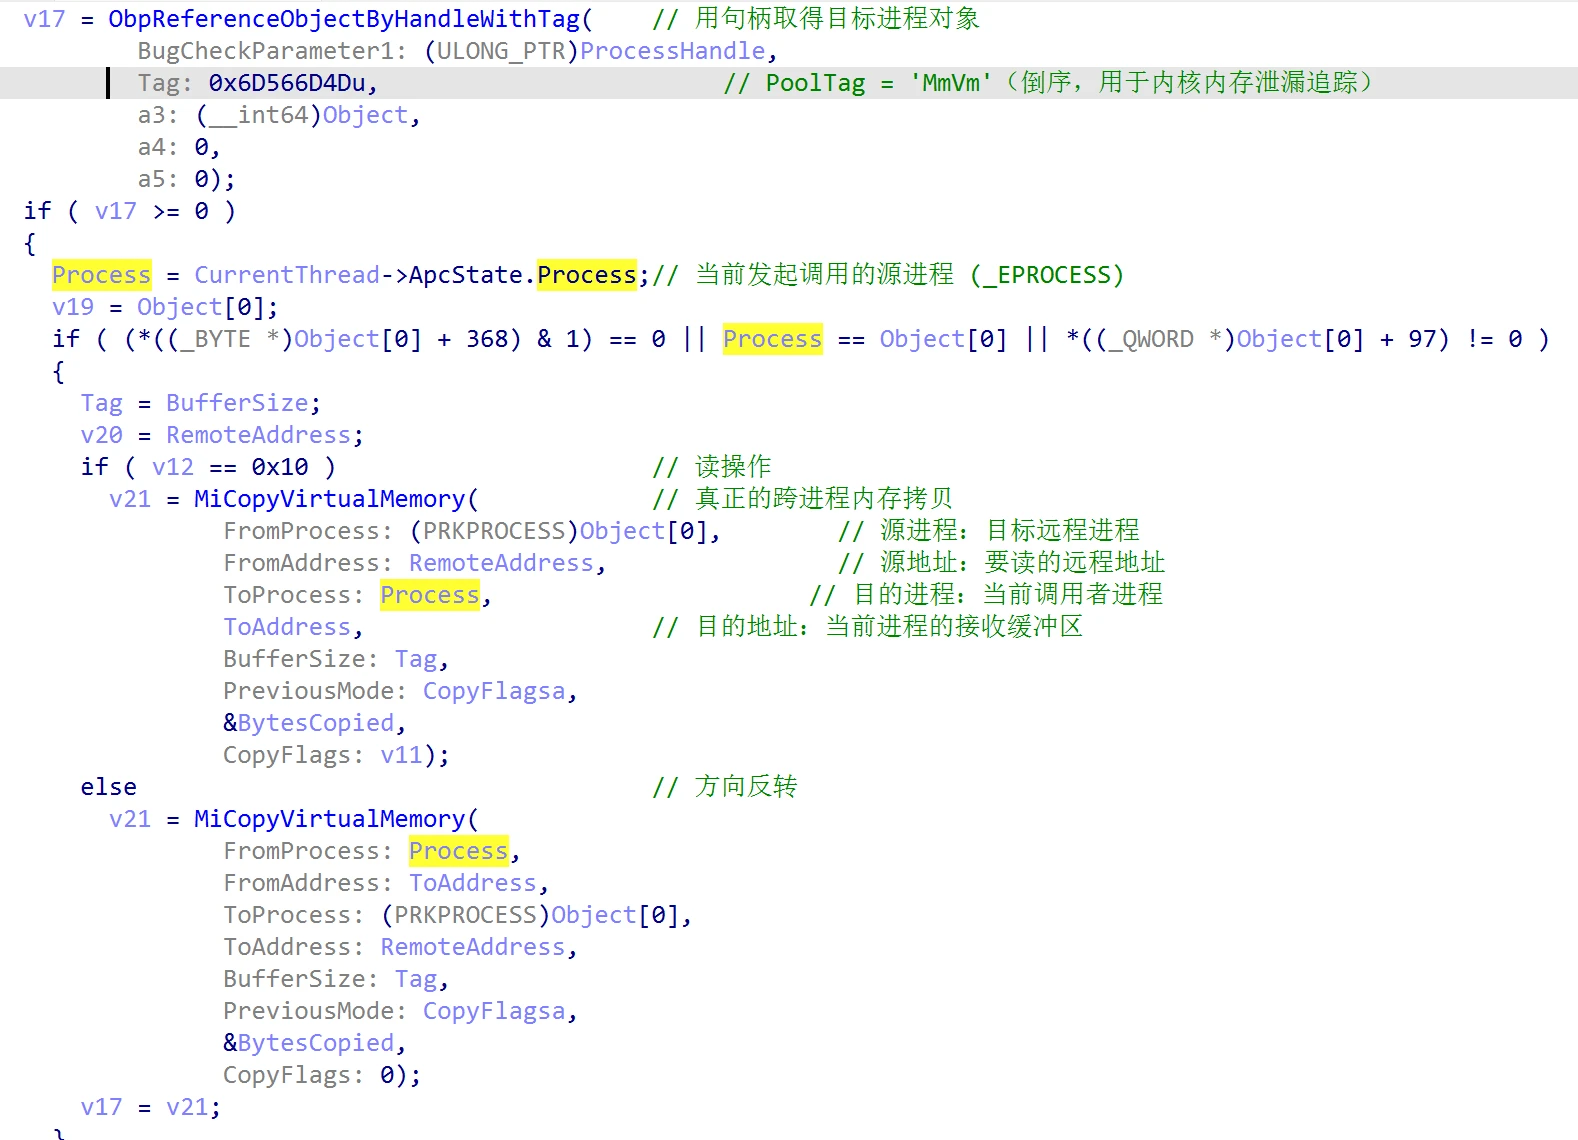
- 之后,特殊进程C05拒绝,打印日志,释放资源,看API名称即可知道,忽略;接下来分析MiCopyVirtualMemory
wrk源码-MmCopyVirtualMemory
前面 安全检查忽略
核心:BufferSize > POOL_MOVE_THRESHOLD,走MiDoMappedCopy(MDL 直接映射),反之,通过MiDoPoolCopy(内核池中转)是内存Copy
TNTSTATUS
MmCopyVirtualMemory(
    IN PEPROCESS FromProcess,
    IN CONST VOID *FromAddress,
    IN PEPROCESS ToProcess,
    OUT PVOID ToAddress,
    IN SIZE_T BufferSize,
    IN KPROCESSOR_MODE PreviousMode,
    OUT PSIZE_T NumberOfBytesCopied
    )
{
    NTSTATUS Status;
    PEPROCESS ProcessToLock;

    if (BufferSize == 0) {
        ASSERT (FALSE);         // No one should call with a zero size.
        return STATUS_SUCCESS;
    }

    ProcessToLock = FromProcess;
    if (FromProcess == PsGetCurrentProcess()) {
        ProcessToLock = ToProcess;
    }

    //
    // Make sure the process still has an address space.
    //

    if (ExAcquireRundownProtection (&ProcessToLock->RundownProtect) == FALSE) {
        return STATUS_PROCESS_IS_TERMINATING;
    }

    //
    // If the buffer size is greater than the pool move threshold,
    // then attempt to write the memory via direct mapping.
    //
    //MiDoMappedCopy(MDL 直接映射)
    if (BufferSize > POOL_MOVE_THRESHOLD) {
        Status = MiDoMappedCopy(FromProcess,
                                FromAddress,
                                ToProcess,
                                ToAddress,
                                BufferSize,
                                PreviousMode,
                                NumberOfBytesCopied);

        //
        // If the completion status is not a working quota problem,
        // then finish the service. Otherwise, attempt to write the
        // memory through nonpaged pool.
        //

        if (Status != STATUS_WORKING_SET_QUOTA) {
            goto CompleteService;
        }

        *NumberOfBytesCopied = 0;
    }

    //
    // There was not enough working set quota to write the memory via
    // direct mapping or the size of the write was below the pool move
    // threshold. Attempt to write the specified memory through nonpaged
    // pool.
    //
    //MiDoPoolCopy(内核池中转)。
    Status = MiDoPoolCopy(FromProcess,
                          FromAddress,
                          ToProcess,
                          ToAddress,
                          BufferSize,
                          PreviousMode,
                          NumberOfBytesCopied);

    //
    // Dereference the target process.
    //

CompleteService:

    //
    // Indicate that the vm operation is complete.
    //

    ExReleaseRundownProtection (&ProcessToLock->RundownProtect);

    return Status;
}
Win11-MiCopyVirtualMemory
**MiCopyVirtualMemory**** 内部在干什么?(一句话概括给听众)**:
因为两个进程拥有各自独立的虚拟地址空间(页表 CR3 不同),不能直接 memcpy。内核会调用 **KeStackAttachProcess** 把当前线程的 CR3 临时切换到目标进程,把数据拷入内核中转缓冲区(或通过 MDL 映射物理页),再切回当前进程将数据拷入 LocalBuffer。
前备概念:
跨进程读取不能盲目直接 memcpy,因为目标地址可能横跨多个不同属性的虚拟内存区域(VAD,Virtual Address Descriptor,例如一段可读、下一段不可读或属于设备 I/O 空间)。
本轮安全块大小 ChunkSize
VAD(Virtual Address Descriptor) 是用来管理进程用户态虚拟地址空间的核心数据结构。每个进程都有自己独立的虚拟地址空间,内核通过一棵 AVL 自平衡二叉树(VAD 树) 来记录这些地址的分配与使用状态。 记录了该区间的起始页号、结束页号、内存保护属性(如可读、可写、可执行)以及后备存储信息(如普通私有内存或映射文件)。
| 维度 | VAD(虚拟地址描述符) | 页表(Page Table / PTE) |
|---|---|---|
| 管理主体 | Windows 操作系统内核(软件层) | CPU 硬件(MMU 内存管理单元)与内核共同维护 |
| 描述粒度 | 连续的内存块(可能包含成百上千个页面) | 单个内存页(通常为 4KB) |
| 核心作用 | 记录内存的逻辑分配状态(是否已申请、申请时的权限) | 记录虚拟地址到物理内存地址的映射关系 |
| 懒加载机制 | 调用 VirtualAlloc提交内存时,内核立刻创建 VAD 节点 |
只有程序实际读写该内存触发缺页异常(Page Fault)时,内核才对照 VAD 分配物理页并填充页表 |
MiCopyVirtualMemory 比 wrk的 多了 参数unsigned __int8 CopyFlags
  unsigned __int64 v21; // r8 定位虚拟地址区域边界*/                        //
  unsigned __int64 v22; // r8 计算本轮最大安全块大小
  SIZE_T RemainingSize; // [rsp+48h] [rbp-3E0h] 剩余总字节数
//初始化  安全状态位
if ( (v11->SecureState.SecureHandle & 1) == 0 )
      v13 = 16 * (CopyFlags & 1) + 1;           // if (目标进程的该安全状态位成立)
正式分析,忽略了很多
首先是初始化和目标进程的该安全状态位成立 ,if ( (v11->SecureState.SecureHandle & 1) == 0 ) v13 = 16 * (CopyFlags & 1) + 1;
循环复制:
临时将当前线程的 CR3 页表寄存器切换到源进程(FromProcess)。KeStackAttachProcess(PROCESS: v11, &ApcState);
算出这块连续合法内存区域的结束边界 v21 v21 = v14 + RemainingSize;
KUSER_SHARED_DATA 共享数据区),直接按 4096 字节(1 页)边界处理,无需查 VAD 树 v21 = v19 + 4096;
计算本轮最大安全块大小 ChunkSize (v22) v22 = v21 - v14;
检查目标内存是不是硬件设备的 I/O 映射内存(MMIO),防止读取设备寄存器引发硬件副作用。ChunkSize = MiVadRangeIsIoSpace(a1: v17, a2: v14, a3: v22);
核心:MDL,Pool,Buffer(类比WRK源码)
- 本轮至少 512 字节&&本轮具备 MDL 路径资格
if ( ChunkSize >= 512 && (v15 & 2) != 0 )- 在栈上初始化 MemoryDescriptorList(MDL,内存描述符列表),记下虚拟地址、页内偏移和长度。
- 说明:源进程和目的进程都不是受保护的安全进程(即代码开头的 SecureState.SecureHandle & 1 == 0,VBS/Credential Guard 隔离进程不允许物理页直接映射),且不是特殊的受限 VAD 区域。
- v29 = MmMapLockedPagesSpecifyCache( // 给 MDL 描述的物理页建立映射 把刚才锁定的源进程物理页,直接映射到内核系统虚拟地址空间
- 否则,缓冲区分支:复用池、申请池,或者直接使用栈数组 memmove(内核临时缓冲区, target源地址,len)
- BounceBuffer = (PVOID)MiAllocatePool 动态申请内核池(Pool),每次减半重试
- 或小于等于512 则,BounceBuffer = v73; // 函数开头在内核栈上预留的 char v73[512] 局部数组 连内核池都不申请,直接在栈上中转
- v29 = BounceBuffer; // 统一的内核源指针 v29
最终memmove
从LABEL_48:开始,下半部分类似:
- 阶段 3:挂载目的进程 (ToProcess) 计算VAD边界并写入数据 (LABEL_48 - LABEL_66)
特殊:
- VslDebugReadWriteSecureProcess( // 如果目标进程受 VBS(虚拟化安全 / Credential Guard) 保护,它的内存受 Hypervisor 隔离,内核直接读会触发违例,必须通过 VTL 调用安全内核(Secure Kernel)代读。
- MiDbgReadWriteEnclave( // 如果目标内存属于 Intel SGX / VBS Enclave(飞地),必须走专门的飞地调试读取接口。
- LABEL_85 MmProbeAndLockPages 把源进程这块虚拟内存对应的物理内存页死死锁在物理内存中(防止被操作系统换出到磁盘页面文件),记录下它们的物理页帧号(PFN)。
释放API:
- MiUnlockAndDereferenceVadShared(P: v18);// 释放对应的 VAD 锁/引用
- KiUnstackDetachProcess(a1: (__int64)&ApcState, a2: 0);// 脱离源进程,恢复原本的页表
分析WRK后,win11的实现类似,但多了很多安全检查(虚拟化,硬件安全,漏洞预防)
| 对比维度 | WRK(Server 2003 时代) | 现代 Windows(Win10 / Win11) | 演进动因 |
|---|---|---|---|
| 1. 安全隔离适配 | 无(所有进程均在 Ring 3 平等运行) | 新增 SecureState检查、 VslDebugReadWriteSecureProcess和 MiDbgReadWriteEnclave |
适配 VBS(虚拟化安全 / Credential Guard) 和 Enclave(飞地),受保护进程的内存由 Hypervisor 隔离,必须通过 VTL 调用安全内核代读。 |
| 2. 内存区域精准校验 | 依赖 MmProbeAndLockPages触发异常捕获来判断地址合法性 |
每次循环先调用 **MiObtainReferencedVadEx**锁定并查询 VAD 边界,配合 **MiVadRangeIsIoSpace**过滤设备 I/O 空间 |
避免盲目读取触发硬件 MMIO 寄存器副作用(如清空硬件状态字导致蓝屏),同时防止跨 VAD 区域读取产生竞态条件。 |
一些疑惑,AI解释(可跳过)
一 为什么不统一使用MDL ?
直接映射(MDL)虽然在大块数据上少了一次拷贝,但它的前期准备与硬件代价极高
- 物理页锁定与锁竞争开销:
MmProbeAndLockPages必须操作全局的物理页帧数据库(PFN Database),还要修改页表项(PTE)防止物理页被换出。如果只是读一个int(4 字节),花在加锁、查 PFN 上的 CPU 周期是直接memcpy的几十倍。 - 系统 PTE 资源稀缺:
MmMapLockedPagesSpecifyCache需要消耗内核的系统页表项(System PTEs)来建立临时虚拟映射,并可能触发多核 CPU 的 TLB Shootdown(核间中断刷新快表)。高频小数据全走 MDL 会迅速耗尽系统 PTE 并拖慢整机性能。 - 内存对齐与安全限制:MDL 是按物理页(4KB)为单位进行锁定和映射的。如果目标内存跨页且处于受保护的 VBS 安全进程或设备 I/O 空间,硬件/Hypervisor 根本不允许将其物理页直接暴露映射出来,此时必须走中转缓冲区。
Win11 的 VAD 边界计算代码那么长?
你看反编译里出现类似 (((*(unsigned int *)(v20 + 28) | ((unsigned __int64)*(unsigned __int8 *)(v20 + 33) << 32)) << 12) | 0xFFF) + 1 这样极其冗长的位运算,主要有两个原因:
- 结构体极致压缩(位域拼接):
_MMVAD_SHORT是内核中最海量的结构体之一(每个进程都有成百上千个虚拟内存块)。为了省内存,微软把 64 位的结束页帧号(EndingVpn)拆成了低 32 位(EndingVpn)和高 8 位(EndingVpnHigh),分别塞在结构体里不同的空隙字节中。- 汇编和 F5 反编译器不认识这种手动拼接的位域,于是把“取出低 32 位 + 取出高 8 位左移 32 位 + 乘以 4096(
<< 12)算出页尾地址”全展开成了纯算术表达式。
- 现代 Windows 的防御性安全逻辑变复杂:
- 在进入公式前,代码还要过滤
KUSER_SHARED_DATA(0x7FFE0000)、校验VadFlags中的内存保护属性、判断是不是 Enclave(飞地) 或 VBS 安全进程,以及调用MiVadRangeIsIoSpace逐段排除硬件设备映射内存,防止读到一半撞上硬件寄存器。
- 在进入公式前,代码还要过滤
三 LABEL_48(目的进程阶段)与前半段是对称的吗?
在“主干流程”上是完全镜像对称的,但在“数据传输动作”上有本质区别:
- 完全对称的部分(环境准备与安全检查):
- 同样要
KeStackAttachProcess切换页表到目的进程(ToProcess)。 - 同样要判别内核地址还是用户地址,判别
0x7FFE0000。 - 同样要调
MiObtainReferencedVadEx锁定目的进程的 VAD 边界,防止写入越界。 - 同样要检查
MiVadRangeIsIoSpace(防误写硬件设备寄存器)以及判断是否属于 VBS/Enclave 安全进程。
- 同样要
- 不对称的核心部分(数据搬运动作):
- 前半段(读源进程):两条路径是分开的——MDL 路径只“锁页不拷贝”,缓冲路径执行
memmove读进内核缓冲区。 - 后半段(写目的进程):两条路径合二为一——此时源数据已经变成了统一的内核虚拟指针
v29(要么指向内核池/栈,要么指向 MDL 映射出来的内核地址),因此无论哪条路,统一直接执行memmove(目的地址, v29, 长度)完成写入。
- 前半段(读源进程):两条路径是分开的——MDL 路径只“锁页不拷贝”,缓冲路径执行
四、 读写共用一个函数,仅靠参数交换和 CopyFlags 有什么额外区分?
- 决定谁具备“走 MDL 零拷贝”的资格:
- 见代码开头:
v13 = 16 * (CopyFlags & 1) + 1;。 - 当
CopyFlags == 1(读操作)时,最低位1置位,允许优先走 MDL 物理页直接映射(锁定源进程的只读/读写物理页并映射到内核,安全性极高)。 - 当
CopyFlags == 0(写操作)时,最低位为0,直接剥夺 MDL 路径资格,强制所有写操作全部走中转缓冲区(BounceBuffer)路径!这是因为跨进程写入时涉及目标进程页表的写时复制(Copy-on-Write)触发和更复杂的页面权限变更,走中转缓冲区先拷进内核再切过去写更安全可控。
- 见代码开头:
- 决定 I/O 空间(MMIO)检查的方向:
CopyFlags & 1左移 4 位变成了v15中的0x10标志位,用于控制针对源端还是目的端执行更严格的设备 I/O 空间过滤。
- 配合外层
**DesiredAccess**决定 ETW 审计日志类型:- 在外层
MiReadWriteVirtualMemory末尾调用EtwTiLogReadWriteVm时,会根据传入的DesiredAccess(0x10读 vs0x20写)向杀毒软件/EDR 报告这究竟是一次“跨进程偷窥内存”还是一次“跨进程注入代码”。
- 在外层
动态调试验证 windbg
过程:
- 在虚拟机win11运行两个程序,windbg连接
- 附加到目标进程
- 待分析函数NtReadVirtualMemory下断点
- 查看调用堆栈,从KiSystemServiceCopyEnd 系统调用来的
- u查看汇编实现,传入操作码0x10,调用MiReadWriteVirtualMemory
- 查看寄存器查看变量值等
动态调试似乎起到的作用不大,AI和pdb符号,很多结构体或函数都有公开信息且代码不依赖于程序运行,可直接静态分析
!process 0 0 reader.exe 查找程序
PROCESS ffffxxxxxxxxxxxx 地址是 reader 的 EPROCESS 地址,不是 PID。用它设置断点:
bp /p <reader的EPROCESS地址> nt!NtReadVirtualMemory 下断点
0: kd> k 查看当前调用栈
Child-SP RetAddr Call Site
00 ffffcc82040f7428 fffff806f0886655 nt!NtReadVirtualMemory
01 ffffcc82040f7430 00007ff8609df5e4 nt!KiSystemServiceCopyEnd+0x25(见下图)
02 00000076f795faa8 00007ff85e35b20e 0x00007ff8`609df5e4
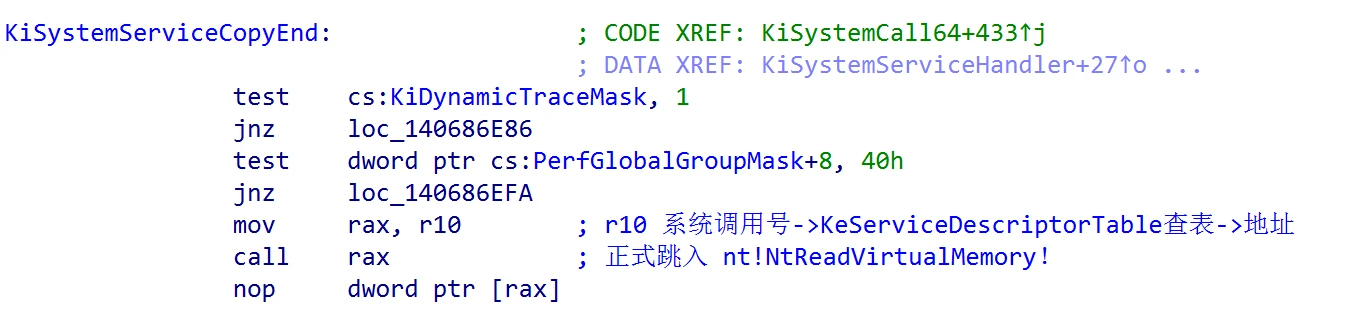
0: kd> u @rip L20 查看当前的汇编 NtReadVirtualMemory
nt!NtReadVirtualMemory:
fffff806`f0bb7c00 4883ec48        sub     rsp,48h
fffff806`f0bb7c04 488b442470      mov     rax,qword ptr [rsp+70h]
fffff806`f0bb7c09 c744243000000000 mov     dword ptr [rsp+30h],0
fffff806`f0bb7c11 c744242810000000 mov     dword ptr [rsp+28h],10h
fffff806`f0bb7c19 4889442420      mov     qword ptr [rsp+20h],rax
fffff806`f0bb7c1e e80d000000      call    nt!MiReadWriteVirtualMemory (fffff806`f0bb7c30)
fffff806`f0bb7c23 4883c448        add     rsp,48h
... 省略
nt!MiReadWriteVirtualMemory:
fffff806`f0bb7c30 488bc4          mov     rax,rsp
杂项
| 对比维度 | **ntdll!NtReadVirtualMemory** |
**nt!NtReadVirtualMemory** |
|---|---|---|
| 所在模块 | ntdll.dll(用户态核心动态链接库) |
ntoskrnl.exe(Windows 内核可执行文件) |
| 运行级别 | 用户态 (Ring 3) | 内核态 (Ring 0) |
**VslDebugReadWriteSecureProcess**** 是 Windows 内核(**ntoskrnl.exe**)中的一个未公开内部函数,主要用于在启用基于虚拟化的安全性(VBS)时,协助内核调试器读写受保护的安全进程(Trustlet / Isolated User Mode 进程)的内存。**
KernelArchive 在内核逆向分析中的作用:(没用到)
KernelArchive 是一个在线 Windows 内核公共符号(PDB)索引平台,在内核逆向分析中主要用于快速查询不同 Windows 版本(Build)下的未公开内核结构体字段偏移(如 _EPROCESS、_KPCR),帮助研究人员在反编译时还原硬编码的内存偏移。同时,它支持直接查看未导出内核函数的相对虚拟地址(RVA)、所在内存节区属性(如判断函数是否位于可分页的 PAGE 节区以规避高 IRQL 蓝屏),并能一键生成用于驱动特征码扫描(Pattern Scan)的字节序列及多版本兼容性验证,无需手动下载并解析庞大的官方 PDB 文件。
参考的相关博客,但感觉不如直接AI分析:
Windows API 理解----Nt* Zw* - 屁颠屁颠的小奶孩 - 博客园
https://bbs.kanxue.com/thread-279130-1.htm







