VMP(Virtual Machine Protection,虚拟机保护)简单说就是把.so中的关键代码转换成自定义的虚拟指令,交给程序内置的虚拟机执行,以此来增加逆向分析的难度。这里的VMP泛指代码虚拟化保护。
程序在正常情况下的执行顺序是,ARM64原生指令-> CPU直接执行。
经过虚拟化保护后,将关键代码转换成自定义字节码,再将字节码交由内置的解释器进行读取并且执行,结果保持不变。
简单来说就是将原本走直线的路径改成了多绕几圈。
实现后的解释器效果可以参考下图(图片来自某加固厂商)。
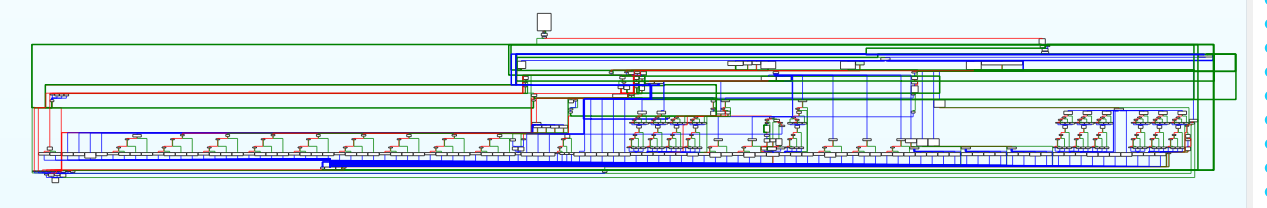
本文的目标就是自己手搓一个可以在安卓APP上运行的mini版本,以此来提升对虚拟化保护的理解。
下面这个就是将要受到保护的函数,可以很清晰的看出整体的逻辑非常的简单,对a、b两个参数进行加减乘除运算后将结果交由print_value函数打印日志。
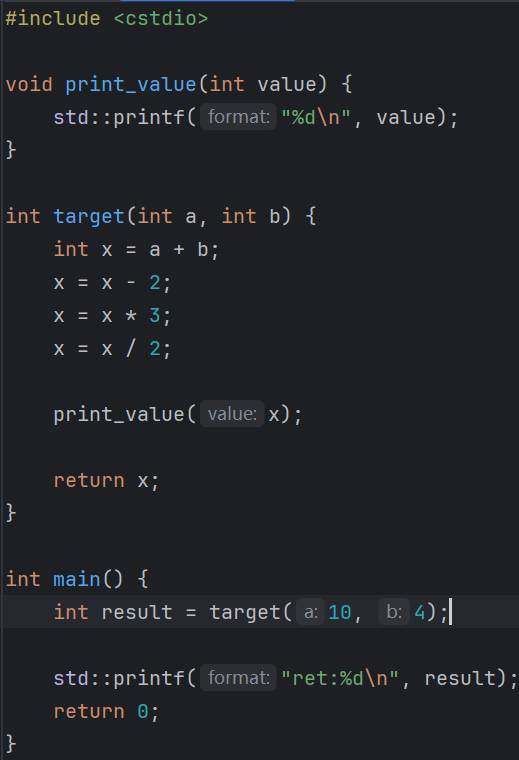
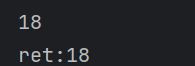
运行后的结果长这样
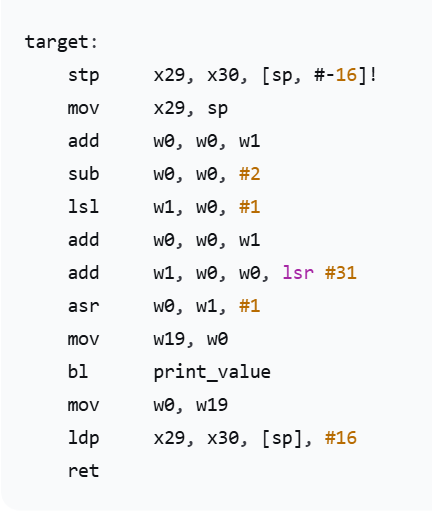
target函数经由编译器编译后的汇编大概长这样。
但是现在我想过要换一种组织方式去实现。
简单来说据就是我希望x=a+b不再只是一个固定写在target里的C++操作,而是可以通过一份数据表达出来。
假设说我要给另外一段程序发送一条计算要求,让他完成这句
这条要求至少需要说明:做什么操作(加法)、第一个数从哪里取(从a取)、第二个数从哪里取(从b取)、计算结果存放在哪里(放到x)。
如果说不知道这些的话,执行者就不知道该算什么、用什么算、算完存哪里。
当然也可以直接在数据里写a、b、x。设计完后指令长这样:
但是需要再去做一个按名字查找的表保存值
执行器读取这条指令时:
根据 "a" 查出 10;
根据 "b" 查出 4;
相加得到 14;
把名字 "x" 对应的值更新为 14。
这条路线是成立的 。 只是需要处理字符串,以及名字对应哪个值的查找。
所以说不论是用名字还是数字,都得自己规定:执行器去哪里取这些值 。
既然已经知道执行器需要拿到a、b,还需要一个地方保存结果x。
一个很普通的办法就是数组:
然后做一个约定
再把入参放进去:
此时,例如调用target(10, 4)
数组就是:
于是这里不需要再实现字符串查找,直接用数组下标就行。
现在已经有了int values[3] 。执行器会用这些位置保存输入和中间结果。如果说规定:
就可以把:values[2] = values[0] + values[1];
写成一种方便阅读的表示:R2 = R0 + R1
这里的虚拟寄存器并非是每一个虚拟机都是我这种的实现,也可以使用前面提到的按照名字保存值的表,操作数栈等其他存储方式。
原来由 a、b、x 承担的存储工作,现在可以由三个数组元素承担。但是它还没有实现由数据描述计算步骤。
因为这里values[2] = values[0] + values[1],仍然把加法和操作的位置都写死在了 C++ 代码里。
现在就是先把values[2] = values[0] + values[1]这里的三个下标拿出来。
把他们保存成一份数据
这里的顺序是按照下面约定排序的
所以{2, 0, 1},意思就是:
这里还要区分两个数组:
代码长这样
现在实现的是由数据决定操作数来自哪里,以及结果写到哪里。还是没有做到由数据决定做说明运算,因为
这里的 + 任然写死了。如果说下一步要减法,不可能再去写一个只会减法的执行器,这里需要在说明数据里面再去放一个字段,交代清楚执行器这次执行到底是加还是减。
还是最朴素的方式,约定
这两个数字没有特殊含义。
不是 CPU 规定 1 必须是加法,也不是 C++ 规定的。换成:
同样可以。只要写数据的人和读取数据的执行器遵守同一份约定就行 。
给原来的格式增加一个字段
原来是这样的约定:
现在新增字段后站这样:
于是unsigned char instruction[] = {1, 2, 0, 1}; 就表示values[2] = values[0] + values[1];
而 unsigned char instruction[] = {2, 2, 0, 1}; 就表示values[2] = values[0] - values[1];
现在有了操作码,就可以写成这样了
但是还需要去解决怎么根据不同的操作码做不同的事情
现在操作码是int op = instruction[0];那么只需要最普通的if判断就能实现
但是用1、2这种名称来记录对应关系不太行,可以起个别名。
现在就可以写成这样了
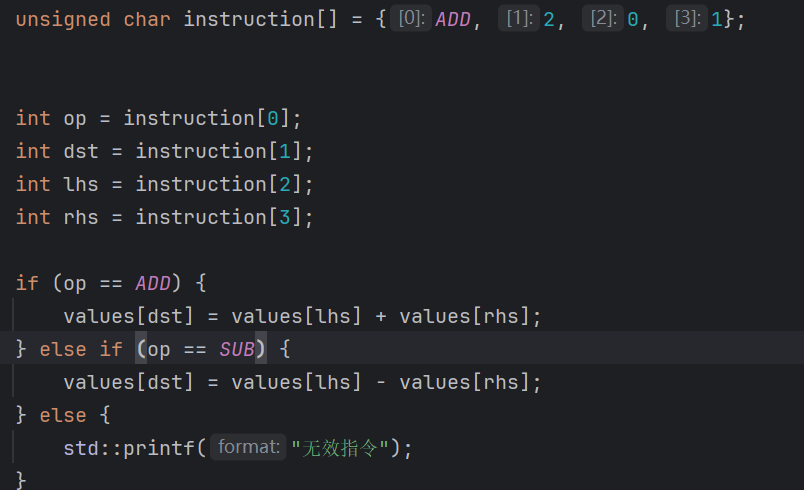
现在就拥有一条完整的、能够被执行器理解的指令(操作码,结果位置,左边来源,右边来源)
但是目前还是只能执行一条,在原函数中 需要先加、再减、再乘、再除。这就产生了一个新的问题,如果把多条指令接在统一数组里面,执行器怎么知道当前读到哪条了,以及下一条从哪里开始?
在前面我们只能描述int x = a + b;,现在可以新增一点,操作码在前面以及定义好了
第一步表示为
第二步表示为
接下来,一个直接的想法就是:把两条指令依次放进同一个数组。
这里从instruction改名为code,是因为他现在保存了一组指令,不再只是一条。
程序运行的时候知道前四个元素是一条指令,是因为我们做了每条指令固定占据四个元素。
这里的每个元素的类型是unsigned char,占一个C++字节,因此也可以说每条指令占据了四个字节。
这里先不用循环,用笨办法写一下看看。
目前执行一条指令时,我们这样读取:
如果要读第二条,很容易想到:
这里就有规律了,第一条的起点是0,第二条的起点是4,如果有第三条那么他的起点就是8,以此类推。
因为每条指令占据四个字节,所以每执行完一条,下一条的起点就向后移动四个字节。
我们不需要为每一条指令复制一套读取代码,只需要让读取起点发生变化。
比如说把当前读取起点保存成一个变量
offset就是偏移量。在这里,他表示当前这条指令的开头,距离code数组开头有多少个字节。
现在读取指令可以改成
当offset = 0;时,读的是
当offset = 4;时,读的是
读取代码没有变,但它能通过起点变化读取不同的指令。
所以我们可以把它改名为:
此pc非彼pc,在当前设计中,它只是字节码数组中的一个偏移量。之所以叫虚拟PC是因为在当前这套规则当中,他是负责跟踪虚拟指令的位置。
所以现在的执行顺序变成了
对应
因此
可以通过std::size_t code_size = sizeof(code);得到整个数组的字节数,也就是8。来做终止条件
只要没有走到数组末尾,就继续处理下一条指令。
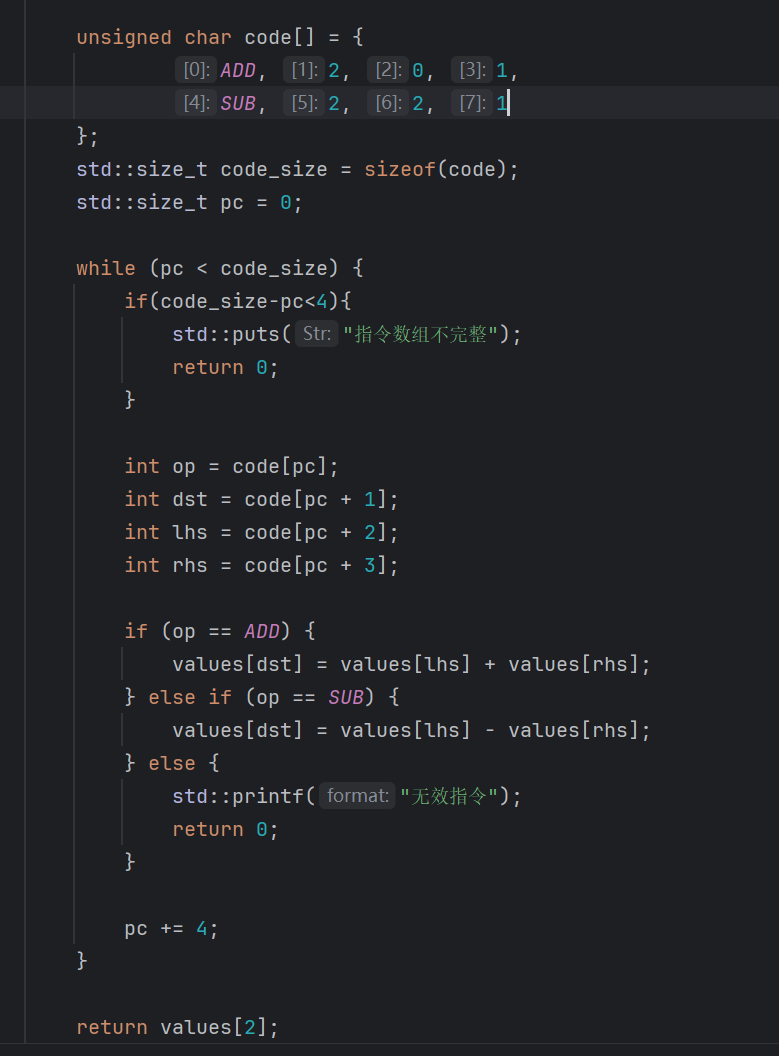
运行结果:
原函数前两步是:
第一步目前已经会表达,但是第二步是一个常量,根据前面定义的规则,没办法对这个常量进行计算。
要解决也很简单,为这个常量准备一个存储位置,然后从这个存储位置取值,就可以参与运算了。
最简单的办法就是直接values[3] = 2,然后
但是我们之前的目标是尽量让具体计算步骤由指令数据描述。那么往一个位置放入常量也可以由指令描述。
这里增加一种操作:
例如:把数值2写入位置3。
可以为这个指令起名叫做LOADI。数值直接写在指令里面,不需要根据位置编号再去别的地方读取。
新指令可以规定为
例如
表示
因为给LOADI的第三个字段规定的含义是直接数值,而不是来源位置。
数据里的一个字节到底表示位置还是数值,是由指令格式决定的,不是数字自己决定的。
最后一个放0是因为每条指令固定占据四个字节,而LOADI只需要三个字段,那么就需要多放一个作为填充。
在之前这里只有三个有效位置,现在想要使用位置3,就必须新增一个元素,最开始的约定也需要改变。
需要先给新操作分配一个编号
然后增加一种判断即可。但是需要先把变量名调整一下