首页
课程
问答
CTF
社区
招聘
峰会
发现
排行榜
知识库
工具下载
看雪20年
看雪商城
证书查询
登录
注册
首页
社区
课程
招聘
发现
问答
CTF
排行榜
知识库
工具下载
峰会
看雪商城
证书查询
社区
Pwn
发新帖
2
6
[原创]Linux内核攻击 USMA 解析
发表于: 2025-12-5 13:02
15776
[原创]Linux内核攻击 USMA 解析
Elenia
7
2025-12-5 13:02
15776
> USMA : USER SPEACE MAPPING ATTACK (用户空间映射攻击) > > 本文关于 Linux 源码的版本均为:6.12.32 ## 参考文章: - <mark class="encrypted">234K9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6D9N6r3k6S2x3h3I4Q4x3X3g2@1L8%4m8Q4x3V1j5J5x3o6t1#2i4K6u0r3x3o6u0Q4x3V1j5J5y4g2)9J5c8Y4y4&6M7%4c8W2L8g2)9J5c8X3E0W2M7X3&6W2L8q4)9J5c8V1I4A6L8Y4g2^5i4K6g2X3K9$3g2J5L8X3g2D9z5q4)9#2k6W2g2e0e0f1q4Q4x3V1j5`.</mark> ## Pakcet Socket > USMA 利用的是 socket 的 pgv 数组,所以我们在这里先深入了解一下 PacketSocket 的数据结构,在这里我们还是主要关注 pgv 的创建和映射,关于Socket其他板块的详细解析可以看我其他的文章。 ### 数据结构 #### packet_socket > 我们这里主要关注 rx_ring/tx_ing,这是我们后续利用的关键数据结构。 > > 所以相当于除去 struct socket 以外其他均为 packetsocket 独有的结构. - sk: 继承的通用 socket * - fanout: fanout 组 - rx_ring/tx_ring: 接收/发送环形缓冲区(mmap) - prot_hook: 协议钩子,用于接收数据包 - ifindex: 绑定的网络设备索引 - tp_version: TPACKET 版本(V1/V2/V3) ```C++ struct packet_sock { /* struct sock has to be the first member of packet_sock */ struct sock sk; struct packet_fanout *fanout; union tpacket_stats_u stats; struct packet_ring_buffer rx_ring; struct packet_ring_buffer tx_ring; int copy_thresh; spinlock_t bind_lock; struct mutex pg_vec_lock; unsigned long flags; int ifindex; /* bound device */ u8 vnet_hdr_sz; __be16 num; struct packet_rollover *rollover; struct packet_mclist *mclist; atomic_long_t mapped; enum tpacket_versions tp_version; unsigned int tp_hdrlen; unsigned int tp_reserve; unsigned int tp_tstamp; struct completion skb_completion; struct net_device __rcu *cached_dev; struct packet_type prot_hook ____cacheline_aligned_in_smp; atomic_t tp_drops ____cacheline_aligned_in_smp; }; ``` #### packet_ring_buffer [核心] > 正常 Linux Socket 的传输数据需要进行用户层到内核层的拷贝,然后发送后又需要内核层到用户层的拷贝,比较消耗性能。所以类似于 zerocopy 的设计思想,Linux 在 PacketSocket 中设计了共享环形结构,让用户态可以直接将数据写入环形结构避免了拷贝操作。当然如果设置了 ring_buffer ,但是不使用mmap是没有使用到 zerocopy 的。 > > ring_buffer 是 packet_socket 独有的数据结构。当没有设置 PACKET_RX_RING 或 PACKET_TX_RING 时,Packet_socket 和正常的 socket 一样都使用标准的 sk_receive_queue/sk_write_queue。 - pg_vec 是 pgv 数组,每个元素对应一个 block - pg_vec_len 是 block 数量 - pg_vec_pages 是每个 block 的页数 - pg_vec_order 是页分配阶数 ```C++ struct packet_ring_buffer { struct pgv *pg_vec; unsigned int head; unsigned int frames_per_block; unsigned int frame_size; unsigned int frame_max; unsigned int pg_vec_order; unsigned int pg_vec_pages; unsigned int pg_vec_len; unsigned int __percpu *pending_refcnt; union { unsigned long *rx_owner_map; struct tpacket_kbdq_core prb_bdqc; }; }; ``` #### Pg_vec [漏洞目标结构] 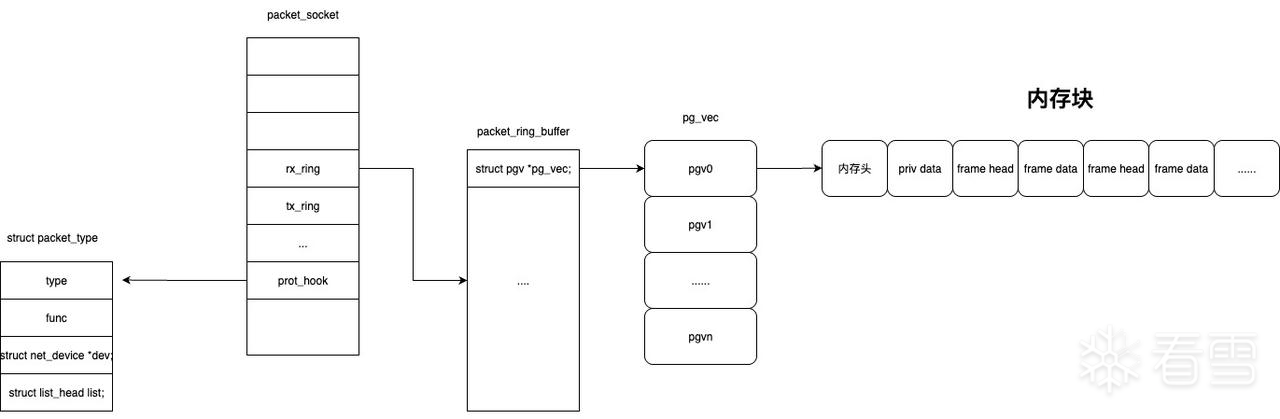 - pgv(Page Vector)是页向量,每个 pgv 指向一个内存块(block)的起始地址,一个block对应一个或者多个完整的page。 - buffer 指向该 block 的实际内存,Block 用于存储我们的网络请求等信息。 ```C struct pgv { char *buffer; }; ``` #### Socket 缓冲区对比 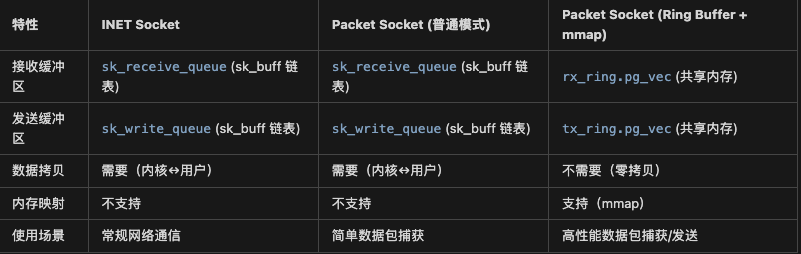 ### Socket 创建流程 #### 调用链 ```C 用户空间: socket(AF_PACKET, SOCK_RAW, htons(ETH_P_ALL)) ↓ sys_socket() ↓ __sock_create() ↓ pf->create() [packet_proto.create = packet_create] ↓ packet_create() ├─ sk_alloc() // 分配 sock 和 packet_sock ├─ packet_alloc_pending() // 分配 pending 结构 ├─ sock_init_data() // 初始化 sock 数据 ├─ mutex_init(&po->pg_vec_lock) // 初始化 pg_vec 锁 ├─ po->prot_hook.func = packet_rcv // 设置接收函数 └─ __register_prot_hook() // 注册协议钩子 └─ dev_add_pack(&po->prot_hook) // 添加到协议栈 ``` ### Setsockopt 设置 RingBuffer > 用户通过 setsockopt 设置 PACKET_RX_RING 或 PACKET_TX_RING,最终调用 packet_set_ring,设置环形缓冲区。 #### 调用链 ```C 用户空间: setsockopt(fd, SOL_PACKET, PACKET_RX_RING, &req, sizeof(req)) ↓ sys_setsockopt() ↓ sock_setsockopt() ↓ packet_setsockopt() ↓ case PACKET_RX_RING: packet_set_ring() ├─ 参数验证 ├─ order = get_order(req->tp_block_size) // 计算页阶数 ├─ alloc_pg_vec(req, order) // 分配 pg_vec 数组 │ ├─ kcalloc(block_nr, sizeof(struct pgv)) // 分配 pg_vec 数组 │ └─ for each block: │ └─ alloc_one_pg_vec_page(order) // 分配每个 block 的内存 │ ├─ __get_free_pages() // 优先使用连续物理页 │ ├─ vzalloc() // 失败则使用虚拟连续内存 │ └─ __get_free_pages() // 最后重试(允许 swap) ├─ init_prb_bdqc() [V3 only] // 初始化 V3 块描述符 │ ├─ p1->pkbdq = pg_vec // 设置 pg_vec 指针 │ └─ prb_open_block() // 打开第一个 block ├─ 临时卸载协议钩子 ├─ swap(rb->pg_vec, pg_vec) // 交换 pg_vec ├─ 设置 ring buffer 参数 └─ 重新注册协议钩子 └─ po->prot_hook.func = tpacket_rcv // 切换到 tpacket_rcv ``` #### packet_set_ring(入口) - 参数校验(block_size、frame_size 等) - 计算 order(页分配阶数) - 调用 alloc_pg_vec 分配 pg_vec - 根据版本初始化(V3 调用 init_prb_bdqc,V1/V2 分配 rx_owner_map) - 临时卸载协议钩子,设置 pg_vec,再重新注册 - 若设置了 rx_ring.pg_vec,将接收函数切换为 tpacket_rcv ```C++ static int packet_set_ring(struct sock *sk, union tpacket_req_u *req_u, int closing, int tx_ring) { struct pgv *pg_vec = NULL; struct packet_sock *po = pkt_sk(sk); unsigned long *rx_owner_map = NULL; int was_running, order = 0; struct packet_ring_buffer *rb; struct sk_buff_head *rb_queue; __be16 num; int err; /* Added to avoid minimal code churn */ struct tpacket_req *req = &req_u->req; rb = tx_ring ? &po->tx_ring : &po->rx_ring; rb_queue = tx_ring ? &sk->sk_write_queue : &sk->sk_receive_queue; err = -EBUSY; if (!closing) { if (atomic_long_read(&po->mapped)) goto out; if (packet_read_pending(rb)) goto out; } if (req->tp_block_nr) { unsigned int min_frame_size; /* Sanity tests and some calculations */ err = -EBUSY; if (unlikely(rb->pg_vec)) goto out; switch (po->tp_version) { case TPACKET_V1: po->tp_hdrlen = TPACKET_HDRLEN; break; case TPACKET_V2: po->tp_hdrlen = TPACKET2_HDRLEN; break; case TPACKET_V3: po->tp_hdrlen = TPACKET3_HDRLEN; break; } err = -EINVAL; if (unlikely((int)req->tp_block_size <= 0)) goto out; if (unlikely(!PAGE_ALIGNED(req->tp_block_size))) goto out; min_frame_size = po->tp_hdrlen + po->tp_reserve; if (po->tp_version >= TPACKET_V3 && req->tp_block_size < BLK_PLUS_PRIV((u64)req_u->req3.tp_sizeof_priv) + min_frame_size) goto out; if (unlikely(req->tp_frame_size < min_frame_size)) goto out; if (unlikely(req->tp_frame_size & (TPACKET_ALIGNMENT - 1))) goto out; rb->frames_per_block = req->tp_block_size / req->tp_frame_size; if (unlikely(rb->frames_per_block == 0)) goto out; if (unlikely(rb->frames_per_block > UINT_MAX / req->tp_block_nr)) goto out; if (unlikely((rb->frames_per_block * req->tp_block_nr) != req->tp_frame_nr)) goto out; err = -ENOMEM; order = get_order(req->tp_block_size); pg_vec = alloc_pg_vec(req, order); if (unlikely(!pg_vec)) goto out; switch (po->tp_version) { case TPACKET_V3: /* Block transmit is not supported yet */ if (!tx_ring) { init_prb_bdqc(po, rb, pg_vec, req_u); } else { struct tpacket_req3 *req3 = &req_u->req3; if (req3->tp_retire_blk_tov || req3->tp_sizeof_priv || req3->tp_feature_req_word) { err = -EINVAL; goto out_free_pg_vec; } } break; default: if (!tx_ring) { rx_owner_map = bitmap_alloc(req->tp_frame_nr, GFP_KERNEL | __GFP_NOWARN | __GFP_ZERO); if (!rx_owner_map) goto out_free_pg_vec; } break; } } /* Done */ else { err = -EINVAL; if (unlikely(req->tp_frame_nr)) goto out; } /* Detach socket from network */ spin_lock(&po->bind_lock); was_running = packet_sock_flag(po, PACKET_SOCK_RUNNING); num = po->num; if (was_running) { WRITE_ONCE(po->num, 0); __unregister_prot_hook(sk, false); } spin_unlock(&po->bind_lock); synchronize_net(); err = -EBUSY; mutex_lock(&po->pg_vec_lock); if (closing || atomic_long_read(&po->mapped) == 0) { err = 0; spin_lock_bh(&rb_queue->lock); swap(rb->pg_vec, pg_vec); if (po->tp_version <= TPACKET_V2) swap(rb->rx_owner_map, rx_owner_map); rb->frame_max = (req->tp_frame_nr - 1); rb->head = 0; rb->frame_size = req->tp_frame_size; spin_unlock_bh(&rb_queue->lock); swap(rb->pg_vec_order, order); swap(rb->pg_vec_len, req->tp_block_nr); rb->pg_vec_pages = req->tp_block_size/PAGE_SIZE; po->prot_hook.func = (po->rx_ring.pg_vec) ? tpacket_rcv : packet_rcv; skb_queue_purge(rb_queue); if (atomic_long_read(&po->mapped)) pr_err("packet_mmap: vma is busy: %ld\n", atomic_long_read(&po->mapped)); } mutex_unlock(&po->pg_vec_lock); spin_lock(&po->bind_lock); if (was_running) { WRITE_ONCE(po->num, num); register_prot_hook(sk); } spin_unlock(&po->bind_lock); if (pg_vec && (po->tp_version > TPACKET_V2)) { /* Because we don't support block-based V3 on tx-ring */ if (!tx_ring) prb_shutdown_retire_blk_timer(po, rb_queue); } out_free_pg_vec: if (pg_vec) { bitmap_free(rx_owner_map); free_pg_vec(pg_vec, order, req->tp_block_nr); } out: return err; } ``` #### alloc_pg_vec 函数 (核心) > pg_vec 是 kcalloc 分配 > > Pgv 的 buffer 是通过 alloc_one_pg_vec_page 分配 - 分配 pg_vec 数组(kcalloc) - 为每个 block 调用 alloc_one_pg_vec_page 分配内存 ```C static struct pgv *alloc_pg_vec(struct tpacket_req *req, int order) { unsigned int block_nr = req->tp_block_nr; // block 数量 struct pgv *pg_vec; // pgv 数组指针 int i; // 分配 pg_vec 数组,大小为 block_nr 个 pgv 结构体 pg_vec = kcalloc(block_nr, sizeof(struct pgv), GFP_KERNEL | __GFP_NOWARN); if (unlikely(!pg_vec)) goto out; // 为每个 block 分配内存页 for (i = 0; i < block_nr; i++) { // 分配一个 block 的内存(2^order 页) pg_vec[i].buffer = alloc_one_pg_vec_page(order); if (unlikely(!pg_vec[i].buffer)) goto out_free_pgvec; // 失败则释放已分配的 } out: return pg_vec; out_free_pgvec: // 释放已分配的 pg_vec(包括所有已分配的 buffer) free_pg_vec(pg_vec, order, block_nr); pg_vec = NULL; goto out; } ``` #### alloc_one_pg_vec_page( buffer 分配函数) > 所以我们知道正常情况下 block 对应一个或者多个连续的page - 优先使用 __get_free_pages(连续物理页) - 失败则用 vzalloc(虚拟连续) - 再失败则重试 __get_free_pages(允许交换) ```SQL static char *alloc_one_pg_vec_page(unsigned long order) { char *buffer; gfp_t gfp_flags = GFP_KERNEL | __GFP_COMP | __GFP_ZERO | __GFP_NOWARN | __GFP_NORETRY; buffer = (char *) __get_free_pages(gfp_flags, order); if (buffer) return buffer; /* __get_free_pages failed, fall back to vmalloc */ buffer = vzalloc(array_size((1 << order), PAGE_SIZE)); if (buffer) return buffer; /* vmalloc failed, lets dig into swap here */ gfp_flags &= ~__GFP_NORETRY; buffer = (char *) __get_free_pages(gfp_flags, order); if (buffer) return buffer; /* complete and utter failure */ return NULL; } ``` ### Pgv 内存映射 #### 调用链 ```C 用户空间: mmap(fd, ...) ↓ sys_mmap() ↓ packet_mmap() ├─ mutex_lock(&po->pg_vec_lock) ├─ 计算 expected_size = pg_vec_len * pg_vec_pages * PAGE_SIZE ├─ for each ring buffer: │ └─ for each pg_vec[i]: │ └─ for each page in block: │ └─ vm_insert_page() // 将物理页映射到用户空间 ├─ atomic_long_inc(&po->mapped) // 增加映射计数 └─ mutex_unlock(&po->pg_vec_lock) ``` #### 流程图 ##### Mmap 映射流程图 ```SQL 用户空间程序 | | mmap(fd, addr, len, PROT_READ|PROT_WRITE, MAP_SHARED, 0, 0) | v sys_mmap() / sys_mmap2() | | 系统调用入口 | v ksys_mmap_pgoff() | | 处理 mmap 系统调用 | v vm_mmap_pgoff() | | 分配 VMA 并调用文件操作 | v call_mmap() | | 调用 file->f_op->mmap | v socket_file_ops.mmap | | Socket 文件操作 | v sock_map_mmap() | | 调用 socket->ops->mmap | v packet_ops.mmap | | Packet socket 操作 | v packet_mmap() <--- 我们的目标函数 | | 执行映射操作 | +---> mutex_lock(&po->pg_vec_lock) | +---> 计算 expected_size | | | +---> 遍历 rx_ring 和 tx_ring | +---> 累加: pg_vec_len * pg_vec_pages * PAGE_SIZE | +---> 验证 size == expected_size | +---> 映射每一页 | | | +---> for each ring buffer (rx_ring, tx_ring) | | | | | +---> for each block (pg_vec[i]) | | | | | | | +---> for each page in block | | | | | | | | | +---> pgv_to_page(kaddr) | | | | | | | | | | | +---> is_vmalloc_addr()? | | | | | | YES -> vmalloc_to_page() | | | | | | NO -> virt_to_page() | | | | | | | | | +---> vm_insert_page(vma, start, page) | | | | | | | | | +---> 建立页表项 | | | | +---> 将用户虚拟地址映射到物理页 | +---> atomic_long_inc(&po->mapped) | +---> vma->vm_ops = &packet_mmap_ops | +---> mutex_unlock(&po->pg_vec_lock) | v 返回 0(成功)或错误码 ``` ##### 访问映射地址流程图 ```C 用户空间访问 start 地址 | v CPU 发出虚拟地址 start | v MMU 查询页表 | | 页表项 (PTE) 已由 set_pte_at() 建立 | PTE 包含 page 的物理地址 | v MMU 将虚拟地址转换为物理地址 | v 访问物理内存(buffer 对应的 page) ``` #### packet_mmap > 获取 buffer 对应的 page,然后将 page 加入页表中,这样用户态访问对应虚拟地址就会去访问对应的page内容。 ```C++ /** * packet_mmap - 将 packet socket 的 ring buffer 映射到用户空间 * * @file: socket 对应的文件结构体指针 * @sock: socket 结构体指针 * @vma: 虚拟内存区域结构体,描述用户空间要映射的内存区域 * * 功能说明: * 1. 将 packet_sock 中的 rx_ring 和 tx_ring 的物理页映射到用户空间 * 2. 实现零拷贝:用户态可以直接访问内核的 ring buffer,无需数据拷贝 * 3. 映射后,用户态可以通过直接读写 ring buffer 来收发数据包 * * 返回值: * 0 - 成功 * -EINVAL - 参数错误(vm_pgoff 不为0,或大小不匹配,或没有 ring buffer) * 其他 - vm_insert_page 失败的错误码 */ static int packet_mmap(struct file *file, struct socket *sock, struct vm_area_struct *vma) { struct sock *sk = sock->sk; // 获取底层 sock 结构 struct packet_sock *po = pkt_sk(sk); // 转换为 packet_sock unsigned long size, expected_size; // size: 用户请求的映射大小 // expected_size: 实际需要的映射大小 struct packet_ring_buffer *rb; // 遍历用的 ring buffer 指针 unsigned long start; // 当前映射的起始虚拟地址 int err = -EINVAL; // 错误码,默认参数错误 int i; /* * 检查 vm_pgoff(页偏移量) * vm_pgoff 必须为 0,表示从文件/设备的开头开始映射 * 如果不为 0,说明用户想要映射文件的某个偏移位置,但 packet socket 不支持 */ if (vma->vm_pgoff) return -EINVAL; /* * 获取 pg_vec_lock 互斥锁 * 这个锁保护 pg_vec 的并发访问,防止在映射过程中 ring buffer 被修改或释放 */ mutex_lock(&po->pg_vec_lock); /* * 第一步:计算期望的映射大小 * 遍历 rx_ring 和 tx_ring,累加所有 ring buffer 的总大小 * * 计算公式: * expected_size = Σ (pg_vec_len * pg_vec_pages * PAGE_SIZE) * * 其中: * - pg_vec_len: block 的数量(pg_vec 数组的长度) * - pg_vec_pages: 每个 block 包含的页数 * - PAGE_SIZE: 页大小(通常 4KB) * * 例如:如果有 4 个 block,每个 block 是 2 页(8KB),则: * expected_size = 4 * 2 * 4096 = 32KB */ expected_size = 0; for (rb = &po->rx_ring; rb <= &po->tx_ring; rb++) { // 遍历 rx_ring 和 tx_ring if (rb->pg_vec) { // 如果该 ring buffer 已分配 expected_size += rb->pg_vec_len // block 数量 * rb->pg_vec_pages // 每个 block 的页数 * PAGE_SIZE; // 页大小 } } /* * 检查:如果没有 ring buffer,无法映射 * 用户必须先通过 setsockopt(PACKET_RX_RING/PACKET_TX_RING) 设置 ring buffer */ if (expected_size == 0) goto out; /* * 第二步:验证用户请求的映射大小 * vma->vm_end - vma->vm_start 是用户空间 mmap 调用时请求的映射大小 * 这个大小必须精确等于 expected_size,不能多也不能少 * * 为什么必须精确匹配? * - 如果用户请求的大小小于实际大小,会导致部分 ring buffer 无法映射 * - 如果用户请求的大小大于实际大小,会导致访问越界 * - 精确匹配确保用户空间和内核空间对映射区域的理解一致 */ size = vma->vm_end - vma->vm_start; // 用户请求的映射大小 if (size != expected_size) goto out; /* * 第三步:执行实际的页映射操作 * 将每个 ring buffer 中的每个 block 的每一页都映射到用户空间 * * 映射顺序: * 1. 先映射 rx_ring 的所有页 * 2. 再映射 tx_ring 的所有页 * 3. 在每个 ring buffer 内,按照 pg_vec 数组的顺序映射 * 4. 在每个 block 内,按照页的顺序映射 */ start = vma->vm_start; // 从用户空间请求的起始地址开始 for (rb = &po->rx_ring; rb <= &po->tx_ring; rb++) { // 遍历 rx_ring 和 tx_ring if (rb->pg_vec == NULL) // 跳过未分配的 ring buffer continue; /* * 遍历该 ring buffer 中的每个 block(pg_vec 数组的每个元素) * pg_vec_len 是 block 的数量 */ for (i = 0; i < rb->pg_vec_len; i++) { struct page *page; // 要映射的物理页结构 void *kaddr = rb->pg_vec[i].buffer; // 当前 block 的内核虚拟地址 int pg_num; // block 内的页索引 /* * 遍历该 block 中的每一页 * pg_vec_pages 是该 block 包含的页数 * * 例如:如果 block_size = 8192 (2页),则 pg_vec_pages = 2 */ for (pg_num = 0; pg_num < rb->pg_vec_pages; pg_num++) { /* * pgv_to_page: 将内核虚拟地址转换为 page 结构体指针 * * 这个函数处理两种情况: * 1. 如果 buffer 是通过 __get_free_pages 分配的(连续物理页) * 使用 virt_to_page 转换 * 2. 如果 buffer 是通过 vmalloc 分配的(虚拟连续,物理可能不连续) * 使用 vmalloc_to_page 转换 */ page = pgv_to_page(kaddr); /* * vm_insert_page: 将物理页插入到用户空间的虚拟地址空间 * * @vma: 虚拟内存区域 * @start: 用户空间的虚拟地址(页对齐) * @page: 要映射的物理页 * * 功能: * - 建立页表项,将用户空间的虚拟地址 start 映射到物理页 page * - 用户空间访问 start 时,会直接访问到 page 对应的物理内存 * - 实现了内核和用户空间共享同一块物理内存(零拷贝) * * 返回值: * 0 - 成功 * 负数 - 失败(如内存不足、地址冲突等) */ err = vm_insert_page(vma, start, page); if (unlikely(err)) goto out; // 映射失败,跳转到错误处理 /* * 更新映射地址和内核地址 * - start: 用户空间下一个要映射的虚拟地址 * - kaddr: 内核空间下一个页的虚拟地址 */ start += PAGE_SIZE; // 用户空间地址前进一页 kaddr += PAGE_SIZE; // 内核空间地址前进一页 } } } /* * 第四步:映射成功后的收尾工作 * * 1. 增加映射计数 * mapped 计数器用于跟踪有多少个 VMA 映射了这个 socket * 当 socket 关闭或 ring buffer 被修改时,需要检查这个计数 * 如果 mapped > 0,说明用户空间还在使用,不能释放 ring buffer */ atomic_long_inc(&po->mapped); /* * 2. 设置 VMA 操作回调函数 * packet_mmap_ops 包含两个回调: * - .open: 当 VMA 被 fork 时调用(增加 mapped 计数) * - .close: 当 VMA 被关闭时调用(减少 mapped 计数) * * 这样可以在进程 fork 或退出时正确维护 mapped 计数 */ vma->vm_ops = &packet_mmap_ops; err = 0; // 成功 out: /* * 释放互斥锁并返回错误码 * 无论成功还是失败,都要释放锁 */ mutex_unlock(&po->pg_vec_lock); return err; } ``` ## 攻击 ### 原理 > 攻击的主要是 packet_mmap 映射这个过程。仔细研究 packet_mmap 我们可以发现,如果我们能够修改 pg_vec ,那么就可以任意将内核的 page 映射到用户态。比如最常见的利用方式,就是将内核代码段的page映射出来,实现任意代码修改。 并且通过上文我们知道由于 pg_vec 是根据 `kcalloc(block_nr, sizeof(struct pgv), GFP_KERNEL | __GFP_NOWARN);` 获取的。 sizeof(struct pgv)为 8字节,然后我们可以控制 block_nr 的数量,那么我们就可以控制 pgv 为任意大小的 object,非常有利于我们的堆喷。 ```C++ /* * 遍历该 ring buffer 中的每个 block(pg_vec 数组的每个元素) * pg_vec_len 是 block 的数量 */ for (i = 0; i < rb->pg_vec_len; i++) { struct page *page; // 要映射的物理页结构 void *kaddr = rb->pg_vec[i].buffer; // 当前 block 的内核虚拟地址 int pg_num; // block 内的页索引 /* * 遍历该 block 中的每一页 * pg_vec_pages 是该 block 包含的页数 * * 例如:如果 block_size = 8192 (2页),则 pg_vec_pages = 2 */ for (pg_num = 0; pg_num < rb->pg_vec_pages; pg_num++) { /* * pgv_to_page: 将内核虚拟地址转换为 page 结构体指针 * * 这个函数处理两种情况: * 1. 如果 buffer 是通过 __get_free_pages 分配的(连续物理页) * 使用 virt_to_page 转换 * 2. 如果 buffer 是通过 vmalloc 分配的(虚拟连续,物理可能不连续) * 使用 vmalloc_to_page 转换 */ page = pgv_to_page(kaddr); /* * vm_insert_page: 将物理页插入到用户空间的虚拟地址空间 * * @vma: 虚拟内存区域 * @start: 用户空间的虚拟地址(页对齐) * @page: 要映射的物理页 * * 功能: * - 建立页表项,将用户空间的虚拟地址 start 映射到物理页 page * - 用户空间访问 start 时,会直接访问到 page 对应的物理内存 * - 实现了内核和用户空间共享同一块物理内存(零拷贝) * * 返回值: * 0 - 成功 * 负数 - 失败(如内存不足、地址冲突等) */ err = vm_insert_page(vma, start, page); if (unlikely(err)) goto out; // 映射失败,跳转到错误处理 /* * 更新映射地址和内核地址 * - start: 用户空间下一个要映射的虚拟地址 * - kaddr: 内核空间下一个页的虚拟地址 */ start += PAGE_SIZE; // 用户空间地址前进一页 kaddr += PAGE_SIZE; // 内核空间地址前进一页 } } ``` ### Page 校验 > 当然在利用过程中,我们得仔细看看是否对 page 有什么检查 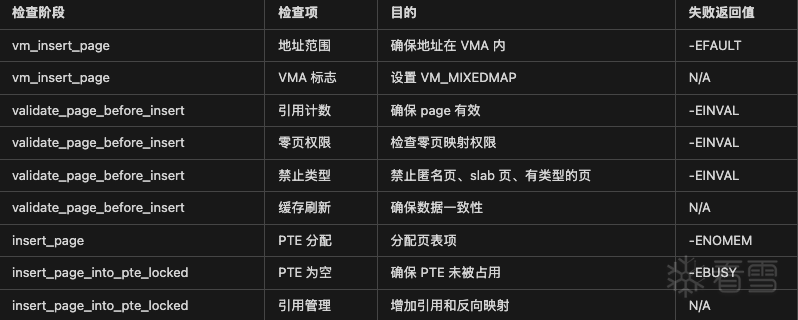 ```Java vm_insert_page(vma, addr, page) [校验 1, 2] | ├─> [校验 1: 地址范围检查] | if (addr < vma->vm_start || addr >= vma->vm_end) | return -EFAULT; | ├─> [校验 2: VMA 标志检查] | if (!(vma->vm_flags & VM_MIXEDMAP)) { | BUG_ON(vma->vm_flags & VM_PFNMAP); // 冲突检查 | vm_flags_set(vma, VM_MIXEDMAP); | } | └─> insert_page(vma, addr, page, prot) [校验 3, 4] | ├─> [校验 3: Page 校验] | validate_page_before_insert(vma, page) [校验 3.1-3.4] | | | ├─> page_folio(page) // 转换为 folio | | | ├─> [校验 3.1: 引用计数检查] | | folio_ref_count(folio) == 0? | | | YES -> return -EINVAL | | | ├─> [校验 3.2: 零页检查] | | is_zero_folio(folio)? | | | YES -> vm_mixed_zeropage_allowed(vma) | | | | NO -> return -EINVAL | | | | YES -> return 0 (允许) | | | ├─> [校验 3.3: 禁止类型检查] | | folio_test_anon(folio) // 检查是否是匿名页 | | | // 匿名页由缺页处理程序管理,不应直接映射 | | | YES -> return -EINVAL | | | | folio_test_slab(folio) // 检查是否是 slab 页 | | | // slab 页属于内核内存管理,不应映射到用户空间 | | | YES -> return -EINVAL | | | | page_has_type(page) // 检查是否有特殊类型 | | | // 检查 page_type 字段,禁止 buddy、offline、 | | | // table、guard、hugetlb、slab、zsmalloc 等类型 | | └─> page_mapcount_is_type(page->page_type) | | └─> page_type_has_type(mapcount - 1) | | └─> page_type < (PGTY_mapcount_underflow << 24) | | | YES -> return -EINVAL | | | └─> flush_dcache_folio(folio) // 缓存刷新 | ├─> [校验 4: PTE 分配] | get_locked_pte(vma->vm_mm, addr, &ptl) | | | └─> __get_locked_pte(mm, addr, ptl) | | | ├─> walk_to_pmd(mm, addr) // 遍历页表层次 | | ├─> pgd_offset() | | ├─> p4d_alloc() | | ├─> pud_alloc() | | └─> pmd_alloc() | | | └─> pte_alloc_map_lock(mm, pmd, addr, ptl) | ├─> pte_alloc(mm, pmd) // 分配 PTE 页表(如需要) | | └─> __pte_alloc() | | ├─> pte_alloc_one() // 分配页表页 | | └─> pmd_install() // 安装到 PMD | | | └─> pte_offset_map_lock() // 获取 PTE 指针并锁定 | | if (!pte) // 分配失败 | return -ENOMEM | └─> insert_page_into_pte_locked(vma, pte, addr, page, prot) [校验 5, 6] | ├─> page_folio(page) | ├─> [校验 5: PTE 为空检查] | pte_none(ptep_get(pte)) | | NO -> return -EBUSY | ├─> mk_pte(page, prot) | ├─> [校验 6: 零页处理和引用管理] | if (is_zero_folio(folio)) { | pteval = pte_mkspecial(pteval); | } else { | folio_get(folio); // 增加引用 | inc_mm_counter(...); // 增加计数 | folio_add_file_rmap_pte(...); // 添加映射 | } | └─> set_pte_at(vma->vm_mm, addr, pte, pteval) ``` #### vm_insert_page (入口) - 检查 addr 是否在 vma 范围 ```C++ int vm_insert_page(struct vm_area_struct *vma, unsigned long addr, struct page *page) { // 确保 addr 在 vma 范围内 if (addr < vma->vm_start || addr >= vma->vm_end) return -EFAULT; // 设置 VM_MIXEDMAP,允许混合映射(普通页与特殊页) if (!(vma->vm_flags & VM_MIXEDMAP)) { BUG_ON(mmap_read_trylock(vma->vm_mm)); BUG_ON(vma->vm_flags & VM_PFNMAP); vm_flags_set(vma, VM_MIXEDMAP); } return insert_page(vma, addr, page, vma->vm_page_prot); } ``` #### insert_page (核心) ```C++ static int insert_page(struct vm_area_struct *vma, unsigned long addr, struct page *page, pgprot_t prot) { int retval; pte_t *pte; spinlock_t *ptl; retval = validate_page_before_insert(vma, page); if (retval) goto out; retval = -ENOMEM; pte = get_locked_pte(vma->vm_mm, addr, &ptl); if (!pte) goto out; retval = insert_page_into_pte_locked(vma, pte, addr, page, prot); pte_unmap_unlock(pte, ptl); out: return retval; } ``` #### validate_page_before_insert - 引用计数检查 - Zero page 特殊处理 - 禁止匿名页,slab页面,有类型的页面 ```C++ static int validate_page_before_insert(struct vm_area_struct *vma, struct page *page) { struct folio *folio = page_folio(page); // 引用计数检查 if (!folio_ref_count(folio)) return -EINVAL; // zero page 的特殊处理 if (unlikely(is_zero_folio(folio))) { if (!vm_mixed_zeropage_allowed(vma)) return -EINVAL; return 0; } // 禁止特定类型的页面: 匿名页,slab页,有类型的页 if (folio_test_anon(folio) || folio_test_slab(folio) || page_has_type(page)) return -EINVAL; flush_dcache_folio(folio); return 0; } ``` ##### page_has_type > 根据 enum pagetype 定义,以下类型的页会被 page_has_type() 检测到 1. PGTY_buddy - Buddy 分配器页 2. PGTY_offline - 离线页 3. PGTY_table - 页表页 4. PGTY_guard - Guard 页 5. PGTY_hugetlb - 大页 6. PGTY_slab - Slab 页 7. PGTY_zsmalloc - zsmalloc 页 8. PGTY_unaccepted - 未接受页 ```C enum pagetype { /* 0x00-0x7f are positive numbers, ie mapcount */ /* Reserve 0x80-0xef for mapcount overflow. */ PGTY_buddy = 0xf0, PGTY_offline = 0xf1, PGTY_table = 0xf2, PGTY_guard = 0xf3, PGTY_hugetlb = 0xf4, PGTY_slab = 0xf5, PGTY_zsmalloc = 0xf6, PGTY_unaccepted = 0xf7, PGTY_mapcount_underflow = 0xff }; ``` #### insert_page_into_pte_locked 的检查 ```C++ static int insert_page_into_pte_locked(struct vm_area_struct *vma, pte_t *pte, unsigned long addr, struct page *page, pgprot_t prot) { struct folio *folio = page_folio(page); pte_t pteval; // 页表项必须为空 if (!pte_none(ptep_get(pte))) return -EBUSY; /* Ok, finally just insert the thing.. */ pteval = mk_pte(page, prot); if (unlikely(is_zero_folio(folio))) { pteval = pte_mkspecial(pteval); } else { folio_get(folio); inc_mm_counter(vma->vm_mm, mm_counter_file(folio)); folio_add_file_rmap_pte(folio, page, vma); } set_pte_at(vma->vm_mm, addr, pte, pteval); return 0; } ``` ### 子命名空间 > 由于 PacketSocket 需要 root 权限,所以正常用户权限下无法使用,需要用用户命名空间来实现伪root来成功调用 PacketSocket.但是也有些环境下Linux不支持用户命名空间。(用户命名空间依赖于 CONFIG_USER_NS 开启,这个选项是默认关闭) #### PacketSocket 的检查 > 检查的是在用户命名空间中的 CAP_NET_RAW。 ```C /** * capable_wrt_inode_uidgid - Check nsown_capable and uid and gid mapped * @idmap: idmap of the mount @inode was found from * @inode: The inode in question * @cap: The capability in question * * Return true if the current task has the given capability targeted at * its own user namespace and that the given inode's uid and gid are * mapped into the current user namespace. */ bool capable_wrt_inode_uidgid(struct mnt_idmap *idmap, const struct inode *inode, int cap) { struct user_namespace *ns = current_user_ns(); return ns_capable(ns, cap) && privileged_wrt_inode_uidgid(ns, idmap, inode); } EXPORT_SYMBOL(capable_wrt_inode_uidgid); ``` #### 用户命名空间的创建 - 通过调用链我们可以知道,在创建新的用户空间的时候会自动获取所有能力 - cap_capable() 检查时: - 如果目标命名空间就是进程的用户命名空间,检查 cap_effective - 如果进程是目标命名空间的父命名空间的 owner,直接通过 - PacketSocket 使用 ns_capable(net->user_ns, CAP_NET_RAW) 检查,由于进程在新命名空间内拥有全部能力,检查通过。 ```C 用户代码执行 unshare_setup(): └─> unshare(CLONE_NEWUSER | CLONE_NEWNS | CLONE_NEWNET) └─> ksys_unshare() └─> unshare_userns() └─> create_user_ns() └─> set_cred_user_ns() ├─> cred->cap_permitted = CAP_FULL_SET (允许所有能力) ├─> cred->cap_effective = CAP_FULL_SET (有效能力全部) └─> cred->user_ns = new_ns (绑定到新命名空间) 写入 uid_map: "0 <current_uid> 1" └─> proc_uid_map_write() └─> map_write() └─> new_idmap_permitted() └─> 检查通过:允许将当前uid映射到新ns的uid 0 └─> 安装映射:新ns中uid 0 = 父ns中当前uid 创建 PacketSocket: └─> packet_create() └─> ns_capable(net->user_ns, CAP_NET_RAW) └─> ns_capable_common() └─> security_capable() -> cap_capable() └─> 检查逻辑: ├─> ns == cred->user_ns? │ └─> 是:检查 cred->cap_effective[CAP_NET_RAW] │ └─> 由于 set_cred_user_ns() 设置了 CAP_FULL_SET │ └─> 返回 0 (成功!) └─> 或者 ns->parent == cred->user_ns && uid_eq(ns->owner, cred->euid)? └─> 是:直接返回 0 (拥有所有能力) ``` ##### cap_capable(检查权限) 1. 如果 ns == cred->user_ns:检查 cred->cap_effective 是否包含该能力 2. 如果 ns->parent == cred->user_ns && uid_eq(ns->owner, cred->euid):直接返回 0(拥有所有能力) 3. 否则向上遍历父命名空间 ```C++ int cap_capable(const struct cred *cred, struct user_namespace *targ_ns, int cap, unsigned int opts) { struct user_namespace *ns = targ_ns; /* See if cred has the capability in the target user namespace * by examining the target user namespace and all of the target * user namespace's parents. */ for (;;) { /* Do we have the necessary capabilities? */ if (ns == cred->user_ns) return cap_raised(cred->cap_effective, cap) ? 0 : -EPERM; /* * If we're already at a lower level than we're looking for, * we're done searching. */ if (ns->level <= cred->user_ns->level) return -EPERM; /* * The owner of the user namespace in the parent of the * user namespace has all caps. */ if ((ns->parent == cred->user_ns) && uid_eq(ns->owner, cred->euid)) return 0; /* * If you have a capability in a parent user ns, then you have * it over all children user namespaces as well. */ ns = ns->parent; } /* We never get here */ } ``` #### 脚本 ```C void unshare_setup(void) { char edit[0x100]; int tmp_fd; unshare(CLONE_NEWNS | CLONE_NEWUSER | CLONE_NEWNET); tmp_fd = open("/proc/self/setgroups", O_WRONLY); write(tmp_fd, "deny", strlen("deny")); close(tmp_fd); tmp_fd = open("/proc/self/uid_map", O_WRONLY); snprintf(edit, sizeof(edit), "0 %d 1", getuid()); write(tmp_fd, edit, strlen(edit)); close(tmp_fd); tmp_fd = open("/proc/self/gid_map", O_WRONLY); snprintf(edit, sizeof(edit), "0 %d 1", getgid()); write(tmp_fd, edit, strlen(edit)); close(tmp_fd); } ```
登录后可查看完整内容
冰与火的战歌:Windows内核攻防实战高级班!从零到实战,融合AI与Windows内核攻防全技术栈,打造具备自动化能力的内核开发高手。
最后于
2025-12-5 14:14 被Elenia编辑 ,原因: 修改图片
#基础知识
#漏洞机制
#内核
收藏
・
2
点赞
・
6
打赏
分享
分享到微信
分享到QQ
分享到微博
赞赏记录
参与人
雪币
留言
时间
wx_晨梦
非常支持你的观点!
2026-7-16 07:36
git_10086ubgffhhrffgghh-spec
你的帖子非常有用,感谢分享!
2026-1-15 17:42
Y6blNU1L
为你点赞!
2025-12-9 13:52
mb_wpitiize
非常支持你的观点!
2025-12-8 17:04
Ayuer
为你点赞!
2025-12-7 22:32
winmt
+10
感谢你的贡献,论坛因你而更加精彩!
2025-12-5 13:11
查看更多
赞赏
×
1 雪花
5 雪花
10 雪花
20 雪花
50 雪花
80 雪花
100 雪花
150 雪花
200 雪花
支付方式:
微信支付
赞赏留言:
快捷留言
感谢分享~
精品文章~
原创内容~
精彩转帖~
助人为乐~
感谢分享~
最新回复
(
1
)
擅长JS逆向
雪 币:
20
能力值:
( LV1,RANK:0 )
在线值:
发帖
1
回帖
2
粉丝
0
关注
私信
擅长JS逆向
2
楼
1
2025-12-8 17:06
0
游客
登录
|
注册
方可回帖
回帖
表情
雪币赚取及消费
高级回复
返回
Elenia
7
13
发帖
19
回帖
330
RANK
关注
私信
他的文章
[原创] Qemu 源码分析(PCI篇)
24888
[原创] Frida 17.6 最新Hook注入方案分析(Zymbiote注入机制)
75381
[原创] Android 内核启动流程分析 (13.0.0_r3)
21391
[原创] UE4的启动流程分析
3184
[原创]Linux 内核攻击:Punch hole (2025 Backdoor skernel 复现)
20828
关于我们
联系我们
企业服务
看雪公众号
专注于PC、移动、智能设备安全研究及逆向工程的开发者社区
看原图
赞赏
×
雪币:
+
留言:
快捷留言
为你点赞!
返回
顶部







