全民进入xdec大时代 还原libtiny.so VMP 实战!!
最近拿开源的 AArch64 多级 IL 反编译器 xdec 跑了一轮真实商业样本的去混淆和去 VMP 实战。
文章不堆概念,直接讲清楚四件事:
xdec 到底好在哪,它解决的是逆向里的什么麻烦事;- 拿 **
libtiny.so**做一次「零文档、零硬编码地址」的盲开去 VMP 实战,完整流程怎么跑通的;
- 它和大家熟悉的 VTIL 有什么区别;
- 用下来之后,
xdec 的真实上限和边界在哪里。
一、xdec 解决的是什么问题?
平时分析 Android/iOS 的 ARM64 .so,大家一般都是 Frida + Trace(Stalker / QBDI / Unidbg)再配 IDA 或 Rizin 静态看。普通 .so 这么干挺快,但遇到重度 OLLVM 或自研 VMP,会明显觉得费劲:
- 工作量太大:Trace 动不动几十万行汇编,IDA / Rizin 适合看单个函数,真遇到一两百个 VM Handler,配合AI进度也十分缓慢。
- 自定义字节码用不上反编译器:就算拿 Frida 把字节码 dump 出来、自己写了反汇编脚本,看到的还是满屏
push/pop 和寄存器搬运。IDA / Rizin 的反编译只认 ARM64、x86 这些原生指令,没法帮你把自定义字节码化简成干净的 C。
- 覆盖不全,也不好验对错:Trace 只能看到这次跑到的分支,没触发的分支看不到;人工化简完代码后,算出来到底对不对,通常还得挂回真机再测。
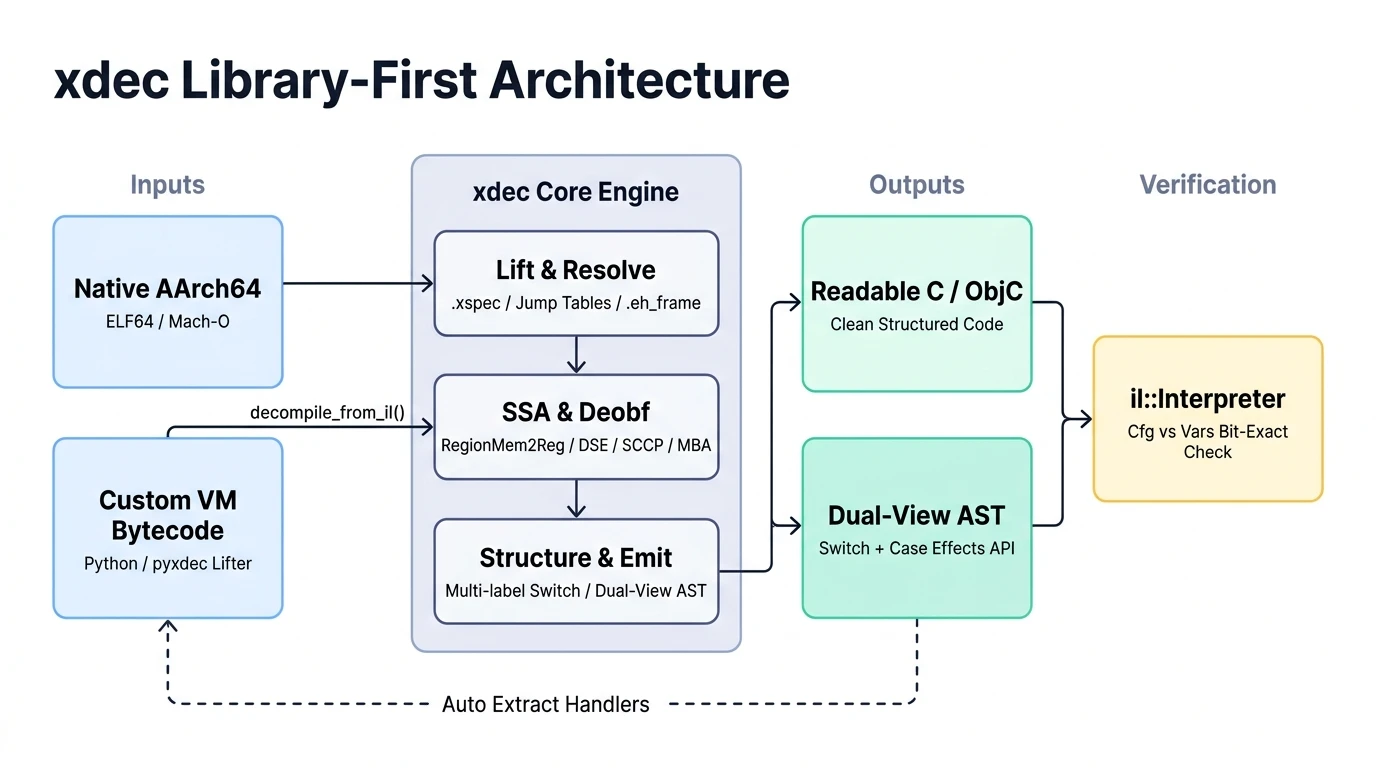
xdec 的思路很直接:把反编译器做成一个可编程的底层库(C++ Core + pyxdec Python 绑定),并且严格守住一条边界——Core 里不写任何针对具体样本的硬编码,只提供通用能力;针对某家 VMP 的解包和字节码提升,全部写在外部 Python 脚本里。
它最顺手的几个能力正好卡在上面三个点上:
- Dual-View AST:反编译解释器后,不光给你 C 文本,还直接暴露结构化
Switch AST(带精确的多标签 case 槽位值)和底层 IL 块映射,用 Python 调 collect_case_region() + summarize_case_effects(),不到 1 秒就能把上百个 Handler 的语义抽出来。
decompile_from_il() 中段接入:只要用 FunctionBuilder + AbiSpec 把任意自定义虚拟机的字节码翻成 xdec IL,就能直接送进它整套后端——全量 SSA、RegionMem2Reg/RegionDSE(专治栈机冗余)、常量折叠、MBA 代数化简、结构化控制流,最后直接吐出干净 C 代码。- 自带
il::Interpreter 校验:先 fn_cfg.clone() 留一份优化前的原始 IL,再跑 decompile_from_il() 得到优化后的 Vars IL,最后拿内置解释器把两边各跑一遍,比对返回值和输出内存是否 Bit-Exact(逐比特一致)。
二、实战案例:用 xdec 盲开还原 libtiny.so
2.1 样本情况
libtiny.so 是一个 8.4 MB 的 arm64-v8a ELF64,完全 stripped(只剩 JNI_OnLoad 一个导出符号),里面叠加了两层比较硬的对抗:
- Native 层重度 OLLVM:全库 6.91 MB
.text 里光 br_reg 间接跳转就有 69,907 条(占 4.04%)、csel 46,892 条,大量函数使用共享间接跳转跳板 + .data 指针表。
- 内嵌定制栈机 VMP:内部藏了 4 个加密压缩容器,解开后是魔改过的栈式虚拟机模块(自定义段号、数据段 XOR 掩码、256 项操作码全量重映射),对应的原生解释器本体足有 57 KB(256 项
ldrh 跳转表)。
实测这个样本的过程中修复了的卡点:共享跳板在后续轮次新增回边时没重新求值、栈机连续读写优化后残留未命名变量、Switch 去重合并目标时把 case 编号搞乱了,以及 stripped ELF 缺 .eh_frame 函数列表。把这几个通用问题修掉后,原有 903 个 C++ 单测和 5 个 Python 单测全部通过,没有在核心代码里写任何针对 libtiny.so 的特殊处理。
2.2 盲开流程(零文档、零硬编码地址)
直接输入一个裸的 --so libtiny.so,脚本里不硬编码任何函数地址、容器偏移或操作码表,完全靠 xdec / pyxdec 从零跑通整套流程:
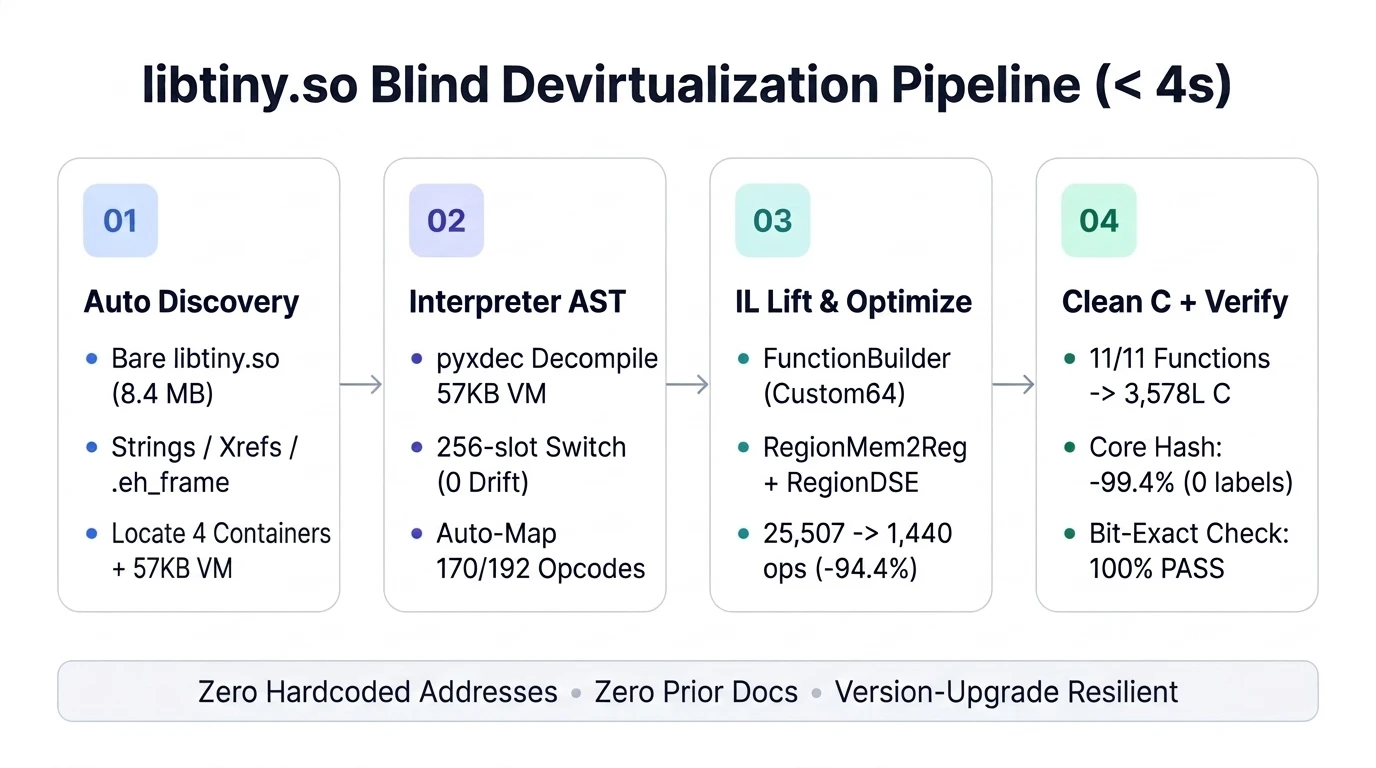
整个过程拆成 4 步,跑完不到 4 秒:
- 自动定位(01 Auto Discovery)
- 先靠
xdec 的 .eh_frame FDE 扫描拉出全库 4,624 个无符号函数,AArch64 指令覆盖率实测 100.00%(1,729,344 / 1,729,347)。
- 用
strings + xrefs 顺藤摸瓜定位到初始化入口、容器分发器和解包器;扫出 4 个加密容器并按重定位差值自动配对;结合常量表特征动态推导解密参数并通过解压校验自证;最后扫出 57 KB 栈机解释器主循环。
- 实时反编译解释器,自动抽操作码表(02 Interpreter AST)
- 直接调
pyxdec 反编译 57 KB 的解释器主循环,拿到 0 错位的 256 槽位多标签 Switch AST。
- 遍历每个
case 调 collect_case_region() 做语义特征匹配,自动分类出 170 / 192 个有效操作码(剩余主要是浮点/NEON 特殊指令);对目标核心模块实际用到的 44 种操作码,自动识别率 44/44(100%)。
import xdec

img = xdec.Image.open("libtiny.so")
res = img.decompile(interp_va, structured_exprs=True)

# 直接拿到 0 错位的多标签 Switch AST,无需手工解析跳表
switches = res.ast.find_all(xdec.ast.StmtKind.Switch)
main_sw = max(switches, key=lambda s: sum(len(c.values) for c in s.cases))

opcode_map = {}
for case in main_sw.cases:
    # 沿局部 CFG 收集完整 case 区域,避免单句 goto 跳板漏收后继块
    region = xdec.analysis.collect_case_region(res.il, case.il_blocks[0], stop_blocks={dispatch_va})
    summary = xdec.analysis.summarize_case_effects(res.il, region)
    semantic = classify_stack_vm_handler(summary, case.body)
    for op_byte in case.values:          # 原始 0..255 槽位索引,多标签自动展开
        opcode_map[op_byte] = semantic
- 提升为 IL,交给
xdec 后端暴力削冗余(03 IL Lift & Optimize)
- 对盲解包出的核心模块全部 11 个函数(6,567 条自定义栈机指令),用
FunctionBuilder(Arch.Custom64) + PrivateStack 提升为 Cfg 级 IL,先 clone() 留底,再喂给 decompile_from_il()。
- 优化效果非常夸张:全模块总 IL 指令从
25,507 ops 压到 1,440 ops(削掉 94.4% 栈机 push/pop 冗余);里面最核心的 64 轮密码压缩函数更是从 6,822 ops 直接干到 39 ops(削掉 99.4%)。
- 输出可读 C + Bit-Exact 校验(04 Clean C + Verify)
- 11 个函数全部输出为干净的结构化 C(共 3,578 行,0 处
unnamed-value,核心 64 轮压缩核输出 0 label 直链代码)。
- 用
xdec.il.Interpreter 拿测试向量分别跑 Cfg(优化前)和 Vars(优化后),返回值与输出内存 100% Bit-Exact 通过。
# 1. 将自定义栈机字节码提升为 xdec Custom64 Cfg IL(省略逐指令 lift 细节)
fn_cfg = lift_stack_vm_func(bytecode, opcode_map, abi=vm_abi)

# 2. clone 一份原始 Cfg IL 用于校验,另一份送入 xdec 全套优化 + C 后端
fn_opt_in = fn_cfg.clone()
out = xdec.decompile_from_il(fn_opt_in, abi=vm_abi, memory=layered_mem, regions=mem_regions)
Path("out/vm_func_core.c").write_text(out.c_code, encoding="utf-8")

# 3. 用内置解释器对优化前 (Cfg) 与优化后 (Vars) 做 Bit-Exact 逐比特等价校验
ret_cfg, mem_cfg = run_with_interpreter(fn_cfg, test_args, vm_abi, layered_mem)
ret_var, mem_var = run_with_interpreter(out.il, test_args, vm_abi, layered_mem)
assert ret_cfg == ret_var and mem_cfg == mem_var
下面是一段效果对比——原本在栈机里需要几百条 local.get / i32.load / push / pop / rotl / add / local.set 绕来绕去的压缩轮运算,经过 RegionMem2Reg + RegionDSE + SCCP 后,直接吐出干净的直链 C(0 label、0 栈槽残留):
// 优化前:6,822 条 Cfg IL(密集的虚拟栈 push/pop 与临时槽读写)
// 优化后:39 条 Vars IL(削减 99.4%),直接还原为无分支直链算术
uint32_t w0 = *(uint32_t*)(block + 0x0);
uint32_t mix0 = ((b & c) | (~b & d)) + a + w0 + 0xd76aa478;
a = b + ((mix0 << 7) | (mix0 >> 25));

uint32_t w1 = *(uint32_t*)(block + 0x4);
uint32_t mix1 = ((a & b) | (~a & c)) + d + w1 + 0xe8c7b756;
d = a + ((mix1 << 12) | (mix1 >> 20));
// ... 64 轮展开后直接写回状态字,Bit-Exact 校验 100% 一致
Native OLLVM 侧同样收益明显:修完共享跳板增量发现后,原来在 3–7 块就卡死成伪 while (true) 的几个核心 Native 函数(载荷加密入口、密钥协商封装、容器分发器、随机源封装)全部正常展开,30ms 左右就能吐出完整可读的调用链与常量地址。
三、xdec 和 VTIL 的核心差异
提到“基于编译器 IR 去 VMP”,大家第一反应往往是当年大名鼎鼎的 VTIL。两者理念有相通之处,但定位和落地效果差别巨大:
| 对比维度 |
VTIL |
xdec |
| 目标平台 |
Windows x86-64(主要面向 VMProtect 等 PC 壳) |
移动端 AArch64(Android ELF64 / iOS Mach-O / dyld cache)+ 自定义 Custom32/64 虚拟 ISA |
| 定位与终点 |
反混淆 IR + 重编译回机器码:把 trace 优化后再编译成 x86-64,最后还得丢回 IDA 看 F5 |
完整反编译器 + Library-First 库:直接输出结构化 C / ObjC 和 Dual-View AST,一站式闭环 |
| 工作方式 |
偏重动态 trace / 符号执行切入,C++ 写 lifter 迭代成本高 |
动静结合 + Python 编排(pyxdec):既能静态反编译解释器自动抽 Switch Handler,也支持 Specializer 部分求值与 --tracedb 动态轨迹 |
| 适用 VM 形态 |
强在 x86 栈机的激进死存储消除与符号化简 |
LayeredMemory + RegionMem2Reg/DSE 通用覆盖 寄存器机(如官方 128 寄存器示例)+ 栈机(如 libtiny.so) 双范式 |
| 正确性验证 |
依赖外部执行对比 |
内置 il::Interpreter + Function.clone(),一行脚本跑完 Cfg vs Vars Bit-Exact 校验 |
| 生态现状 |
已停止维护多年,编译和二次开发门槛高 |
架构现代(C++20 + CMake + pybind11 + MCP Server),极易配合脚本与 AI Agent 快速迭代 |
一句话概括:VTIL 是当年 x86 时代的“去虚拟化汇编优化器”,而 xdec 是面向 ARM64 与自定义 VM 的“可编程全栈反编译器”。
四、xdec 的上限和真实边界在哪?
吹完优点,也要客观聊聊它的天花板,方便评估什么活该交给它、什么活不该硬怼:
它的上限很高
- 原生 ARM64 + 中重度 OLLVM:只要不是磁盘加密壳,配合共享跳板增量解析、PIC 跳表识别、MBA 化简、不透明谓词位吸收折叠和
Specializer,已经能把绝大多数商业 Native 混淆剥得相当干净。
- 纯算/算法密集型自定义 VMP(寄存器机 / 栈机 / WAMR 类):这是
xdec 的绝对主场。配合 pyxdec 的多标签 Switch AST 自动抽 Handler + decompile_from_il() + Bit-Exact 校验,几秒钟就能把上万条虚拟指令压成几十行可验证的 C 代码。
它的真实边界(天花板)
- 原生架构边界:原生 lifter 目前只支持 AArch64(不支持 32 位 ARMv7 / x86),且部分复杂 NEON / 标量浮点指令还在持续补齐中(遇到浮点密集 VM 时个别操作码会退化为占位)。
- 加壳与运行时自修改:磁盘整体压缩/加密壳(如 UPX 或自定义加固壳)以及运行时 SMC,静态工具都绕不开,依然需要先做运行时内存 dump + ELF 修复(
xdec 的抗畸形 ELF 前端可以很好地接住修复后的镜像)。
- 动态类型 VM 与重度宿主反射 VM:像内嵌的定制 Lua/JS,或者大量调用
JNIEnv 反射的商业 DexVMP,xdec 非常适合用来反编译它们的原生解释器、解密容器、自动抽 Handler 映射表,以及还原里面的纯算循环;但把整段动态对象/JNI 反射业务强行转成 C 反而不如直接映射回脚本或伪 Java 好读。
- 密码学白盒:如果某个 VM 模块里直接塞了 160 张 S-Box 的白盒 AES,
xdec 可以把查表逻辑还原得清清楚楚,但从白盒里抠出密钥属于密码分析范畴,不是反编译器的工作。
致谢
感谢原作者@[zhuzhu_Top] 开源了工程质量极高且极具想象力的项目,让移动端 ARM64 反编译与去虚拟化有了一套真正可以工程化、自动化、可验证的底层基础设施。
项目地址:883K9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6Y4K9i4c8Z5N6h3u0Q4x3X3g2U0L8$3#2Q4x3V1k6*7K9s2g2*7K9s2g2Q4x3X3c8f1L8%4m8Q4x3V1k6^5k6r3g2U0