-
-
[原创]使用 AST 还原某大厂JS控制流平坦化与VMP保护
-
发表于: 2天前 268
-

声明:本文仅供学习交流,仅分享分析思路,不提供相关工具或还原代码。严禁将本文内容用于商业用途或任何违法违规活动,由此产生的一切后果由使用者自行承担,与作者无关!
做安全 SDK 的算法分析,绕不开的不只是算法本身,更重要的就是代码保护。再复杂的算法,脱离代码保护也容易分析;即使是简单的算法,使用强大的代码保护,依然会对攻击者造成很大的困扰。目前大厂较为成熟的保护方式就是 OLLVM 控制流平坦化 + VMP + 标准算法自定义 。接下来就用 AST(抽象语法树)一点点拆开,看看能把代码还原到什么程度。同时讲清楚中间遇到的问题、为什么这样处理,以及处理前后有什么变化。
一、控制流平坦化与 JSVMP
前端保护并不是让代码无法执行,而是让执行逻辑不容易被直接理解。相比变量改名、压缩和简单字符串替换,控制流平坦化与虚拟化会进一步改变程序的表达方式。
1.1 控制流平坦化
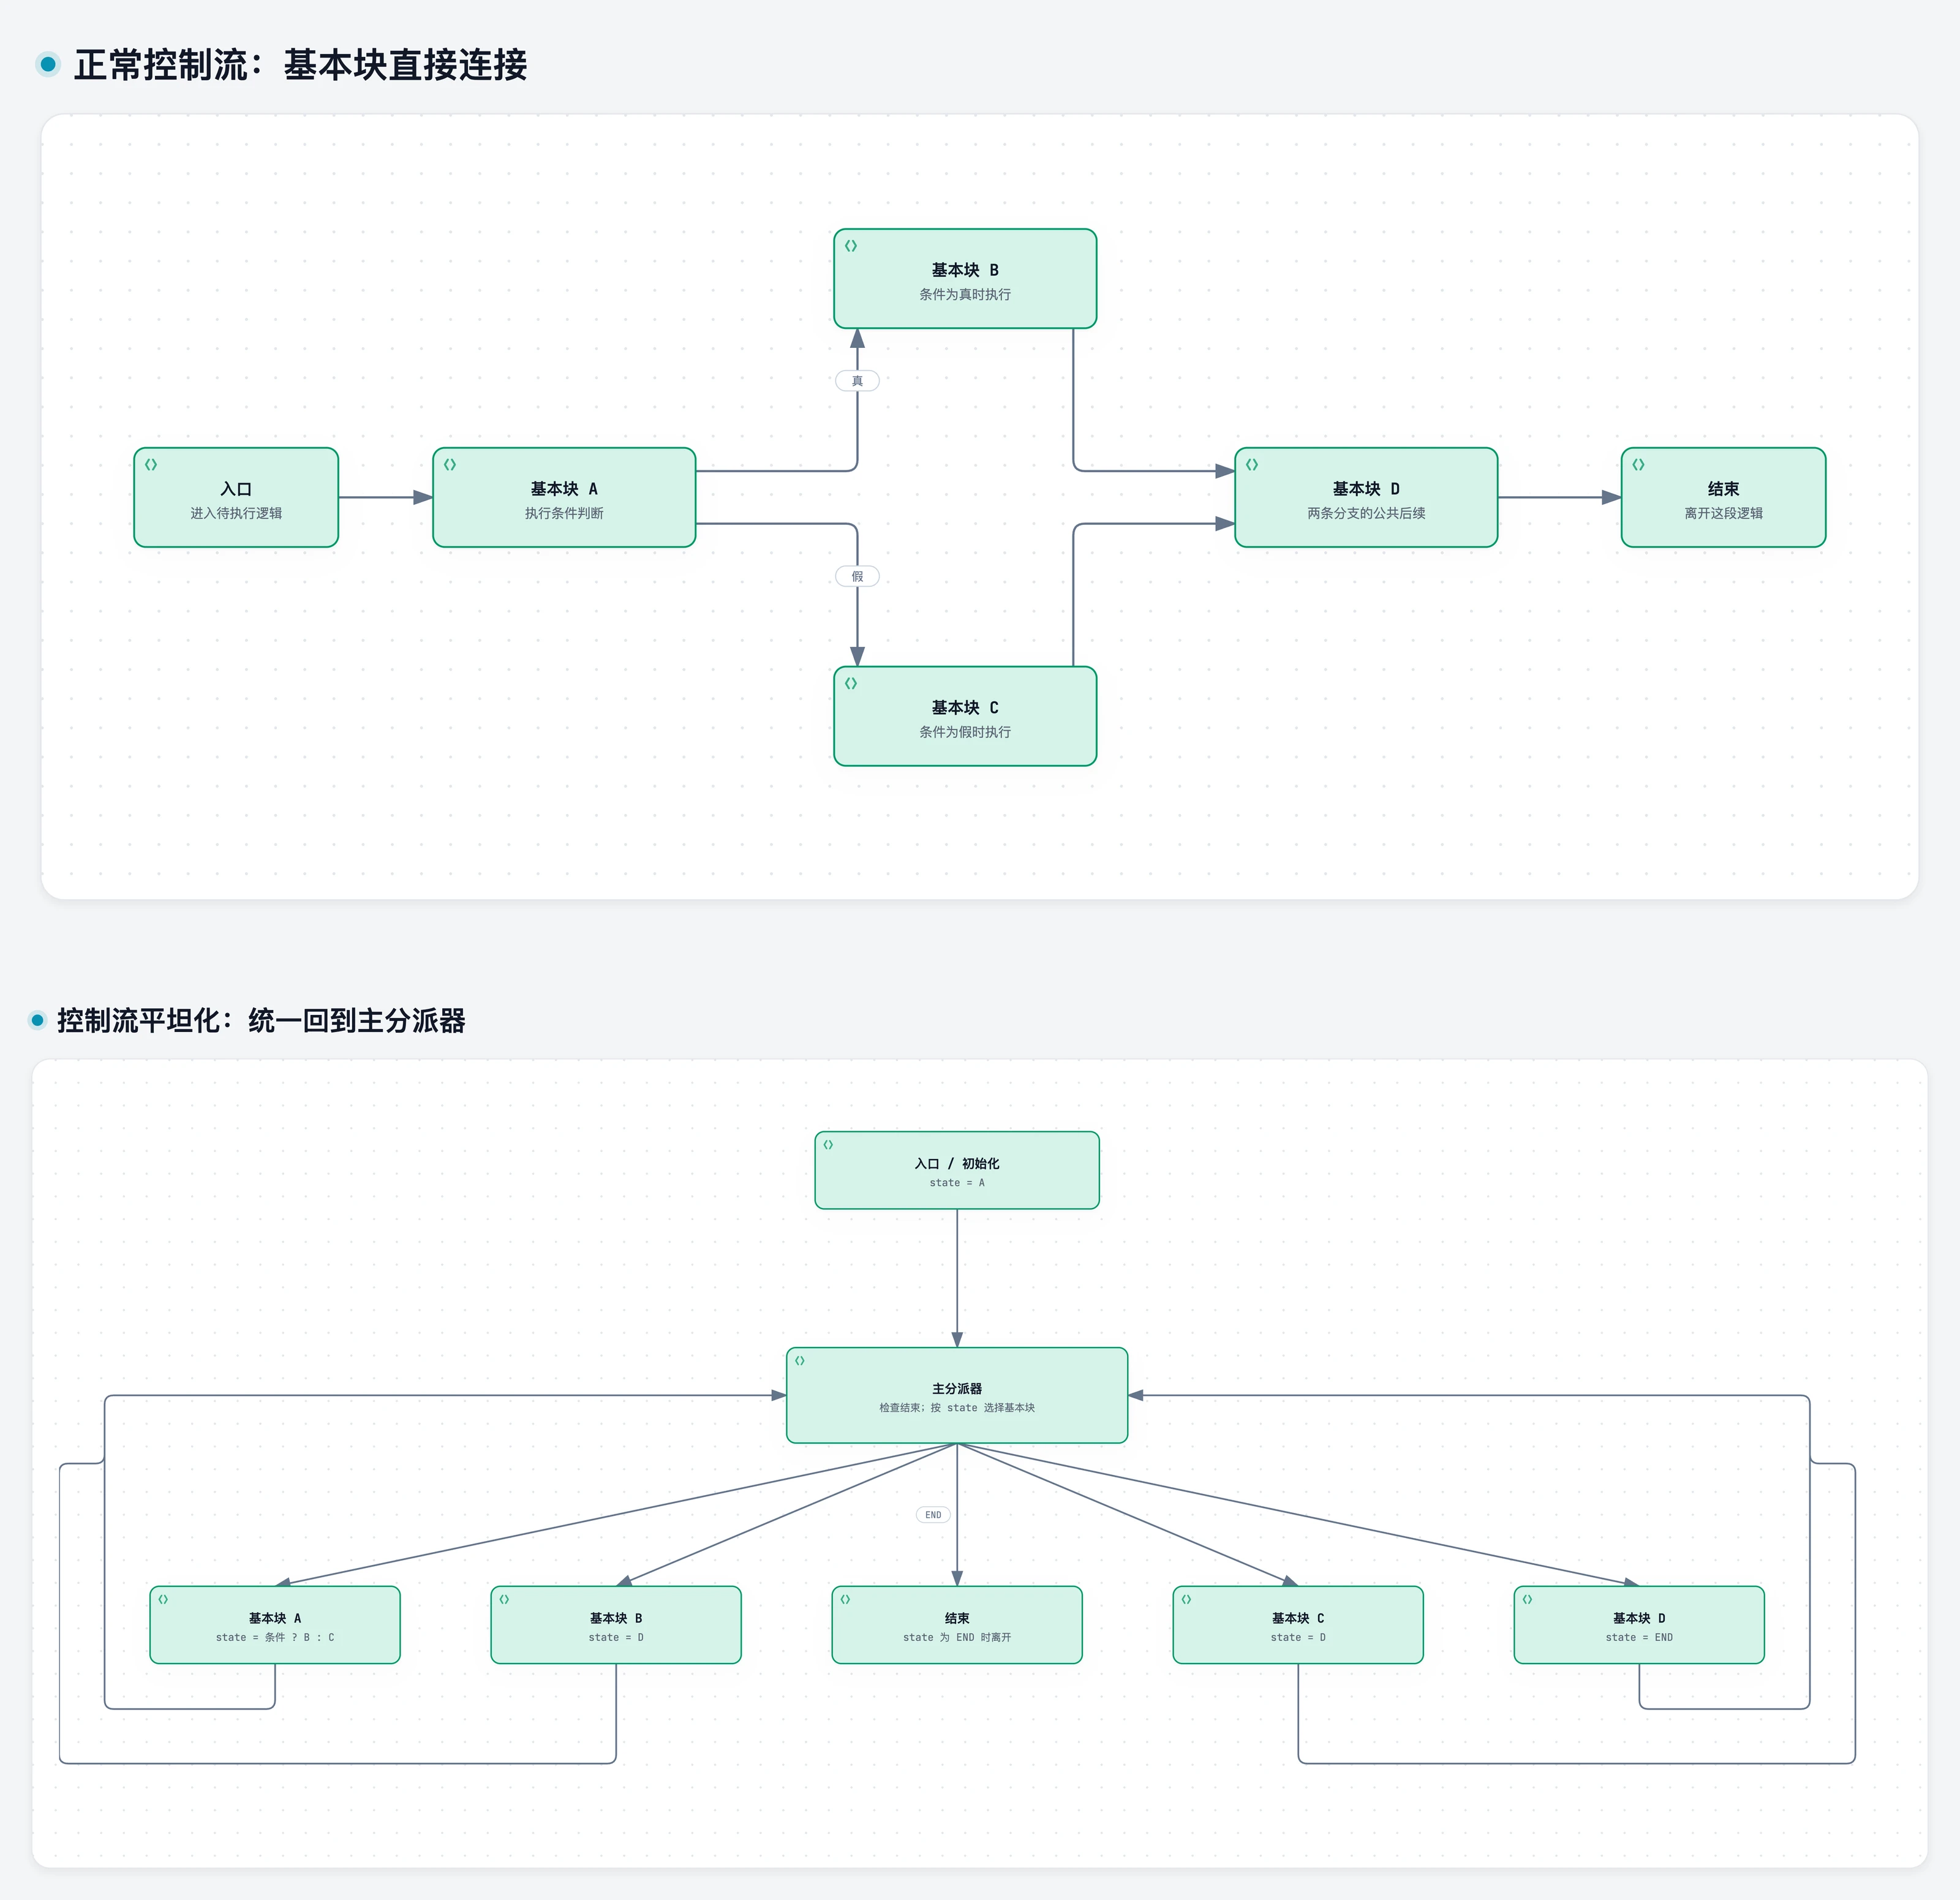
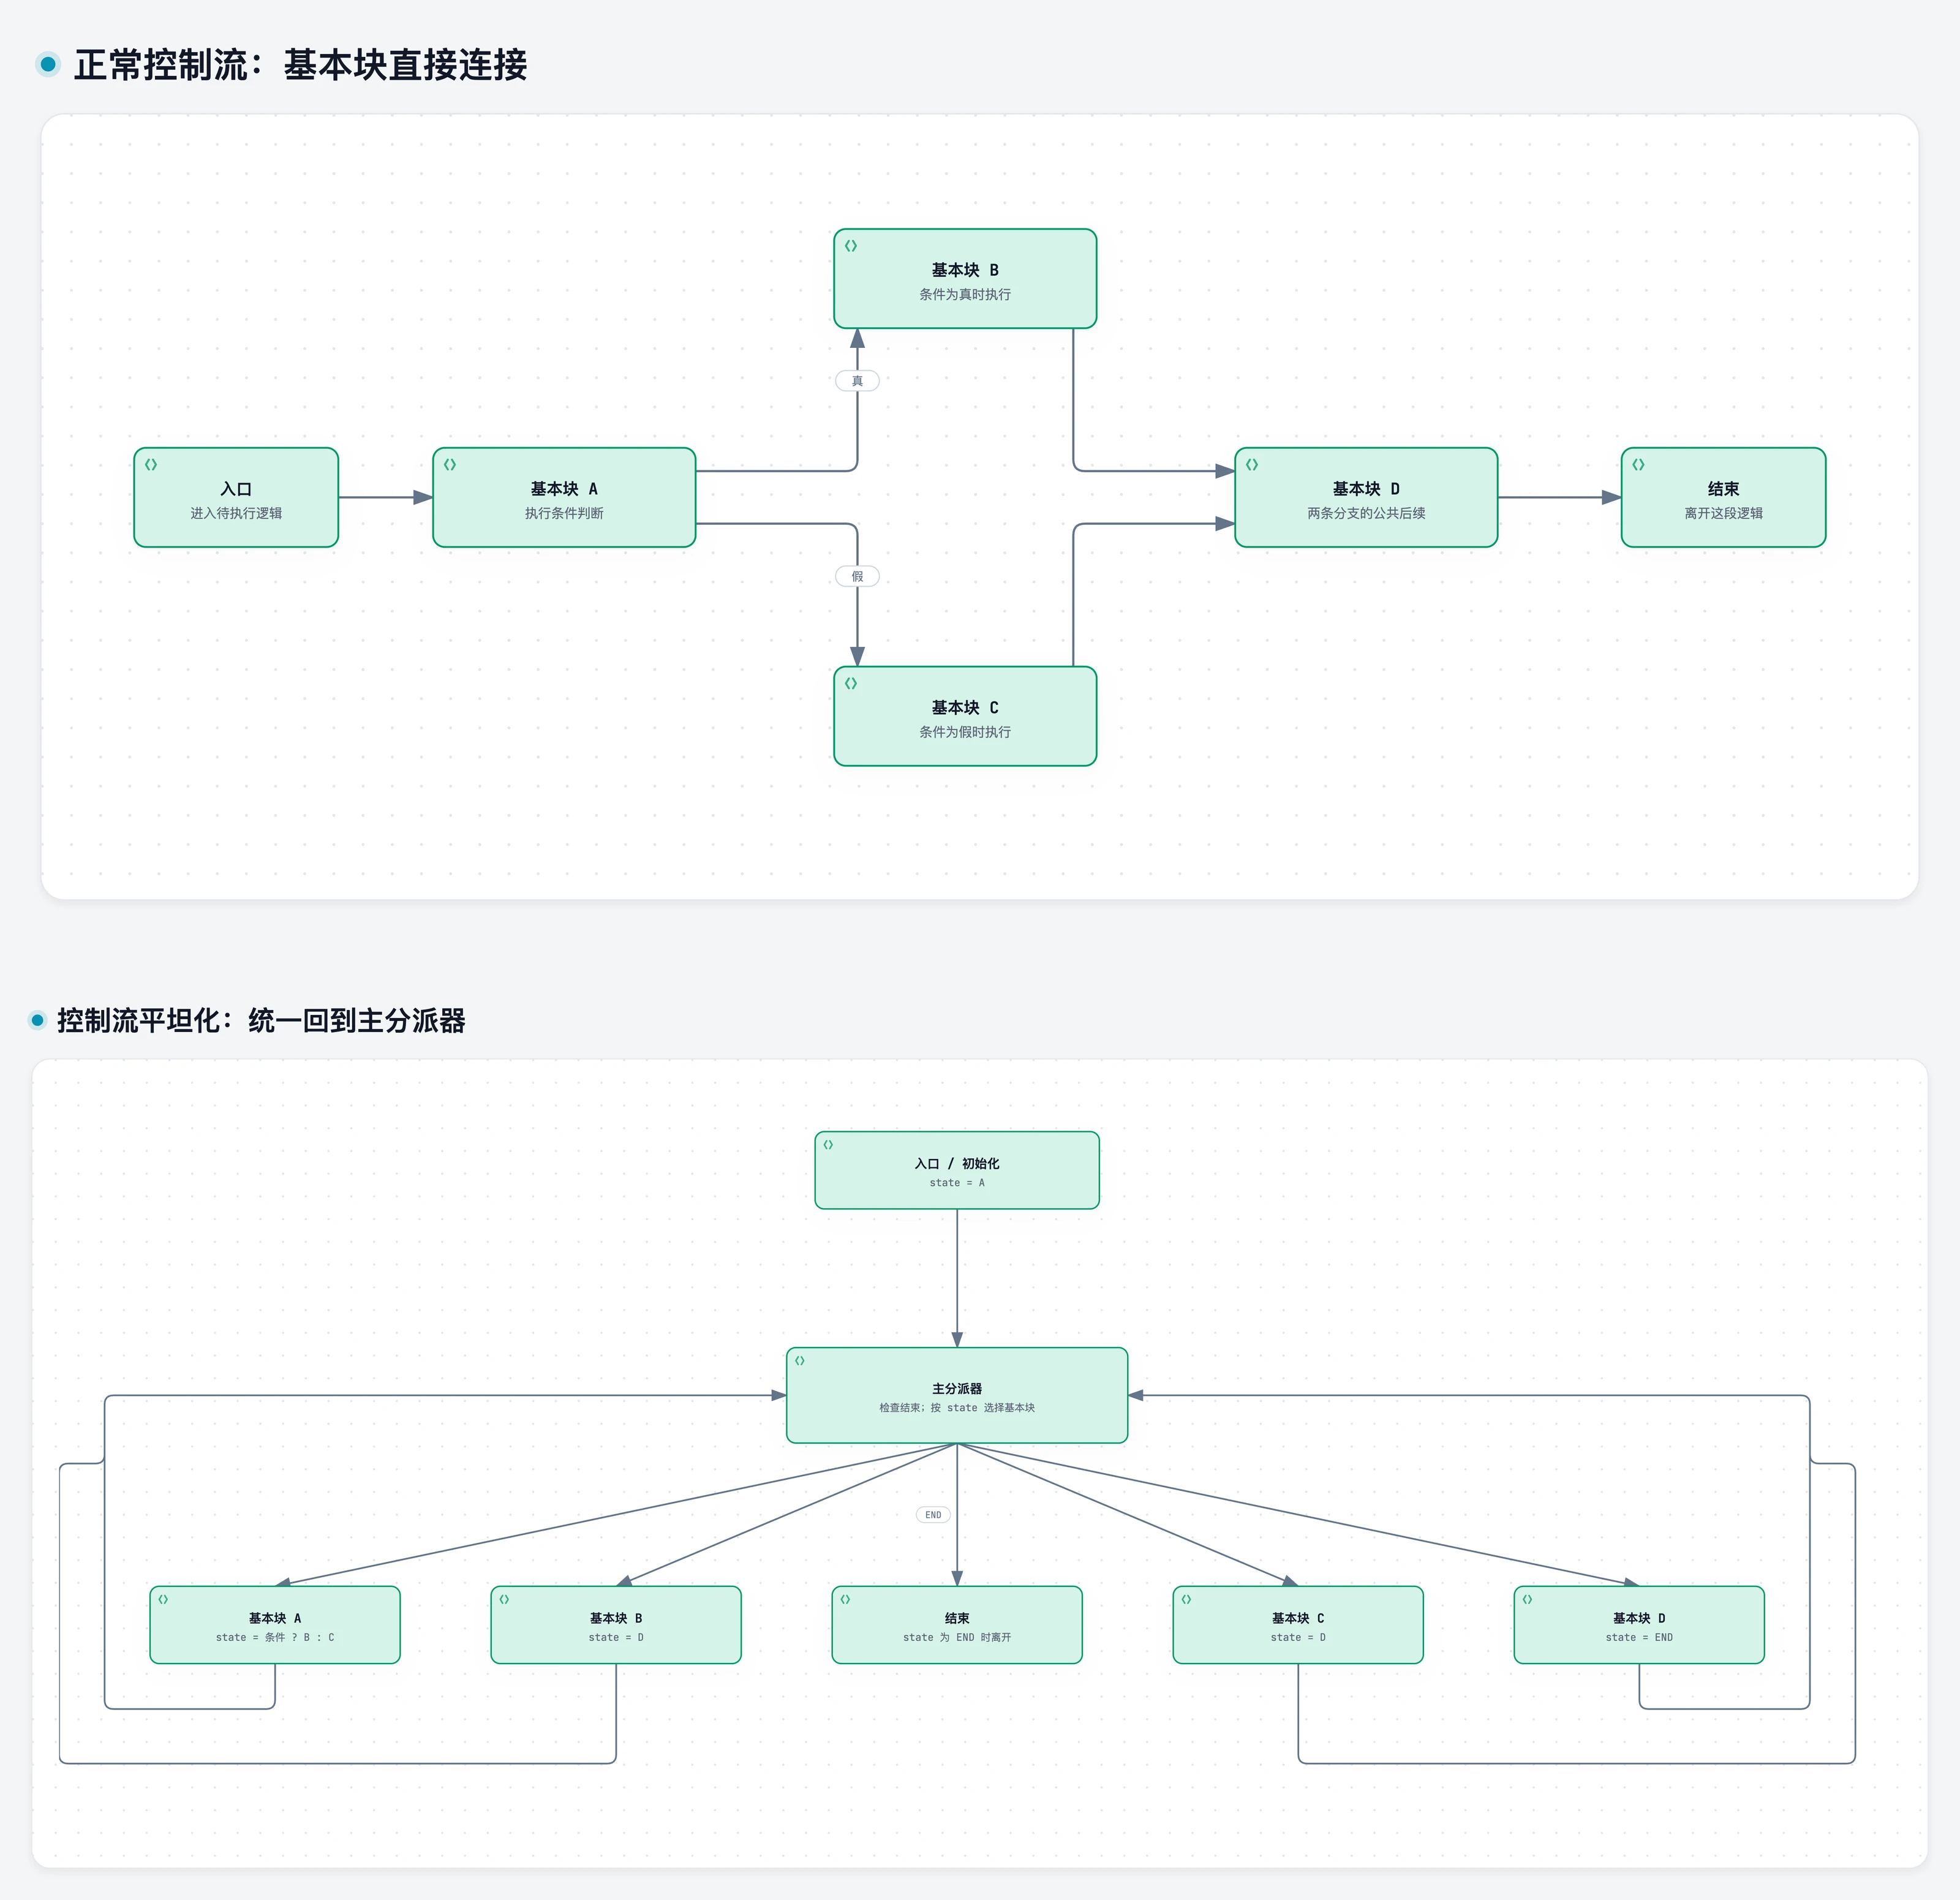
正常程序中,一段代码执行完之后,直接进入下一段;遇到条件时选择分支,满足循环条件时重复执行循环体。这些连接关系通常能从语句的排列和嵌套中看出来。
例如,一个条件块 A 根据判断进入 B 或 C,两支处理后汇合到 D,最后结束。
控制流平坦化改变的是这些代码块之间的连接方式:把执行片段交给一个统一的分派器,再用一个状态值记录下一片段的位置。分派器通常由循环和 switch 组成,但也可以使用条件树等其他表达。
1.2 JavaScript 虚拟化保护
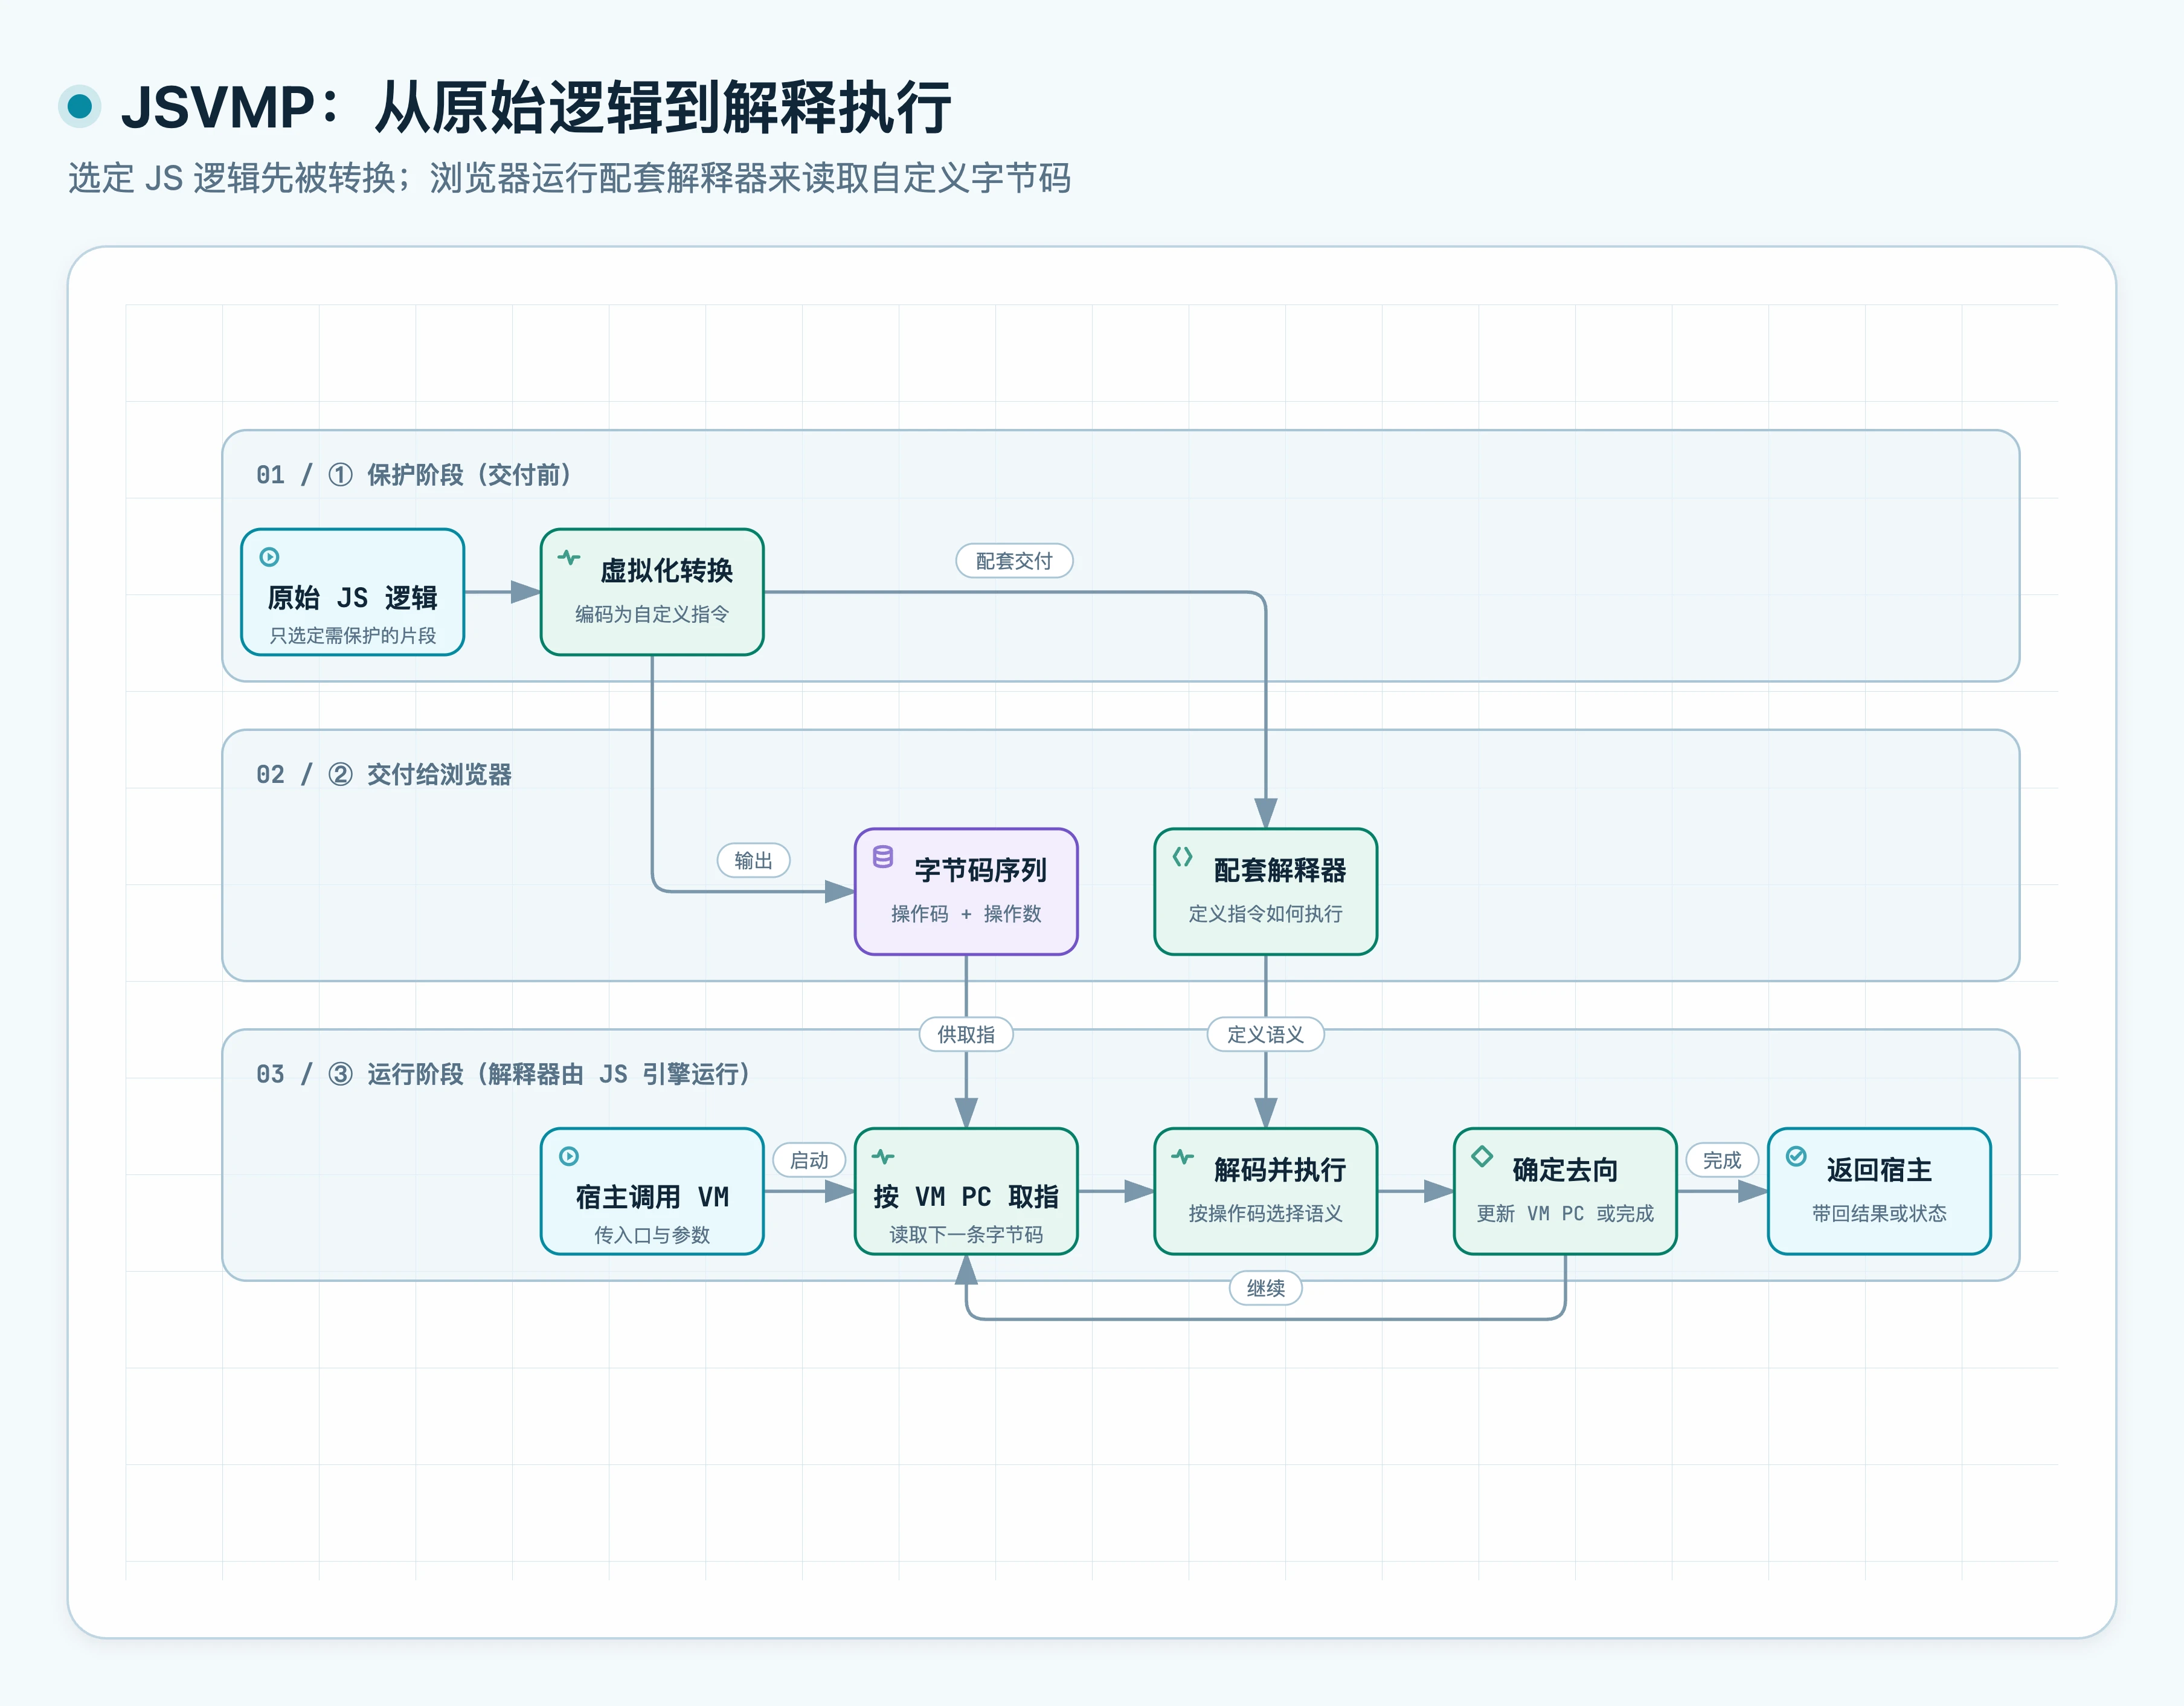
JavaScript 虚拟化保护(JSVMP) 则是将 JavaScript 逻辑转换成自定义字节码,并随代码提供能够执行这套字节码的解释器。
运行时,宿主 JavaScript 调用解释器;解释器读取指令、选择处理逻辑、操作执行状态,再决定下一条指令。
二、AST
AST(Abstract Syntax Tree,抽象语法树) 把源码表示成语句、表达式、函数等节点及其组成关系。
function add(a, b) {
  return a + b;
}
它可以用一棵简化的树表示:
程序 Program
└─ 函数声明 FunctionDeclaration:add
   ├─ 参数:a、b
   └─ 函数体 BlockStatement
      └─ 返回语句 ReturnStatement
         └─ 二元表达式 BinaryExpression:+
            ├─ 左操作数:a
            └─ 右操作数:b
树中能明确区分函数参数、返回语句和加法表达式。空格、换行以及括号外观不是这里的主要信息。
字符串匹配无法获取作用域等信息,容易误改代码。AST 能分清语句结构,配合作用域分析,让我们按代码的实际含义分析和改写,而不是对着字符硬替换。
三、使用 AST 还原
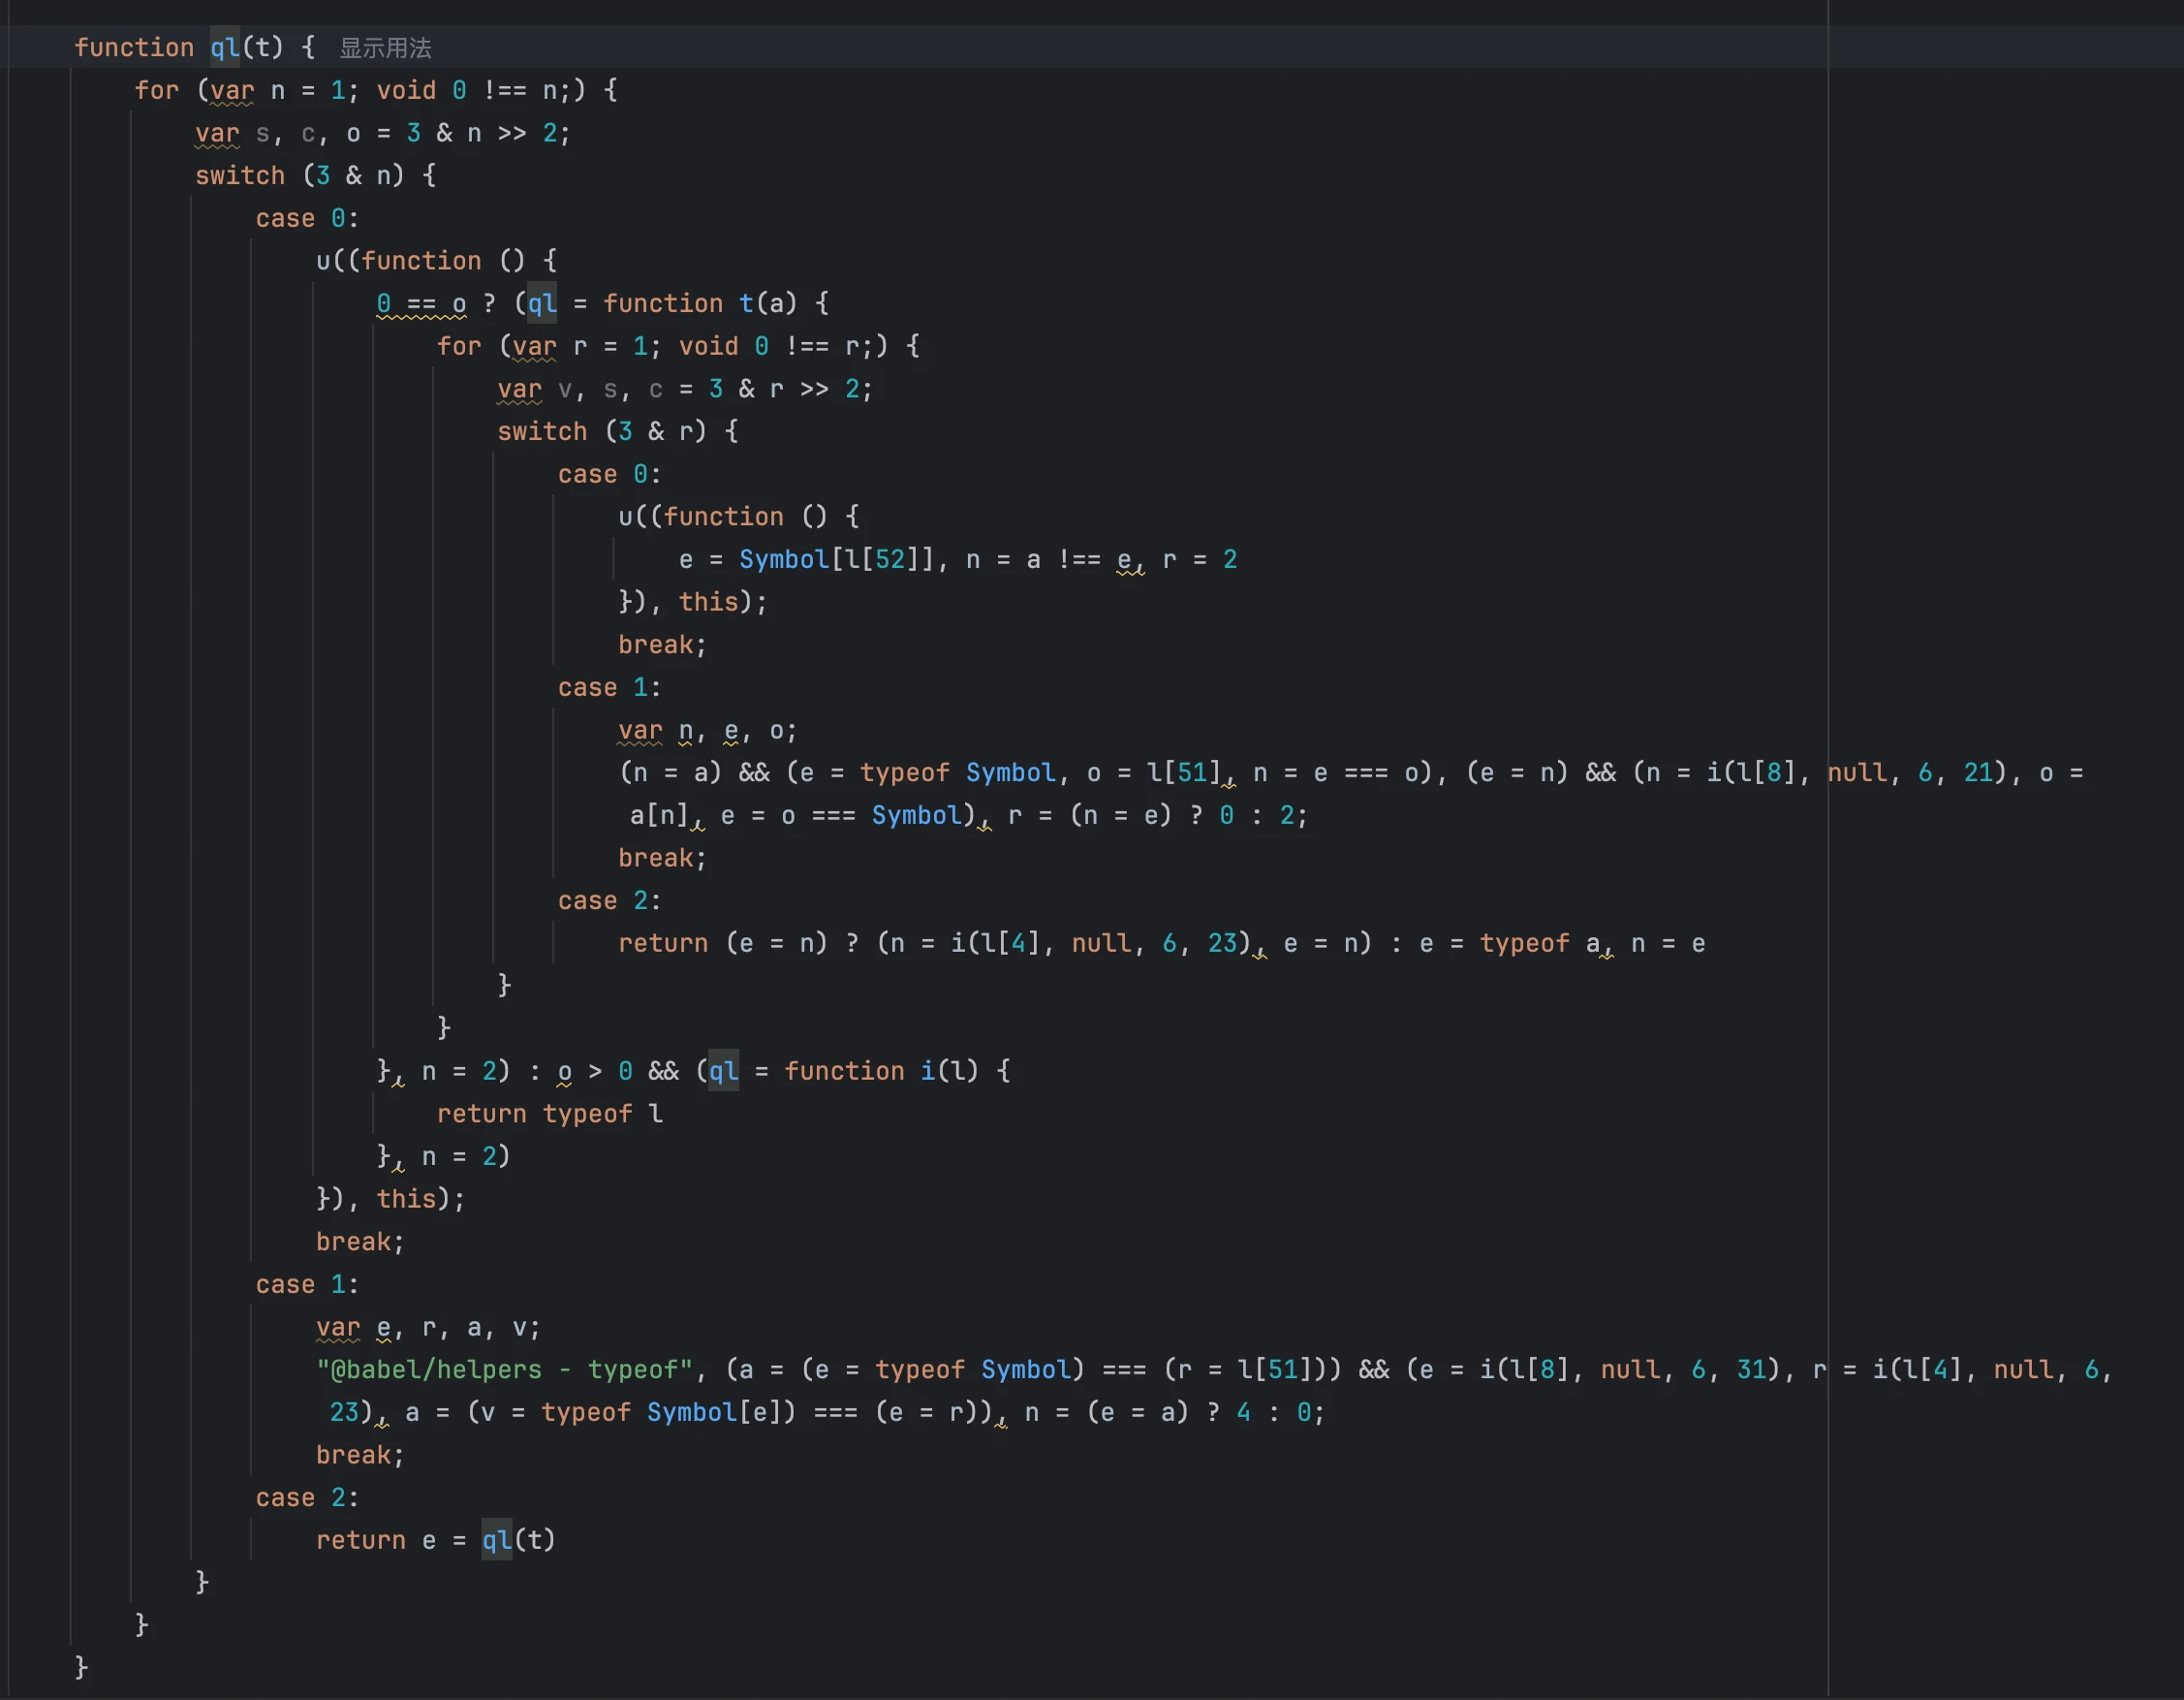
下图是一段经过混淆与保护的 JavaScript。它仍然可以执行,但很难从表面的代码直接看出原有算法的步骤、关键参数如何产生,以及各段代码按什么顺序运行。
接下来先从预处理开始,把表达式里的操作展开,方便后面分析执行顺序。
3.1 预处理
3.1.1 逗号表达式
3.1.1.1 非 return:普通表达式语句按顺序拆开
下面这条语句不使用逗号表达式的整体结果,只需要保留三次赋值的顺序:
处理前:
this.type = l, this.value = i, this.target = n;
处理后:
this.type = l;
this.value = i;
this.target = n;
逗号表达式如果在赋值右侧或调用参数里,不能直接按普通语句拆开。
3.1.1.2 return:前面的项展开,最后一项留给返回值
处理前:
function Ni(l, i) {
  return l[49]++, "";
}
处理后:
function Ni(l, i) {
  l[49]++;
  return "";
}
最后的空字符串仍作为返回值。也就是前面的项展开成语句,最后一项继续交给 return。
3.1.2 逻辑表达式
&& 是左边为真才执行右边:
处理前:
(n = a) && (e = typeof Symbol, o = l[51], n = e === o);
处理后:
if (n = a) {
  e = typeof Symbol;
  o = l[51];
  n = e === o;
}
|| 正好相反:左边为假才执行右边。样本中的下面一条 return 还同时包含三目,我们可以先只看最前面的 (t = e) || (t = isNaN(c)):
处理前:
return (t = e) || (t = isNaN(c)), (e = t) ? e = null : ((t = {}).r = a, t.g = s, t.b = c, e = t), a = e;
处理后:
if (!(t = e)) {
  t = isNaN(c);
}
这里先执行 t = e,只有结果为假,才调用 isNaN(c) 并更新 t。
3.1.3 三目表达式
三目表达式要它展开,重点不只是消掉问号,还要把条件、写入和求值顺序保留下来。
处理前:
r = (n = e) ? 0 : 2;
处理中:把写入操作放进两条分支:
(n = e) ? r = 0 : r = 2;
处理后:分支转换成if else语句:
if (n = e) {
  r = 0;
} else {
  r = 2;
}
先用 n = e 的结果选支,再把 r 写成 0 或 2。n = e 这个赋值没有被删掉,也没有同时执行两次对 r 的写入。
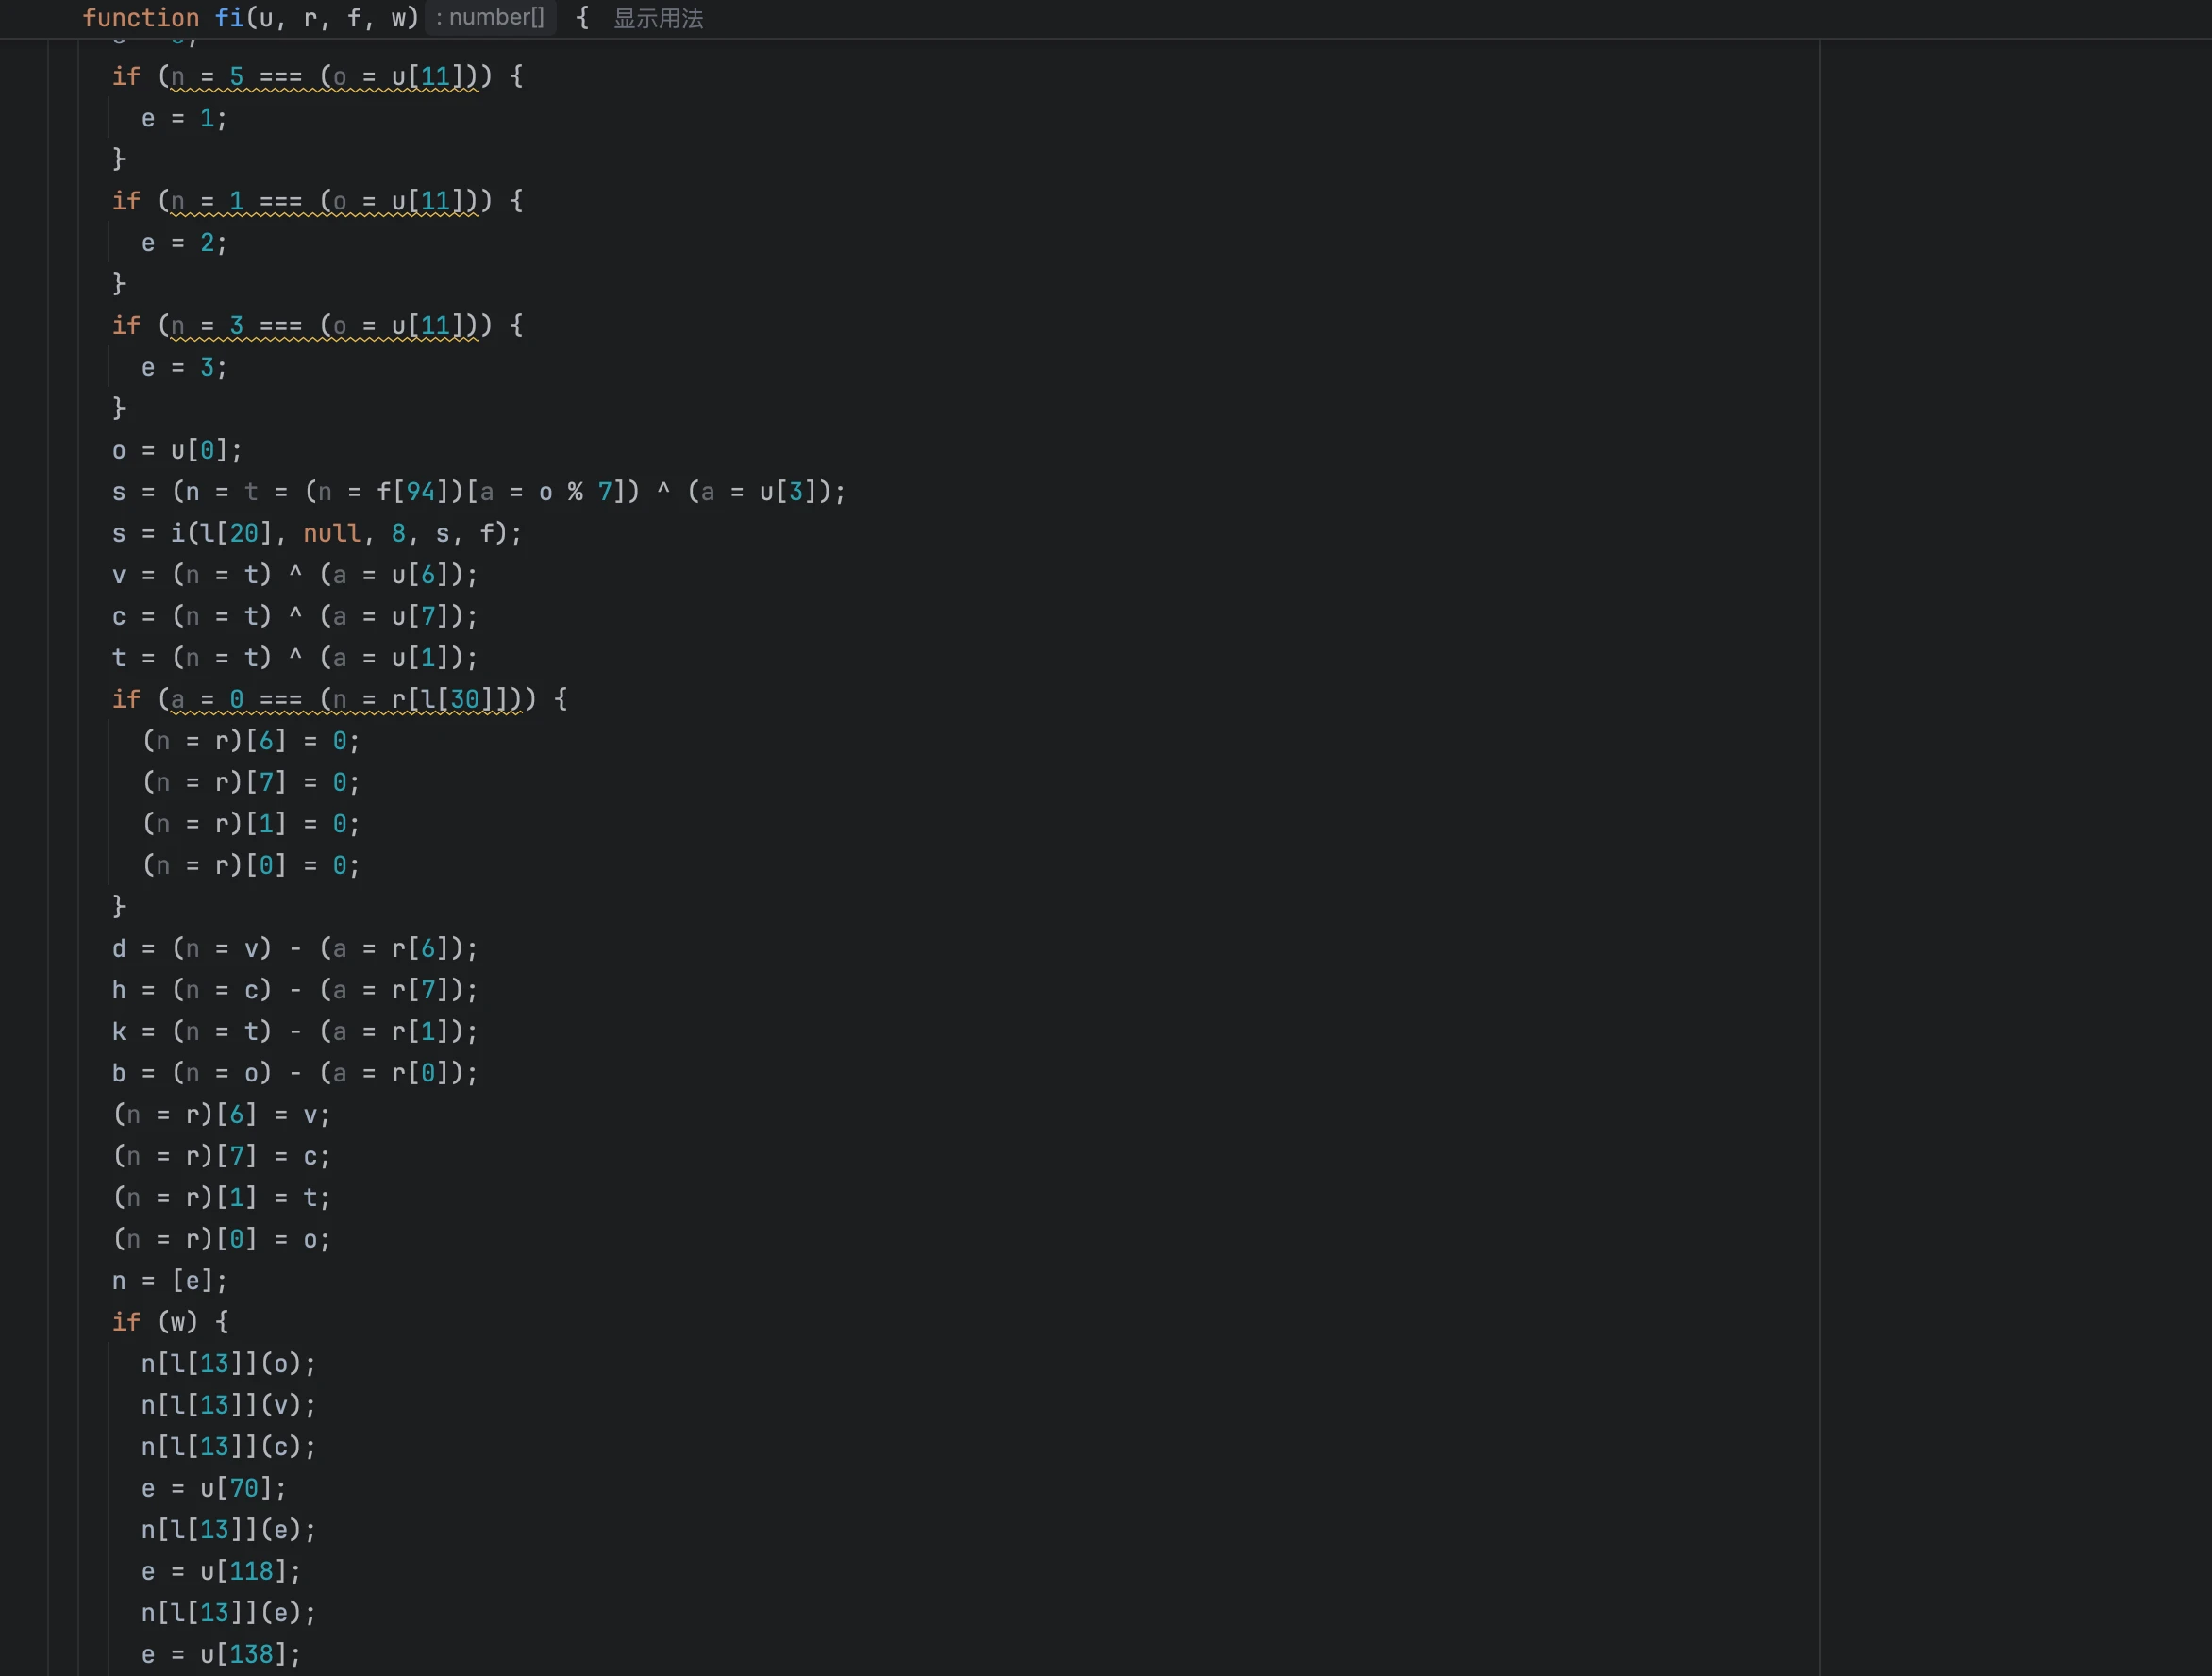
通过上面的规则,就能处理 fi 此函数里很长的一条 return。这里用的是前面几条规则的组合:逗号表达式,逻辑表达式,三目表达式,最后一项保留返回值。
处理前:
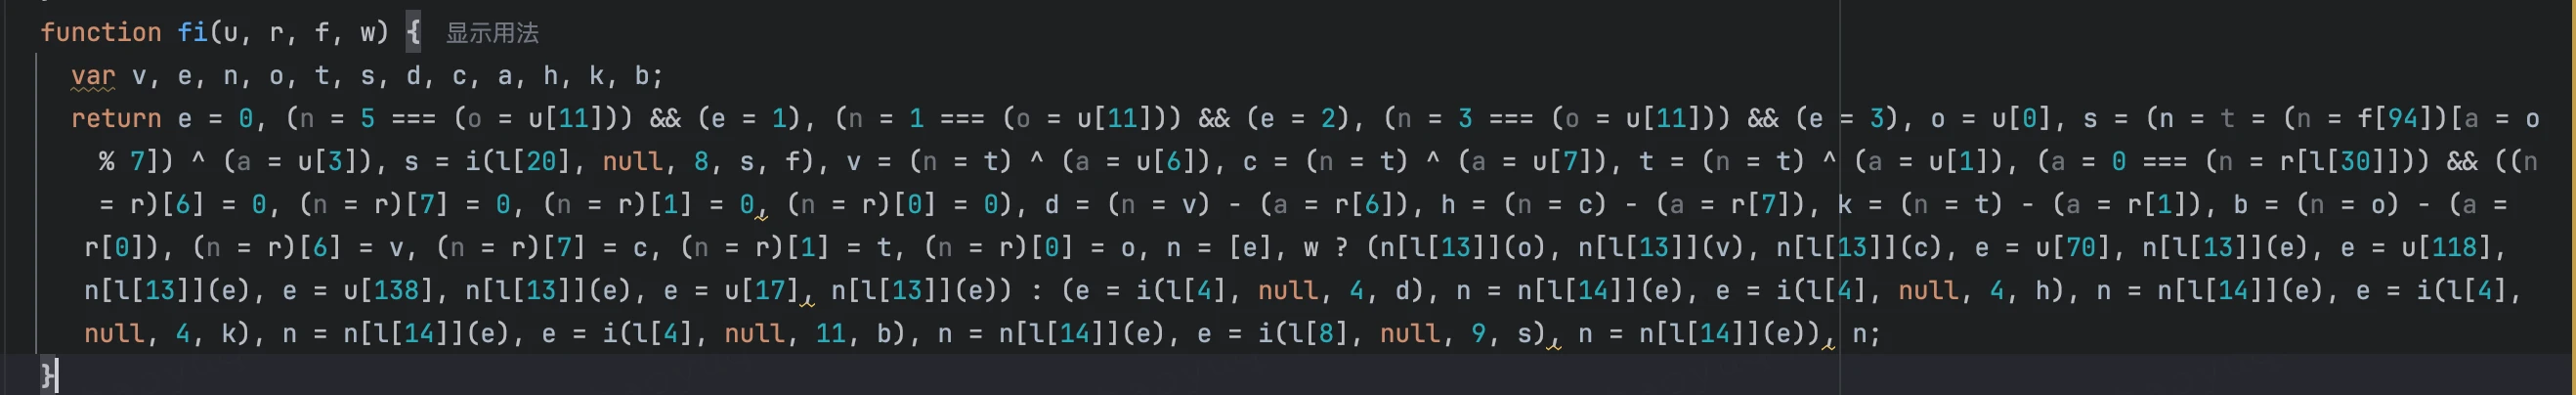
处理后:
3.1.4 统一条件处理的方向
混淆代码会把常量放在左边,比如 0 == o。可以统一为“变量在左、常量在右”这样的格式:
处理前:
if (0 == o) {
  ql = function t(a) {
处理后:
if (o == 0) {
  ql = function t(a) {
这里判断的仍是 o 是否等于 0。遇到大小比较时,交换两边还要反转比较符号,不能只交换操作数:
处理前:
if (1 < o) {
  // ...
}
处理后:
if (o > 1) {
  // ...
}
同样的整理也用于 switch 的简单按位表达式:
处理前:
switch (3 & n) {
  case 0:
处理后:
switch (n & 3) {
  case 0:
3.1.5 处理单句分支
这一步把单句 if/else 分支统一写成代码块,让每条语句更清楚表示属于哪个分支。
处理前:
if ("undefined" != typeof globalThis) m = globalThis;else if ("undefined" != typeof global) m = global;else if ("undefined" != typeof self) m = self;else {
  if ("undefined" == typeof window) throw new Error("Unable to detect global object.");
  m = window;
}
处理后:
if ("undefined" != typeof globalThis) {
  m = globalThis;
} else {
  if ("undefined" != typeof global) {
    m = global;
  } else {
    if ("undefined" != typeof self) {
      m = self;
    } else {
      if ("undefined" == typeof window) {
        throw new Error("Unable to detect global object.");
      }
      m = window;
    }
  }
}
3.1.6 去掉标签跳转
break l 与普通 break 不一定跳到同一个地方。所以需要使用do ... while (false) 包裹:
处理前:
l: try {
  (r = b.CSS) && (o = b.CSS, e = (n = l[3][175])[0], c = i(l[4], null, 13, e), e = l[3][n[1]], r = o[e = c + (n = i(l[8], null, 8, e))]);
  (v = r) && (r = b.CSS, o = l[3][175], n = l[3][o[0]], e = i(l[4], null, 16, n), n = o[1], v = r[n = e + (o = i(l[8], null, 17, n))](d, h));
  f = v;
  t = 39;
  break l;
} catch (l) {
  t = 40;
  break l;
}
处理后:
do {
  try {
    (r = b.CSS) && (o = b.CSS, e = (n = l[3][175])[0], c = i(l[4], null, 13, e), e = l[3][n[1]], r = o[e = c + (n = i(l[8], null, 8, e))]);
    (v = r) && (r = b.CSS, o = l[3][175], n = l[3][o[0]], e = i(l[4], null, 16, n), n = o[1], v = r[n = e + (o = i(l[8], null, 17, n))](d, h));
    f = v;
    t = 39;
    break;
  } catch (l) {
    t = 40;
    break;
  }
} while (false);
do ... while (false) 只是一个单次执行、可以被 break 退出的外壳。如果跳转与标签之间还夹着别的循环或 switch,就不能直接去标签,否则 break 可能跳错层级。所以会检查如果存在层级则保留对应的结构。
3.1.7 处理立即执行函数
样本里有两种立即执行函数的写法:一种把函数交给执行器调用,另一种在定义后直接调用。两者都可以去掉调用外壳,让内部操作直接出现在执行位置。
3.1.7.1 通过执行器立即调用
有些 case 并不直接写业务,而是先定义一个函数,再交给执行器立即调用。下面的操作被放进了 u(function () { ... }, this):
处理前:
先看 u 的定义。这里只摘出执行器相关的两个变量;定义和下面的调用位于源码的不同位置:
var gi = Function.prototype.call,
    u = gi.bind(gi);
这里的 u(fn, this) 相当于 fn.call(this):立即执行 fn,并把当前的 this 作为函数调用时的接收对象。确认这一点后,再看调用处,就知道这是一个立即执行的回调:
u(function () {
  e = Symbol[l[52]];
  n = a !== e;
  r = 2;
}, this);
处理后:
e = Symbol[_l20[52]];
n = a !== e;
r = 2;
3.1.7.2 直接自调用
另一种包装没有辅助执行器,而是函数定义后直接调用。IIFE 就是这种立即调用的函数表达式。样本最外层的 !function () { ... }() 属于这一类。看这一层展开前后的开头:
处理前:
!function () {
  var Bi = void 0,
    n = parseInt,
    z = Uint8Array,
    b = String,
处理后:
var _Bi = void 0,
  _n9 = parseInt,
  _z18 = Uint8Array,
  _b = String,
3.1.8 识别状态变量
经过前面的表达式展开、语法整理和立即执行函数展开,代码已经变成下面这样。以 _q55 为例,具体操作已经展开成语句,但代码执行的顺序流由 switch (Z & 7) 和派生值 N 下的多层 if 共同决定。
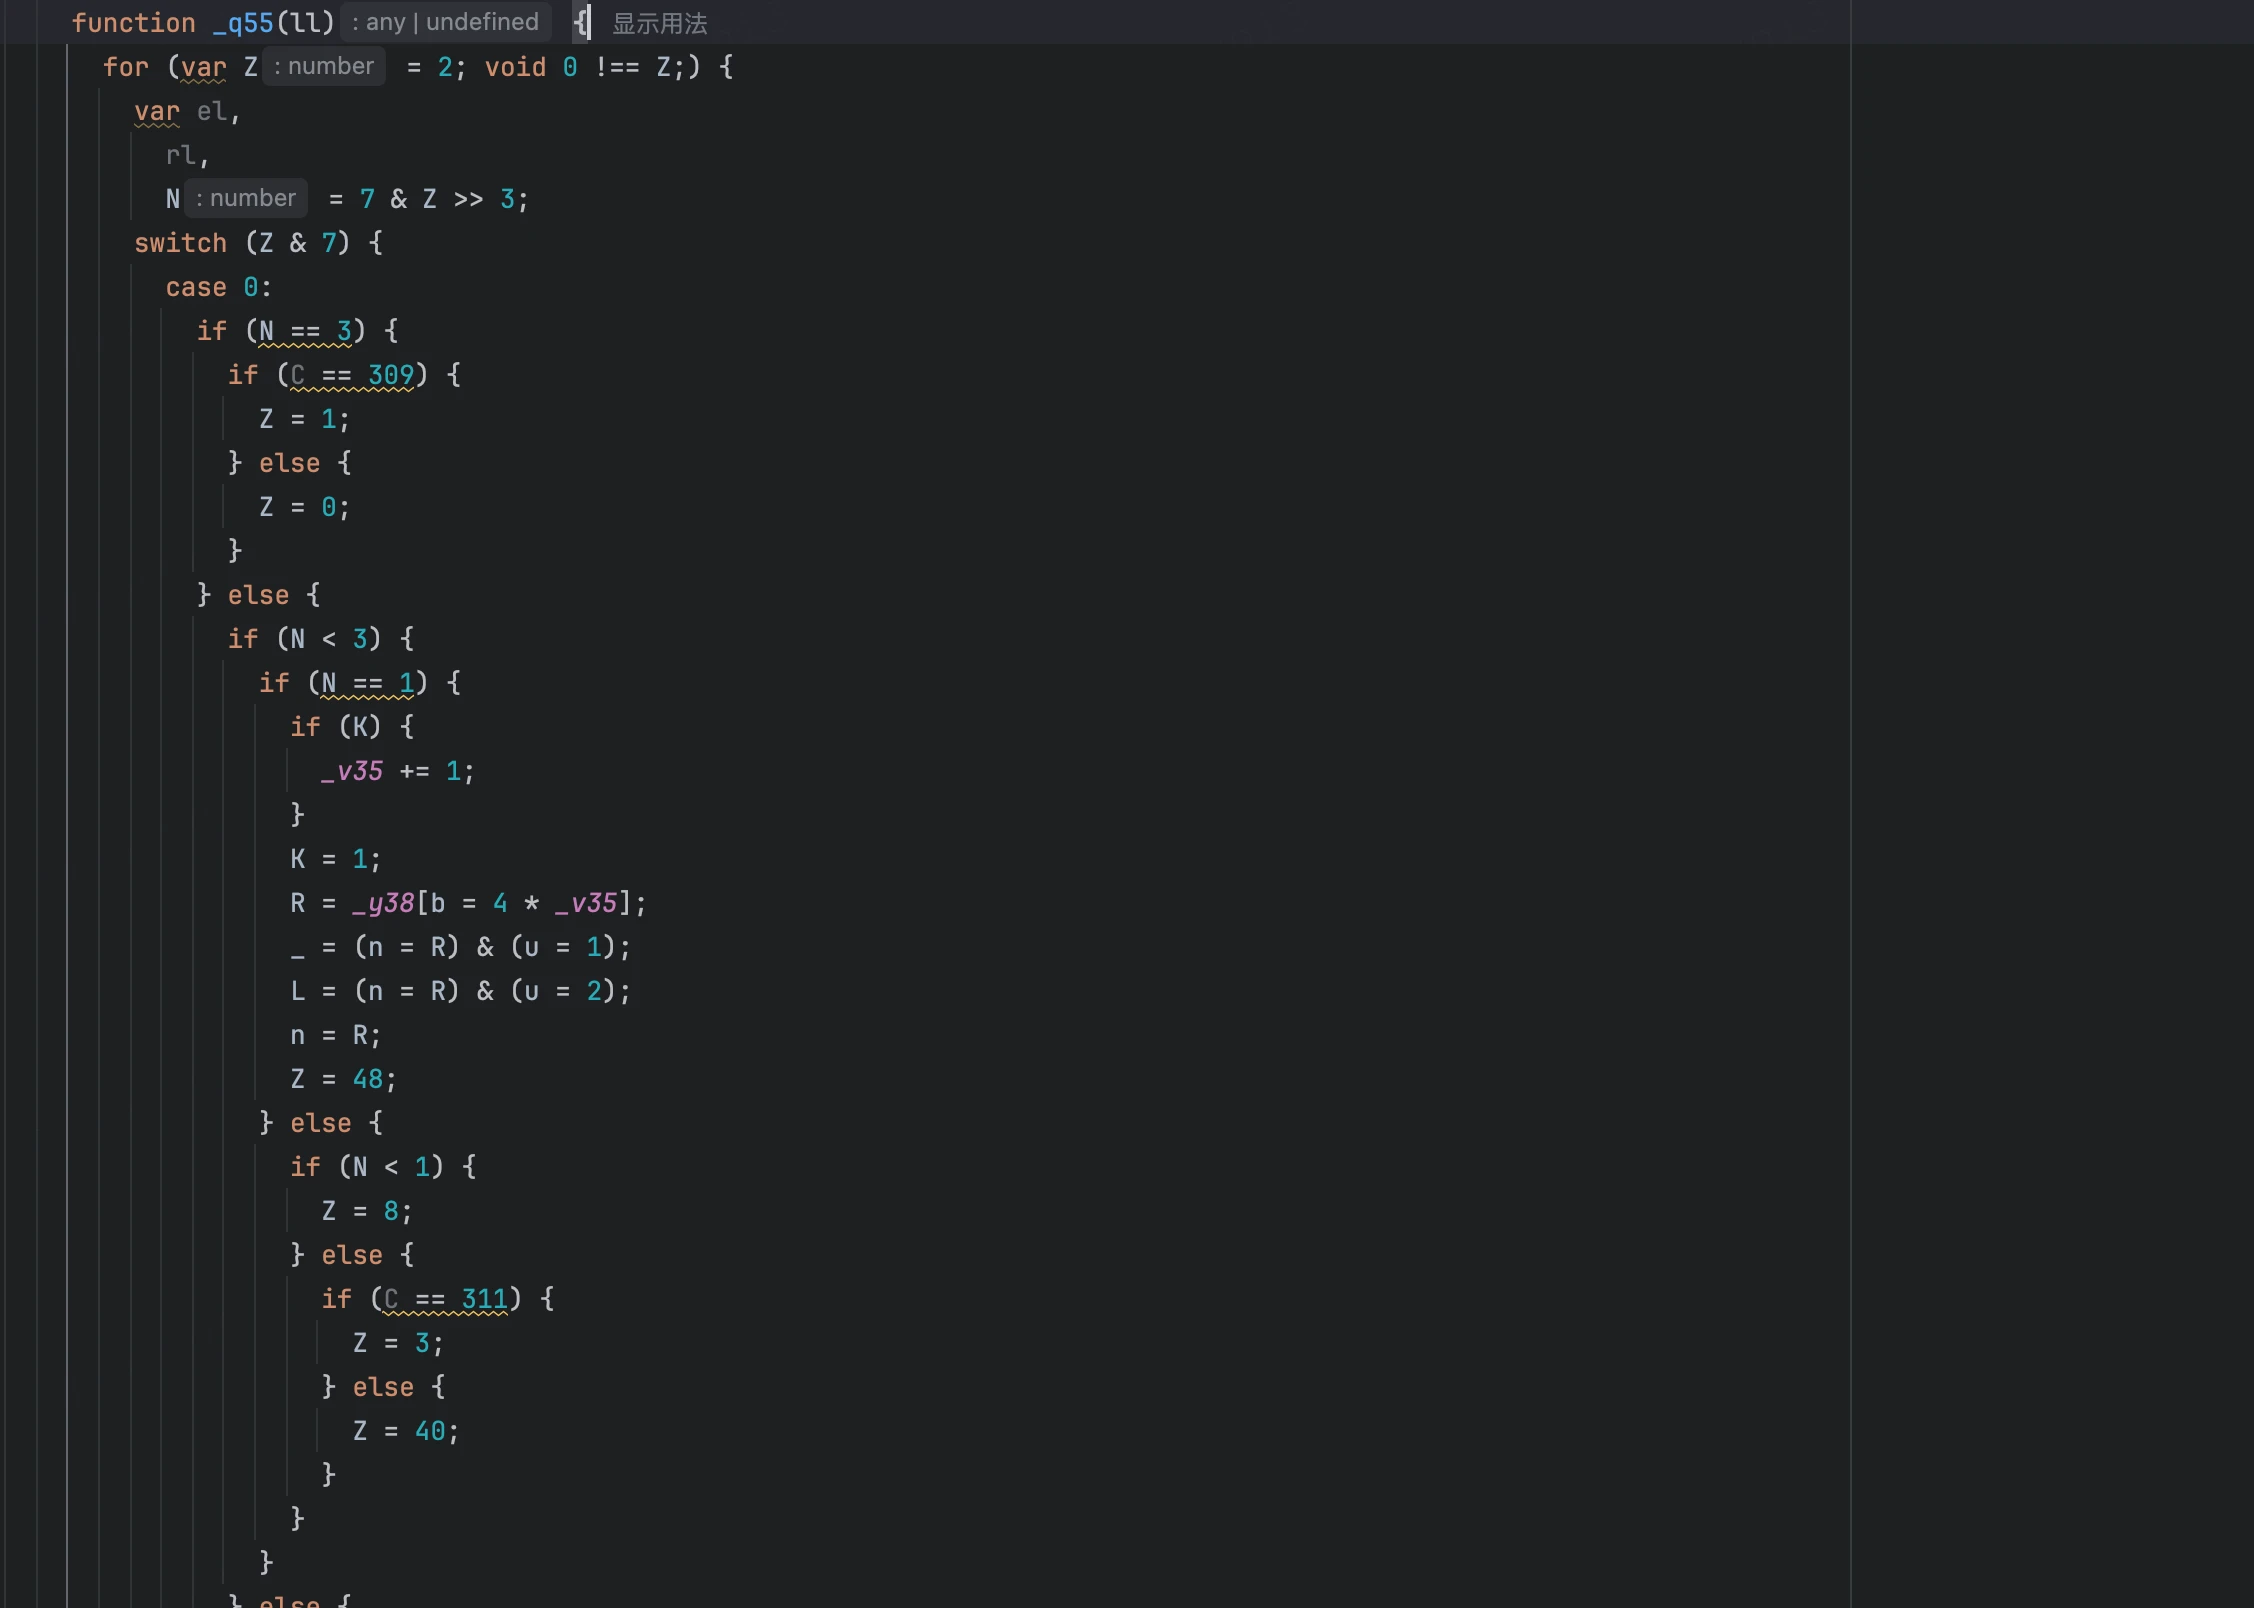
接下来,我们的目标是把同一状态变量及其派生值控制的多层结构,整理成一个直接按完整状态分派的 switch。就是把 switch (Z & 7) 和针对 N 的分派 if 统一成 switch (Z),首先先得认清哪个是状态变量,哪些值是由它派生出来的。这里的思路是:从 for 的循环条件找到候选,再看 switch 是否直接使用它,或者使用由它计算出来的派生值;
继续看截图中的 _q55(ll),它的入口是:
function _q55(ll) {
  for (var Z = 2; void 0 !== Z;) {
    var el,
      rl,
      N = 7 & Z >> 3;
    switch (Z & 7) {
void 0 !== Z 表示 Z 不是 undefined 就继续循环,因此先选 Z 作为候选;switch (Z & 7) 又使用 Z 的低三位选 case,确认它参与分派。回到初始化,Z = 2 给出入口状态。N = 7 & Z >> 3 则从 Z 计算出派生值 N,最终识别的是:状态变量 Z、入口状态 2,以及派生变量 N。
3.1.9 把状态变量的if转switch
上一节已经确认 _q55(ll) 的状态变量是 Z,N 是由 Z 计算出来的派生值。思路是:把原代码段与临时编号建立映射,用编号写入替换代码段,只留下 N 的判断;再给 N 代入不同整数,模拟执行,记录每个 N 选中的编号,最后生成 switch,并把原代码段放回对应 case。
处理前:
case 0:
  if (N == 3) {
    if (C == 309) {
      Z = 1;
    } else {
      Z = 0;
    }
  } else {
    if (N < 3) {
      if (N == 1) {
        if (K) {
          _v35 += 1;
        }
        K = 1;
        R = _y38[b = 4 * _v35];
        _ = (n = R) & (u = 1);
        L = (n = R) & (u = 2);
        n = R;
        Z = 48;
      } else {
        if (N < 1) {
          Z = 8;
        } else {
          if (C == 311) {
            Z = 3;
          } else {
            Z = 40;
          }
        }
      }
    } else {
      if (N == 5) {
        if (C == 310) {
          Z = 4;
        } else {
          Z = 24;
        }
      } else {
        if (N < 5) {
          Z = void 0;
        } else {
          $ = n & (u = 4);
          S = _y38[n = b + 1];
          J = _y38[n = b + 2];
          P = _y38[n = b + 3];
          Z = 5;
        }
      }
    }
  }
  break;
处理1:映射原代码段,用编号替换。
例如,N == 3 分支中的整个 if (C == 309) ... else ... 保存为片段 0;依次类推,接着,把每个原代码段替换成对应的编号记录。处理后就变成下面这样:
if (N == 3) {
  if (typeof code_state === "undefined") {
    code_state = 0;
  }
} else {
  if (N < 3) {
    if (N == 1) {
      if (typeof code_state === "undefined") {
        code_state = 1;
      }
    } else {
      if (N < 1) {
        if (typeof code_state === "undefined") {
          code_state = 2;
        }
      } else {
        if (typeof code_state === "undefined") {
          code_state = 3;
        }
      }
    }
  } else {
    if (N == 5) {
      if (typeof code_state === "undefined") {
        code_state = 4;
      }
    } else {
      if (N < 5) {
        if (typeof code_state === "undefined") {
          code_state = 5;
        }
      } else {
        if (typeof code_state === "undefined") {
          code_state = 6;
        }
      }
    }
  }
}
code_state 就是用来记录“选中了哪个片段”,每次代入一个新的 N,都会重新创建初始值为 undefined 的 code_state。
处理2:给 N 代入值,收集选中的编号。
对这段样本,得到的选块结果是:
| N 的值 | 最终记录的 code_state |
|---|---|
| 0 | 2 |
| 1 | 1 |
| 2 | 3 |
| 3 | 0 |
| 4 | 5 |
| 5 | 4 |
| 6、7 | 6 |
N 由 (Z >> 3) & 7 得到,实际取值为 0~7。
处理后:还原代码段
case 0:
  switch (N) {
    case 0:
      Z = 8;
      break;
    case 1:
      if (K) {
        _v35 += 1;
      }
      K = 1;
      R = _y38[b = 4 * _v35];
      _ = (n = R) & (u = 1);
      L = (n = R) & (u = 2);
      n = R;
      Z = 48;
      break;
    case 2:
      if (C == 311) {
        Z = 3;
      } else {
        Z = 40;
      }
      break;
    case 3:
      if (C == 309) {
        Z = 1;
      } else {
        Z = 0;
      }
      break;
    case 4:
      Z = void 0;
      break;
    case 5:
      if (C == 310) {
        Z = 4;
      } else {
        Z = 24;
      }
      break;
    default:
      $ = n & (u = 4);
      S = _y38[n = b + 1];
      J = _y38[n = b + 2];
      P = _y38[n = b + 3];
      Z = 5;
      break;
  }
  break;
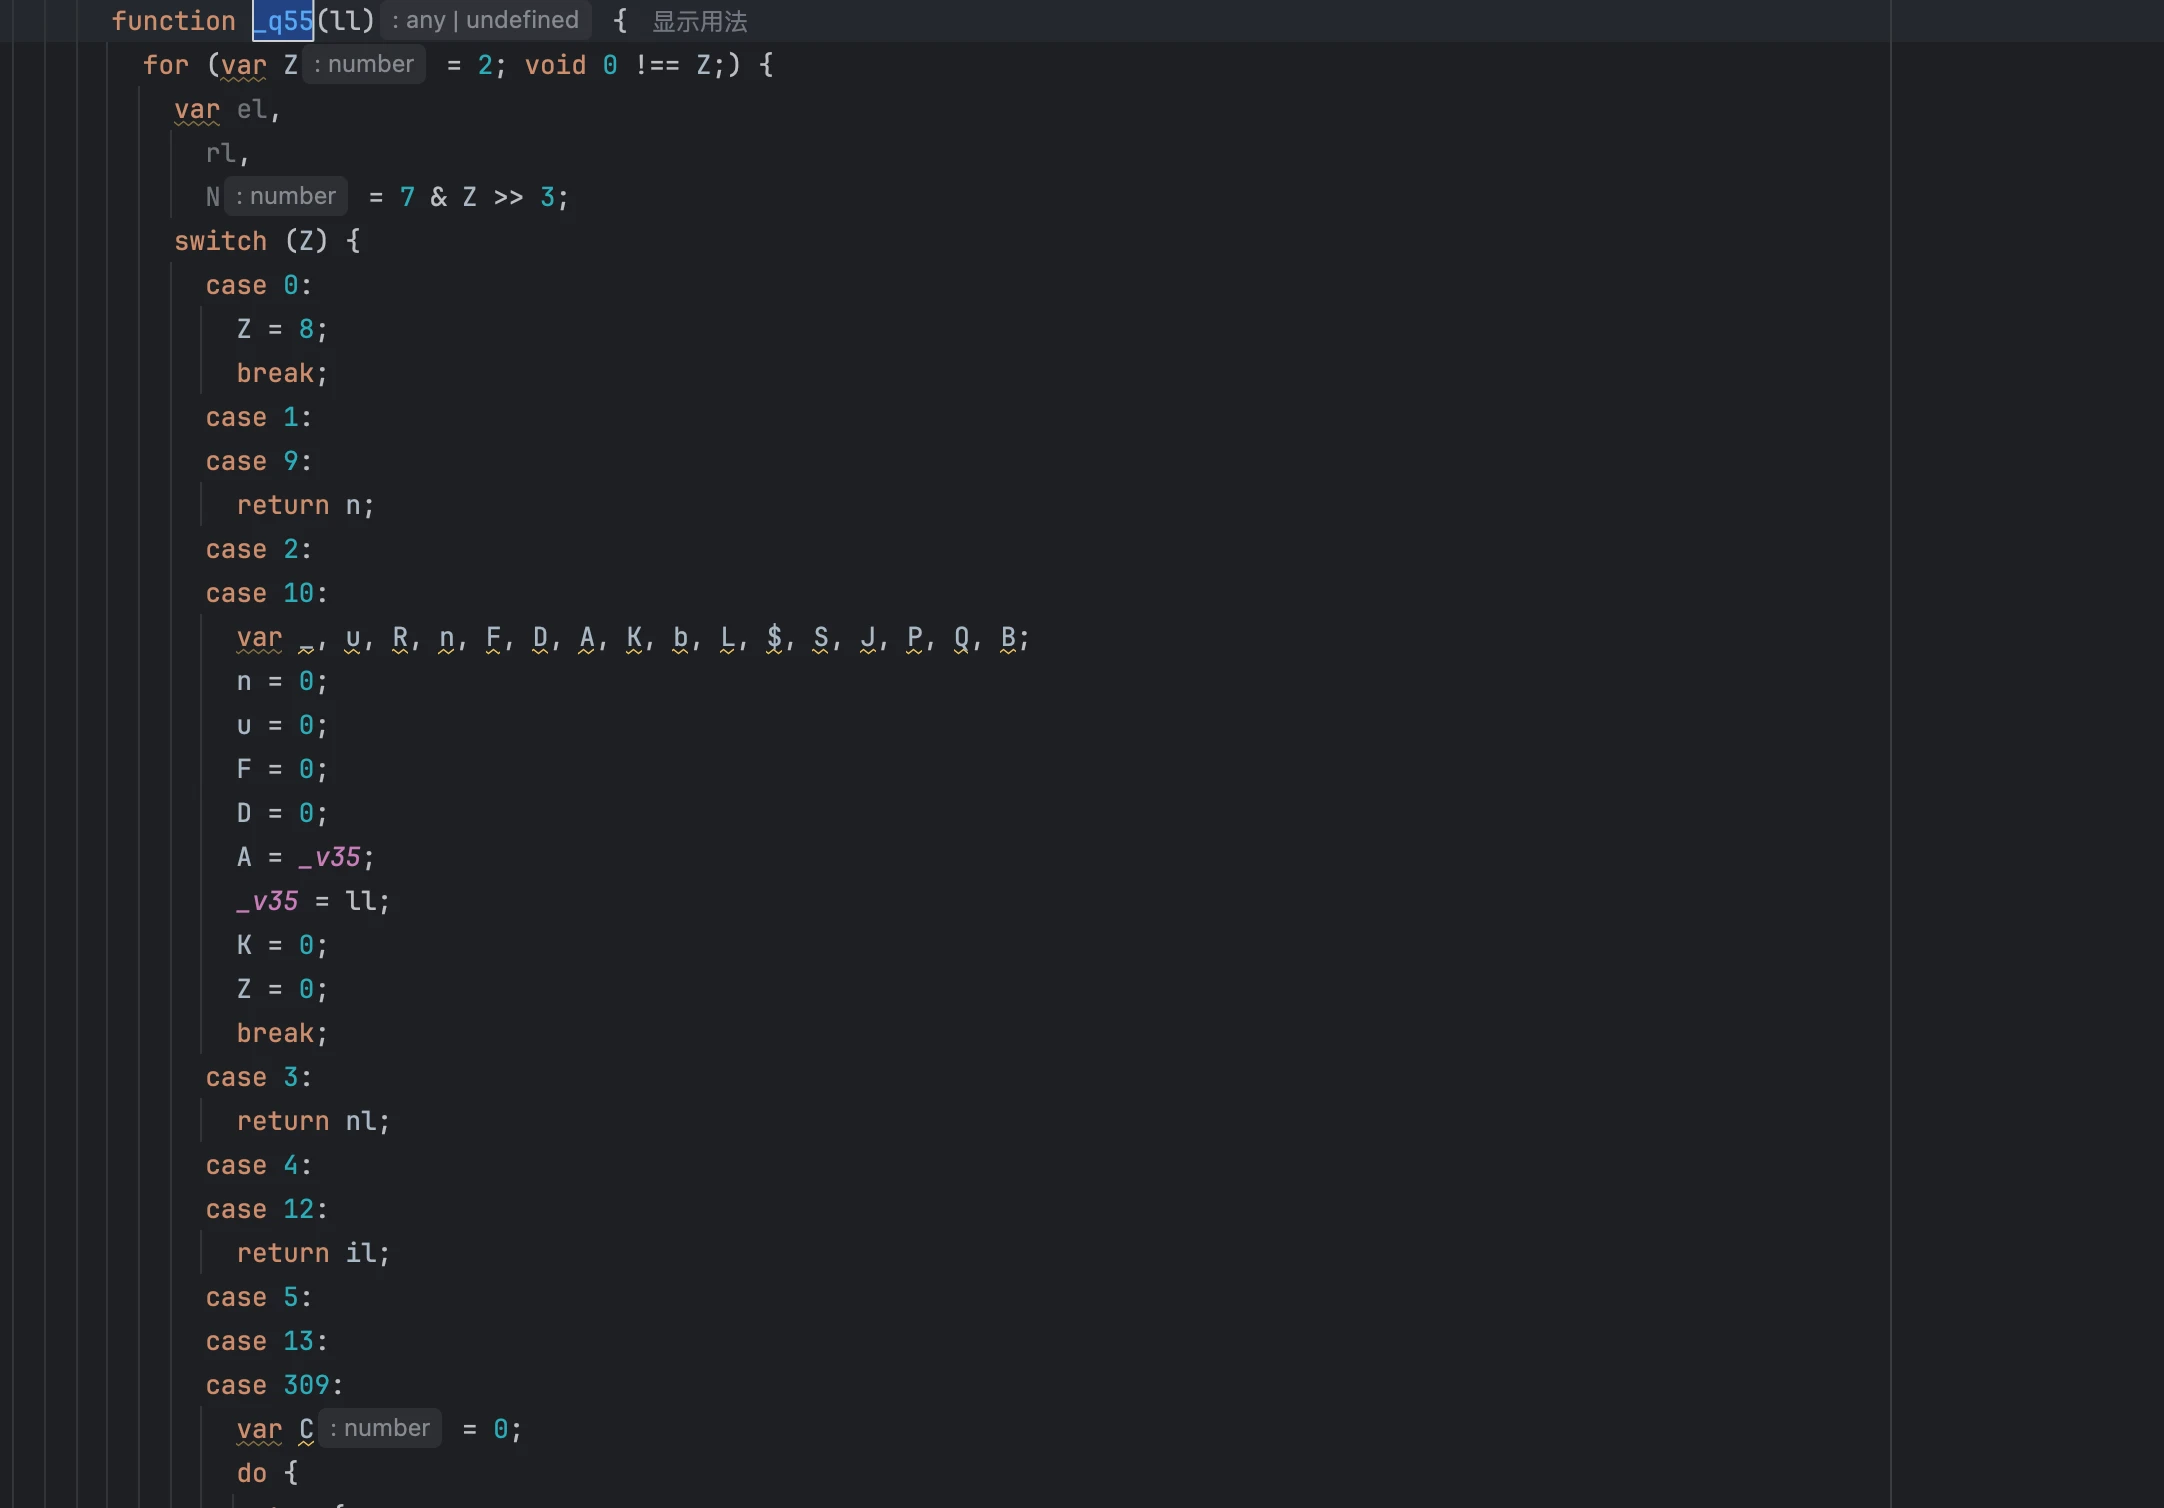
3.1.10 多层嵌套switch转换成一层switch
多层 switch 如果它们使用的是同一个状态变量或由它算出的派生值,就可以把这些合成一个switch。和上一节的思路类似:先保存各层分派最终选中的代码段,用编号替换;再收集候选状态值,逐一代入,记录每个状态会选中哪个编号;最后根据这份“状态值 → 代码段”的映射,把代码段放回单层 switch 中。
处理前:
经过上一节处理,分派入口是下面这样:
function _q55(ll) {
  for (var Z = 2; void 0 !== Z;) {
    var el,
      rl,
      N = 7 & Z >> 3;
    switch (Z & 7) {
      case 0:
        switch (N) {
          case 0:
            Z = 8;
            break;
处理1:保存原代码段,用临时编号替换。
这样就得到下面临时分派代码:
....
{
  var el,
    rl,
    N = 7 & Z >> 3;
  switch (Z & 7) {
    case 0:
      switch (N) {
        case 0:
          code_state = 0;
          break;
        case 1:
          code_state = 1;
          break;
        case 2:
          code_state = 2;
          break;
        case 3:
          code_state = 3;
          break;
        case 4:
          code_state = 4;
          break;
        case 5:
          code_state = 5;
          break;
        default:
          code_state = 6;
          break;
      }
      break;
    case 1:
      code_state = 7;
      break;
    case 2:
      code_state = 8;
      break;
    case 3:
      code_state = 9;
      break;
    case 4:
      code_state = 10;
      break;
    case 5:
      code_state = 11;
      break;
  }
}
处理2:收集编号,给完整状态值代入。
先从 Z = 2 的入口和各处需要保留的值,每次代入一个 Z,都重新创建初始值为 undefined 的 code_state,执行上面的临时分派代码,再读回编号。
这一轮实际收集得到:
| 状态 Z | 记录的 code_state |
|---|---|
| 0 | 0 |
| 8 | 1 |
| 16 | 2 |
| 24 | 3 |
| 40 | 5 |
| 48 | 6 |
| 1、9 | 7 |
| 2、10 | 8 |
| 3 | 9 |
| 4、12 | 10 |
| 5、13、309 | 11 |
处理后:把原代码段放回对应 case
3.1.11 删除不透明谓词
不透明谓词是指在程序执行时其值恒定已知,但在静态分析或逆向工程中难以推断的条件表达式,用于增加代码分析难度和实现控制流混淆。
这里处理的思路是:先识别 case 尾部的下一状态赋值分支,再找出条件表达式依赖的变量。结合当前 case 的,按执行顺序跟踪判断变量之前的声明、赋值和计算,中间发生修改,就更新已知值;如果存在无法确定的计算,就将相关值标为未知。只有能够证明判断时条件恒真或恒假,才保留条件求值和实际会执行的分支,否则保持原样。
处理前:
  var _m35 = 0,
    _S17 = 0,
    _M2 = 0;
  _t3 = [];
  _t3 = 0;
  _t3 = 1;
  _t3 = 2;
  _t3 = [];
  _t3 = {};
  _t3 = _f80(_T8, this, 0);
  if (_m35) {
    _x10 = 2;
  } else {
    _x10 = 0;
  }
处理后:
var _m35 = 0,
  _S17 = 0,
  _M2 = 0;
_t3 = [];
_t3 = 0;
_t3 = 1;
_t3 = 2;
_t3 = [];
_t3 = {};
_t3 = _f80(_T8, this, 0);
_x10 = 0;
3.2 第一轮控制流还原
前面的预处理已经把挤在表达式里的操作展开成语句,并把状态分派 if 和多层 switch 整理成直接按完整状态分派的 switch,接下来就要还原这些代码的控制流:找到哪些片段顺序执行,哪里发生分支,哪里形成循环,再把它们写回顺序语句、if/else 和循环。这里我们使用 CFG(Control Flow Graph,控制流图) 来梳理执行顺序:把每个 case 对应的执行片段看成一个节点,再根据能够确认的下一状态跳转,用有向边将节点连接起来,表示代码的执行顺序。
3.2.1 建图前预处理:给共享标签补上显式跳转
对于共享标签的情况。思路是:找到空 case 后的第一个非空 case,给空 case 写入这个目标状态,再补上 break。(当前这些共享执行体,没有发现case 代码体里读取状态派生值的情况,因此可以统一补跳转。如果存在这种依赖,就不能直接改成目标状态,而应该给空 case 复制代码体。)
处理前:
case 4:
case 8:
case 52:
  _ql = function i(l) {
    return typeof l;
  };
  n = 2;
  break;
处理后:
case 4:
  n = 52;
  break;
case 8:
  n = 52;
  break;
case 52:
  _ql = function i(l) {
    return typeof l;
  };
  n = 2;
  break;
3.2.2 建图前预处理:合并顺序链
共享标签整理清楚后,还可以减少一些不必要的分派。有些 case 执行完只会进入下一个确定的 case,而这个目标 case 也只有一处明确的状态跳转指向它。从执行顺序来看,这两段代码本来就是前后相接的 ,顺序链合并的思路,就是把这段连续执行的代码接起来,减少中间的分派。
具体做法是:把目标 case 的语句接到当前 case 后面,去掉两者之间的下一状态赋值和 break,保留目标 case 最后的跳转或终止语句。如果后面还有符合条件的连接,就继续合并。这样,业务语句仍按同样的顺序执行。
但是注意两种情况:
- 目标是循环并且是初始化入口: 这是一个入口节点,并且有单边指向这个入口节点,这种情况就不能合并。
- case 中使用了状态变量的派生值,就不能合并。 这里检查待合并的两个 case,直接使用状态变量及其派生变量的不能合并。
处理前:
case 48:
  Y = 24;
  break;
case 24:
  if (D) {
    _v2 += 1;
  }
  D = 1;
  J = _z19[Z = 4 * _v2];
  V = (n = J) & (t = 1);
  C = (n = J) & (t = 2);
  n = J;
  Y = 32;
  break;
case 32:
  P = n & (t = 4);
  Q = (n = J) & (t = 8);
  B = (n = J) & (t = 16);
  g = _z19[n = Z + 1];
  x = _z19[n = Z + 2];
  n = Z + 3;
  Y = 16;
  break;
case 16:
  F = _z19[n];
  Y = 5;
  break;
处理后:
case 48:
  if (D) {
    _v2 += 1;
  }
  D = 1;
  J = _z19[Z = 4 * _v2];
  V = (n = J) & (t = 1);
  C = (n = J) & (t = 2);
  n = J;
  P = n & (t = 4);
  Q = (n = J) & (t = 8);
  B = (n = J) & (t = 16);
  g = _z19[n = Z + 1];
  x = _z19[n = Z + 2];
  n = Z + 3;
  F = _z19[n];
  ....
3.2.3 从入口收集可达节点
前面通过预处理已经给共享标签补上了跳转,也合并了一些能够连续执行的 case。接下来使用 DFS 建图:从初始化入口开始,分析当前 case 执行哪些语句、执行后会去哪里,再沿着找到的目标继续搜索。遇到条件跳转,两条可能的路径都要分析;这样既能建立节点之间的执行关系,也能排除从入口始终无法到达、因此不会执行的 case。 图中只记录从入口可达的节点。
3.2.4 定位分支汇合点,恢复 if/else
图建好之后,接下来要把图中的分支恢复成 if/else。这里不能沿着两条路径一直生成到出口,否则两支后面共用的代码也会被分别复制,生成的代码会不断膨胀。因此,对于分支我们需要找到找到分支汇合点。 这里使用后支配关系来找到最近的分支汇合点。
后支配关系:从 B 走向当前分析区域出口的每一条路径,都必须经过 P。则节点 P 后支配节点 B。
这里的思路是:从分支的两个后继出发,找出它们走向出口时都必须经过的节点,再选最近的共同经过的那个节点作为汇合点。(也就是找最近的后支配节点。)
以下面的图举例:状态 1 是分支节点,条件为真进入 52,为假进入 0。从 52 走向出口,必须经过 2;从 0 走向出口,也必须经过 2。因此,2 后支配这两个节点,是两支的共同必经后续。两支在经过 2 之前,没有其他共同节点,所以 2 就是最近的共同必经节点,也就是这个分支的汇合点。
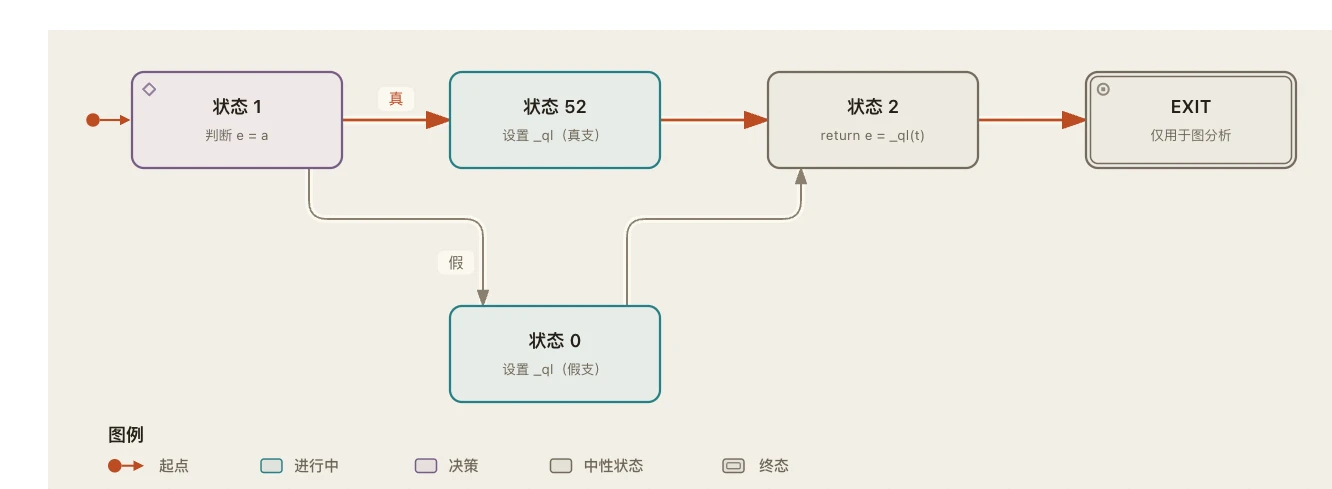
找到汇合点后,就可以确定 if/else 的范围:在状态 1 处生成条件判断。 之后分别生成分支在状态 2 之前停止。在 if/else 后面生成状态 2 的代码。
3.2.5 定位自然循环,恢复循环结构
对于图中的有环区域,需要确认哪些代码会重复执行、每一轮从哪里开始。因此,我们需要先找到循环头,再确定循环范围。这里使用支配关系来确认自然循环。
支配关系:从入口走到节点 N 的每一条路径,都必须经过 H,则 H 支配 N。
这里的思路是:在从入口可达的控制流图中,同时满足下面两个条件,确认一个自然循环:
- H 支配 N:从入口到 N 的每条路径都经过 H。
- 存在真实的边
N → H。
两点同时成立,N → H 就是自然回边,H 就是这个自然循环的循环头。
以下面的图举例:从入口 6 走到状态 8,每条路径都必须经过 48,因此 48 支配 8;图中又确实存在 8 → 48,所以这条边是自然回边,48 就是循环头。确认循环头后,从回跳起点沿图中的边反向收集节点,到循环头为止。图中从 8 反向追到 41,再到 48,因此循环范围是 {48, 41, 8}。
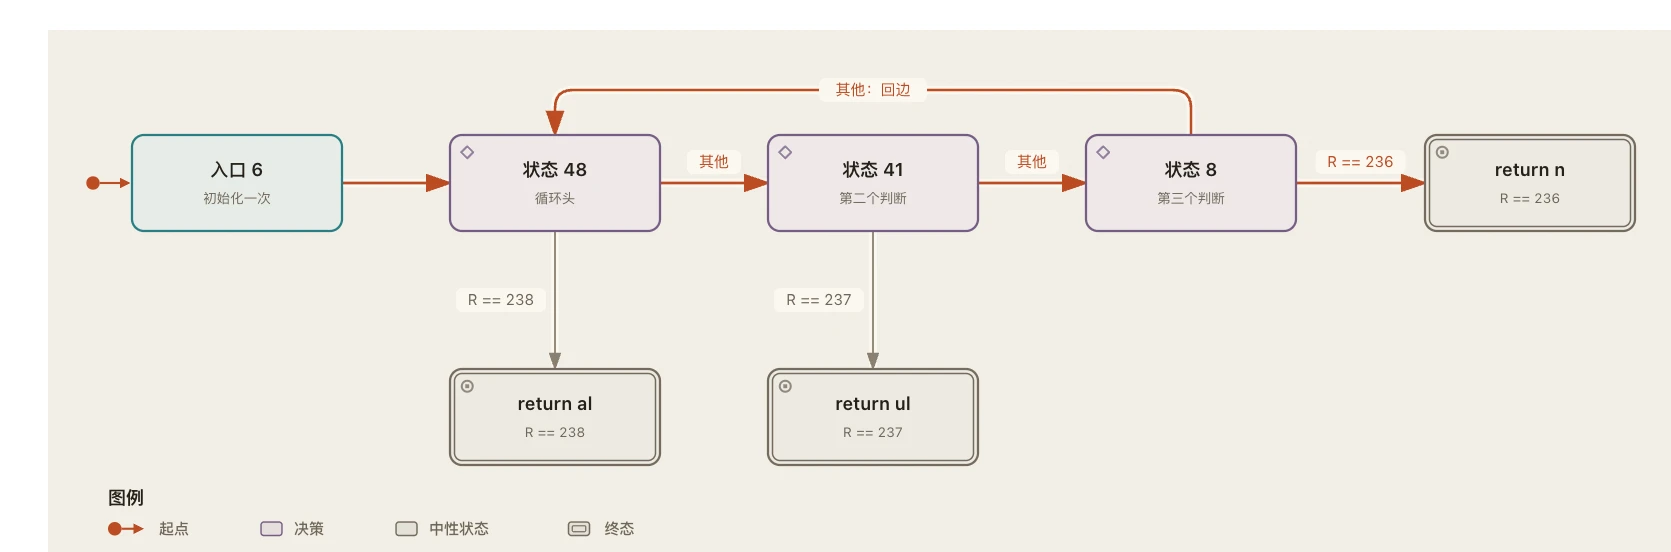
找到循环范围后:48、41、8 的代码放在循环内,48是循环头。 图中三条 return 路径则保留各自的返回效果,结束函数调用。
3.2.6 状态派生值:按当前节点计算,再替换读取
CFG 会按照顺序语句、if/else 和循环控制流生成代码,此时需要把for+switch 这样的dispatch分派器删除掉。但代码段中可能仍然存在读取状态变量或它的派生值。这里的思路是:对代码段中使用的状态变量或它的派生值的情况,按每个节点的状态求出对应值,再将该节点中的读取替换成具体常量。
处理前:进入 switch 前计算 x,case 32 中再读取它。
for (var g = 36; void 0 !== g;) {
  var bl,
    wl,
    x = 7 & g >> 3;
  switch (g) {
    // 其他 case 省略
    case 32:
      if (x < 5) {
        throw v = _O8, w = _q26.length, w = _q26[w -= 1], v = new _h73(v, w);
      }
      if (C) {
        _s8 += X;
      } else {
        v = _u9;
        w = R;
        J = a[X];
        v[w] = J[a[F]];
      }
      g = 1;
      break;
  }
}
处理后:去掉分派结构,对应片段直接使用节点确定的值。
4 < 5;
throw v = _O8, w = _q26.length, w = _q26[w -= 1], v = new _h73(v, w);
...
3.2.7 第一轮CFG,存在少量分派器无法还原的情况。
经过前面的语句整理、建图和分支与循环恢复。不少原本依靠 for + switch 跳转的代码,已经能直接按顺序语句、if/else 和循环阅读:
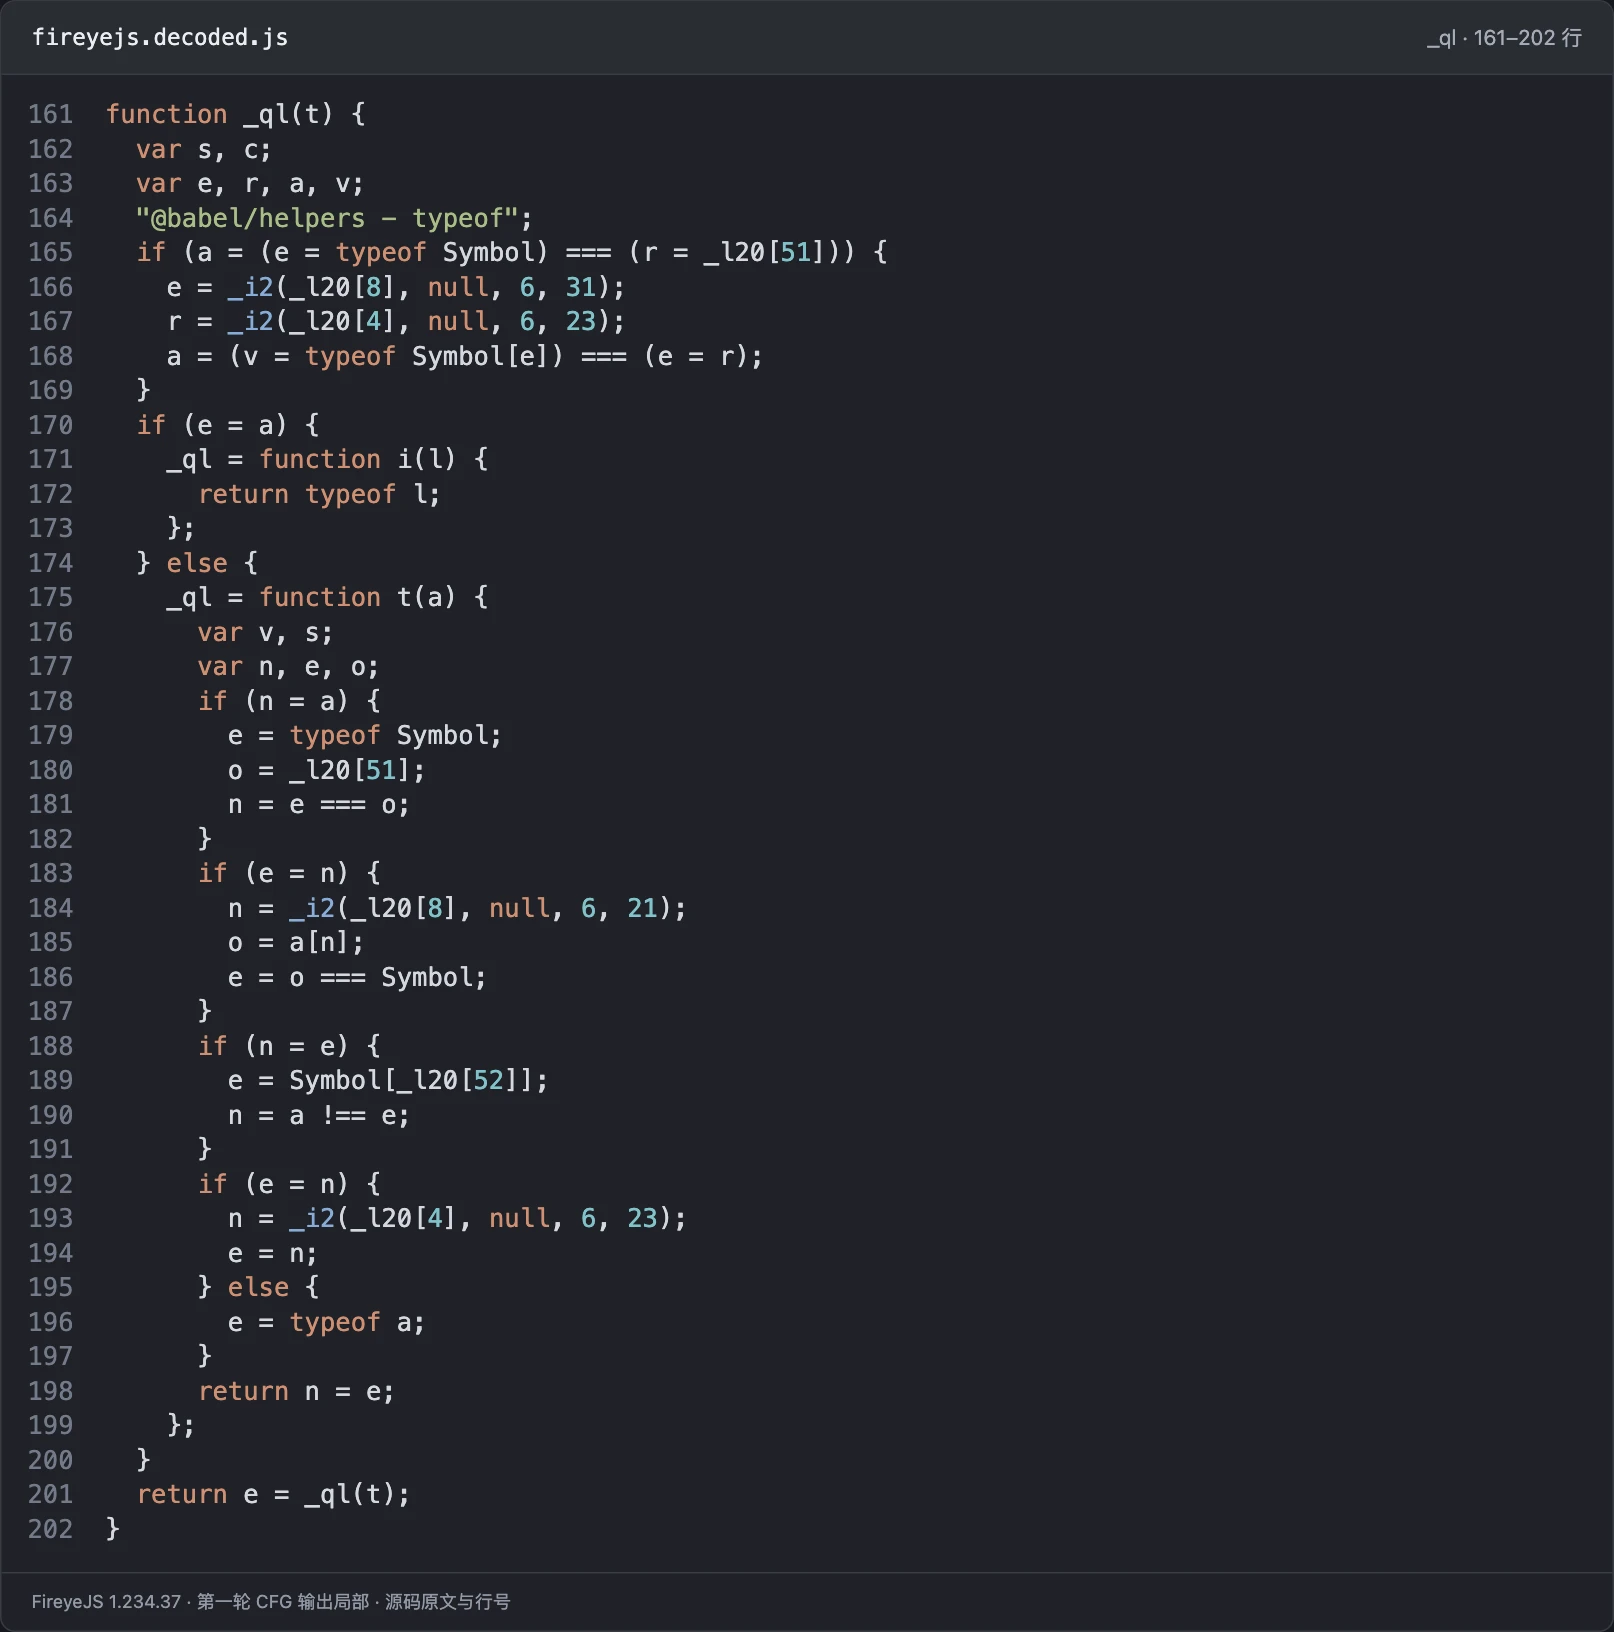
但是第一轮并没有恢复所有分派器。原因是分析某个 case 的尾部时,无法确认执行后的下一个状态。发现这个问题后,就要回到具体位置分析:case 尾部为什么没有识别出下一状态?下面就沿着一个残留的分派器,追查它的原因。
下面的例子,它的宿主状态变量是 a[6],这里case的尾部没有出现a[6] = 下一状态,这里就是分析停住的位置:无法从 case 尾部直接确认下一状态。
for (a[71] = xe, a[73] = je, a[9] = me, a[6] = 23; void 0 !== a[6];) {
  // 省略
  switch (a[6]) {
    // 省略其他 case
    case 323:
      a[8] = void 0;
      a[4] = a[9];
      // 省略初始化
      _v8 = 0;
      _v8 = 1;
      _v8 = 2;
      _v8 = [];
      _v8 = {};
      _v8 = _f80(_G12, this, 0);
      _m39;
      _S23 = 0;
      break;
  }
}
但不能因此确认这个case没有下一状态,因为此case里还调用了_G12 函数,_G12 可以修改外部数组 a。接下来要跟进这次调用,看看状态写入是不是在函数里面。
跟进 _G12 :
function _G12(cl) {
  // 省略局部变量声明及其他初始化
  el = _s8;
  _s8 = cl;
  $ = 0;
  while (true) {
    if ($) {
      _s8 += 1;
    }
    $ = 1;
    P = _z25[N = 4 * _s8];
    // 省略根据 P 计算 C、D、Q、ll、rl 的标志语句
    X = _z25[v = N + 1];
    F = _z25[v = N + 2];
    v = N + 3;
    R = _z25[v];
    var L = 0;
    do {
      try {
        // 省略这里的局部变量声明
        if (rl) {
          if (ll) {
            // 省略其他指令分支
          } else {
            if (Q) {
              if (D) {
                // 省略其他指令分支
              } else {
                if (C) {
                  v = _u9;
                  w = R;
                  J = _l20[X];
                  v[w] = J[F];
                } else {
                  // 关键:写入外层 rr 的数组 a
                  a[v = X] = F;
                }
              }
            } else {
              // 省略其他指令分支
            }
          }
        } else {
          // 省略其他指令分支
        }
      } catch (l) {
        // 省略异常捕获、完成状态设置及恢复逻辑
      }
    } while (false);
    // 根据完成状态返回,或者继续取下一条指令
    if (L == 88) {
      return dl;
    } else {
      if (L == 87) {
        return fl;
      } else {
        if (L == 86) {
          return v;
        } else {
          continue;
        }
      }
    }
  }
}
可以看到这是一个VM,并且存在 a[v = X] = F:它先把 X 赋给 v,再将 F 写入 a[X]。不过,只看到这条语句,还不能断定本次调用一定修改了下一状态。还需要确认执行到了哪条指令,以及当时 X、F 分别是多少。这里通过动态运行确认执行到这里时,变量为:
X = 6;
F = 617;
R = 0;
a[v = X] = F;
代入操作数,这条指令的状态写入效果就是a[6] = 617:宿主靠 a[6] 分派,VM 内部的这条指令向同一个位置写入 617。
因此分析完毕这个 case 的拒绝根因:因为下一状态写入隐藏在被调用的 VM 中,没有直接出现在宿主 case 的尾部。 第一轮 CFG 缺少这次调用的状态效果,所以保留了分派器。
接下来要做的就是先发现 VM、恢复它的指令操作,再把已证明的宿主下一状态显式表达出来,才能继续恢复外层控制流。
3.3 VM 还原
3.3.1 寻找解释器并反向找到指令数组
接下来分析 VM,最重要的就是找到VM。我们的思路是:先根据取指和执行特征找到解释器,再找到启动它的调用、确认入口,最后从调用位置反向追踪它实际使用的指令数组。
3.3.1.1 通过取指和执行特征找解释器
还不知道哪个函数是解释器时,可以先遍历源码中的函数,寻这样一组结构:循环中按固定宽度读取数组,用第一个元素选择不同操作,再推进读取数组的位置。
下面以_G12 举例:
function _G12(cl) {
  // 省略
  el = _s8;
  _s8 = cl;
  $ = 0;
  while (true) {
    if ($) {
      _s8 += 1;
    }
    $ = 1;
    // 以4作为指令长度,读取指令。
    P = _z25[N = 4 * _s8];
    C = (v = P) & (w = 1);
    D = (v = P) & (w = 2);
    v = P;
    Q = v & (w = 4);
    // 省略
    // 读取操作码
    X = _z25[v = N + 1];
    F = _z25[v = N + 2];
    v = N + 3;
    R = _z25[v];
    // 省略
  }
}
先看读取位置:N = 4 * _s8,随后读取同一个数组的 N、N + 1、N + 2、N + 3。也就是说,每个 _s8 对应一组四个元素。循环还会对 _s8 加一。再看四个元素如何使用。第一个元素 P 被拿来做 & 1、& 2、& 4,得到 C、D、Q。这些标志就是用来选择执行分支的值。后面的根据它们进入不同代码,例如下面这段 D、C 分支:
if (D) {
  if (C) {
    a[v = X] = _u9[F];
  } else {
    v = _u9[X];
    w = _u9[F];
    _e2(v, w);
  }
} else {
  if (C) {
    v = _u9;
    w = R;
    J = _l20[X];
    v[w] = J[F];
  } else {
    a[v = X] = F;
  }
}
于是,这一步识别出的关系是:
解释器:_G12
PC:_s8
指令数组引用:_z25
每条指令:P、X、F、R,共四个元素
此时通过上面的逻辑可以找到解释器函数,但是还没有确认调用位置和原始指令数组,下一步去找调用位置。
3.3.1.2 通过函数引用查找解释器调用位置
找到解释器后,通过作用域沿函数引用就可以找到调用位置:
_v8 = _f80(_G12, this, 0);
这里还要知道 _f80 做什么。追到它的定义,可以看到:
// 摘录同一文件中的定义,省略相邻的其他变量。
var _mi = Function.prototype.call;

function _Q(l) {
  return l.call.bind(l);
}

var _f80 = _Q(_mi);
_f80 是把 Function.prototype.call 包装成可以直接调用的函数。因此,这次调用的效果可以理解为下面的写法:
_G12.call(this, 0);
_G12 在这里被同步执行;0 作为参数传给了 cl。结合解释器开头的 _s8 = cl,第二个参数0就代表PC的初始值。
3.3.1.3 从调用位置反向追踪实际使用的指令数组
找到解释器及其启动调用后,接下来要确认它实际读取的指令数组来自哪里。这里的思路是:从解释器使用的指令数组引用入手,以启动调用为定位点,沿调用前的定义、赋值和别名关系反向追溯,确认它指向哪一次创建的数组。
以 _G12 为例,它通过 _z25 读取指令:
P = _z25[N = 4 * _s8];
之后我们看函数调用时时这个引用在哪。以VM函数调用的 _f80(_G12, this, 0) 为定位点,反向查找 _z25 的赋值,找到:
var _z25 = _w11,
  _R4 = [];
到这里,追踪对象从 _z25 变成了 _w11。因此继续从这次赋值往前追引用:
(_w11 = []).push(
  10, 1, 4, 0,
  7, 183, 0, 0,
  26, 4, 0, 0,
  4, 0, 2, 5
  ...
);
_w11 = [] 创建了数组,随后的 push 向它写入整数,下一句 _z25 = _w11 又取得这份数组引用。这样就把解释器的取指与具体数组连接起来了。
3.3.2 把指令翻译回js代码
拿到完整指令数组后,接下来就要把这些数字指令重新表达成 JavaScript,思路是:按照解释器的取指方式拆出每条指令,把每条指令的操作码代入解释器的分派条件,找到实际执行的代码,再代入指令的操作数;同时按照解释器更新 PC 的规则,确定下一条指令。最后把这些操作和跳转写成规范for+switch IR,最后交给通用 CFG 恢复执行顺序。
为方便阅读,文中生成的 switch 分派状态变量统一写为 vmState,仅简化展示名称,不改动实际产物。不同执行入口仍各有自己的状态变量。
3.3.2.1 确认每条指令的位置和字段
当前所有识别的 VM,都以四个数组元素组成一条指令。接下来根据解释器的取指和使用方式,确认这四个元素分别对应操作码和哪些操作数。
还是以 _G12 为例,每次按四个元素取指。数组开头按指令划分后,
(
  10, 1, 4, 0,
  7, 183, 0, 0,
  26, 4, 0, 0,
  4, 0, 2, 5
  ...
);
可以整理成下表:
| PC(指令位置) | 操作码 P | 操作数 X | 操作数 F | 操作数 R |
|---|---|---|---|---|
| PC 0 | 10 | 1 | 4 | 0 |
| PC 1 | 7 | 183 | 0 | 0 |
| PC 2 | 26 | 4 | 0 | 0 |
每一行就是一条完整指令,由一个操作码和三个操作数组成。
3.3.2.2 代入操作码和操作数,确认代码段。
这里的思路是:将操作码代入已经确认的分派条件,沿条件选出对应代码,再将操作数代入这段代码。 以 PC 2 的操作码 26 为例,原解释器对应的分派区域是:
// 读取当前指令的操作码,并计算分派标志。
P = _z25[N = 4 * _s8];
C = (v = P) & (w = 1);
D = (v = P) & (w = 2);
v = P;
Q = v & (w = 4);
ll = ~(~((v = P) & (w = 8)) & ~(v & w)); // 等价于 P & 8。
v = P;
w = 1 << _n9("100", 2); // _n9 是 parseInt ,这里 w 为 16。
rl = ~(~(v & w) & ~(v & w)); // 等价于 P & 16。

// 读取同一条指令的三个操作数。
X = _z25[v = N + 1];
F = _z25[v = N + 2];
v = N + 3;
R = _z25[v];

// 下面为分派判断
if (rl) {
  if (ll) {
    if (Q) {} else {
      if (D) {
        C || ((v = _u9)[w = X] = []);
      } else {
        // 省略其他操作。
      }
    }
  } else {
    // 省略其他操作。
  }
} else {
  // 省略其他操作。
}
分析过程:将 26 代入标志计算。
rl = 26 & 16 = 16 → 真
ll = 26 & 8  = 8  → 真
Q  = 26 & 4  = 0  → 假
D  = 26 & 2  = 2  → 真
C  = 26 & 1  = 0  → 假
因此沿 rl 为真 , ll 为真 , Q 为假 , D 为真,最后确认代码块:
C || ((v = _u9)[w = X] = []);
再把 X 为 4、C 为 0 代入,就能确认这条指令的操作:在 _u9[4] 中放入一个新数组。这样,PC 2 的指令 [26,4,0,0] 就与解释器中的这段操作代码对应起来了。
3.3.2.3 按 PC 生成 case,确定下一 PC
前面已经确认了每条指令对应的操作代码,以及当前指令的 PC、操作数和标志值。接下来要做的是把这些分析结果写成可以执行的代码。这里的思路是:用 PC 作为 case 标签,把操作中仍然确定的读取替换成已知值,再逐个检查原 PC、操作数和标志的入口赋值:仍被需要的保留,不再需要的省略。最后按照原解释器更新 PC 的规则确定下一条指令,写入下一分派状态,用 break 回到 switch。 这样就把指令组织成了 for + switch 中间表示。
PC 2:顺序执行
以 PC 2 为例。上一节已经确认它对应的操作是:
C || ((v = _u9)[w = X] = []);当前指令的 C 为 0、X 为 4,这些值已经确认,生成代码时,直接把它们写到操作中的读取位置:
0 || ((v = _u9)[w = 4] = []);这个VM会在后续每轮取指前执行
_s8 += 1。PC 2 的操作没有额外修改_s8,因此下一条指令是2 + 1 = 3。把当前操作和下一位置放到一起,就得到完整的 case:case 2: _s8 = 2; 0 || ((v = _u9)[w = 4] = []); vmState = 3; break;PC 1:无条件跳转
接下来再看一个会修改 PC 的跳转指令的例子。PC 1 的指令是
[7,183,0,0],选出的原操作是:_s8 += X;X 为 183,所以操作中的读取直接写成
_s8 += 183。从当前 PC 1 开始,执行这句后_s8为1 + 183 = 184;原解释器在下一轮取指前还会加一,因此真正的下一 PC 是1 + 183 + 1 = 185。处理后:
case 1:
  _s8 = 1;
  _s8 += 183;
  vmState = 185;
  break;
PC 78:条件跳转
以 PC 78 的指令
[12,1,0,50]为例,选出的原操作是:v = _s8; N = a[X]; _s8 = v + (N ? w = N = F : w = N = R);代入 X 为 1、F 为 0、R 为 50,判断条件是运行时的
a[1]。它不由操作码决定,所以两支都要保留:若 a[1] 为真:78 + 0 + 1 = 79 若 a[1] 为假:78 + 50 + 1 = 129处理后:
case 78:
  _s8 = 78;
  F = 0;
  R = 50;
  v = 78;
  N = a[1];
  _s8 = v + (N ? w = N = F : w = N = R);
  vmState = _s8 === 78 ? 79 : 129;
  break;
3.3.2.4 保留回调的创建、调用和入口关系
前面已经能把单条指令写成 case,但有些指令会先创建一个函数并保存起来,等调用这个函数时,再从另一个 PC 进入(也就是回调函数)。因此,不能只沿启动入口排列指令,还要保留回调进入 VM 的执行路径。
先确认回调在哪里创建和保存,再找到它在哪里被调用,确定它重新进入解释器的 PC,最后为启动路径和回调进入的路径分别生成 switch 执行体,用函数调用把两者连接起来。
继续以 _G12 为例。
生成代码保留主函数名 _G12。辅助执行函数按它实际接受的入口 PC 命名:本例只有 PC 2 这个回调入口,因此命名为 _pc2。 _pc2 是新增的 VM 执行函数,不是把原回调换了一个名字。当前样本的 _I37 则由同一辅助执行函数接受 PC 2 和 PC 32 两个回调入口,因此命名为 _pc2_32,而不是把所有 VM 的辅助函数都固定叫 _pc2。
创建回调:
PC 0 的指令是
[10,1,4,0],其中 X 为 1、F 为 4。对应的操作先定义一个用来创建回调的函数,再调用这个函数,用来创建回调:v = function c(a, o) { var n, l; l = 0; var v = _j50(n = {}, l = _d8), s = a; (n = _u9)[l = o] = function () { // 省略 n = _f80(o = _G12, this, c = s + 1); // 省略 }; }; _f80(v, this, w = X, J = F);代入当前指令的操作数:
_f80(v, this, w = 1, J = 4);这里调用的是用来创建回调函数 v:1 传给参数 a,4 传给参数 o。因此
s = a保存的是 1,_u9[o]保存回调的位置就是_u9[4]。再看回调内部的
c = s + 1:它传给解释器的入口值是1 + 1 = 2。这样就确认了两件事:回调保存在_u9[4],被调用后从 PC 2 进入解释器。调用回调:从调用位置接上 PC 2 的执行路径。
前面在 PC 0 创建了回调,并把它保存到
_u9[4],但这时只是保存函数,并没有执行函数体。接下来沿启动路径继续看:PC 1 跳到 PC 185,到了这里才取出并调用这个回调。此时 X 为 4,对应的操作是:// 省略调用前的状态保存和参数准备,此时 X = 4。 v = _u9[X]; il = _o2(v, null, w = _t9);_o2是样本对Function.prototype.apply的包装。这里先取出_u9[4]中保存的函数,再用_t9提供的参数调用它。执行到这次调用,才真正进入前面创建的匿名回调。再接上回调内部的代码:
// 位于 _u9[4] 中的匿名回调内部。
// 省略调用前的参数准备和状态保存;s 是创建回调时保存的 1。
n = _f80(o = _G12, this, c = s + 1);
// 省略调用后的状态恢复及结果处理。
这次调用把
s + 1,也就是 2,作为入口参数传给_G12。因此完整关系是:启动路径走到 PC 185 → 调用_u9[4]中的回调 → 回调重新调用解释器,从 PC 2 执行。生成回调执行体:连接两个 switch。
调用关系理清楚后,就知道生成代码时不能只处理从 PC 0 开始的启动路径,还需要一份从 PC 2 开始执行的代码。这里的思路是:在
_G12内生成辅助执行函数_pc2,让它用自己的 switch 执行从 PC 2 进入的指令;。处理前:回调重新调用解释器,从 PC 2 取指。
n = _f80(o = _G12, this, c = s + 1);处理后:回调调用已经翻译好的 PC 2 执行函数。
n = _pc2.call(this, c = s + 1);_pc2每次调用都有自己的一组局部变量和初始化,与启动执行体的局部变量分开。这样生成的两套 switch 就保留了前面确认的关系:启动 switch 执行到 PC 185 时调用回调,回调再调用_pc2的 switch,从 PC 2 执行;等这次调用完成,才回到原来的调用位置继续处理。处理后的执行结构:
function _G12(cl) {
  function _pc2(cl) {
    // 省略
    _s8 = cl;

    // 回调进入 VM 的执行体:从 PC 2 开始。
    for (var vmState = 2; vmState !== -1;) {
      switch (vmState) {
        case 2:
          _s8 = 2;
          0 || ((v = _u9)[w = 4] = []);
          vmState = 3;
          break;

        // 省略其他 case 及完成处理。
      }
    }
  }

  // 省略启动调用的局部变量声明、初始化和外层异常处理。

  // 启动执行体:本例从 PC 0 开始。
  for (var vmState = 0; vmState !== -1;) {
    switch (vmState) {
      case 0:
        _s8 = 0;
        v = function c(a, o) {
          var n, l;
          l = 0;
          var v = _j50(n = {}, l = _d8),
            s = a;

          // 这才是真正保存到 _u9[4] 的回调。
          (n = _u9)[l = o] = function () {
            // 省略局部变量声明、参数准备和状态保存。
            n = _pc2.call(this, c = s + 1);
            // 省略状态恢复及原来的 return/throw 结果处理。
          };
        };
        _f80(v, this, w = 1, J = 4);
        vmState = 1;
        break;

      case 1:
        _s8 = 1;
        _s8 += 183;
        vmState = 185;
        break;

      case 185:
        _s8 = 185;
        X = 4;
        F = 0;
        R = 0;
        v = _u9[X];
        // 2. 调用这个回调,开始执行回调内部的代码。
        il = _o2(v, null, w = _t9);
        (v = _u9)[w = R] = il;
        vmState = 186;
        break;

      case 186:
        _s8 = 186;
        // 省略
        throw v = _O8,
          w = _q26.length,
          w = _q26[w -= 1],
          v = new _h73(v, w);
    }
  }
}
因此对应的逻辑是:
case 185
  → 取出 case 0 创建的回调
  → 调用回调
      → 准备参数、保存状态
      → 调用 _pc2,从 PC 2 执行
      → 按原逻辑恢复状态、处理结果
  → 回调正常返回,结果赋给 il
  → 执行 case 185 后续的状态恢复和结果写入
  → vmState = 186
3.3.2.5 生成规范 switch IR
各条指令和执行入口明确后,就把它们组织成对应的 for + switch,保留必要的初始化和调用关系,再写回完整源码,得到switch 中间表示(IR),后面可以交给通用 CFG 继续还原。不过还需要把 VM 内部对宿主下一状态的写入提取出来,让外层控制流能连起来。
3.3.3 提取 VM 中对宿主 dispatch 下一状态的写入
前面已经把 VM 指令翻译成了 switch,但外层宿主分派器的有些 case 的下一状态是在 VM 内部写入的,因此需要把下一状态提取出来。这里的思路是:从翻译后的指令中找到对宿主状态变量的写入,结合调用关系确认宿主下一状态,再把这个结果显式写到宿主 case 的尾部。
继续沿前面的 _G12 来看。
宿主尾部
宿主使用
a[6]选择 case。case 323 调用_G12,调用之后没有下一状态:switch (a[6]) { // 省略其他 case。 case 323: // 省略 _G12 的函数定义、指令数组及调用前的准备代码。 _v8 = _G12.call(this, 0); _m39; _S23 = 0; break; }沿 VM 的执行关系,找到宿主状态写入。
前面已经确认,
_G12的启动路径会调用回调,再进入_pc2,从 PC 2 执行。沿这条路径分析,PC 183 对应的指令是[20,6,617,0],翻译后是:case 183: _s8 = 183; a[v = 6] = 617; vmState = 184; break;a[v = 6] = 617写入的就是宿主使用的a[6]。因此,这里把宿主下一状态设为 617。把已确认的下一状态写回宿主尾部。
调用关系和宿主状态对应清楚后,在原 case 的 break 前补上这条赋值:
处理后:
switch (a[6]) {
  // 省略其他 case。
  case 323:
    // 省略 _G12 的函数定义、指令数组及调用前的准备代码。
    _v8 = _G12.call(this, 0);
    _m39;
    _S23 = 0;
    a[6] = 617;
    break;
}
这时宿主尾部已经直接写出
a[6] = 617,通用 CFG 就能建立323 → 617这条边。
3.4 第二轮控制流恢复
到这里,VM 指令已经写成规范 switch,隐藏在 VM 中的宿主下一状态也已提出来。接下来使用前面同一个通用 CFG,把 VM 和剩余宿主分派器的控制流恢复成顺序语句、if/else 和循环。这一轮还遇到一种前面没有展开的情况:下一状态是从一张目标表中选出来。
目标表,就是数组中保存了一组确定的目标状态,运行时根据索引选择其中一个。这个结构其实在第一轮控制流还原的时候就有遇到过,但是当时包含它的宿主分派器还有 VM 隐藏下一状态,导致整个控制流没能完成结构化。这里针对目标表处理思路是:先确定“索引 → 目标状态”的对应关系,把这些目标作为后继继续还原,再把每个目标对应的执行代码放进按索引选择的 switch。
以 me 的 case 517 为例,它根据参数 Jn 选择下一状态:
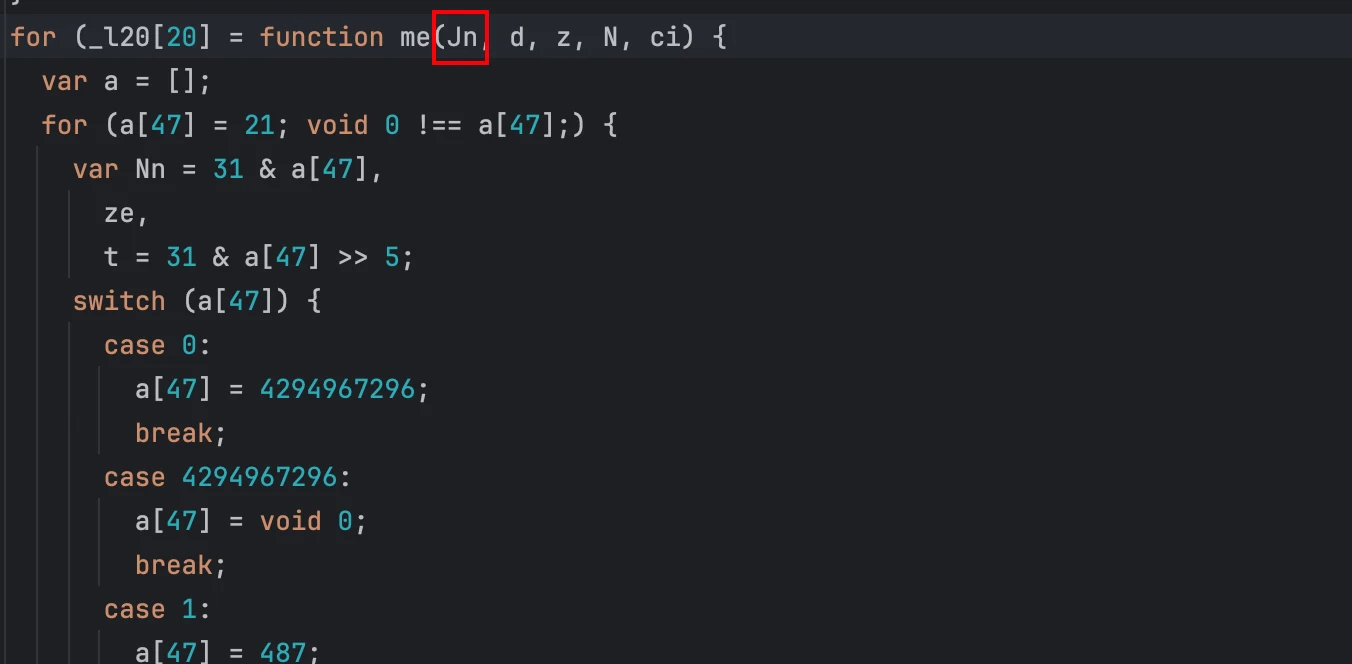
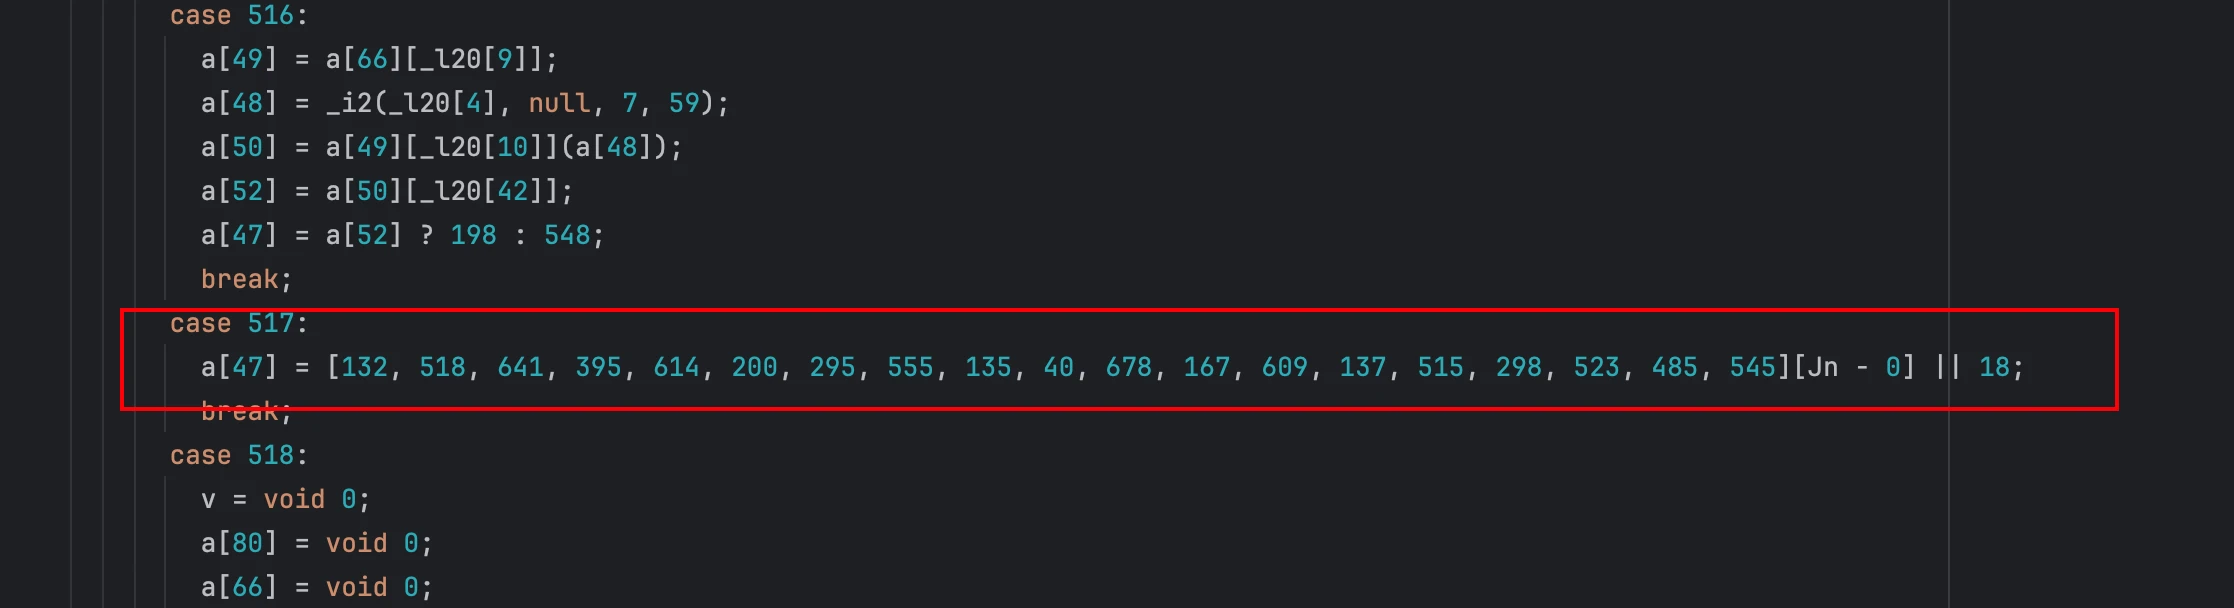
这些目标已经明确,因此可以沿各条路径还原代码,直接用索引选择对应的执行分支:
处理后:直接选择业务代码。
switch (Jn - 0) {
  case 0:
    // 从原宿主状态 132 开始的代码。
    v = void 0;
    a[80] = void 0;
    a[66] = void 0;
    s = void 0;
    // 省略这条分支的其余代码。
    break;

  case 1:
    // 从原宿主状态 518 开始的代码。
    v = void 0;
    a[80] = void 0;
    a[66] = void 0;
    s = void 0;
    // 省略其余初始化。
    G = d;
    a[55] = N;
    // 省略这条分支的其余代码。
    break;

  // 省略其他索引对应的 case。
  default:
    break;
}
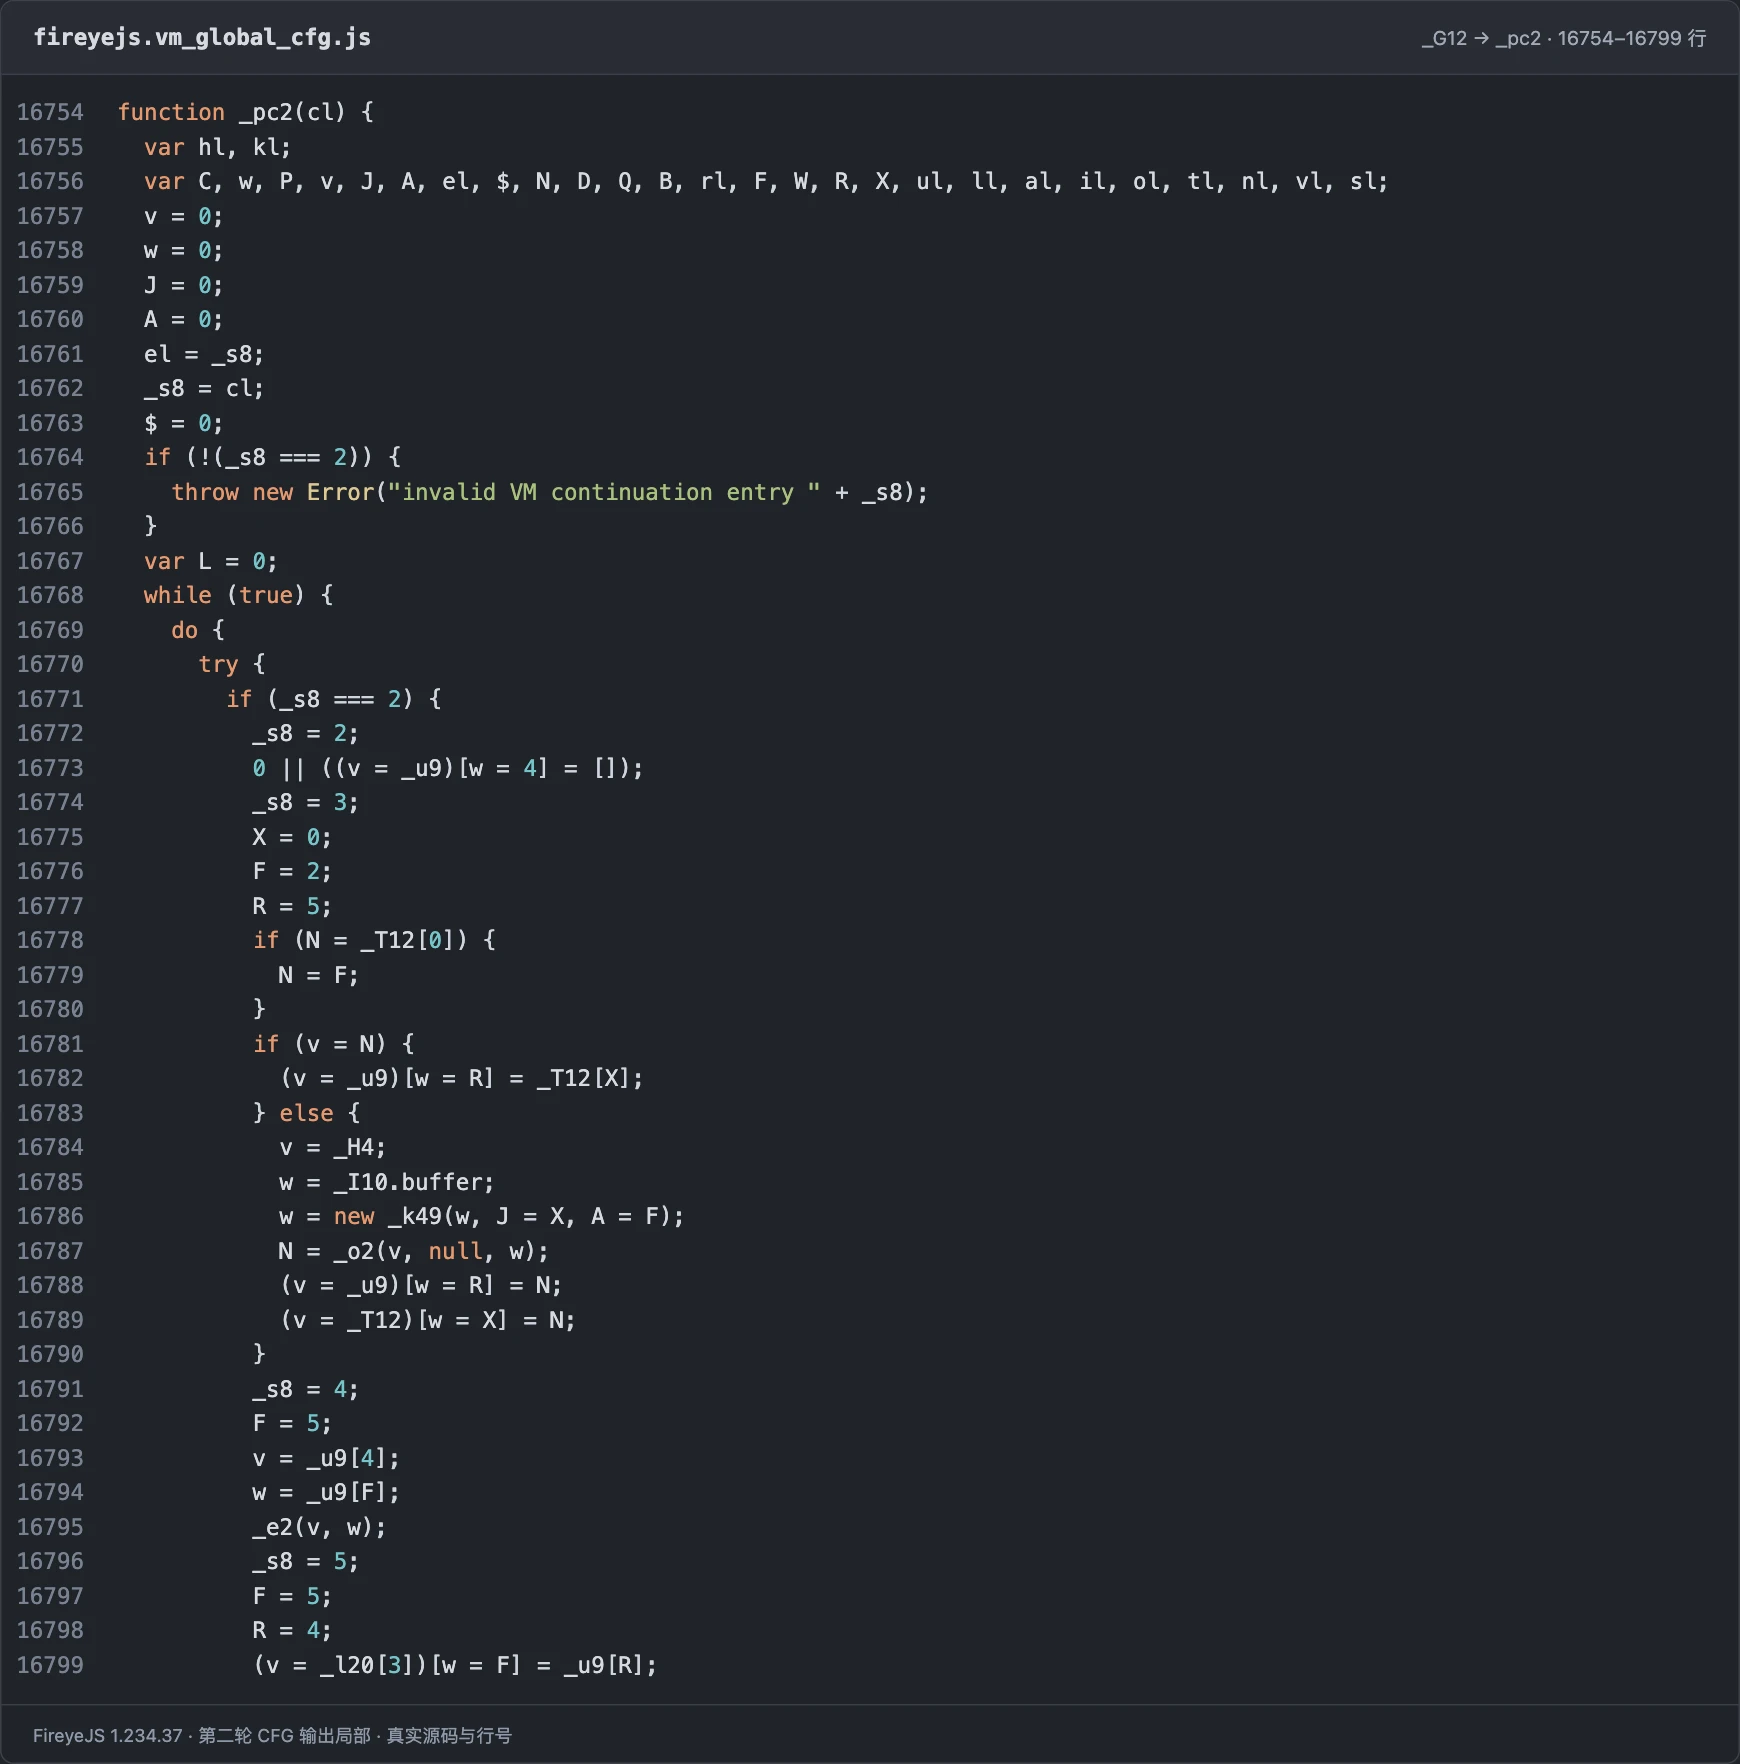
下面是第二轮控制流恢复后的实际代码:
3.5 后处理
经过第二轮 CFG,代码的执行顺序已经恢复。接下来还原能够确定的字符串,减少临时变量的中转,并整理变量名称,让代码更容易读。
3.5.1 还原字符串
字符串可能藏在数组中,也可能经过函数调用才得到。这里的思路是:先找出字符串处理函数使用的表,再追踪调用参数,按对应的处理逻辑算出结果,最后替换成字符串。
处理前:
a[3] = _l20[3][154];
a[4] = _l20[3][a[3][0]];
a[0][4] = _i2(_l20[8], null, 10, a[4]);
处理后:
a[3] = _l20[3][154];
a[4] = _l20[3][a[3][0]];
a[0][4] = "ru";
3.5.2 缩短值传递
一个值有时经过临时变量才被使用。确认变量只是中转,而且改写不会改变求值顺序和次数,就把来源直接放到使用位置。
处理前:
T = S;
a[0] = !!T;
处理后:
a[0] = !!S;
3.5.3 重命名变量
一些随机变量名其实是内建函数的别名。确认它引用的对象且没有被重新赋值后,换成能看出用途的名字。
处理前:
var _Bi = void 0,
  _n9 = parseInt,
  _z18 = Uint8Array,
  // 省略同一声明中的其余项。
  _m34 = null;
处理后:
var _Bi = void 0,
  parseIntFn = parseInt,
  Uint8ArrayCtor = Uint8Array,
  // 省略同一声明中的其余项。
  _m34 = null;
四、替换还原后的样本
代码还原完了,再把它放回页面。这里用无头浏览器打开,将页面请求的 fireyejs.js 替换,然后手动操作登录页面。在开发者工具的 Sources 面板中,可以看到页面加载的是还原后的代码。
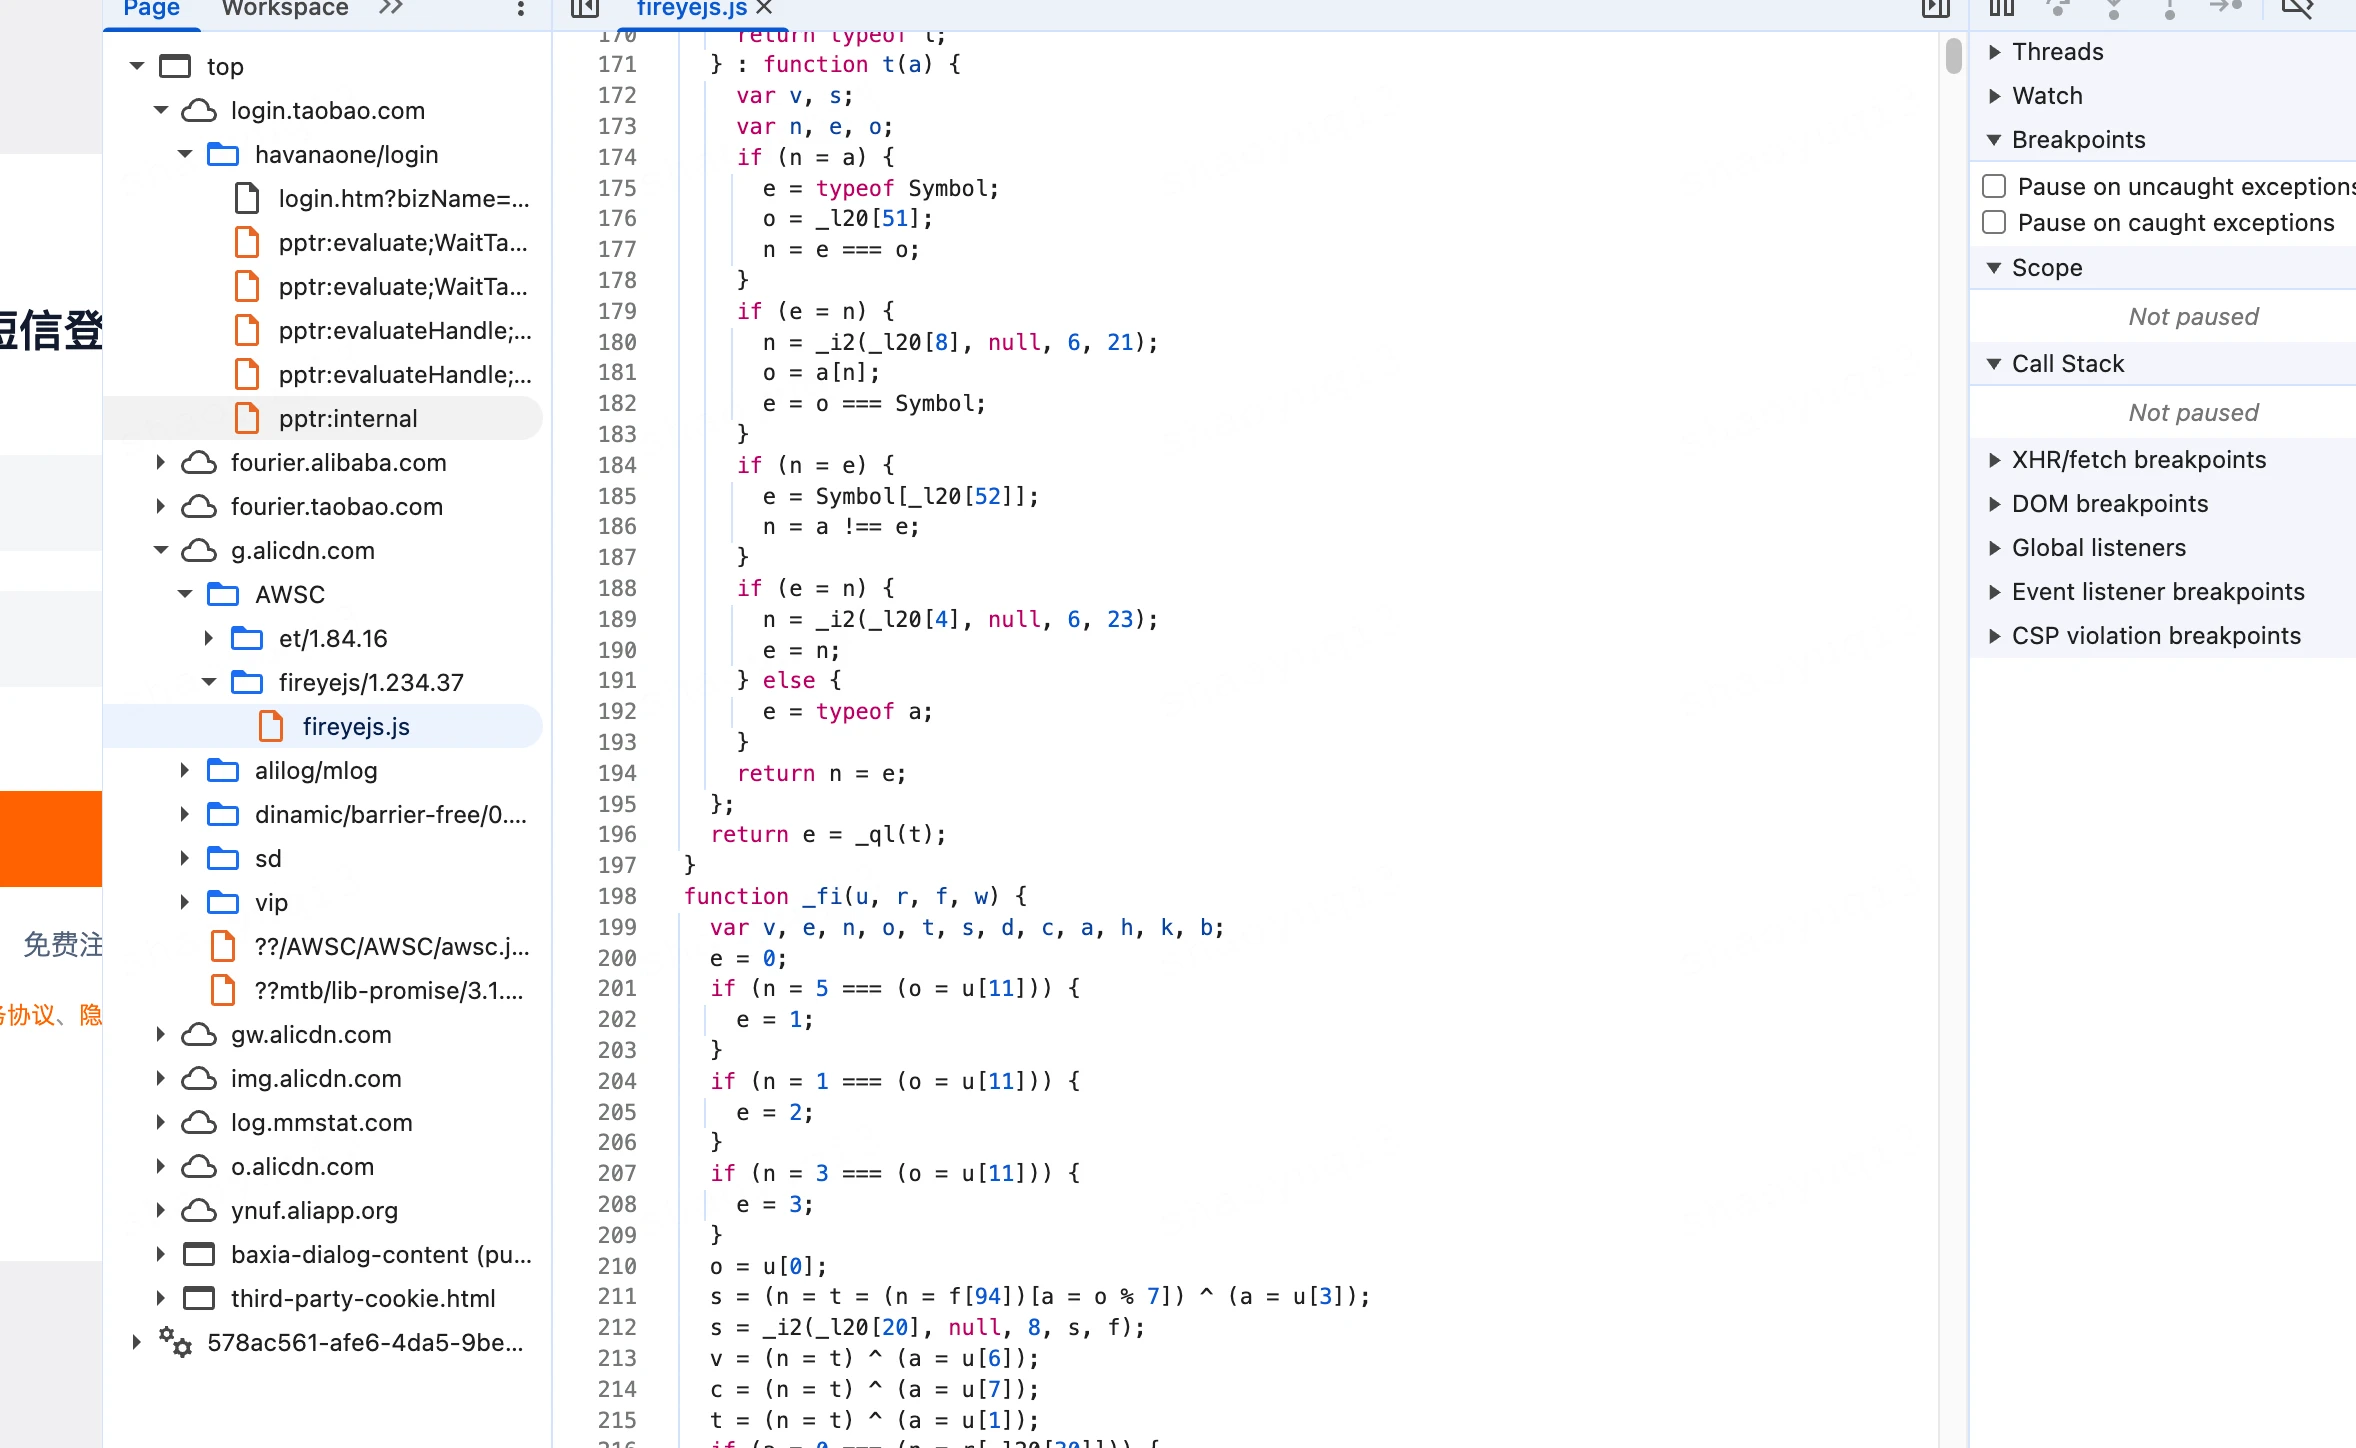
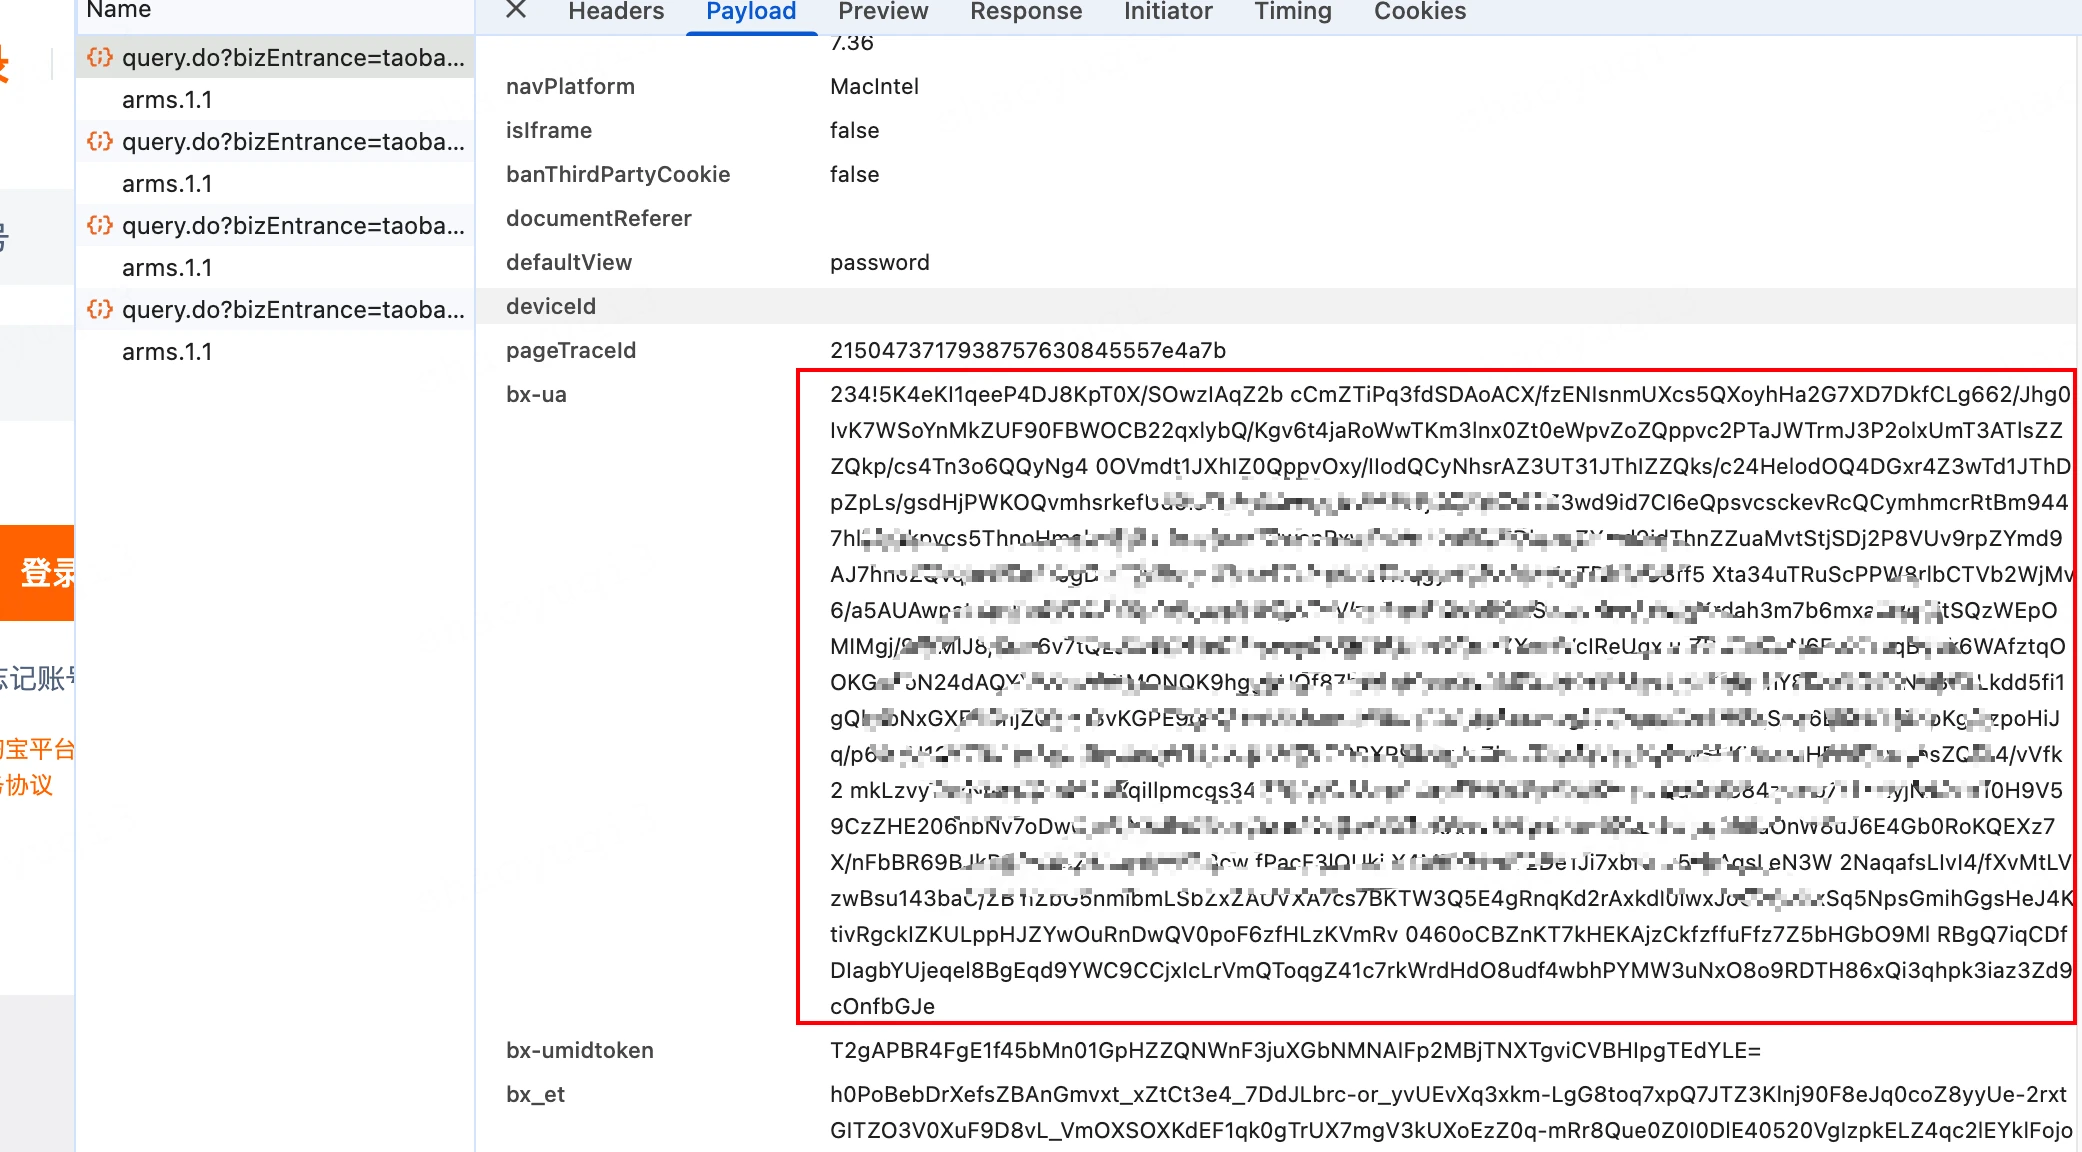
请求体中带有 bx-ua。并且替换后的脚本不只是能够加载,页面操作仍然能够触发请求,并携带 SDK 生成的数据。
五、总结
这次还原的难点在于,执行顺序被控制流分派打散,部分状态跳转又隐藏在 VM 指令中。因此,代码还原的关键不是遇到一种混淆就写一条替换规则,而是先弄清楚每段代码做了什么,再借助 AST 把这些执行关系整理清楚。反过来看,样本中一些固定的规律也为批量还原提供了便利:识别出的 VM 都采用四个数组元素组成一条指令,很多 case 的下一状态赋值集中在 break 之前,部分虚假分支的条件在当前 case 内就能确定。因此,从加固来讲:可以增加不同 VM 指令格式的差异,可以在保持执行语义的前提下,把状态写入打散在代码段的不同位置,并让虚假分支的条件需要结合前序状态,不只依赖局部常量。
参考:
冰与火的战歌:Windows内核攻防实战高级班!从零到实战,融合AI与Windows内核攻防全技术栈,打造具备自动化能力的内核开发高手。
赞赏

|




