-
-
[分享]告别 反射式 PE 加载!C++ 直编译纯机器码(Shellcode)
-
发表于: 1小时前 86
-


告别 反射式 PE 加载!C++ 直编译纯机器码(Shellcode)
一、背景:现代 EDR 内存对抗下的瓶颈
在目前的红蓝对抗中,后渗透载荷(Implant)的内存投递方式主要依赖两大流派:
- 反射式 DLL 注入(Reflective DLL Injection / sRDI) 或 Donut 封装:将完整的 PE 文件(EXE/DLL)打包在一段 Shellcode 尾部,并在头部塞入一个微型的内存 PE 加载器(Reflective Loader),在目标进程私有内存中模拟操作系统的加载流程(修复节区、IAT、重定位表等)。
- 纯裸汇编 / 限制型 C Shellcode:不使用 PE 封装,直接生成位置无关机器码。
在面对现代 EDR(如 CrowdStrike、Defender for Endpoint、SentinelOne)以及内存取证工具(如 pe-sieve、Moneta)时,上述两种方案各有硬伤:
- 反射式 PE 加载的结构暴露:即使加了混淆,反射加载器最终依然要在私有内存(Unbacked Memory)中还原完整的 PE 结构。
IMAGE_DOS_HEADER(MZ幻数)、IMAGE_NT_HEADERS(PE\0\0)、节区头表(.text、.rdata)、以及明文导入导出表在内存扫描面前是不折不扣的静态特征指纹。此外,加载器自身调用VirtualProtect、VirtualAlloc的堆栈回溯(Call Stack)极易触发 ETW-TI 监控。 - 传统 Shellcode 的开发成本过高:如果抛弃 PE,传统的纯机器码开发将变得极为苛刻——由于脱离了 OS 加载器支持,开发者无法直接使用全局变量(重定位失效)、无法使用字符串字面量(被放入只读数据节导致越界访问)、无法正常使用 C++ 的类多态与虚函数表(vtable 指针未重定位)、更无法使用 C++ 异常处理机制(x64 SEH 需要
.pdata函数表支撑)。这导致编写复杂后渗透工具时,代码极度脆弱且难以维护。
MemLLVM 的设计目标:从编译器底层解决这一矛盾。它不是在编译后去加壳或做格式转换,而是在 LLVM 编译管线中介入,直接将标准、现代的 C/C++20 源代码编译为彻底去除 PE 头、无导入表、无需外部反射加载器、塞入内存任意偏移 0 即可原生运行的位置无关扁平机器码(Flat Machine Code)。
二、整体编译架构与执行模型
MemLLVM 由两部分组成:
- 编译器 Pass 插件(
MemLLVM.dll):挂载在 Clang-cl 编译管线中,针对 LLVM IR 层面重构符号引用与调用逻辑。 - 独立微型运行时(
ltl,Lightweight Tiny Library):接管 CRT 底层,彻底摆脱外部 MSVCRT / UCRT 静态库的不可控重定位与 TLS 依赖。
[ C/C++20 源码 ]
       │
       ▼ (clang-cl 前端)
[ LLVM IR (Intermediate Representation) ]
       │
       ├─► 1. StlStubPass: 消除隐式 TLS 依赖与 Meyers 单例检查
       ├─► 2. GlobalSectionPass: 节区合并与属性控制
       ├─► 3. GlobalPointerPass: 扫描全局变量/虚表,生成运行时自愈槽
       ├─► 4. AutoLoadLibraryPass: 预测依赖 DLL 并注入入口预加载
       └─► 5. ApiResolvePass: 抹除导入表,改写为 PEB 遍历 + ROR13 哈希调用
       │
       ▼ (lld-link 链接器)
[ 紧凑对齐的临时 PE 镜像 (/align:512, /driver) ]
       │
       ▼ (extract_flat_bin.py 提取与重构)
[ 纯扁平二进制机器码 (.bin) ]
  ┌────────────────────────────────────────────────────────┐
  │ 引导桩 (自寻址 RIP, 注册 .pdata, 执行全局基址修正)     │
  │ .text 节 (原生代码段,外部 API 均内联为动态寻址)        │
  │ .data 节 (全局与静态数据)                              │
  │ .pdata 节 (x64 异常栈回溯函数表,可选)                 │
  │ Reloc Table (增量 DIR64 修正表)                         │
  └────────────────────────────────────────────────────────┘
生成的 .bin 镜像在磁盘与内存中没有任何 DOS 头(MZ)、没有 PE 签名(PE\0\0)、没有节区表头。将其读取到任意具有执行权限的内存地址后,跳转到偏移 0 即可直接执行。
三、关键核心技术的底层实现
1. 编译期符号抹平与动态自举解析(ApiResolvePass)
在常规 PE 结构中,外部函数调用被编译为间接调用:
call qword ptr [__imp_CreateFileW]
__imp_CreateFileW 依赖加载器在 IAT 中填入绝对地址。
MemLLVM 的 ApiResolvePass 在 LLVM IR 层面遍历模块内的全部函数声明(F.isDeclaration())及 __imp_* 全局槽位:
- 识别外部 API:过滤内置 Intrinsic 与模块内部符号,提取真正的 Win32 API 符号名。
- 内嵌自举解析器:将预编译为 LLVM Bitcode 的核心解析器(
Resolver.c)直接链接合并到当前模块中,并赋予linkonce_odr与 Comdat 属性,保证多编译单元合并时全局唯一。 - 改写调用点:
- 在编译期对 API 符号名计算 32 位 ROR13 哈希值;
- 将原始的直接调用指令(
CallInst/InvokeInst)改写为调用内置解析函数:void *pfn = MemLLVM_GetApiAddress(0x1F768765); // ROR13(CreateFileW) ((CreateFileW_t)pfn)(...); - 即使在代码中使用
&CreateFileW取函数指针,IR 也会被改写为在赋值点动态求值。
- 运行时解析机制(
Resolver.c):- 通过
gs:[0x60]获取当前进程的 PEB,遍历PEB->Ldr->InLoadOrderModuleList模块链表; - 对链表中的
BaseDllName进行大小写不敏感的宽字符 ROR13 计算,匹配目标 DLL 基址; - 解析该 DLL 的导出表(
IMAGE_EXPORT_DIRECTORY),遍历AddressOfNames,找到匹配 API 哈希的 RVA 并转换为虚拟地址返回。
- 通过
此时,最终产物中没有任何导入表,没有任何明文 API 字符串,彻底免疫针对 IAT 的静态特征匹配与导入表 Hooking。
2. Windows 隐藏序数导出(Ordinal-Only)与多级转导链的突破
在 Windows 系统库中,存在大量不包含名称字符串、仅通过序号导出的隐蔽 API([NONAME])。以 shell32.dll 为例,包含 364 个无名导出;shlwapi.dll 包含 551 个(包括后渗透常用的 SHAlloc、SHFree、ConnectToConnectionPoint)。传统基于 AddressOfNames 的哈希扫描器对这些函数完全失效。
MemLLVM 在最新版本中彻底解决了此问题:
- 静态序数索引数据库(
SdkOrdinalIndexData.h):
离线全量解析 Windows 10/11 SDK 下所有 80 个系统.lib导入库,提取出 2,729 个无名序数导出符号,按符号 ROR13 哈希排布为常量二分查找表,支持编译期 O(logN) 检索。 - O(1) 导出表直读寻址:
在Resolver.c中实现MemLLVM_GetApiAddressByOrdinal(dll_hash, ordinal):
直接通过序号索引DWORD base = exp->Base; DWORD num_funcs = exp->NumberOfFunctions; if (ordinal < base || ordinal >= base + num_funcs) return NULL; DWORD func_rva = funcs[ordinal - base];AddressOfFunctions,耗时仅需一次内存寻址。 - 递归转导链(Export Forwarder)解析:
许多序数导出实际是转导符号(例如指向SHUNIMPL.#429或NTDLL.RtlAllocateHeap)。解析器通过判断 RVA 是否落在 Export Directory 范围内,自动递归解析目标 DLL,同时支持名称转导与#ordinal序数转导,并设置递归深度阈值防止成环死锁。 - 编译器透明接入:
当源码中调用SHAlloc时,ApiResolvePass自动识别其为序数导出,并自动转换为序数解析调用;AutoLoadLibraryPass同时感知该符号归属于shell32.dll,在入口处自动注入LoadLibraryA("shell32.dll"),实现完全无感的透明编译。
3. 全局变量与 C++ 虚函数表(vtable)的动态自基准重构(GlobalPointerPass)
在 x64 架构下,虽然编译器可以生成 RIP-relative 的位置无关代码,但全局指针数组与 C++ 类的虚表(vtable)在底层是静态数据。
例如以下虚函数表结构:
// 编译器生成的原始数据:包含硬编码的 64 位绝对地址
const void* vtable_Dog[] = { &Dog::Speak, &Dog::~Dog };
当代码未加载到链接时的默认基址(0x140000000)时,这些指针全部变成悬空指针,一调用立刻发生访问违规(0xC0000005)。
MemLLVM 的解决方案是 IR 级别的指针剥离与启动期重构:
[ 编译期: GlobalPointerPass ]
1. 扫描全局变量 Initializer 中的指针叶节点
2. 记录每个指针槽相对于全局变量基地址的树形路径 (Path)
3. 将静态 Initializer 中的绝对指针强制抹平为 NULL (防止常量折叠)
4. 将该全局变量标记为可写 (setConstant(false))

[ 运行时: 载荷 EntryPoint ]
1. 引导桩根据 call/pop 获取当前载荷在内存中的实际基地址 RuntimeBase
2. 遍历重构槽:通过 GEP (GetElementPtr) 定位全局变量中的槽位
3. 计算:*SlotPtr = RuntimeBase + TargetRVA
4. 若指向外部 Win32 API (如函数指针表),则调用 MemLLVM_GetApiAddress 填入真实地址
通过这一机制,C++ 的类继承、多态虚表、回调函数指针数组(如 SQLite 内部的 aSyscall 表)均可在纯内存任意地址下稳定运行。
4. 裸机器码环境下的 x64 SEH 异常展开与 .pdata 动态注册
许多红队工具在植入宿主进程后,一旦发生未捕获的 C++ 异常就会导致目标服务或进程崩溃,直接暴露红队行为。
在 Windows x64 下,异常处理(try / catch / throw)完全由内核驱动的表式展开(Table-driven Unwinding)管理:
- 当抛出异常时,内核从当前栈顶开始回溯;
- 内核在模块所属的
.pdata节中查找RUNTIME_FUNCTION(记录了函数的起止偏移及UnwindInfoAddress); - 若当前 RIP 所在内存未登记任何
.pdata记录,内核判定栈帧损坏,立即终止进程。
MemLLVM 突破了裸二进制无法处理异常的限制:
- 在自研运行时
ltl中实现核心 C++ 异常 ABI 函数:_CxxThrowException、__CxxFrameHandler3; - 打包脚本
extract_flat_bin.py保留并重定位 PE 的.pdata节,拼接在扁平载荷后部; - 二进制引导桩头部包含一个微型结构体描述符:
struct MEMLLVME { uint64_t magic; // 'MEMLLVME' uint32_t pdata_rva; // .pdata 相对起始偏移 uint32_t pdata_count; // RUNTIME_FUNCTION 条目数 }; - 载荷执行时,自举代码首先调用:
向 Windows 内核动态登记当前内存块的函数异常展开信息;RtlAddFunctionTable(pdata_addr, pdata_count, current_base); - 当载荷生命周期结束返回前,调用
RtlDeleteFunctionTable清理注册表,不留下任何动态注册痕迹。
这使得复杂 C++ 武器化载荷即使在无文件、无 PE 头的内存状态下,依然能够完整支持 try、catch、异常多级捕获与 RAII 局部对象析构展开。
5. 消除隐式 TLS 依赖(StlStubPass)
现代 C++(C++11 及以后)要求局部静态变量具备线程安全初始化(Meyers' Singleton):
void Function() {
    static MyClass instance; // 隐式依赖 TLS
}
MSVC 和标准 Clang 会在背后插入对 _Init_thread_epoch 的调用,并通过 gs:[0x58] 读取模块的 TLS 索引。由于裸机器码根本没有通过 OS PE 加载器分配 TLS 槽位,这会导致必现的空指针崩溃。
MemLLVM 的 StlStubPass 扫描整个 IR,识别编译器生成的初始化守卫变量($TSS0),将其拦截改写为基于常规内存的无锁原子 CAS(Compare-And-Swap)原语,彻底斩断对系统 TLS 槽位的依赖,同时保留多线程环境下的初始化安全。
四、实战验证:复杂工业级工程编译为裸机器码
编译器设计最忌讳“演示玩具”——即只能跑通 calc.exe 弹框,遇到复杂工程就原形毕露。
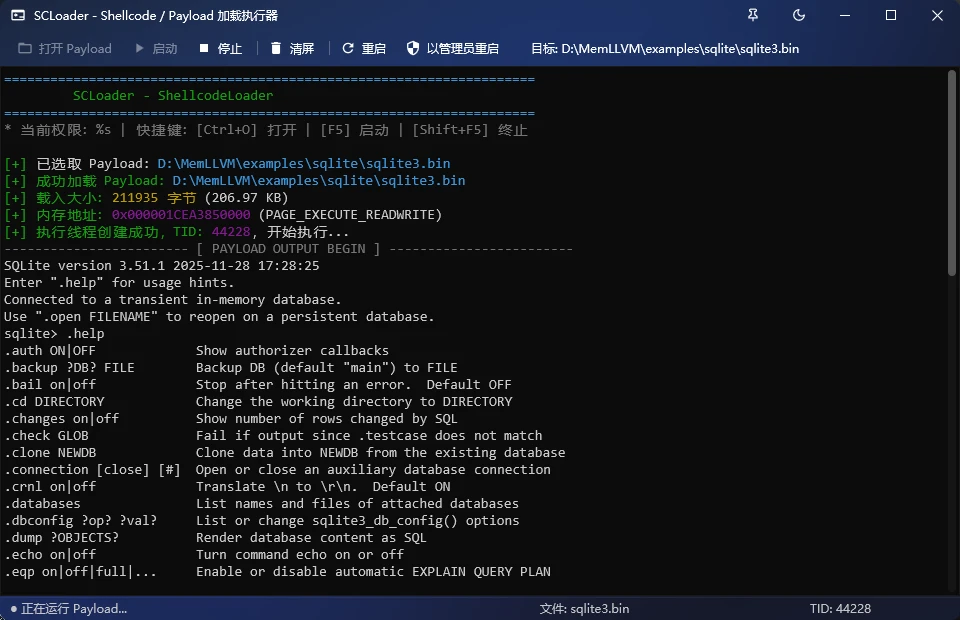
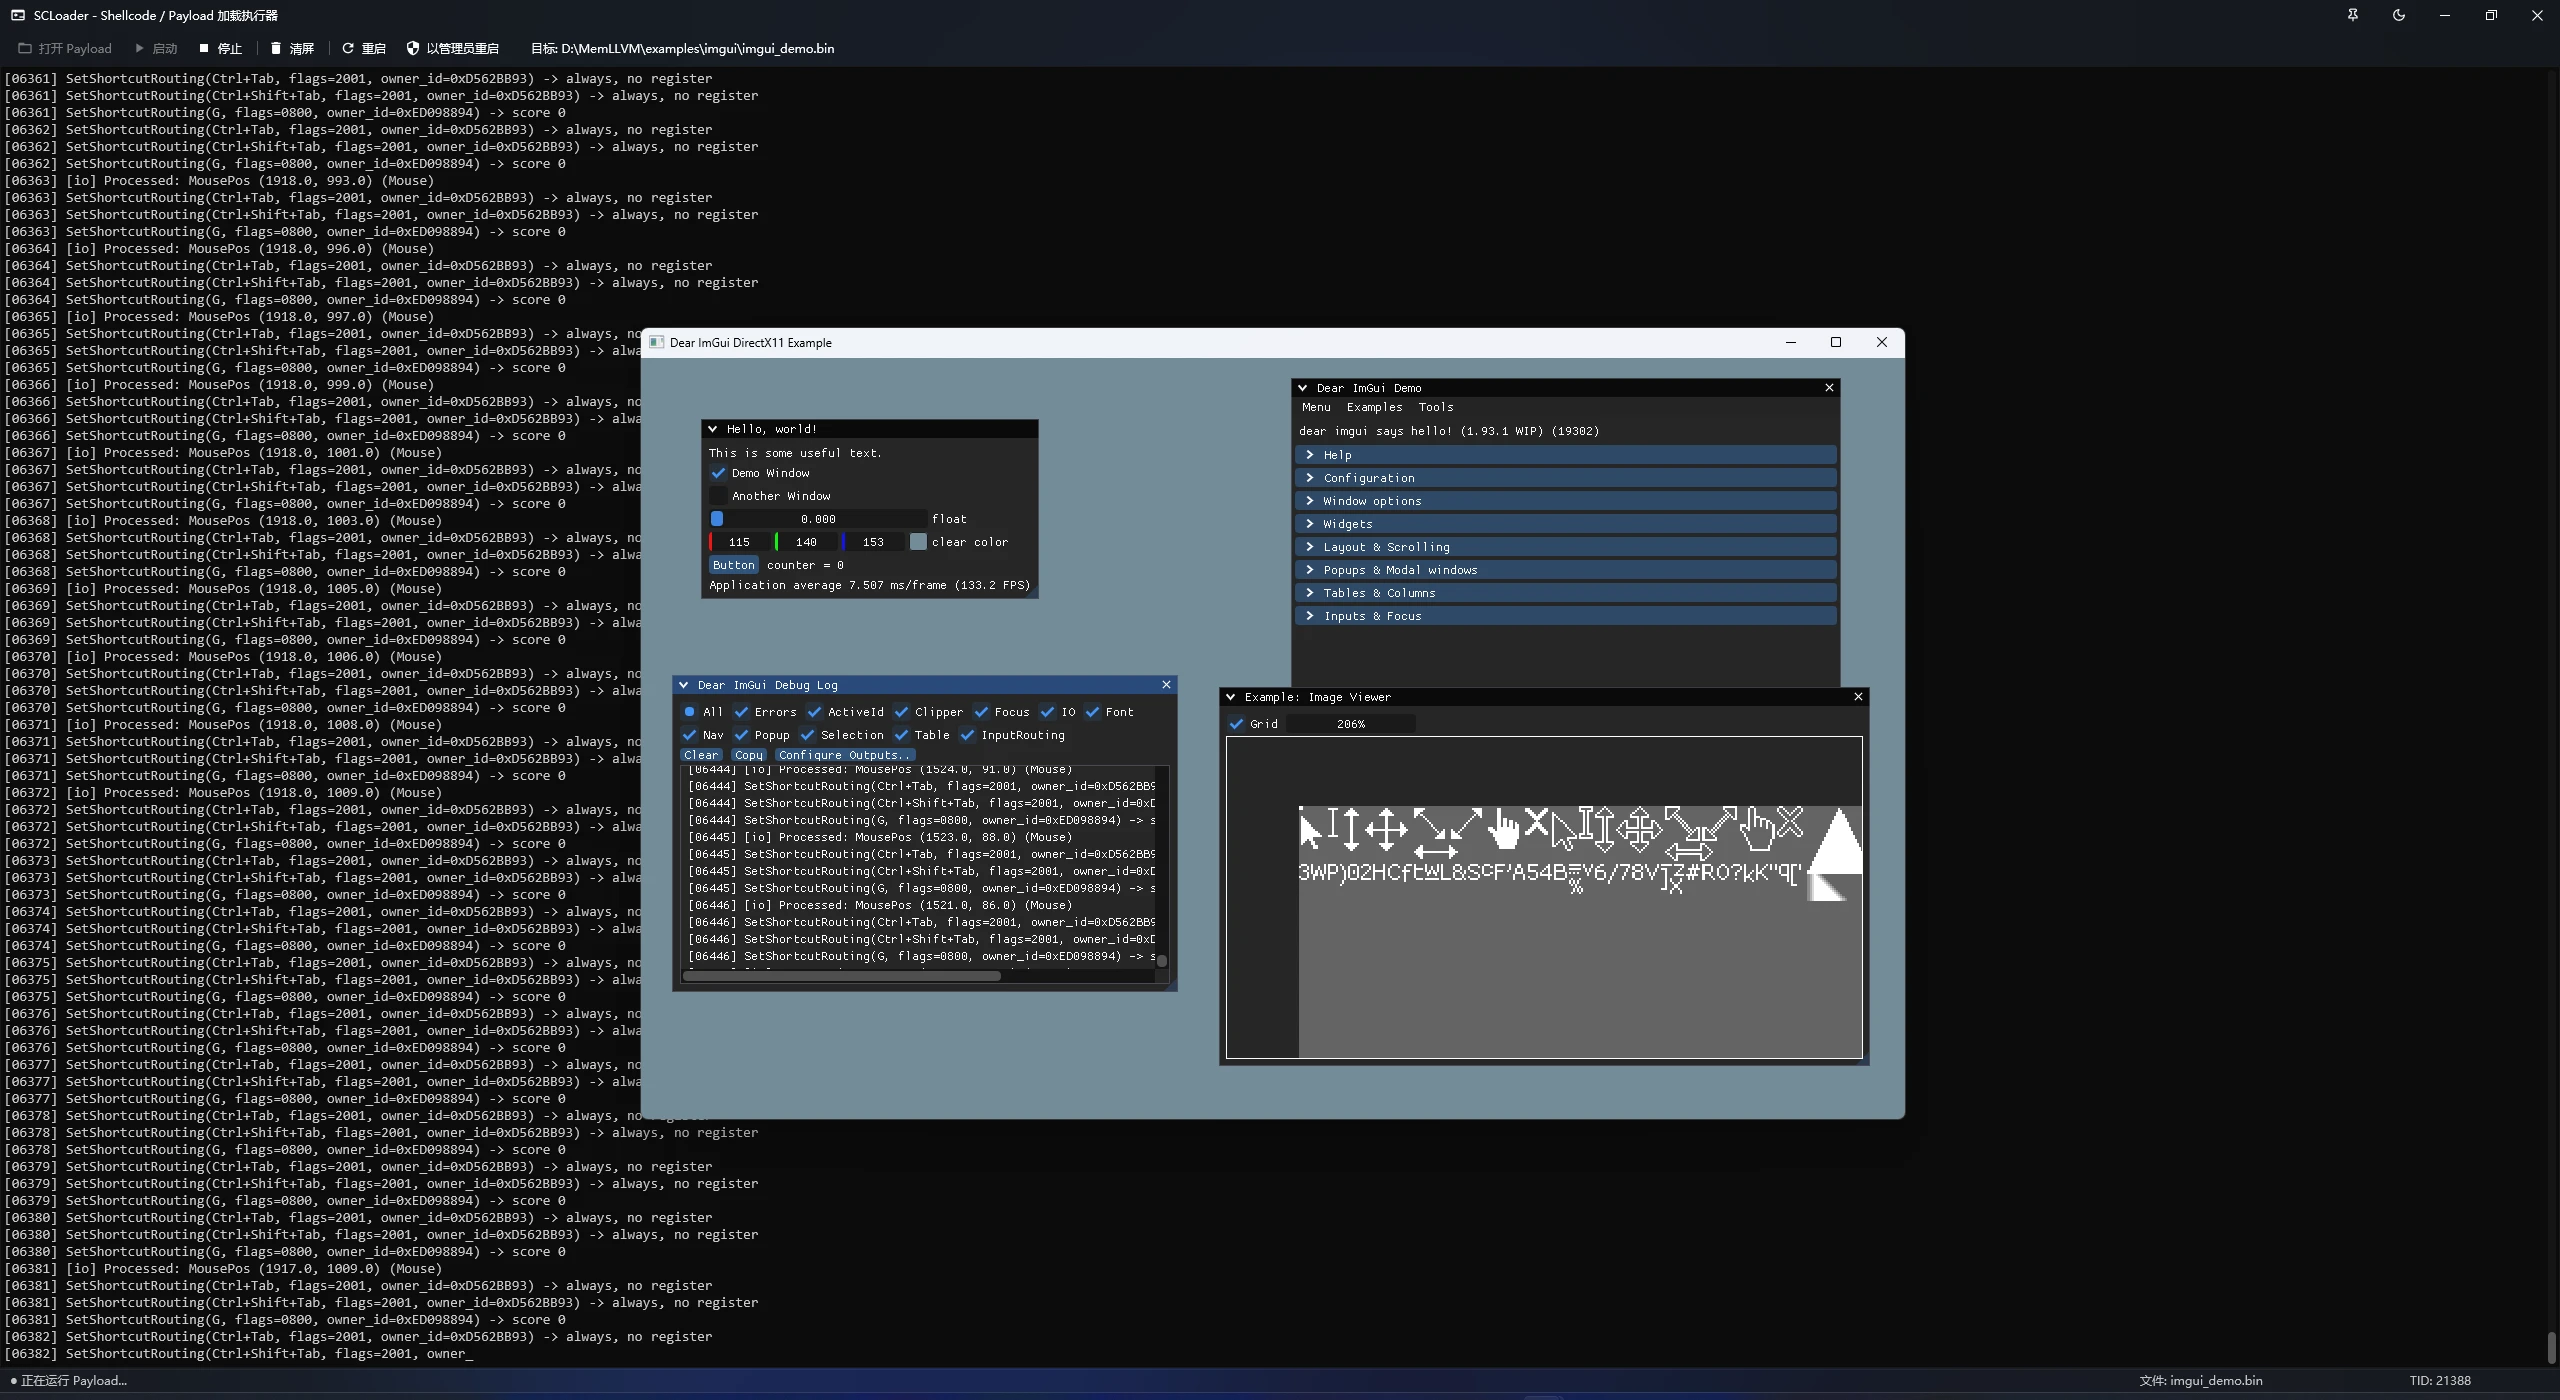
在 MemLLVM 仓库的 examples/ 目录下,对多个高复杂度的真实项目进行了从源码直接编译到单文件 .bin 裸机器码的验证: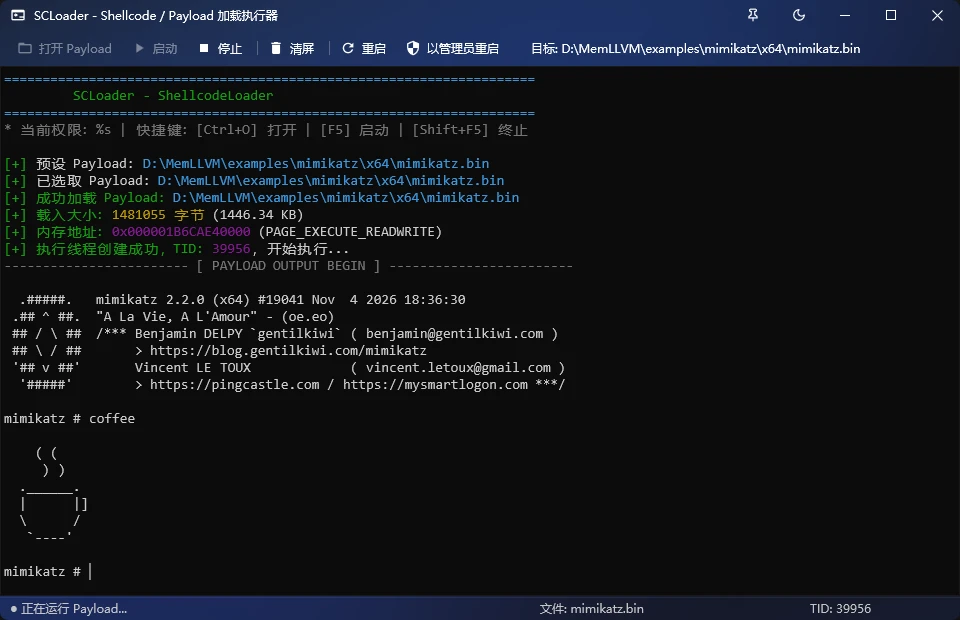
| 验证项目 | 涉及技术体系 | 工程规模 | 验证的核心能力 |
|---|---|---|---|
| Mimikatz | C 语言底层后渗透神器 | 114 个源文件,大规模全局符号 | 验证跨模块未决定义、LSA 敏感 API 动态哈希化、ASN1 驱动解析 |
| SQLite3 CLI | 复杂 C 语言命令行终端 | 单文件超 20 万行,自建虚拟文件系统 | 验证深度虚表/全局系统调用表重构(aSyscall)、完整 SQL 解析引擎运行 |
| Dear ImGui | 现代 C++ 工业级 GUI 框架 | 硬件加速渲染管线 | 验证多态 C++ 类、DirectX 11 驱动调用、复杂内存对齐 |
| Box2D 3.0 | 物理引擎 | 45 个现代 C++ 源码 | 验证密集浮点计算、GDI 绘制、局部静态变量原子化 |
| DOOM | 经典 3D 游戏引擎 | 83 个源码文件 | 验证纯 CPU 软件光栅化渲染、实时音频流管道 |
内存取证对比测试
以生成的 mimikatz.bin 为例,将其读取至目标进程执行,并使用取证工具 pe-sieve 进行内存扫描对比:
- 传统反射式注入(sRDI / Donut):
pe-sieve立即命中并转储内存:[+] Found PE header in unbacked memory (R-X) at 0x1a8...
报告高危异常:Replaced PE / Implanted PE。 - MemLLVM 生成的
mimikatz.bin:pe-sieve扫描完毕:[+] Scanned 1240 modules, 0 anomalous memory pages detected.
由于该内存块内不存在任何合法的 DOS/NT Header 结构,传统针对 PE 格式骨架的特征检测完全失效。
五、使用与配置示例
MemLLVM 针对 Visual Studio 进行了工具链对接。开发流程与常规 C++ 毫无二致:
- 项目配置:在 VS 属性页中将“平台工具集”设置为 ClangCL。
- 挂载 Pass 插件:在编译命令行选项中加入:
/clang:-fpass-plugin="path\to\MemLLVM.dll" /clang:-fno-jump-tables /clang:-fno-builtin - 引入极简运行时:链接器启用
/NODEFAULTLIB,引入ltl.lib(MemLLVM 配套的轻量运行时)。 - 后处理输出:生成事件调用
extract_flat_bin.py,直接从链接生成的临时 PE 提取纯机器码.bin。
你可以在源码中任意调用 Win32 API、使用带有虚函数的类、使用 STL 流操作或异常处理,生成的 .bin 均可直接投递执行。
六、总结
MemLLVM 的核心意义在于打破了“高级 C++ 特性”与“位置无关扁平 Shellcode”之间的鸿沟:
- 它不依赖外层加壳封装,而是把防御规避下沉到了编译器 IR 优化的本质环节;
- 彻底消除了内存中遗留的 PE 结构与导入表痕迹,使基于内存 PE 解析的静态检测与启发式扫描失去落脚点;
- 让安全研究人员能够直接采用现代 C++ 软件工程方法论开发复杂的武器化载荷,而无需在汇编层面上妥协工程质量。
完整源码、详细构建指导及测试用例已全部开源在 GitHub。欢迎从事红蓝对抗、免杀研究及底层编译器技术的同行查阅、提交 Issue 与参与共建:
赞赏

|




