【原创及合著说明】 本文由我(对应原博客署名:Inkarro)与团队成员共同完成,首发于第一作者个人博客(5c5K9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6U0N6h3u0C8i4K6u0W2j5$3&6Q4x3V1k6S2M7Y4c8A6j5$3I4W2M7#2)9J5c8X3!0T1L8r3W2@1k6i4u0S2N6r3W2F1k6#2)9J5k6s2A6W2L8r3W2^5i4K6u0V1K9$3I4S2M7%4y4Q4x3X3c8E0j5i4y4@1k6i4t1`.)。原博客文末已添加本帖链接以及我的看雪 ID 作为原作者身份证明。
源码已发布于:afdK9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6Y4K9i4c8Z5N6h3u0Q4x3X3g2U0L8$3#2Q4x3V1k6e0N6s2W2D9k6i4y4r3L8%4g2F1k6r3q4@1K9h3!0F1i4K6u0r3e0%4m8W2L8W2A6w2e0b7`.`.
本文以 Zelix KlassMaster(ZKM)自身为例,从反调试机制开始,逐层拆解 ZKM 的各项混淆,并给出对应的还原思路。拆解 ZKM 的反调试、引用混淆、参数修改与参数类型混淆、常量加密、控制流和异常混淆,并给出一套基于运行时重放的完整反混淆方案,同时分析 ZKM 的一些暗桩和机制的实现细节。
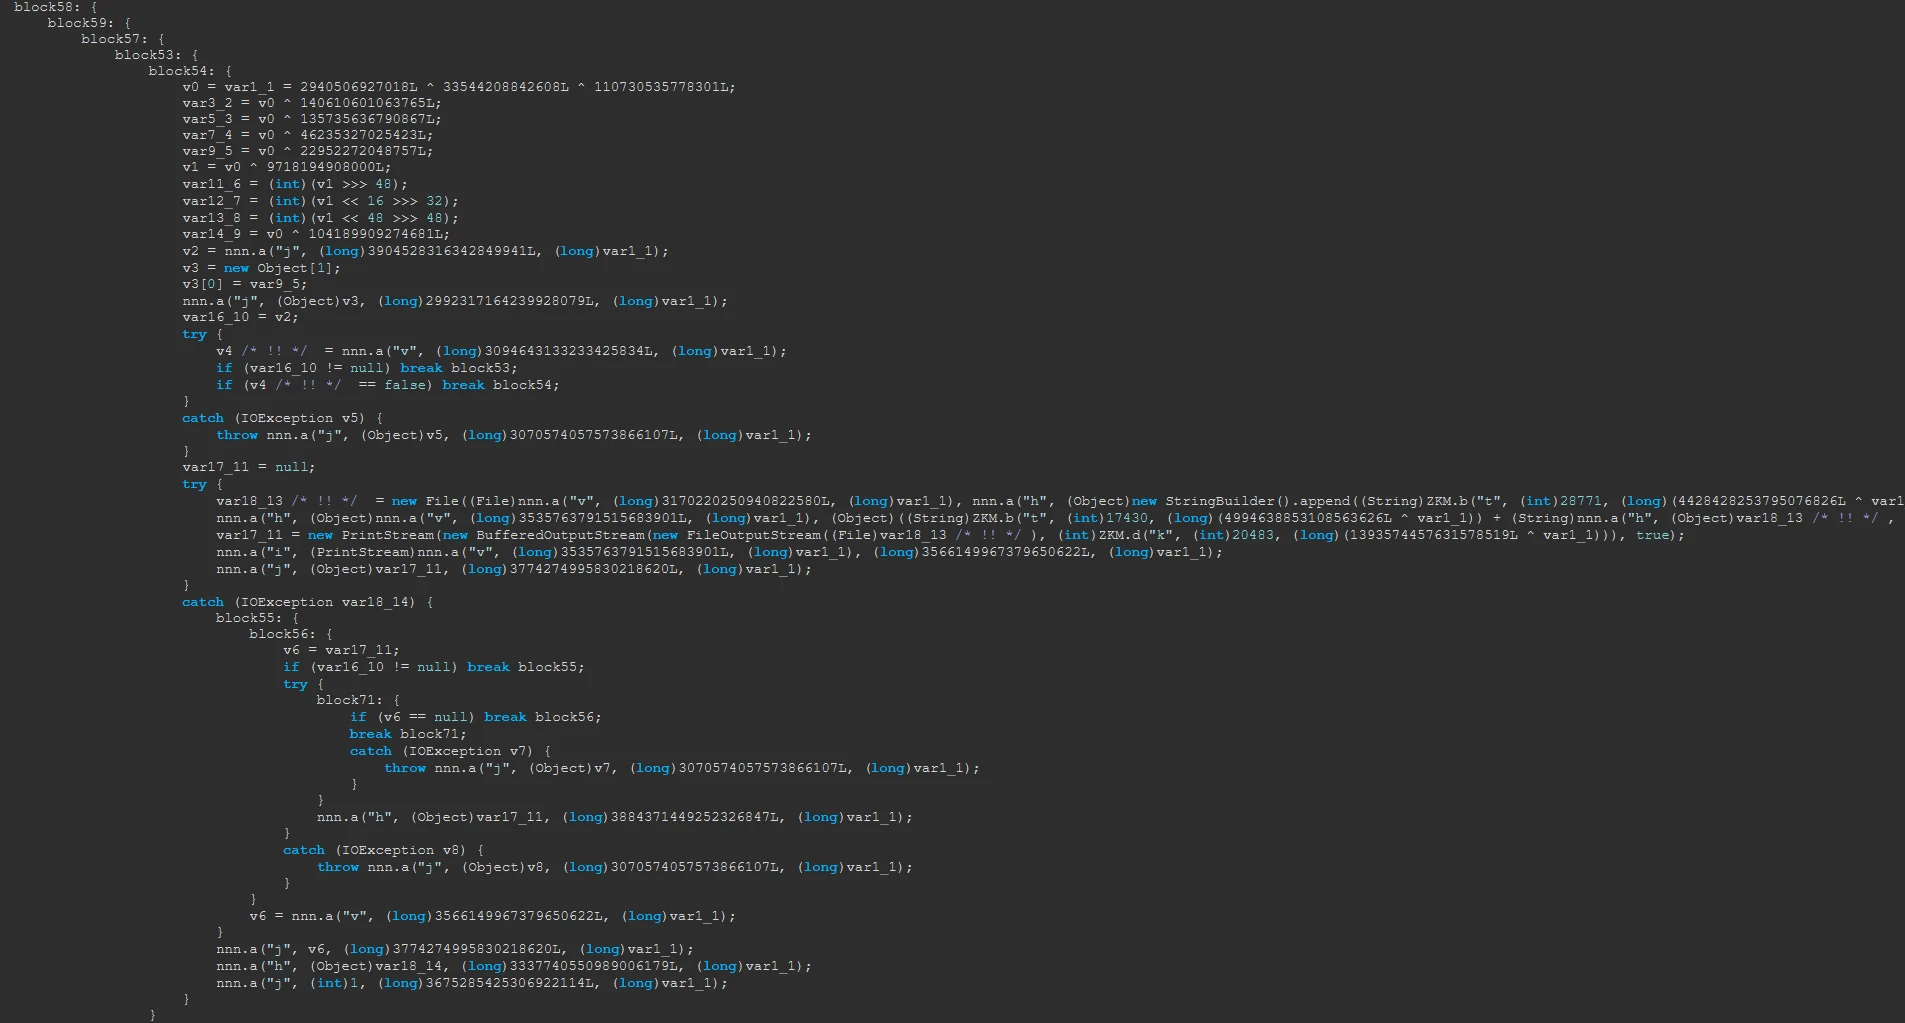
Zelix Klass Master 混淆之后的代码
Zelix KlassMaster ,简称ZKM,是市面上最好的 Java 混淆器,许多公司利用它来保护应用程序,防止被逆向工程和篡改。该工具极其稳定,几乎能够处理任何项目,并可靠地生成可正常运行的混淆后代码。并拥有先进的控制流混淆、字符串加密、整型常量加密、方法参数混淆、引用混淆,同时拥有参数混淆,如果要解密任何方法中的常量,必须完全追踪从程序运行到方法的参数加密链条。
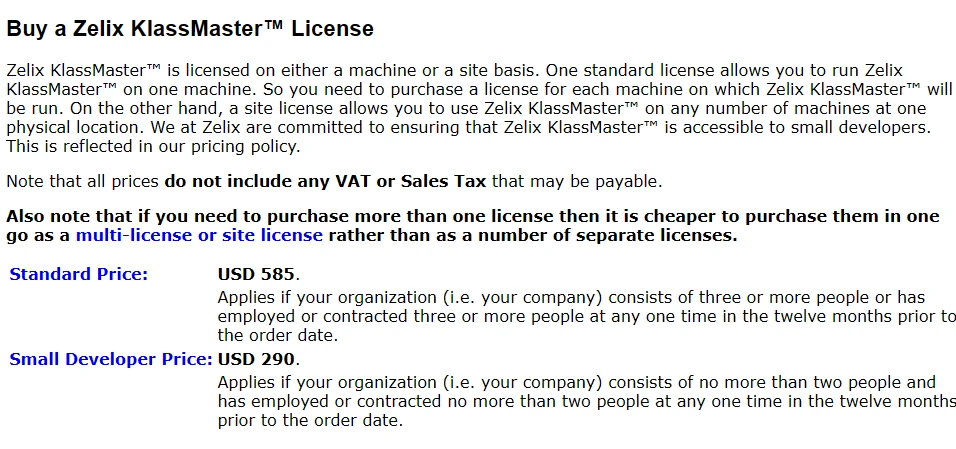
ZKM的价格为290美元对于小团队,585美元对于大团队,当然你也可以下载一个试用版本,试用版本的限制为每个类最多混淆两个方法。当然,笔者出于对 Zelix Pty Ltd 的尊重,还是正价购买了一份正版。
本文所有逆向均基于此正版文件进行,本文所有逆向分析均基于合法购买的正版样本,仅作混淆器架构与字节码保护技术的学术探讨,请勿将相关工具用于非法用途。
下文会频繁出现混淆后的类名,对应关系如下:
ZKM 的各项混淆是互相咬合的,解密流程不是线性的,必须按顺序进行
其中引用混淆和参数修改混淆是互相依赖的:解密 Invoke Dynamic 需要求值方法的额外参数,而追踪额外参数需要先看清调用关系。两者必须迭代推进。
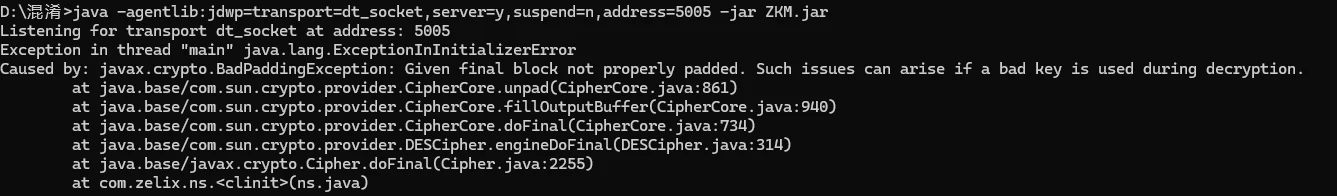
如果使用任何调试参数启动ZKM,会直接弹出一个Given final block not properly padded. Such issues can arise if a bad key is used during decryption异常,你将无法解密任何常量。
因为ZKM的反调试完全基于利用ZKM的解密机制,每个类都会有一个long字段,参与所有混淆运算,我们称其为master key。
在static块中赋值,示例赋值代码:
其中bff为解密器我们称之为MasterKeyFactory,实现grr,grr为解密器Base为一个接口,这个接口的另一个实现为FallbackKeyFactory。
所以这一段可以理解为
然后 KeyFactoryBase 的结构如下
位于 MasterKeyFactory,但是实际上并不在这里分发,只是一个供Class使用的入口
前往 FallbackKeyFactory 检查 a 方法
其中this.b也就是合法的 Root Factory 列表都会在 <init> 块里注册,这些注册出来的 KeyFactory 为 MasterKeyFactory
最终这个MasterKeyFactory返回给程序,即可执行到decrypt
回到 MasterKeyFactory,在获得 KeyFactory 之后会进入一个有 long 作为参数的解密方法
回到派生 KeyFactory 的代码,如果这个 Class 不匹配原始注册的 Root Factory(典型情况是脱离原上下文外部调用)就会派生 FallbackKeyFactory。
FallbackKeyFactory 没有 Child 滚码机制,实际上你可以使用 FallbackKeyFactory 解密出没有 Class Initialization Order 的 Master Key,但是只要使用 FallbackKeyFactory 解密一次就会污染 KeyFactory 注册表,导致无法解密其他的。
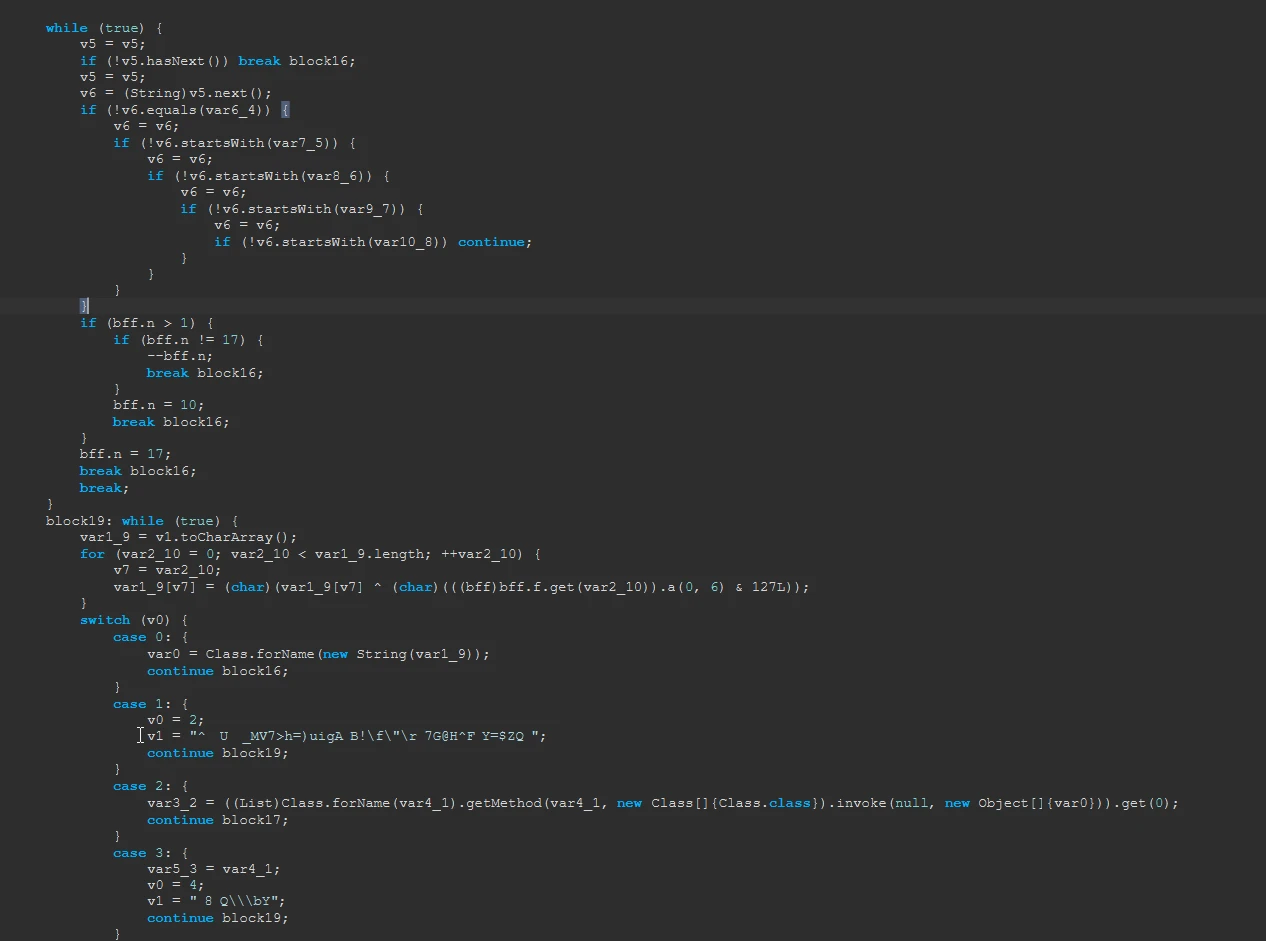
反调试代码实际上位于 MasterKeyFactory 的<init>调用,这段代码有控制流和字符串混淆,简化之后如下:
如果检测到这些调试参数,MasterKeyFactory里的运算常量会被偷偷破坏,导致你将无法正确派生密钥。
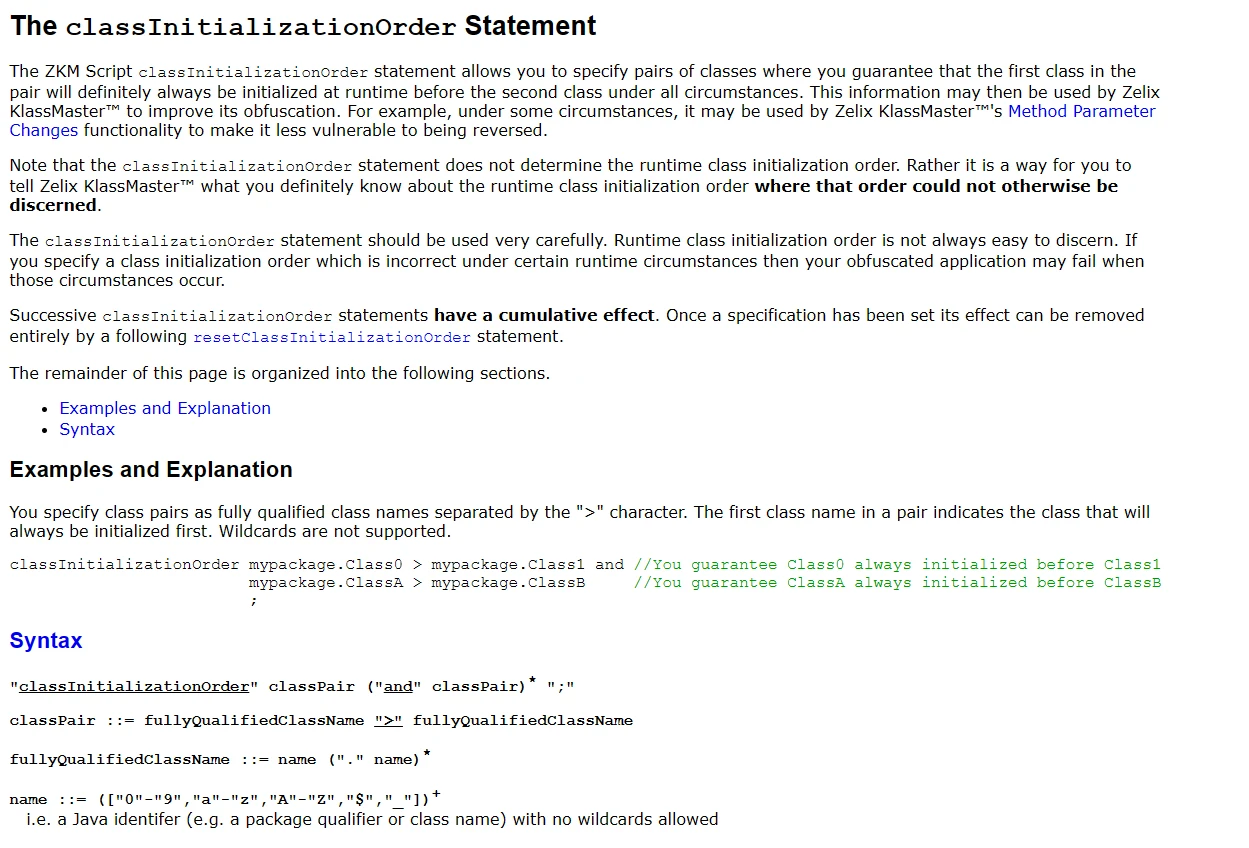
关于 Class Initialization Order 的介绍
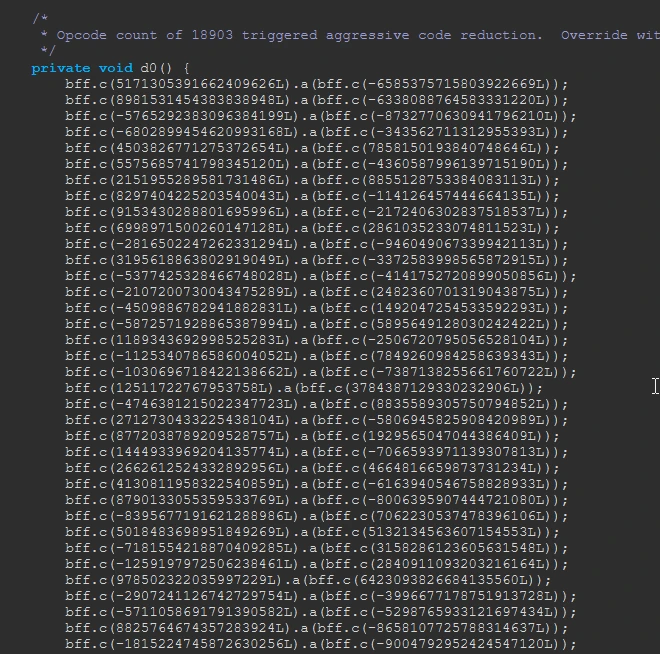
在初始化 KeyFactory 阶段会在大量硬编码生成的初始化代码中设置很多这样的关系,这样一个 KeyFactory 被调用之后所有 Child 也会跟着滚码。
这就是 Class Initialization Order 的原理,你可以通过配置文件指定类A一定比类B早被加载,加载时必须按照这个顺序加载否则就会无法解密 Master Key。同时继承也有这个效果,因为父类一定比子类先初始化,如果你先初始化(调用static)子类,KeyFactory 就会因为没有滚码 Child 导致密钥派生出错。
在正常的 JVM 里这不是问题,因为 ZKM 生成的初始化顺序本来就是对的,继承关系也保证了父类先于子类初始化。但一旦单独反射调用某个类的解密,或者在虚拟机中按任意顺序执行,Child 就可能还没有被滚码,派生出的密钥就是错的。
初始化阶段设置initializtion order
在分析完 ZKM 的 Master Key 计算逻辑之后,我们开始尝试处理这个计算,一次性计算完所有 Class 的 Master Key 防止后续解密出现因初始化顺序不正确而无法解密出正确的逻辑。
在上面的分析中我们提到 Master Key 的计算会依赖许多运行时状态。
如果不处理这些状态直接调用 decrypt 就可能会错误的拿到 FallbackKeyFactory 解密出错误的数据。
所以我们设计了一个利用隔离的虚拟机环境解释解密的运行时,逐步恢复 Factory 对象和注册表状态,再按照对象依赖关系执行解密的方案。
我们使用一个Java字节码解释器(后简称 LittleVM)加载ClassNode并提供完整的运行时环境,由LittleVM独立维护类初始化状态、静态字段和对象实例,一次解密所产生的环境变化可以被观察到。
Replay首先初始化 Fallback 对象所在的类,然后读取其静态单例以及内部注册表
这一步相当于让 ZKM 的解密 Factory 在 LittleVM 中完成启动
我们提到过 Master Key 的计算依赖运行时状态,即使两个解密调用拥有相同的输入密钥,如果它们执行时注册表的状态不同,实际获得的解密对象也可能不同。
所以我们会先尝试从运行时注册表中寻找目标对象,也就是 masterSeed -> create(masterSeed) -> object -> pairs.get(object) -> Factory Object
create(masterSeed) 用来生成查询注册表所需的对象,然后通过 ConcurrentHashMap.get() 找到当前已注册的解密对象,简单来说就是用 Master Seed 模拟创建一个 Factory 然后去查表。
我们将解密调用划分为两类:
假设现在有三个解密点 A、B、C,初始注册表如下:
此时只有 A 点满足执行条件,我们会用 LittleVM 对 A 解密点进行模拟执行,在执行 A 解密点的过程中,ZKM 就可能会对注册表进行修改,从而让我能找到其他解密点的对象。
那么接下来的注册表状态就可能如下:
这样 B 解密点就可以在下一轮进入 Ready 状态,这样我们获取对象的顺序就可以有保证。
注意:这一步并不代表我们就做完了所有的顺序处理,正如我上面所说的,目前为止我们还只是对获取对象的顺序有了保证,而 ZKM 的解密对象是可以单独形成引用链的。
我们需要先读取当前对象中指向下一个解密对象的字段。
有了这个我们就能沿解密对象的引用链向下遍历。
我们不止需要获取对象的引用链,我们还需要判断一个对象是否能够沿引用链访问另一个对象。
假设存在:
那么:
reaches 同时会检测循环引用和长度过长的引用链,防止遍历陷入死循环。
获得引用关系后,我们会计算当前 Ready 集合中,每个 Factory 对象有多少路径可以到达它。
例如:
对应结果为
我们会优先执行 Parent 数量最少的对象,这样就能做到按顺序依次解密所有的 Master Key 了。
在 LittleVM 执行到反调试代码时会触发 调用保护 而中断模拟执行,返回 ExecutionStatus.BLOCKED 并保存运行上下文,在判断到上下文为获取 vmArgs 时向栈内置空列表来绕过反调试检测。
你也可以通过下面的代码来绕过反调试
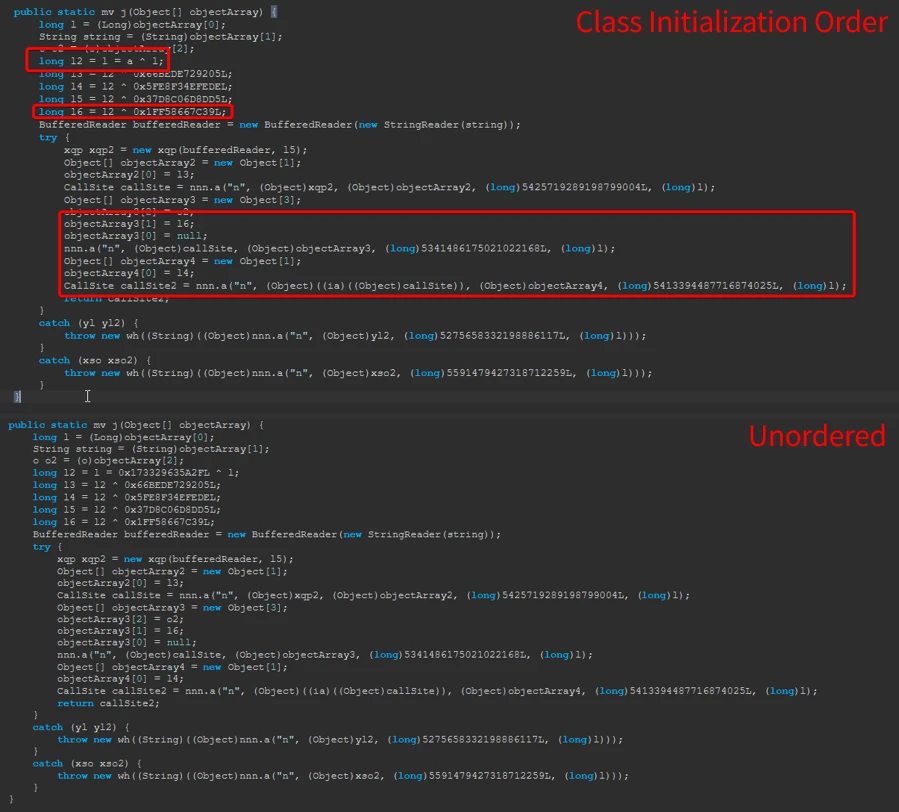
在所有Master Key解密之后,通过字段引用回填到各个方法内,现在所有局部变量均可以通过上下文运算求值,这为后续解密混淆运算打下了基础。
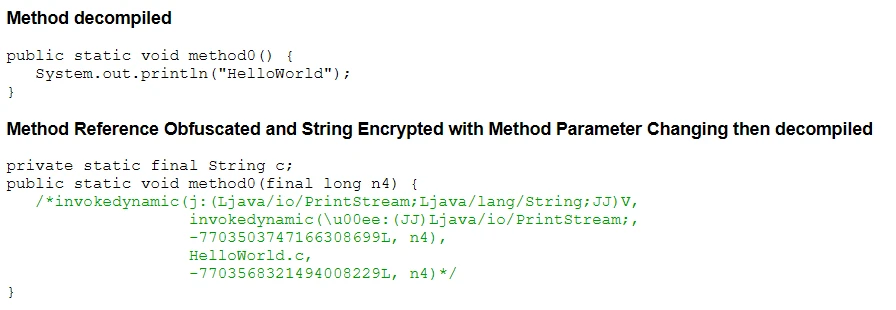
引用混淆(Reference Obfuscation)就是将一般的调用变成一个Invoke Dynamic调用,然后通过ZKM生成的Bootstrap方法导到目标方法和字段,示例Bootstrap方法:
被混淆的调用点在字节码里长这样:
原本的方法多出来两个long输入,用于解密Invoke Dynamic调用,其中这个cfr_ldc_0里指向当前类的Dispatcher方法。
其中也分为两种,一种是在当前类中解密字符串和数字,我们称为ConstantDispatcher,另一种是从一个很大的注册表类里调用方法,我们称为InvokeDispatcher
典型调用:
其中a为 Invoke Dispatcher Bootstrap Method,通过两个long查询一个表来得到目标方法/字段。
其查询的那个Object[]表在初始化时会塞入所有方法/字段的Owner、Name和Descriptor
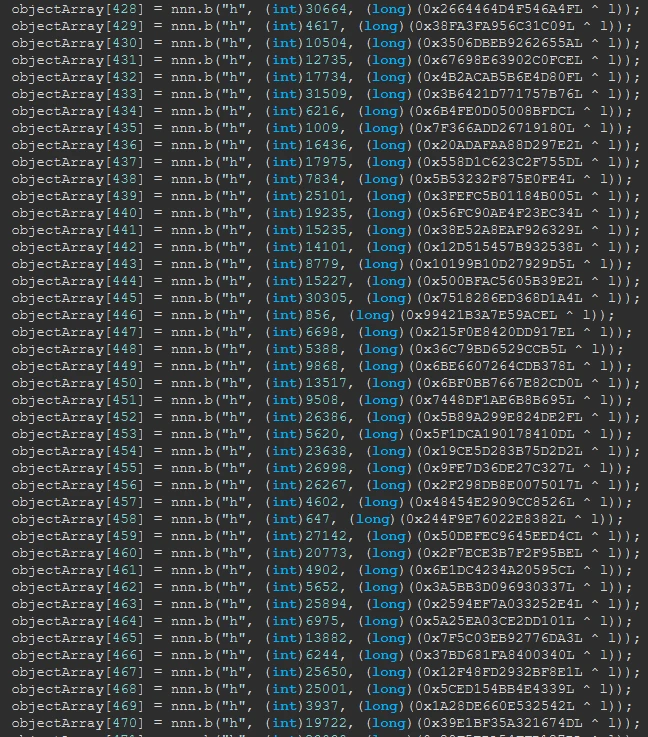
如果你过于闲,你大可还原笔者上述的所有逻辑然后真实的解密所有引用来实现静态解密,但是笔者实际上使用了一个更加轮椅的方案
IMPL_LOOKUP 是 MethodHandles.Lookup 中的一个 private static 字段。
它的 lookupClass 是 Object,权限模式为 TRUSTED 为JDK内部使用的 Lookup 没有任何反射限制。
实际上,目前所有的MasterKey已解密,代表所有局部变量也可以求值,这意味着还原相当简单,只需要模拟执行。
两个long通常一个是直接写出来的,另一个是用Parameter Changes注入的参数异或出来的。
带着那两个long获得MethodHandle,注意 InvokeDispatcher 最后一个指令是 MethodHandles.dropArguments,它为了丢掉末尾两个 long,会把原始句柄包成一个 BoundMethodHandle,原始句柄存放在它的 argL0 字段里,需要先反射取出原始MethodHandle。
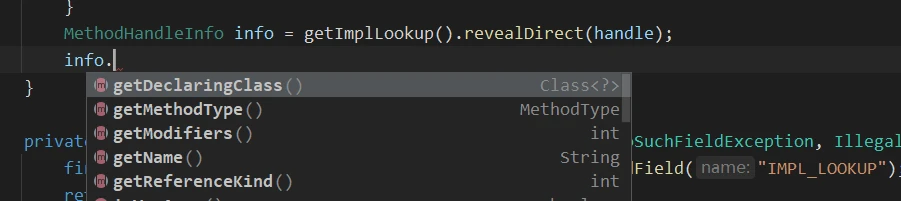
然后使用IMPL_LOOKUP的revealDirect获得MethodHandleInfo,内部提供的信息足以使用ASM重建一个MethodInsnNode出来。
其中getMethodType包含Method Parameters,可以反推Descriptor出来。
重建MethodInsnNode之后进行替换原始的InvokeDynamicInsnNode,即可完全解密所有引用混淆。
ZKM有一个方法参数混淆功能,会将方法参数变成一个Object[],同时所有调用也会改成装配Object Array,再配合类似 overloadaggressively 的混淆配置,会生成大量除了返回类型参数和名字完全一样的方法来恶心人,所以也不能通过名字来推测,即使解密了Invoke Dynamic。
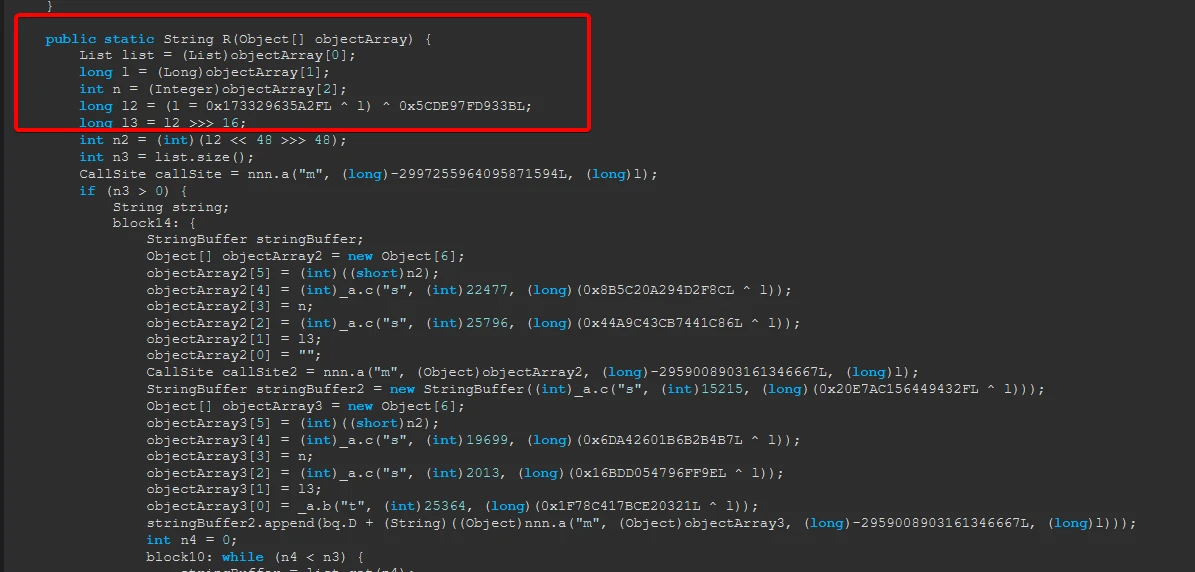
很显然对于参数的调用有一个固定模式
dup → iconst → aaload → checkcast → *unbox
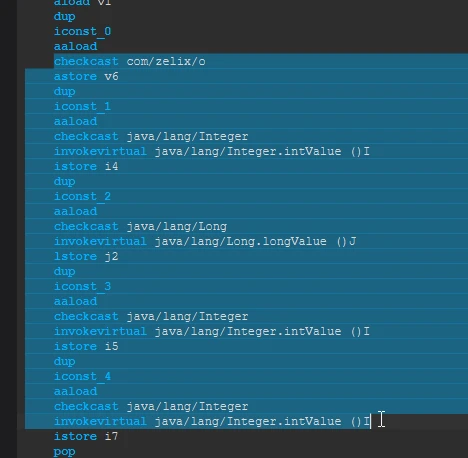
如果有unbox指令例如invokevirtual java/lang/Integer.intValue ()I,类型就是拆箱后的基本类型,没有拆箱,类型就是checkcast的Type,参数顺序完全由数组下标排序,和指令先后无关。
示例:
可推断出原始Descriptor为(Lcom/zelix/o;IJII)V,即可修复方法参数。
参数修复之后,方法体里对参数的读取仍然是解包参数的局部变量,而它们现在应该直接读参数。所以还需要把局部变量表重新排一遍。
实例方法的 this 固定占 0 号槽,参数从 1 号槽开始依次往后排,long 和 double 各占两个槽。以此类推即可修复所有参数引用。
还有一种特殊情况就是这个参数根本没有引用,因为ZKM会给()V这种无参方法也变成Object[]输入,可以直接恢复成()。
ZKM 处理参数混淆时会把整个继承表里的这个方法的参数一起变成 Object[],所以父类或接口里一定还有一个 i([Ljava/lang/Object;)V。因此我们需要建立一个ClassHierarchy,之后可以根据各个有具体代码的方法推断出整个继承或实现表里的Override方法的参数。
对于方法的调用点,也有Object[]装箱代码需要处理,示例字节码
对应Java代码
anewarray 之前的栈内容就是原始参数,所以修复引用的方法为删除从数组长度(bipush 6)到调用指令之前的所有指令,并把调用的 Descriptor 换成修复后的。
为了防止自动识别,新版本 ZKM 尽可能节省了拆包和checkcast
如果一个参数在方法内只被使用一次且目标可以传入Object,例如List.add,ZKM就不会生成checkcast指令。
示例:
27.0.0 混淆将会成为
节省掉了checkcast,单看当前方法体已经无法推断出 Typed 类型了。
虽然当前方法里的checkcast被节省了,但是Caller Method可能因为在多处使用了该变量而在方法开头进行了checkcast或者该变量在Caller Method里store到局部变量上下文有明确的类型。
或者如果一个方法有三处调用,向上追踪后可以发现传入类型都实现了某个接口或者继承了某个类,那么显然这个参数就是父类或接口,可以通过打分机制计算出最有可能的类型。
回填之后,对额外的参数的运算会是一个固定的lload一个数值,可以直接根据堆栈折叠为直接引用而不是局部变量,这样所有调用前就恢复为常量了,为解密常量打下了基础。
除了参数混淆(将参数修改为Object[]),ZKM还有一个功能叫参数修改混淆(Method Parameter Changes),会给方法发配一个额外的long参数,这个参数在方法里参与混淆运算,并在调用下一个方法时将这个值异或。
这意味着你必须完全追踪所有调用,从main方法往下顺,才能算出每个方法的long密钥的值。其中最大的阻碍是 Lambda 方法。ZKM 同样会给 Lambda 的实现方法加上额外的参数,调用方在创建 Lambda 时把它作为参数压栈传入,同时 LambdaMetafactory 的 bsmArgs[1](实现方法的 Handle)的描述符里也带额外参数,两处都需要修复。
在部分情况下他会变异为一种更加恶心的形态
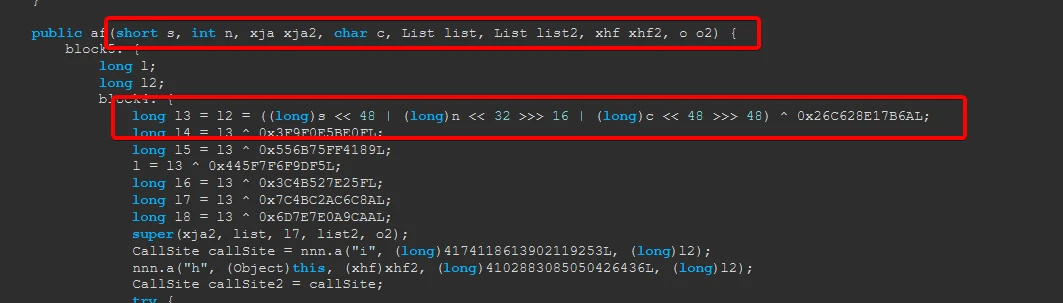
不会直接传入一个long而是传入多个short, int, char 然后拼装出这个方法的long,其组装方式为char代表低16位,int代表中间32位,short代表高16位,字节码为
组装结构为
对于这种模式需要先根据传入的类型反解出原始long并折叠运算,才能继续建立调用追踪。
在解密了引用混淆之后,只要妥善处理Lambda,就可以很容易的建立调用结构,得到他对参数处理的xor值即可算出每个方法对应的long值,然后就可以进行回填并擦除额外的参数,因为回填之后额外的参数不再被引用。





