本文首发于我的个人博客
084K9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6Y4K9r3!0K6N6s2y4Z5j5i4u0C8i4K6u0V1M7s2u0G2i4K6u0W2k6$3W2@1K9s2g2T1i4K6u0W2K9h3!0Q4x3V1j5J5x3o6t1$3i4K6u0r3x3e0m8Q4x3V1j5H3y4W2)9J5c8V1y4h3c8g2)9J5k6o6t1H3x3U0m8Q4x3X3b7$3y4e0l9%4i4K6u0r3
CVE启动
某个版本Chrome的漏洞可以在谷歌的更新公告(7a8K9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6U0K9s2u0G2L8h3g2J5k6h3I4W2j5i4y4W2M7#2)9J5k6h3N6G2L8$3N6D9k6h3u0D9L8$3N6Q4x3X3g2U0L8$3#2Q4x3V1j5`.)上查看
更新公告上可以找到bug的漏洞编号,issue(e65K9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6T1N6h3N6K6i4K6u0W2j5$3S2J5L8$3#2A6N6h3#2Q4x3X3g2G2M7X3N6Q4x3V1k6H3i4K6u0r3j5$3S2J5L8$3#2A6N6h3#2Q4x3V1k6A6M7%4y4#2k6i4y4Q4x3V1k6D9K9i4y4@1)上可以找到相关信息
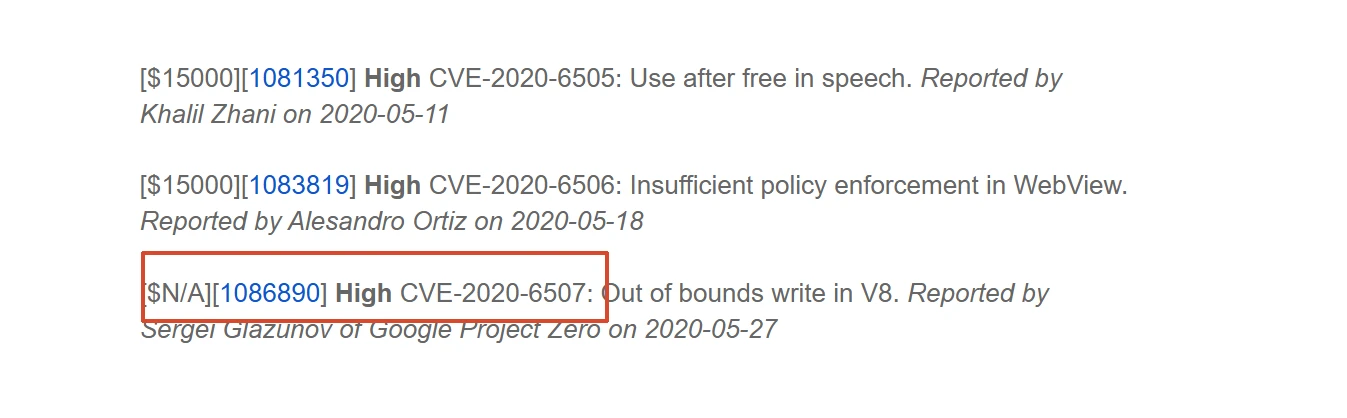
bug编号1086890,然后到issues找
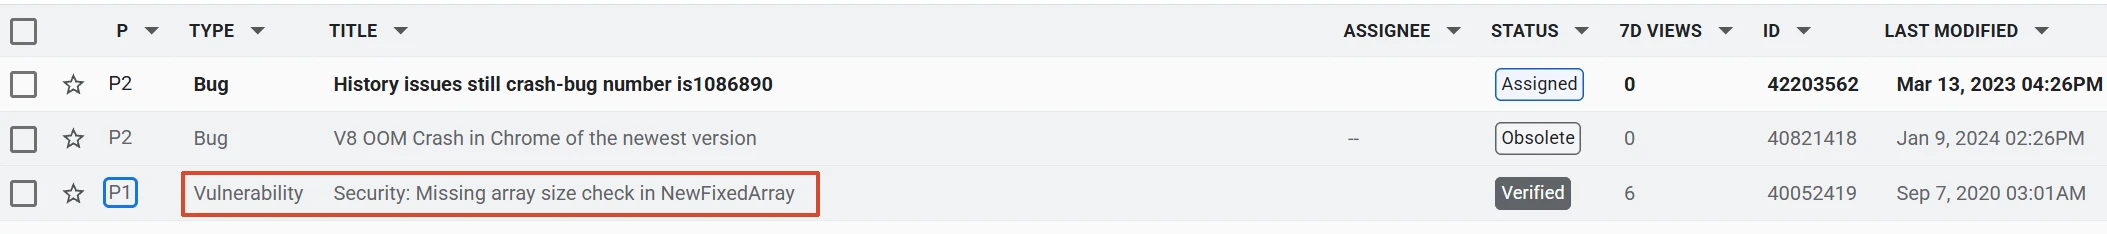
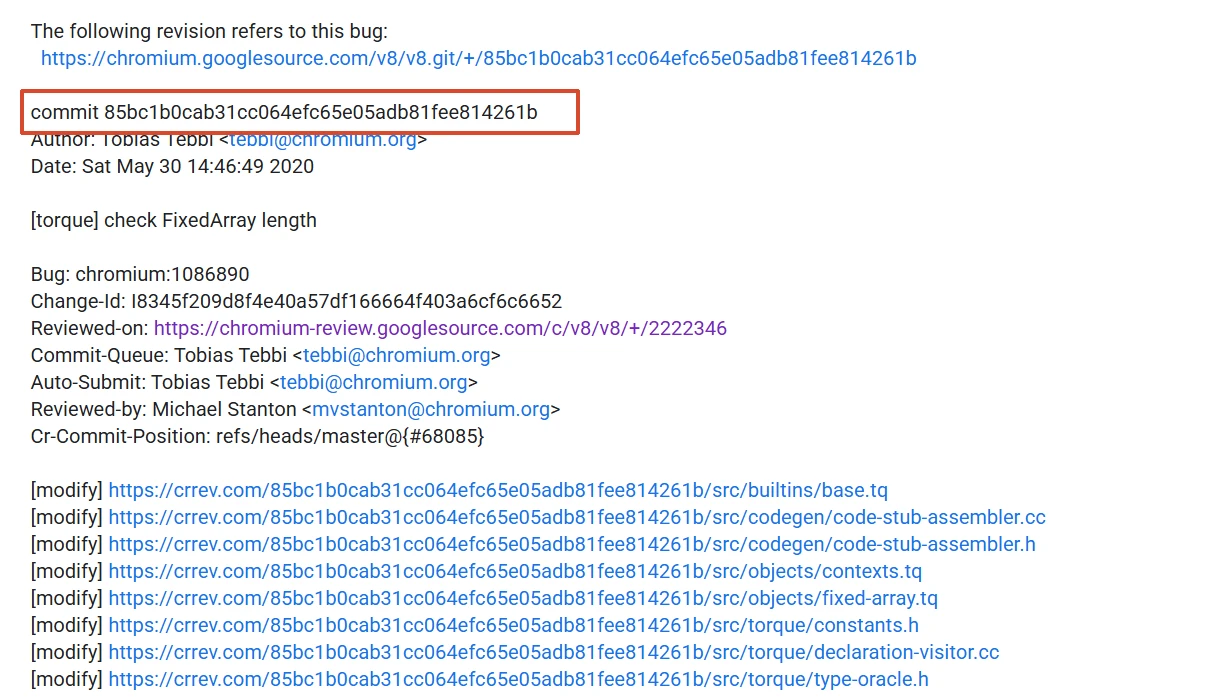
commit怎么藏评论区里
找一下它的父提交(b3bK9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6U0K9s2u0G2L8h3W2#2L8g2)9J5k6h3N6G2L8$3N6D9k6i4y4G2N6i4u0U0k6g2)9J5k6h3y4G2L8g2)9J5c8Y4j5^5i4K6u0r3N6U0S2Q4x3X3g2Y4K9i4c8Q4x3V1k6Q4x3V1u0Q4x3V1j5^5y4h3u0U0x3h3t1H3j5$3q4T1x3K6q4U0j5K6l9$3y4r3g2X3j5K6j5#2k6e0l9#2j5h3c8T1z5o6q4X3k6h3f1^5x3e0b7J5y4U0q4T1)
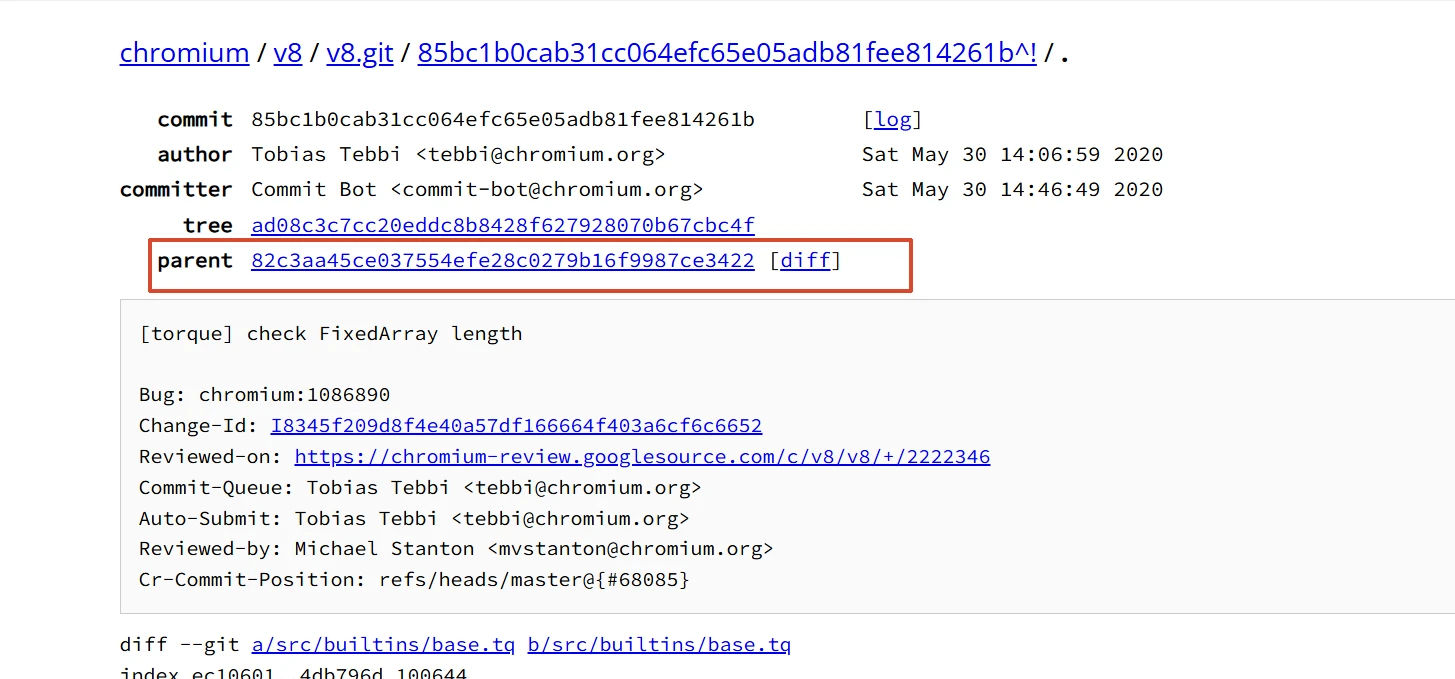
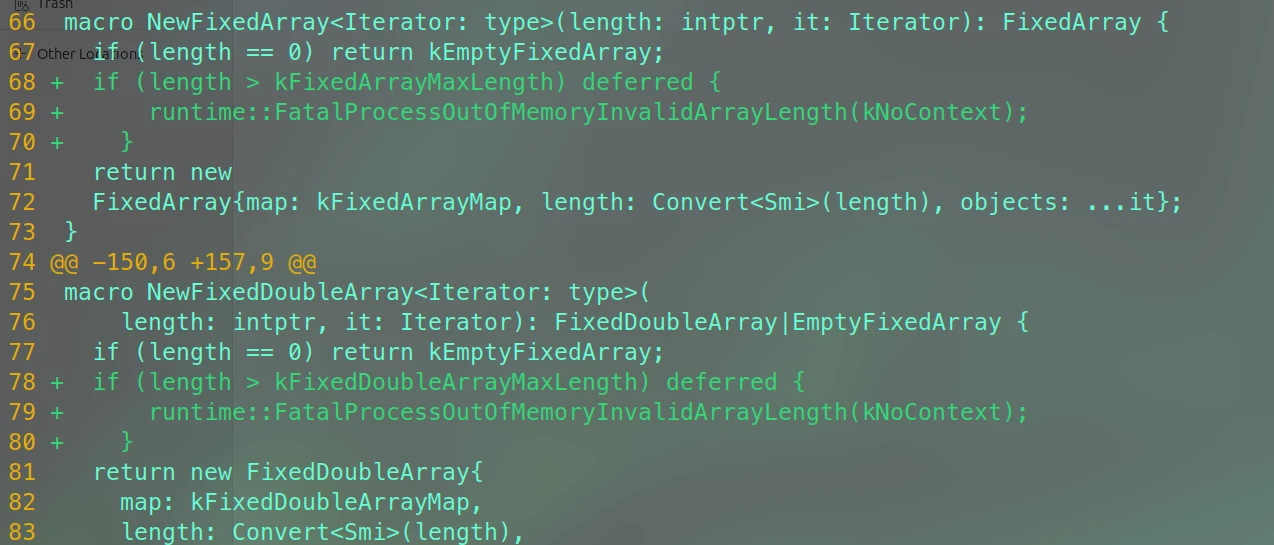
CVE-2020-6507成因之一就是NewFixedDoubleArray这个macro未对DoubleArray的Length上限进行检查(属于是把c++更换成Torque后漏了一步检查,不排除有内鬼的可能性),源码里搜一下可以发现kFixedDoubleArrayMaxLength的值为67108862,可见V8中浮点数数组的length上限应该在67108862
vi src/objects/fixed-array.h
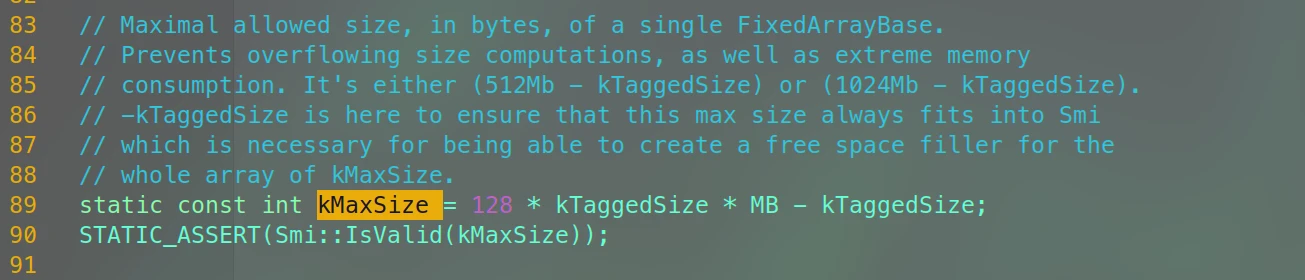
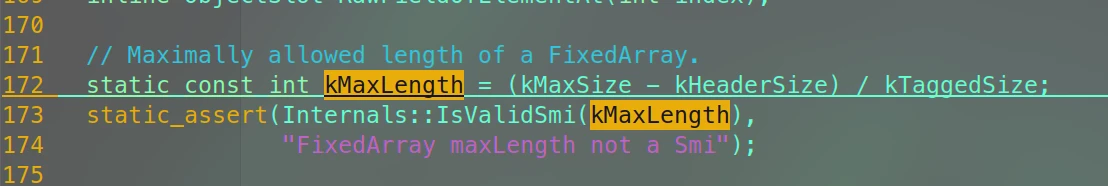
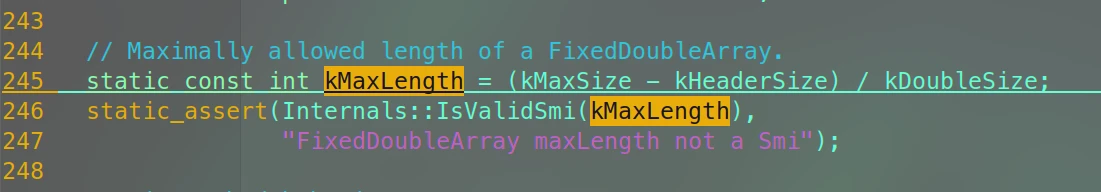
在开了Pointer Compression后kTaggedSize = 4、kHeaderSize = 2*kTaggedSize = 8、kDoubleSize = 8
MB = 2²⁰ = 1048576
kMaxSize = 128 * kTaggedSize * MB - kTaggedSize = 536870908
FixedDoubleArray: (536870908 − 8) / 8 = 536870900 / 8 = 67108862.5 → 67108862
然后看看poc是怎么个利用法
目的是改array的length
issues上的poc应该是在第15行多打了个\
d8里没有alert(),把第31行改成print或者console.log都行
开头先是创了个giant_array->DoubleArray,array在0x40000(262144)里填满1.1,args 中有 255 个元素,每个都指向同一个 array。然后创建一个长度为 262140、元素全是 2.2 的数组,把它push到args的末尾
相当于把args的元素依次复制进giant_array
这时giant_array的长度为255 * 0x40000 + (0x40000 - 4) = 67108860
最后用splice在giant_array后面加上3个3.3,此时giant_array的长度为67108863
由于创建giant_array调用的是NewFixedDoubleArray() 方法,并没有对giant_array的长度做限制,显然giant_array超出了DoubleArray的67108862上限
把同一段 8 字节内存,先按BigUint64Array写入一个 64 位无符号整数,再按Float64Array当成Double读出来
Turbofan在进行编译优化时会考虑到每种数据类型的长度限制,V8是定义了kFixedDoubleArrayMaxLength的值为67108862,但先前创建的giant_array缺失了长度上限限制,达到了67108863。
在trigger函数中,对于常规的浮点数数组x的取值只能是0或1,后续的30000次调用成功触发Turbofan优化,Turbofan判断对于“corrupting_array[x] = length_as_double; ”x的取值不会越界赋值,于是移去了边界检测(简单计算一下发现x的取值实际上为7,如果有边界检测的话就会令corrupting_array扩容,检测移去后length_as_double成功覆盖corrupted_array的legth段)
corrupted_array[0x123456];触发越界访问,这段addr没有映射导致SIGSEGV
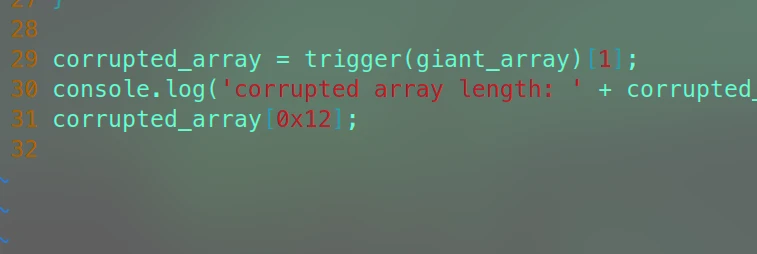
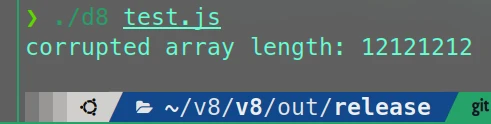
能映射到的addr就没问题了
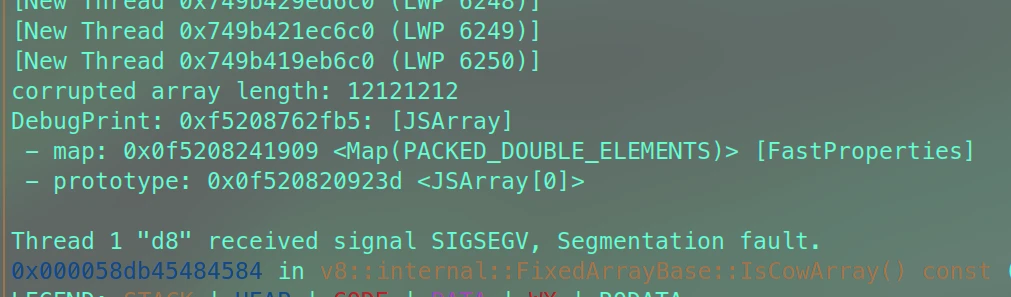
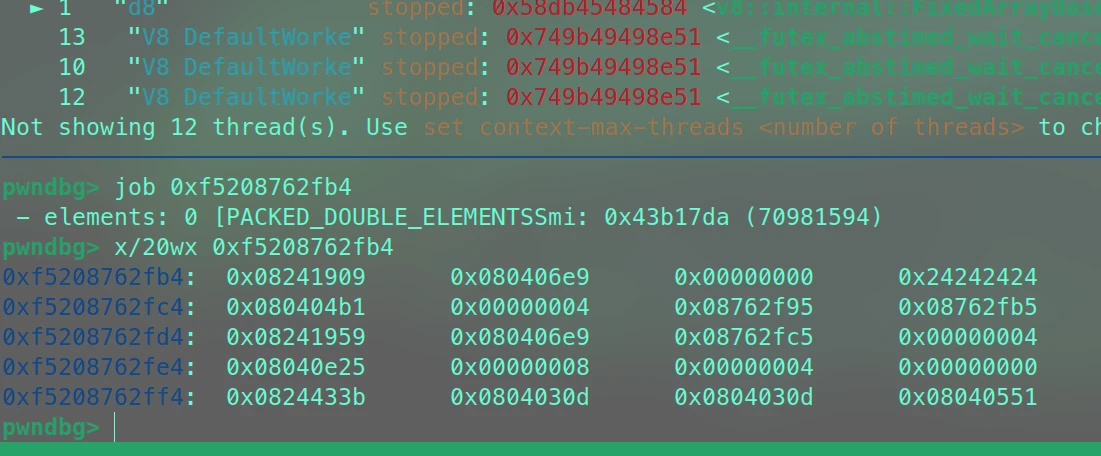
这里有个细节,注意到在开启了Pointer Compression后JS对象的指针被压缩到4字节,以小端序存储的length_as_double覆盖corrupted_array的length字段的同时也破坏了elements,后续的利用会对这部分进行处理
这种环境问题就得开个docker了
麻烦的是还得回滚一下clang
这里记得sudo chown -R改一下out/release权限
v8.dev太权威了你知道吗
我们看看命名属性跟数组下标属性(元素)有什么不同
注意到object {a: "foo",b: "bar"}有两个属性,a和b
object {a: "foo",b: "bar"}这种命名属性没有0,1,2这样的整数索引
["foo", "bar"]这种就是分配的整数索引
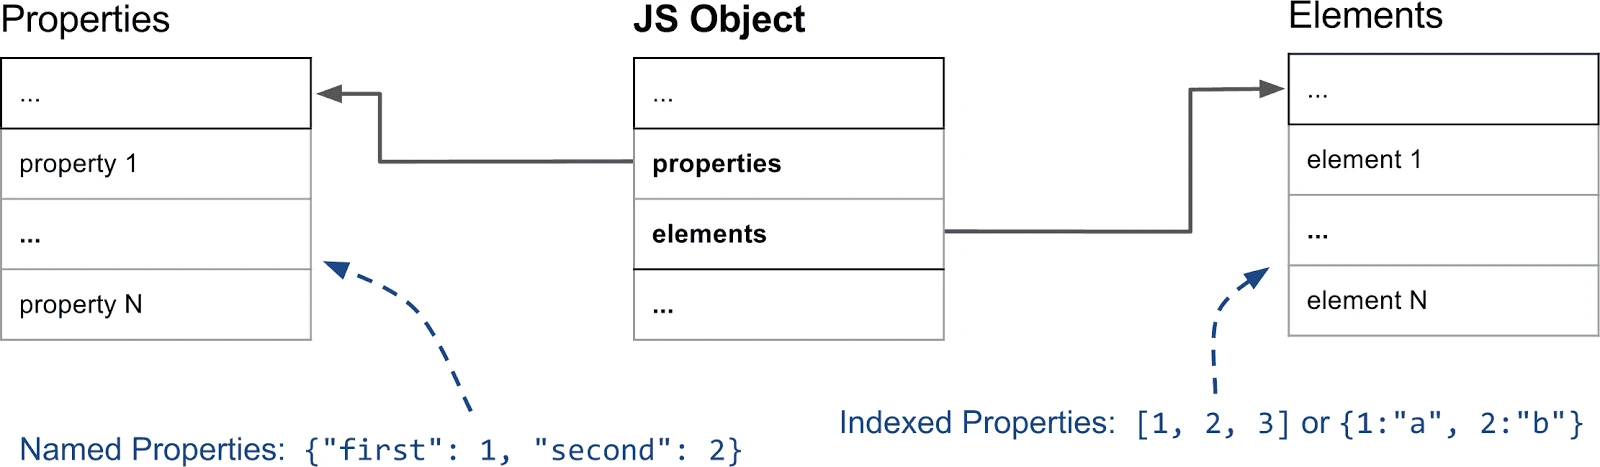
出于性能考虑,V8将properties跟elements针对不同的使用模式分开储存
elements主要用于各种Array.prototype 的方法(pop,slice),这些方法访问的是连续区间的属性,大部分情况下以简单数组的形式存储(稀疏字典)
named properties以一种类似的形式存储在一个独立数组中,V8中的设计是将每一个JSobj都关联一个HiddenClass来推出一个命名在该属性数组的位置,HiddenClass存储的是JSobj的shape,包括从属性名到属性数组下标的映射表,一些更复杂的情况是用字典来存储属性
接下来看看HiddenClasses的工作原理
HiddenClasses存储了obj上属性的数量和obj原型的引用等元数据
HiddenClasses类似面向对象编程中的class
像JS这样基于原型的语言是没办法在程序运行前就确定对象的结构,V8中的HiddenClass是动态创建并随对象动态更新的
HiddenClass充当对象shape的标识符,V8只需要判断两个类的HiddenClass指针相不相同就能判断它们是不是同一个形状
假设 const obj1 = {x: 1, y: 2};的shape为A,const obj2 = {x: 5, y: 6};时V8会发现它们的shape一样,于是让obj2的HiddenClass也指向shapeA。编译优化跟内联缓存也会用到HiddenClass
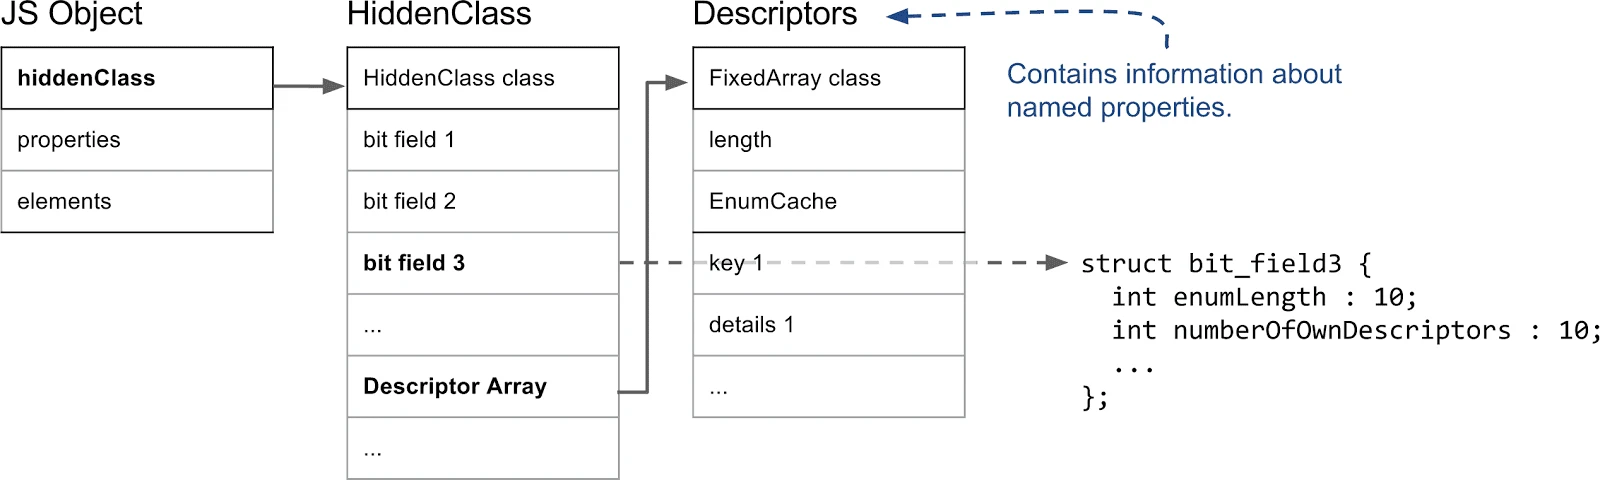
这里的bit field是把一堆小整数和布尔标志位打包进比特位——实例类型、实例大小、是否可调用、元素种类等,不值得各占一个字段
HiddenClass class这个字段表明HiddenClass也是堆对象,也有一个指向它的类的指针,在V8堆上任何由GC管理的对象第一个字段都指向HiddenClass
属性中最重要的信息存储在bit field 3,包括属性数量跟一个指向Descriptor Array的指针,Descriptor Array中包括描述符数组,length是数组容量,EnumCaches是枚举缓存,key1是属性名查找 obj.x 时就是拿 "x" 来比对,details是属性的特性
具有相同结构的对象共享一个HiddenClass,当向对象添加一个属性时,我们会使用一个不同的 HiddenClass
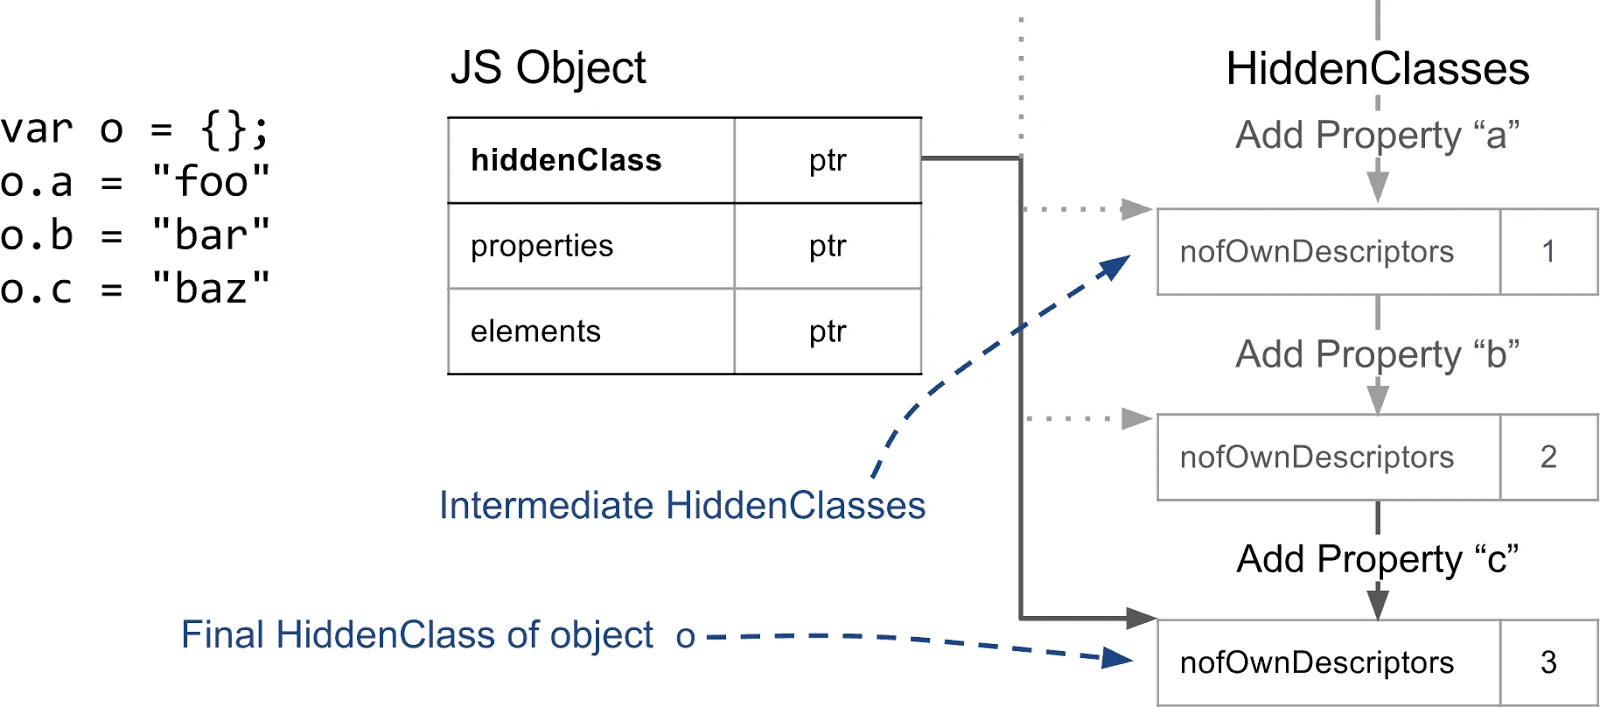
每添加一个新属性,obj的HiddenClass都会被更换
V8会在后台创建一个转化树把HiddenClass连一块

当创建新对象并添加了不同的属性时,V8会为这些新的HiddenClass创建一条单独的分支
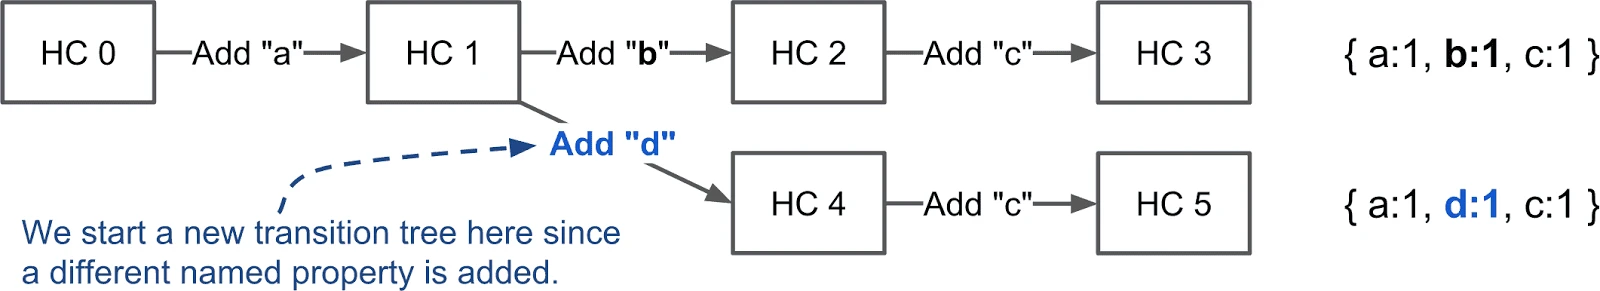
我们再深入了解一下这些属性是如何存储的,前面提到属性有两种类型,named、indexed,接下来先看看命名属性
像{a: 1, b: 2}这样简单的对象在V8里可以有多种不同的表示,不过出于优化考虑(inline caches)很少会用字典形式
V8支持对象内属性,它们直接存储在对象自身上,因为访问不需要二次解引用所以速度很快
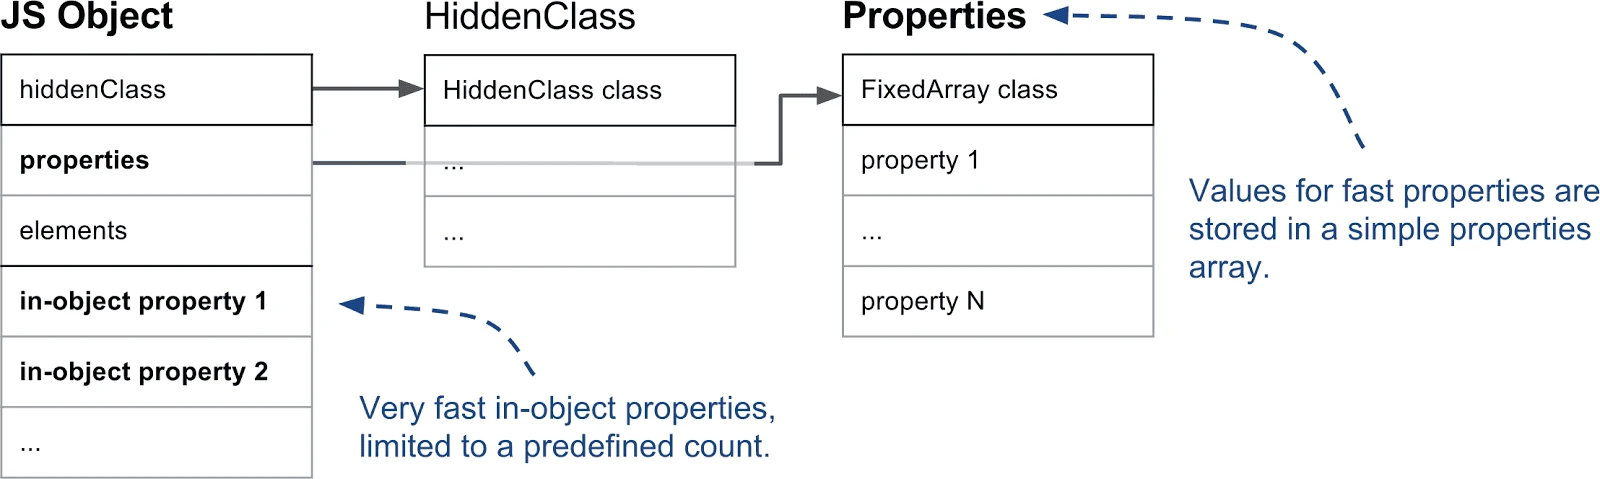
对象内属性数量由对象初始大小决定,如果超过了对象内的空间就会被存储到属性存储区
我们通常把存储在线性属性存储区的属性定义为快速属性,快速属性通过存储区的index访问
从属性名找到在属性存储区的addr必须查询HiddenClass上的描述符数组
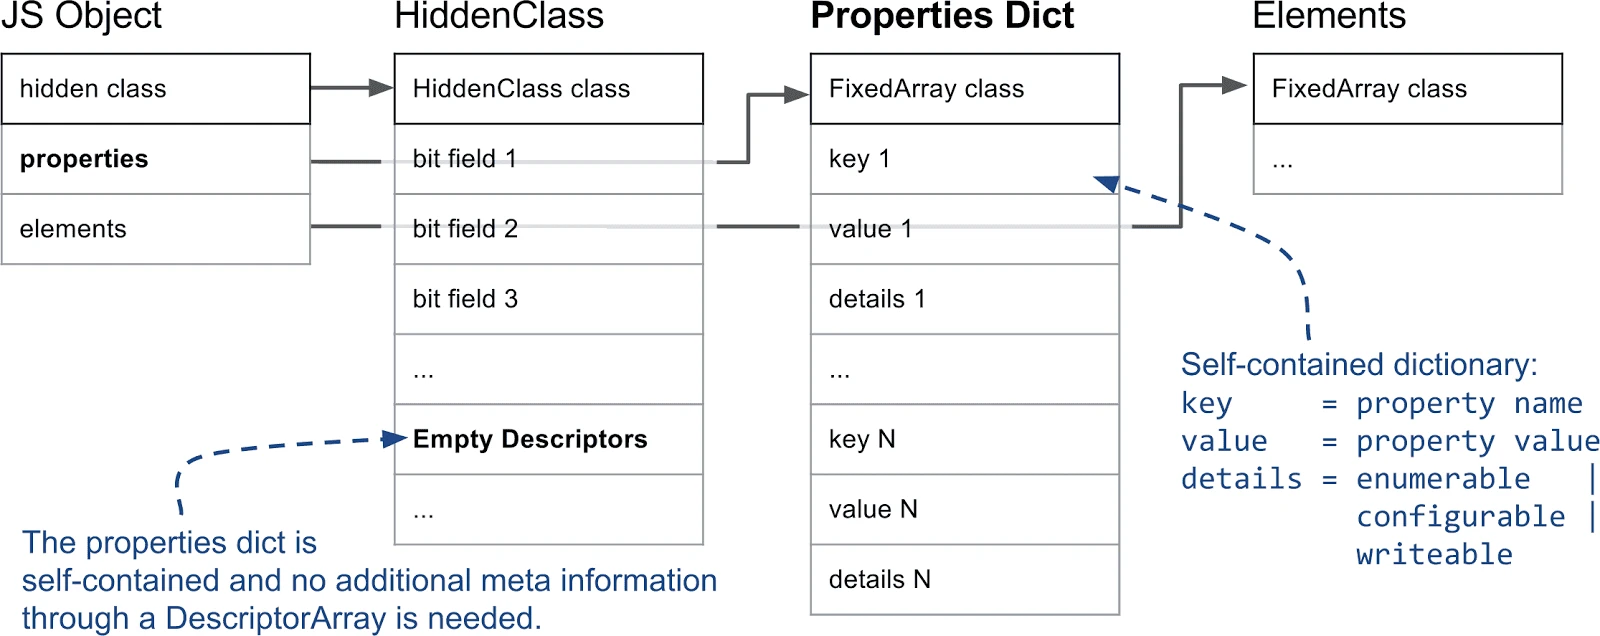
当一个对象频繁add、delete大量属性时,维护HiddenClass和描述符数组会产生大量开销,V8支持slow properties,慢属性的对象用一个自包含的属性字典存储属性,元信息直接存储在属性字典里
这种设计让inline caches无效,因此速度上会慢一些
接下来是整数索引属性,其所有索引属性单独存储在元素存储区
V8对元素做出的第一个区分就是在后备存储中元素是紧密还是空洞(packed or holey)
当删除一个元素或根本没定义时就会出现holes,比如[1,,3]
这里有个好玩的
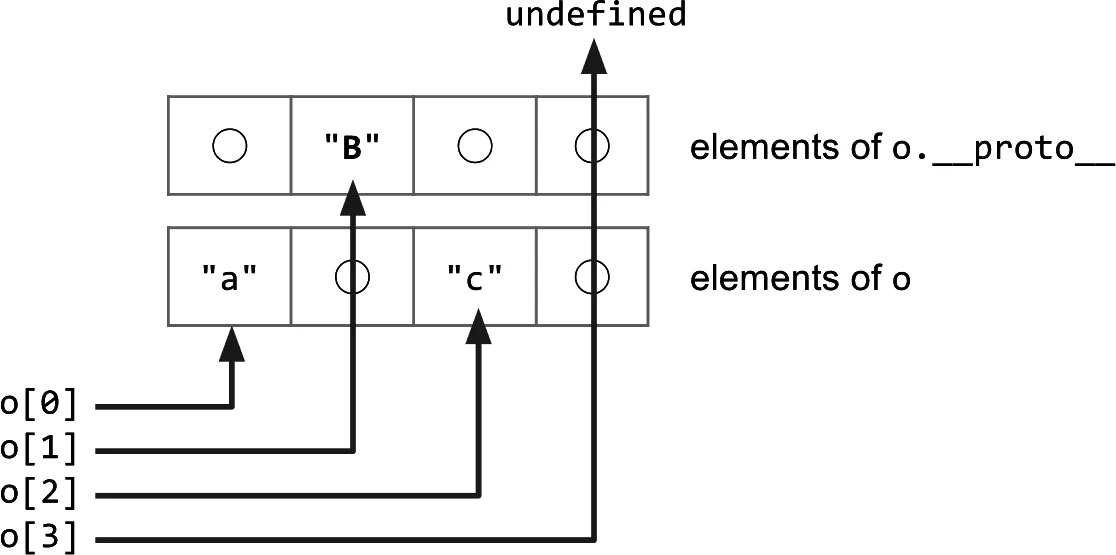
这里的o.__proto__是o的原型
o[1] 因为在 o 自身是 hole(不存在),穿透到原型上找到了 'B'
可见属性上找不到就会沿着原型链向上查找,如果我们有一个the_hole值来标记hole就能提高array的效率,当我们知道array是packed or holey时就能避免开销巨大的原型链查找
接下来是elements的第二层分类
快速模式 or 字典模式
fast elements就是VM的内部数组,index直接映射
对于那些有大量空洞的数组我们采用字典来节省内存
for example
10000个backing store有9999个hole,为了节省内存改用字典
V8会创建一个“键-值-描述符”的三元组,这里的键是“9999”,值是“foo”,用默认描述符
这里用 Object.defineProperty 定义了一个“只读、不可配置”的数组索引属性,configurable: false表示不可配置
描述符细节无法存储在HiddenClass上,shape不记存在性,因此在自定义一个索引属性时V8会使用slow elements
只要用非默认描述符定义索引属性,V8 就被迫退到 slow elements
这里是V8对fast elements的两种区分
Smi = small integer,小整数
在一个array中只存储整数时,V8会直接把值编码在指针里
V8 利用最低位来区分 Smi 和堆对象:
double占用多个字节,通常表示为完整对象,在纯double array的特殊情况下V8会直接存储double的值
V8内部一共定义了20种元素种类,这里不做额外解释
为了避免给20种元素种类都实现一遍Array函数
ElementsAccessor 借助 CRTP(奇异递归模板模式)为每个 Array 函数生成特化版本
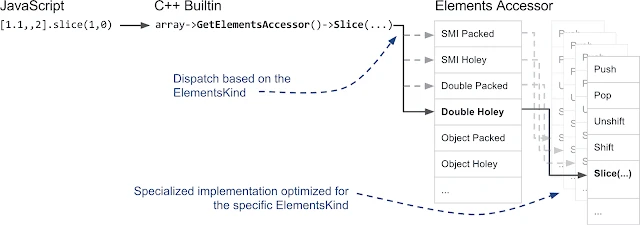
跟SGI STL挺像啊
这部分就简要说一下
JS运行时V8会跟踪每个数组用的是哪种类型的元素,以此来针对性优化
JS并不区分整数、浮点数和双精度数,都将其视为number,但在V8优化时会细分
V8 把 elements kind 组织成一个格(lattice),转换只能从具体走向泛化,不能回退
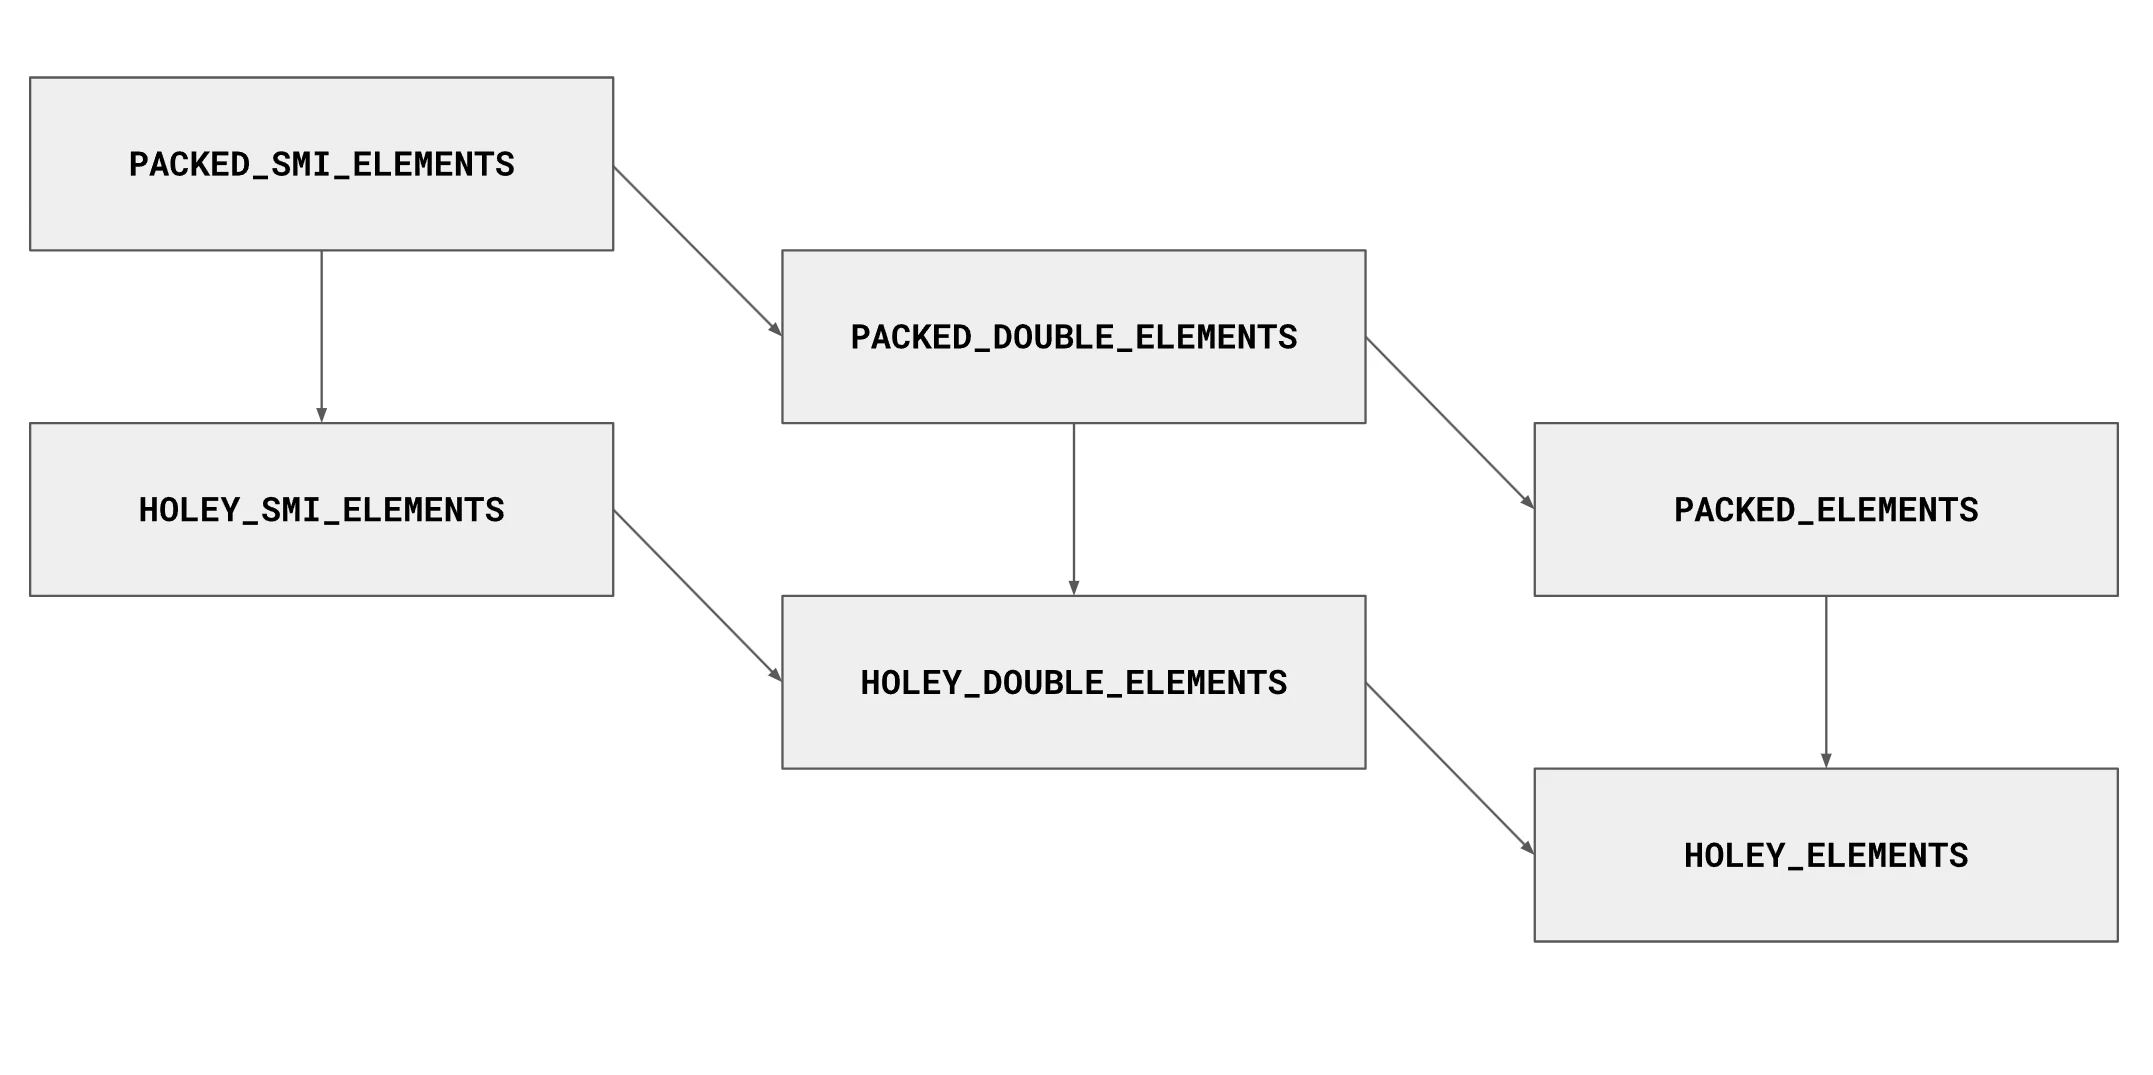
各种数组元素种类按照“具体 → 通用”的关系,组成一个偏序层次结构,转换只能沿着这个结构向下走,即从更具体的种类变成更通用的种类
packed和holey的主要区别就是元素存不存在,对于holey会有hole check,prototype chain lookup等额外开销
先看看inline caches到底在cache什么
IC实际上是记住 Shape 和 property offset,它缓存的是查找结果
后续遇到相同 Shape,可以直接从已经缓存的 offset 加载值,而无需重新查询属性信息
我们来看看查找的过程
第一次查找时得正常查找一次
o ->Map ->找到 x ->发现 x 在 offset N
这时候得到
Map = 0x123456
x offset = 0x18
IC记住如果以后o.map == 0x123456,那么x 就在 offset 0x18







