前言
本文主要分享,前阵子开发的AI的动态分析工具。框架一直高强度实战项目对抗(VMP等)。在KCTF比赛中也检验工具强度并且一直在修改工具功能来完善当前分享平台(修补框架去了排名靠后了,争取明年拿个前三)。我这里也是非常感谢蓝队的大哥们的样本。我一直都在持续优化工具。当前主要以Windows平台视角为主。主要是分享思路为主,姿势不关键。(文章纯古法,除开图片生成0AI参与。项目开源见末尾Git仓,有时间请各位手子耐心看完)
设计
需求
在思考我的需求之前,我认真思考过我这一年的困境与难点。我认为难点如下:
- PC侧三环当前的分析工具常规以X64Dbg,以及各种基于Windows调试框架下的调试器为主。需要处理环境检测甚至是需要进入内核进行对抗。
- 主流的分析工具X64为例,在开发这个调试器的时候并不是AI时代。从设计上来说大量的代码设计都是以传统古法为主。现在都是基于插件的形式支持AI。当前AI浪潮下,古法以及可以说不是主导了。
- 基于Windows调试器框架下,对于vmp的处理效率太低(如常见的trace,污点分析等等)。只能作为一个传统debug的调试器,如果拿来做对抗效率太低,影响产出。(安卓也一样遇到linux调试器环境检测问题)
- 基于内核层的反调试或者是异常接管也是要基于Windows调试框架下(安卓下内核更是不谈了),受驱动签名影响以及兼容性问题等等因素。我认为基于内核调试器分析三环程序太重了。(笔者认为优雅的分析一个三环程序都要动用内核驱动甚至是虚拟化层去做高打低。假设要分析一个虚拟化层的怎么办?要在ME等所谓的微内核上做嘛)
通过反推就可以知道我的需求情况。也许和一些师傅想的到一块去了。
技术选型
通过需求分析,基于Windows调试框架是不太合适作为框架的基座了。所以我们需要一种不基于Windows异常的框架,并且不能太重,不然等于自己写一个虚拟机了。这里选择插装框架作为基座,有代表的就是Pin和DynamoRIO。区别是一个是开源框架一个是闭源。
插装介绍
插装顾名思义就是在运行代码的时候,插入我们自己的东西。
Pin和DynamoRIO都有自己的JIT。与传统的模拟执行不同,这两个框架都是基于二进制运行,而不是将指令转义后在虚拟机里面执行。传统模拟执行可能会遇到一些无法翻译指令的问题或者是对抗,比如切换到内核去的指令。(尤其是在安卓平台上)
举个例子:
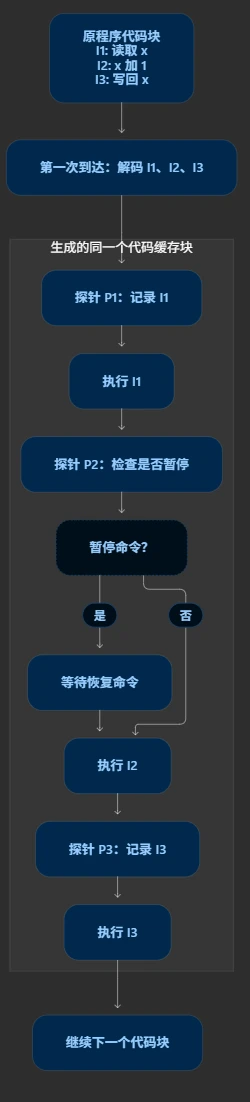
插装框架会把需要运行的程序代码加载到自己的缓存中运行,所以框架是可以知道在哪条指令下面停止下来。这样来做到指令级粒度的控制。基于这个能力我们就可以自建调试。
AI框架设计
前面说过,传统的调试器都是基于人工为主。在AI时代以插件的形式运行。LLM处理静态二进制是可以直接分析汇编的,遇到一些对抗可以使用脚本进行静态分析。
动态分析问题如下:
- 驱动姿势问题,人类在断下后可以通过肉眼,来查看软件内部的上下文信息来分析当前情况。AI更喜欢是驱动代码来处理断下的情况。
- 主导权问题,传统调试器搭配MCP主导权实际上还是人。并不是以Ai主导人辅助。所以会产生以下几个问题(3,4,5)。
- 权限问题,ai具体调用mcp干了什么,没有一个直观的展示。需要通过日志,debug或者是借用Hermes自带的mcp或者是tools(函数调用抽象出来的接口层)。
- 上下文问题,如果在过长的上下文中,AI想要较高灵活的去分析框架,一般是调用自由度较低的函数调用接口(MCP或者是其他一些产品的tools)配合静态代码进行分析。AI到底调用接口的顺序是什么?在调用mcp之后他运行了哪个分析脚本?结果是什么?我们还需要依赖其他手段去做记录和溯源。
- 自由度问题,函数调用接口在二进制分析上来说,不是一个很好的选择。它只能控制我们已有的函数接口的输入和输出。
- 时效性和复杂场景下,假设一个场景,我在做脱壳处理的时候,需要先处理真实OEP情况,在根据OEP情况进行Dump,这是一个组合拳 ,不是单一的几个MCP加上静态脚本就可以处理的。如果要处理这个问题就需要花费更大代价,更多token,来回返工。
框架架构
根据上面的问题我设计一套全新的以AI为主,人类为辅的分析平台。主要以代码驱动,通过MCP接口吧代码动态注入到框架中进行执行。
架构图如下:
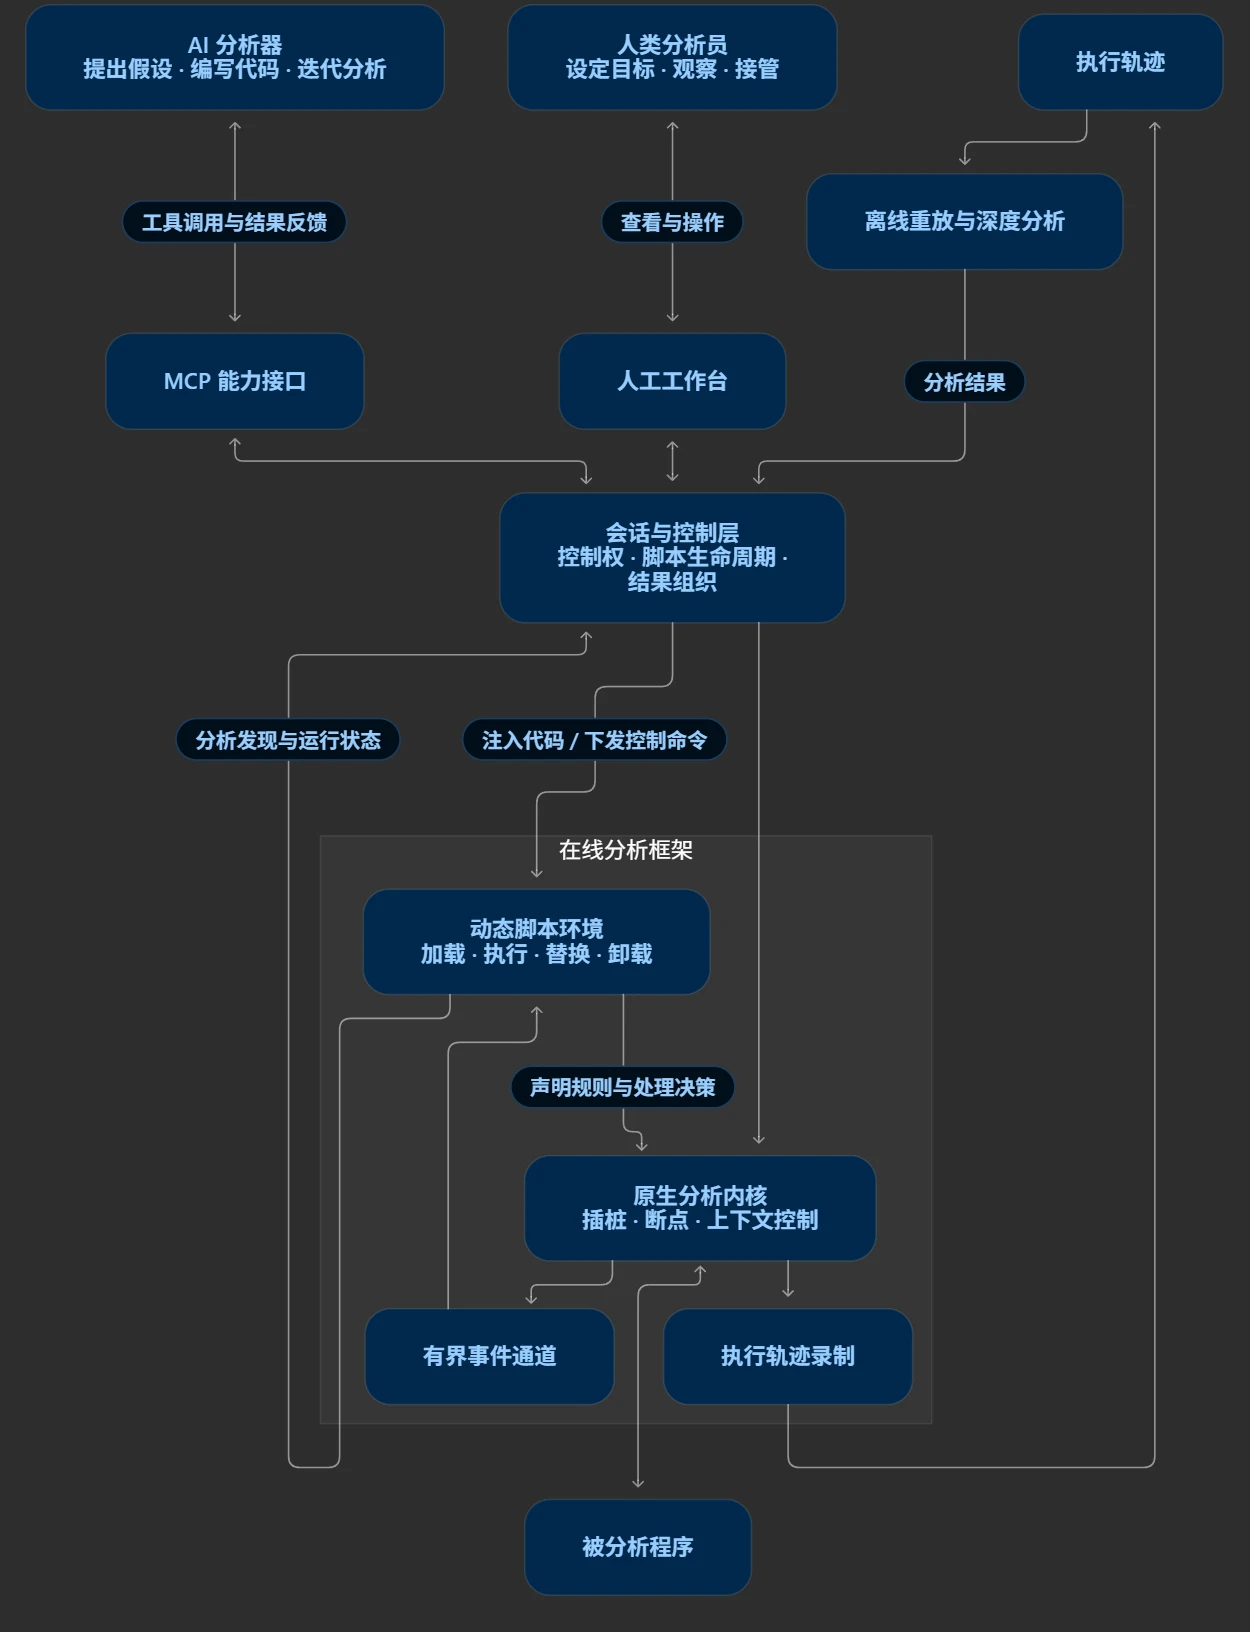
从架构上设计人类和AI层级是平级的而不再是一个插件或者是一个多出来的脚本
理想状态下,我们实际上只是一个观察员,用来观察ai或者agent在干什么:
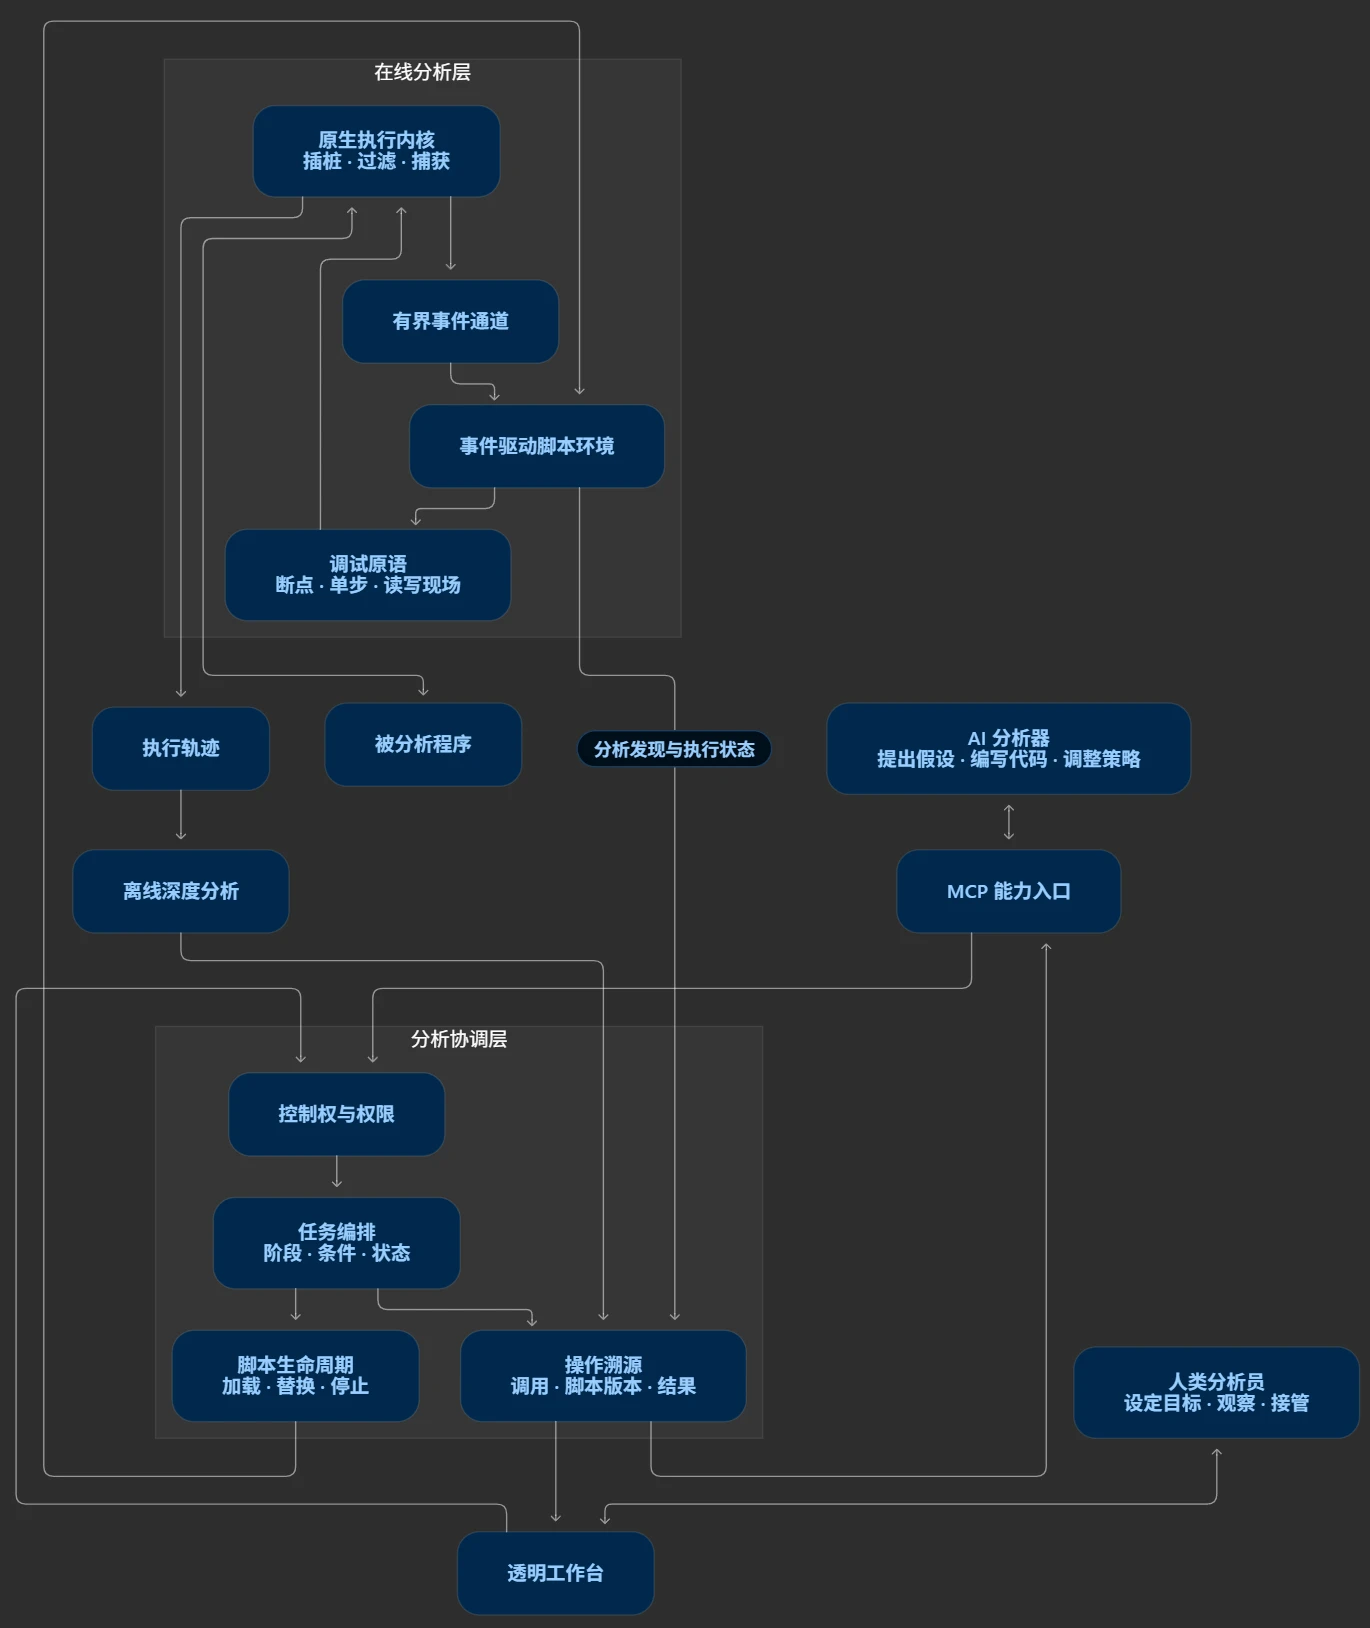
理想状态下,动静配合做到完全无人值守分析。人只需要在外部进行观察。
具体的代码框架如下:
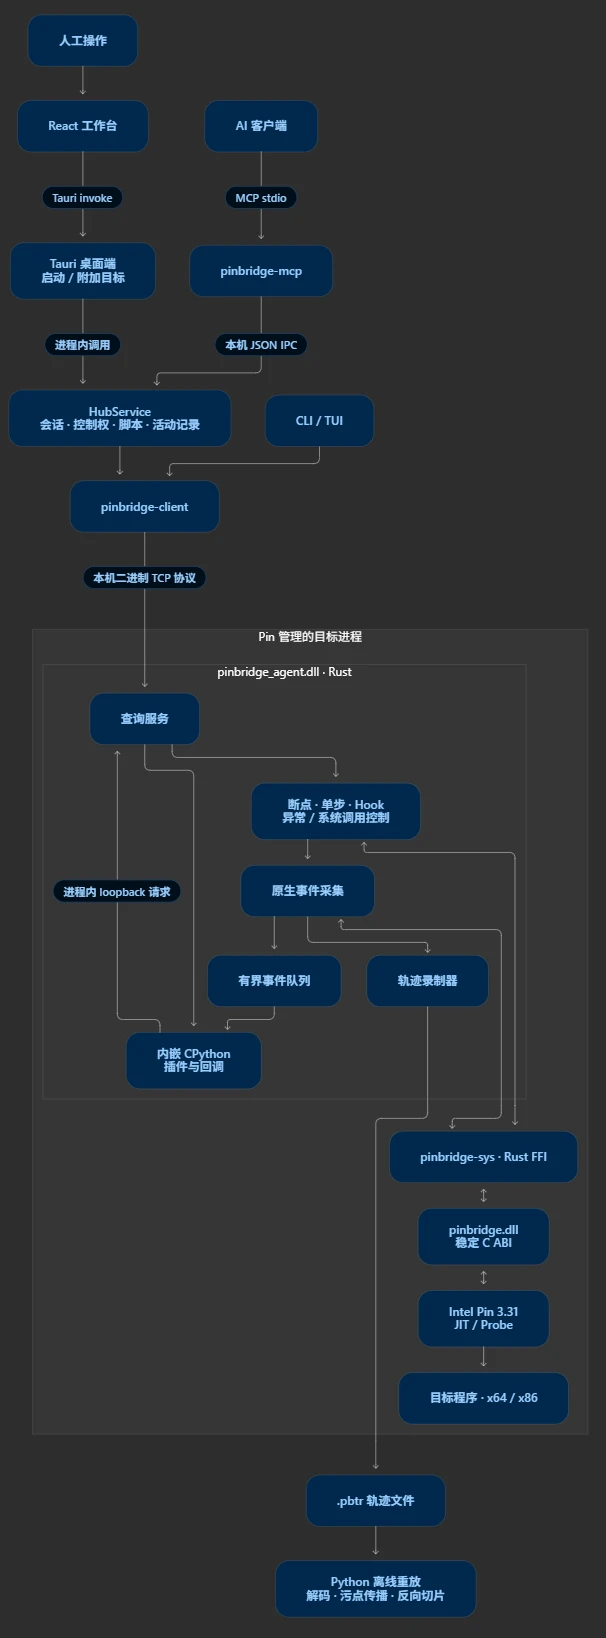
利用插装能力封装了四种介入时机:
- 断点时机
- Windows异常时机
- 系统调用Hook时机
- 指令集模板匹配Hook时机
工具提供一个庞大的trace功能,可以手工trace以及ai代码驱动trace。
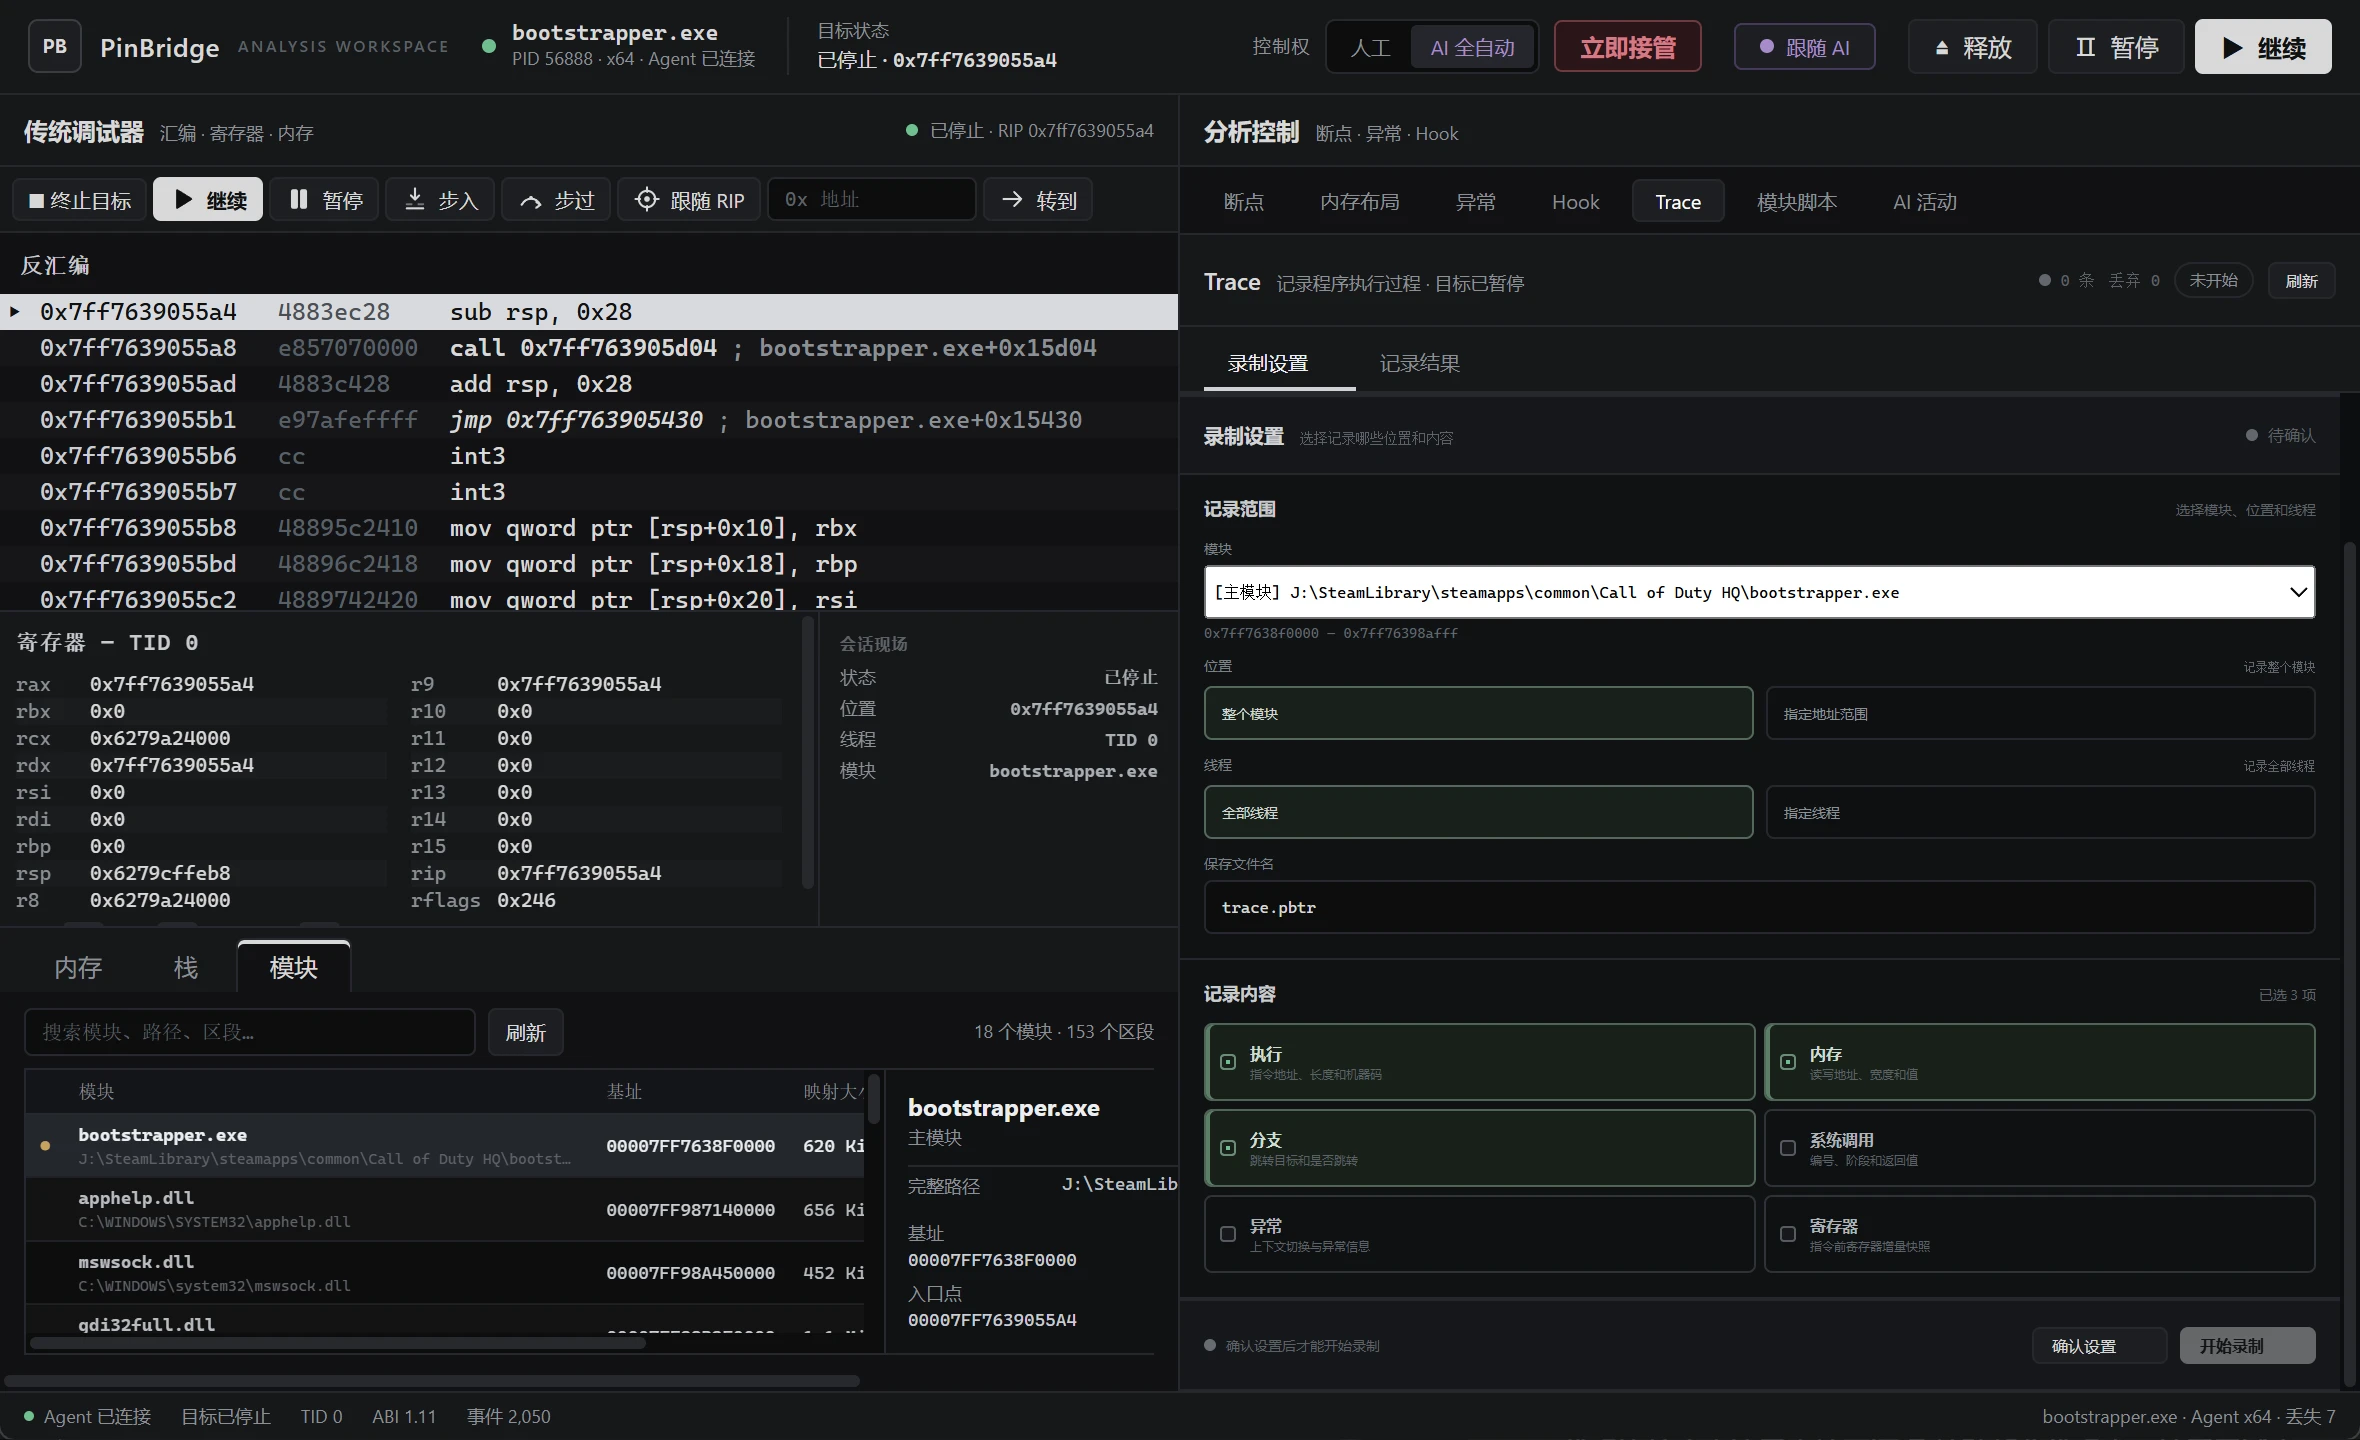
对于AI来说可能时机都是一些多余设计,但是这里方便人工查看所以分了几种情况。
实现
这里内部的解释器没有模仿Frida使用js解释器,我这里使用的是python解释器。
整个项目主要是rust语言构建。pin本身是cpp写的所以使用c语言编写了兼容层。
trace 压缩
无论是在x64还是frida下,vmp对抗环境下trace出来文件时巨大的。
这里做了几种trace压缩算法和策略:
- 录制线程判断是否延续当前重复段:
部分代码片段
let expected = previous
    .sequence
    .saturating_add(pending_repeats)
    .saturating_add(1);
if expected == event.sequence && same_payload(&previous, &event) {
    pending = Some(previous);
    pending_repeats = pending_repeats.saturating_add(1);
}
same_payload 比较事件类型、线程、地址和 arg0 至 arg7,不比较序号。只有序号连续且内容完全相同才会合并。
2. 处理重复指令
if repeat_count > 0 {
    let repeat = Event {
        sequence: event.sequence.saturating_add(repeat_count),
        kind: EVENT_REPEAT,
        thread_id: event.thread_id,
        address: event.address,
        arg0: repeat_count,
        arg1: event.kind as u64,
        ..Event::EMPTY
    };
    write_record(scratch, &repeat);
    writer.write_all(scratch)?;
}
- 寄存器重复处理,如果寄存器没有变化就不需要处理了。
Windows调试标志位处理
插装框架也不是100%全覆盖,这里也是在VMP对抗中发现了一个问题:
目标程序设置 TF 后,处理器会在下一条指令执行后产生单步异常。
在 VMP 等保护场景中,这个异常可能是程序主动设计的陷阱
插装的JIT是代码缓存中的生成指令.如果让目标的 POPF/POPFD/POPFQ 直接设置物理 TF,单步异常可能发生在 Pin 的代码缓存地址,而不是预期的位置。简单清除 TF 也不行,因为目标随后可能检查标志位,或者依赖这个异常进入自己的 VEH/SEH。
我的处理方式是在应用指令边界虚拟化目标设置的 TF。当 POPF 从栈中读取到 TF=1 时,PinBridge 模拟其用户态标志位效果,更新应用上下文中的栈指针和下一条指令地址,同时避免把物理 TF 带进代码缓存:
贴一点伪代码吧:
PIN_SetContextReg(context, REG_GFLAGS,
    EmulateUserPopFlags(current, incoming, width));
PIN_SetContextReg(context, REG_STACK_PTR, stack_pointer + width);
PIN_SetContextReg(context, REG_INST_PTR, next_ip);
AtomicStore(&state->pending, 1);
PIN_ExecuteAt(context);
功能演示
HOOK系统调用分析VMP外壳行为找到Dump时机:
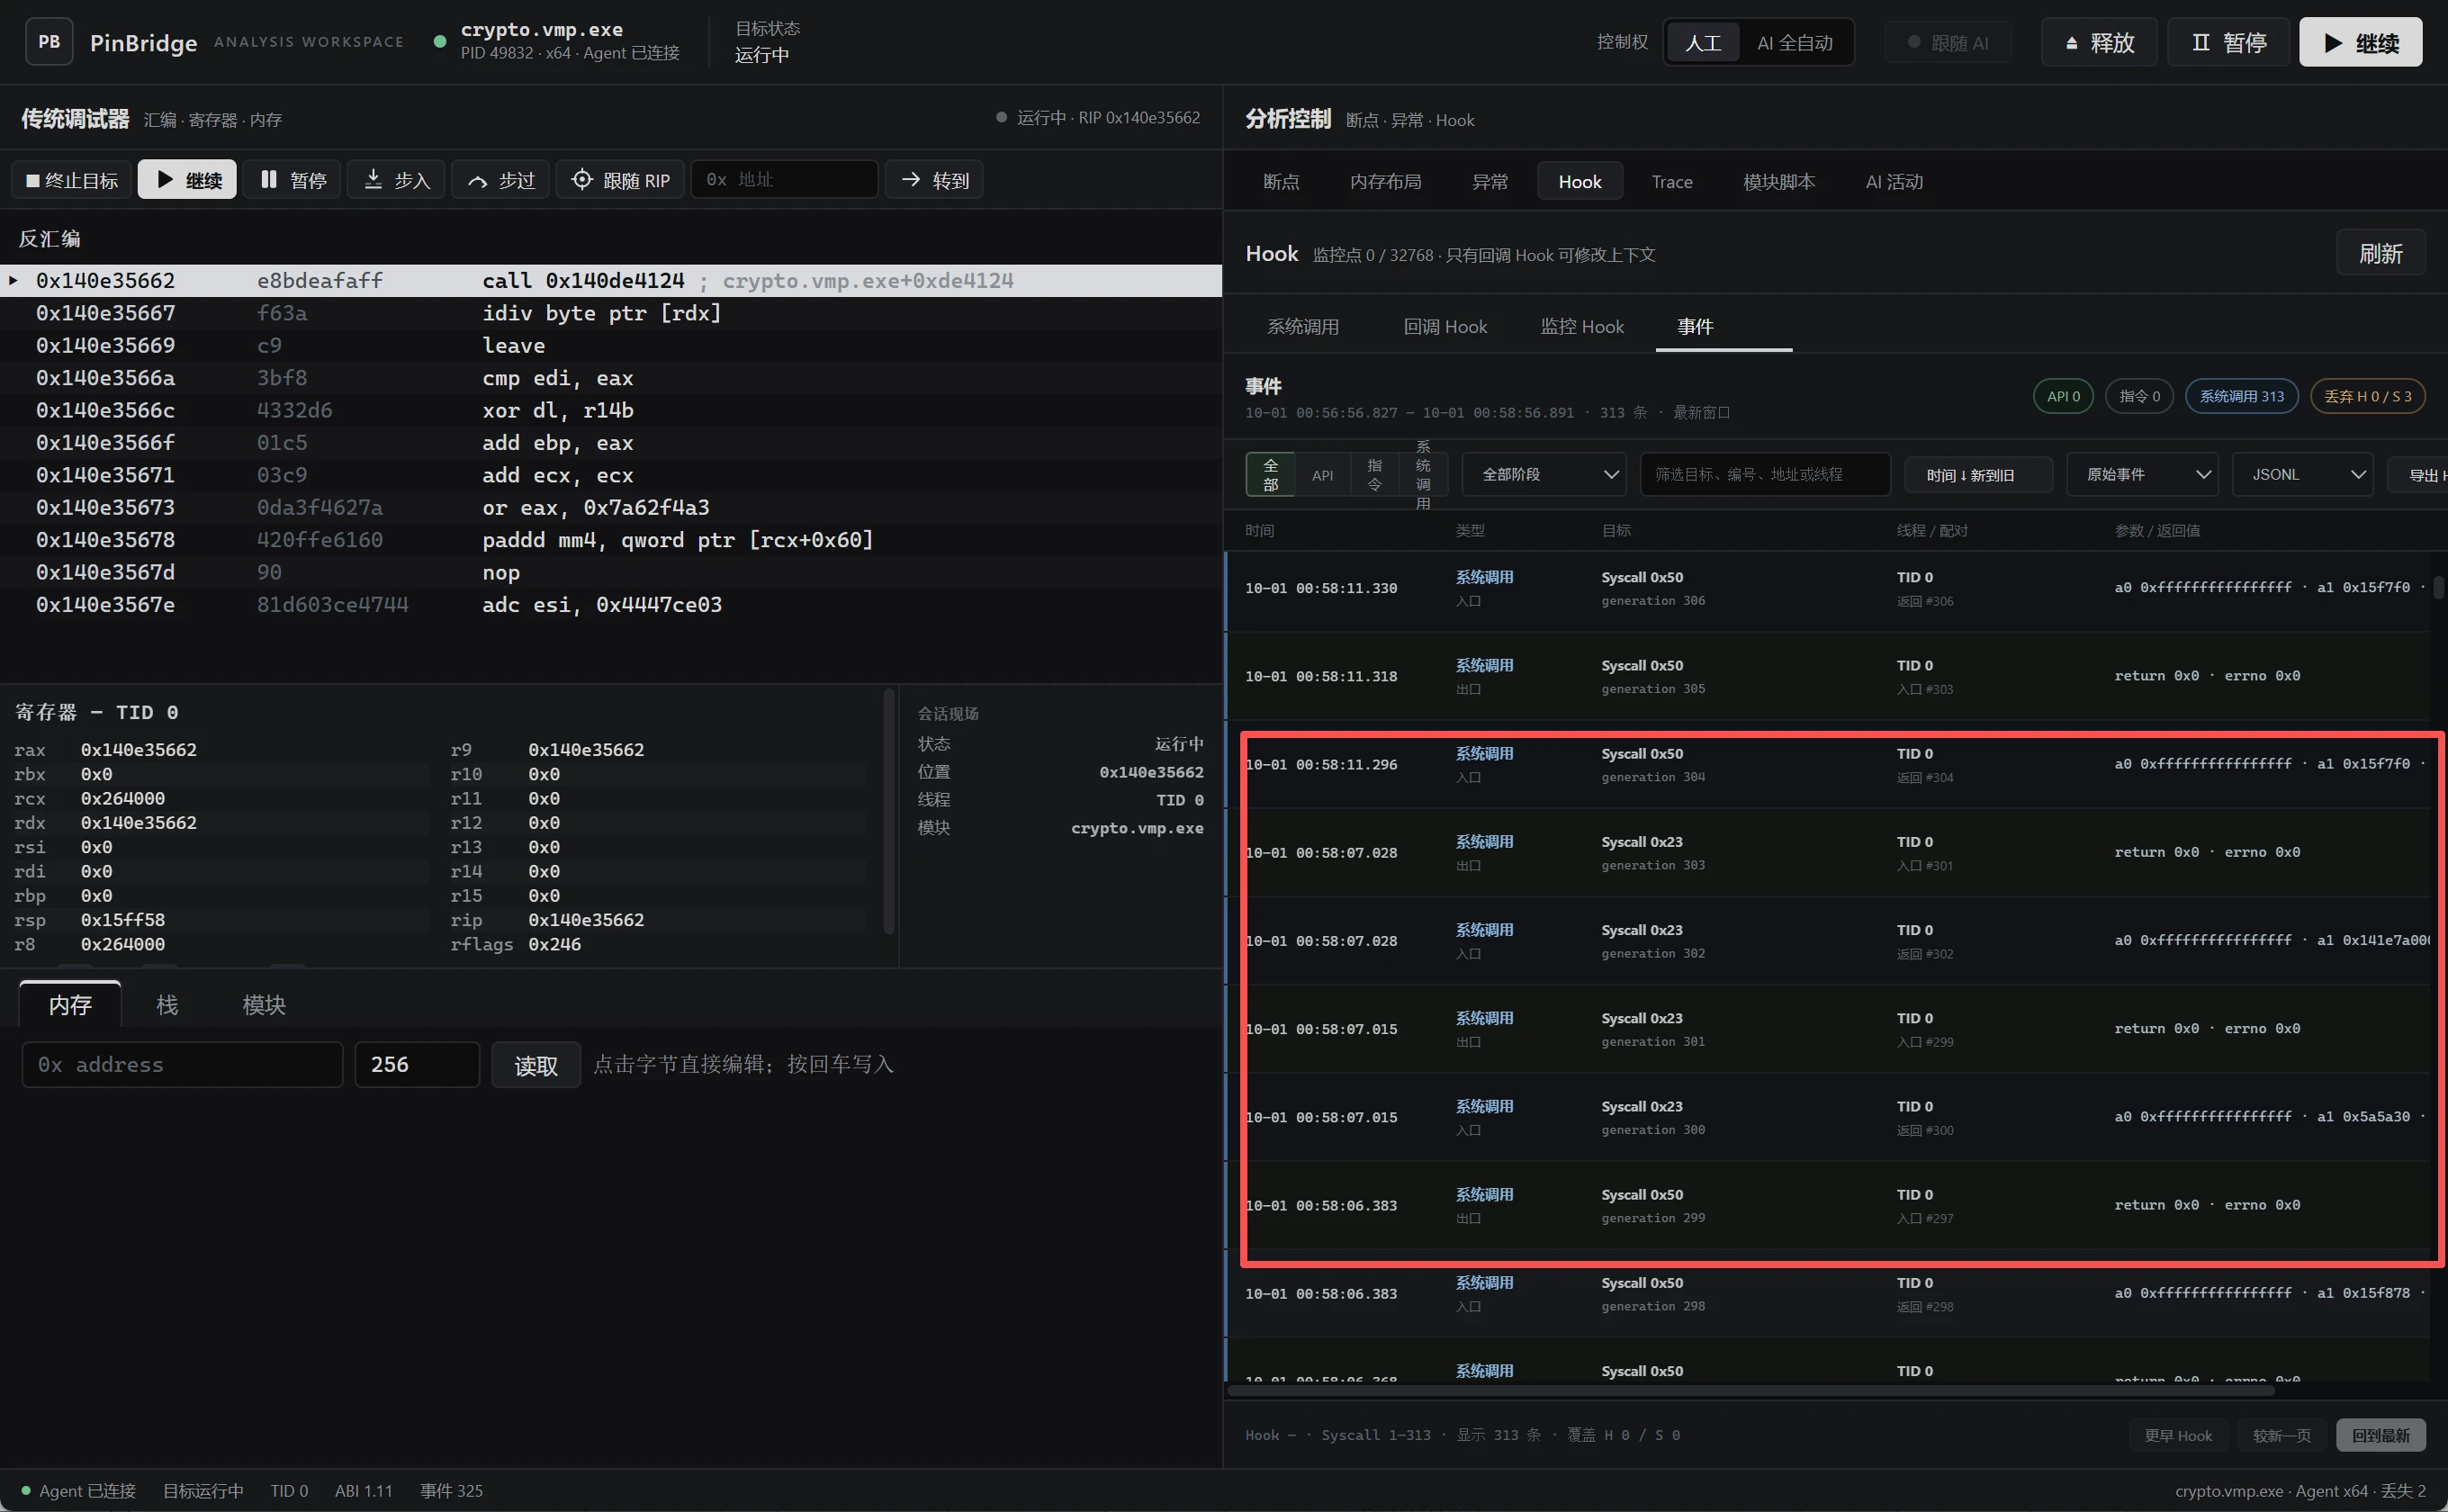
标准的自解压修改内存属性,绕过了系统调用


这样就可以利用这个信息进行外壳脱取了。当然功能太多了,这里就不展示了。整个KCTF Windows侧的分析我全部使用这个工具进行分析。
总结
第一次写博客是这种情况:写了又删,删了又写。有很多东西,代码实现,框架等等想说,但是突然觉得在AI时代没有意义了,哎。Hermes接入代码仓库扫描一下什么都有了所以这里就给个仓库地址。博客只能讲讲我对当前工具和AI融合适配的问题一些看法和解决思路。新时代AI技术面前,旧瓶装新酒有点装不下了。也是一次革命吧。也感谢您看到这里如果觉得我的工具对您有用或者,有什么好的想法可以评论区讨论,老样子还是不做任何限制有条件的可以帮忙点点赞。





