首页
课程
问答
CTF
社区
招聘
峰会
发现
排行榜
知识库
工具下载
看雪20年
看雪商城
证书查询
登录
注册
首页
社区
课程
招聘
发现
问答
CTF
排行榜
知识库
工具下载
峰会
看雪商城
证书查询
社区
逆向工程
发新帖
48
30
[原创]逆向手的锋刃:IDA Hook从入门到实战
发表于: 2026-4-26 19:17
13365
[原创]逆向手的锋刃:IDA Hook从入门到实战
S1nyer
1
2026-4-26 19:17
13365
# 逆向手的锋刃:IDA Hook从入门到实战 我第一次接触 IDA Hook,是从“我想在断点命中时自动打印某些信息”开始的,再往后会发现,Hook 真正的价值并不只是“输出些信息”,而是它能把调试器事件统一交给脚本处理 对逆向来说,这个能力很实用。很多题并不是静态分析做不动,而是你已经知道突破口在哪里,只是不想重复手点 50 次断点、手抄 40 次寄存器、手改 20 次内存这种机械工作。这个阶段,IDA Hook 往往就是最顺手的提速工具 这篇文章主要做四件事: 1. 把 IDA Hook 的概念和工作方式捋清 2. 讲清 `ida_dbg.DBG_Hooks` 这一套核心 API 怎么用 3. 给出一套可复用的 Hook 模板,并说明如何同时 Hook 多个函数且每个断点执行不同逻辑 4. 结合CTF题讲解实战运用技巧 --- ## IDA Hook 原理 IDA 里有很多种 Hook: - UI Hook:界面事件 - IDP Hook:处理器分析相关事件 - Hex-Rays Hook:反编译器事件 - Debugger Hook:调试器事件 逆向题里真正高频使用的,通常就是 Debugger Hook,也就是 `ida_dbg.DBG_Hooks` 它的工作方式可以简单理解成: ``` 调试器产生事件 -> IDA 派发事件 -> 你的 Hook 回调被调用 ``` 这些“事件”包括但不限于: - 进程启动 - 动态库加载 - 断点命中 - 单步结束 - 异常发生 - 进程退出 也就是说,你可以不再把调试看成“手工点 Continue 和 Step”,而是把它看成一套事件流 ### 为什么这对逆向有用 逆向里有很多高重复动作: - 每次命中某个函数入口,就看一遍参数 - 每次某个比较发生,就记下比较两边的值 - 每次状态机切换,就打印当前状态 - 每次过某个检查点,就 patch 某个寄存器或内存 这些动作手点当然能做,但非常浪费时间,也很容易抄错 Hook 的意义就在于把这些动作脚本化: ``` 命中断点 -> 自动读现场 -> 自动记录/修改 -> 自动继续运行 ``` 所以从逆向视角看,Hook 本质上就是三件事: 1. 等事件 2. 读现场 3. 改现场 这里的“现场”通常包括: - 寄存器 - 调试内存 - 调用栈 - 指令指针附近的代码与数据 这就是为什么很多 CTF 题里,Hook 往往不是“锦上添花”,而是直接把原本很蠢的重复劳动压缩成一个小脚本 --- ## IDA Hook 核心 API ### `ida_dbg.DBG_Hooks` 到底是什么 `DBG_Hooks` 是一个“调试器事件监听类”。最常见的写法是继承它,然后只实现你关心的回调 ```python import ida_dbg class MyHook(ida_dbg.DBG_Hooks): def dbg_bpt(self, tid, ea): print("hit bp at %#x" % ea) return 0 ``` 然后实例化并注册: ```python hook = MyHook() hook.hook() ``` 如果不再需要: ```python hook.unhook() ``` 从写脚本的角度看,最常用的成员其实就是下面这些 **`hook()` / `unhook()`** 这两个方法是整个类最基础的入口。 - `hook()`:把当前对象注册到 IDA 的调试事件分发器里 - `unhook()`:取消注册 一般来说,脚本最后都会有类似这样的代码: ```python try: hook.unhook() except Exception: pass hook = MyHook() hook.hook() ``` 这么写的原因很实际:你在 IDA 里反复执行脚本时,旧的 Hook 对象很可能还活着。如果不先 `unhook()`,就容易出现: - 同一个断点被多个旧回调同时处理 - 输出重复 - 旧逻辑还在后台继续报错 所以在调试阶段,“先卸旧 hook,再挂新 hook”几乎可以当成固定习惯 ### 最重要的回调:`dbg_bpt()` 这是最常用的回调,断点命中时会触发它: ```python def dbg_bpt(self, tid, ea): print("breakpoint hit at %#x" % ea) return 0 ``` 参数里: - `tid`:当前线程 ID - `ea`:命中的地址 通常你会在这个函数里做几件事: - 判断当前命中的断点是不是自己关心的那个 - 读寄存器 - 读调试内存 - 记录参数或状态 - 修改寄存器 / 内存 - 自动继续运行 很多 Hook 脚本,本质上就是围绕 `dbg_bpt()` 展开的 **其他高频回调** 除了 `dbg_bpt()`,比较常用的还有这些。 `dbg_process_start` 进程启动时触发。常见用途: - 初始化脚本状态 - 根据模块基址计算运行时断点 - 自动下断点 ```python def dbg_process_start(self, pid, tid, ea, name, base, size): print("process start, base = %#x" % base) return 0 ``` `dbg_process_exit` ```py def dbg_process_exit(self, pid, tid, ea, code): print("process exited with code: %d" % code) return 0 ``` 进程退出时触发,常见用途: - 汇总输出结果 - 打印恢复出的 flag / key / trace 如果你的脚本是“跑完整个程序,最后统一出结果”的类型,那 `dbg_process_exit()` 很适合做收尾 `dbg_library_load` 模块加载时触发,常见用途: - 等目标模块装载后再下断 - 处理延迟加载、动态加载场景 `dbg_exception` 异常发生时触发,常见用途: - 观察反调试逻辑 - 识别异常驱动控制流 - 自动忽略某些故意抛出的异常 **回调返回值怎么理解** 大多数情况下你会看到大家在回调末尾写: ```python return 0 ``` 对常规逆向脚本来说,这么写就够了。更重要的不是返回值本身,而是你在回调里是否显式调用了: ```python ida_dbg.request_continue_process() ida_dbg.run_requests() ``` 如果你调用了这组接口,程序就会在处理完当前事件后继续跑;否则它通常会停在当前事件点,等你手工操作 所以平时更应该关心的是: - 这个回调里我要不要自动继续 - 我要不要在这里停下来人工观察 而不是纠结某个回调到底该 `return 0` 还是别的值。 ### 自定义字段 `DBG_Hooks` 这个类本身最重要的不是它自带什么字段,而是你可以在子类实例上自由挂自己的状态 比如: ```python class Hook(ida_dbg.DBG_Hooks): def __init__(self): super().__init__() self.bp = 0x401000 self.out = [] self.hit_count = 0 self.done = False ``` 这些自定义字段在实际脚本里特别有用: - `self.bp`:保存关键断点地址 - `self.hit_count`:记录命中次数 - `self.out`:累计采样结果 - `self.done`:防止重复输出 - `self.handlers`:保存断点到处理函数的映射 也就是说,`DBG_Hooks` 本质上是“事件回调容器”,真正让脚本变好用的,是你自己附加的那层状态管理 ### `DBG_Hooks` 的正确使用习惯 实际写脚本时,我建议把 `DBG_Hooks` 当成一个“调度壳”,而不是把所有逻辑都塞进去 比较好的风格是: - `DBG_Hooks` 负责接事件 - `dbg_bpt()` 负责分发 - 真正的采样 / patch 逻辑放到独立 handler 里 这样脚本会更清晰,也更适合后期扩展 --- ### 配套的断点/内存/寄存器操作接口 `ida_dbg.DBG_Hooks` 只是 Hook 的入口,真正配合它一起用的通常还有下面几类接口 **增删断点** Hook 负责处理事件,断点负责制造事件。最常见的组合就是: ```python import idc idc.add_bpt(0x401000) idc.del_bpt(0x401000) ``` 如果目标开了 PIE / ASLR,通常不要直接拿静态地址下断,而是先算运行时地址 **操作寄存器** 读取/修改寄存器值非常常用: ```python import ida_dbg rax = ida_dbg.get_reg_val("RAX") rip = ida_dbg.get_reg_val("RDI") ida_dbg.set_reg_val("RAX", 0) ``` **内存读写** 这是动态分析脚本最核心的配套接口之一: ```python import ida_idd data = ida_idd.dbg_read_memory(ea, size) ida_idd.dbg_write_memory(ea, b"\x90\x90") ``` 配合 `struct.unpack` 很方便: ```python import struct u32 = struct.unpack("<I", ida_idd.dbg_read_memory(ea, 4))[0] u64 = struct.unpack("<Q", ida_idd.dbg_read_memory(ea, 8))[0] ``` 如果改了调试内存,最好刷新一下缓存: ```python ida_dbg.invalidate_dbgmem_contents(ea, size) ``` **自动继续** 如果你想让程序在处理完事件后自动继续跑,通常会写: ```python ida_dbg.request_continue_process() ida_dbg.run_requests() ``` 这组接口很适合“批量采样型脚本”,也就是你不希望程序每次命中都停下来等你点 Continue,而是希望它一路跑,把你要的数据全记下来 --- ## 一个最小可用示例 比如你只想在某个断点命中时打印 `RDI` 和 `RSI` ```python import ida_dbg import idc BP = 0x401234 class Hook(ida_dbg.DBG_Hooks): def dbg_bpt(self, tid, ea): if ea != BP: return 0 rdi = ida_dbg.get_reg_val("RDI") rsi = ida_dbg.get_reg_val("RSI") print("RDI = %#x, RSI = %#x" % (rdi, rsi)) ida_dbg.request_continue_process() ida_dbg.run_requests() return 0 hook = Hook() idc.add_bpt(BP) hook.hook() ``` 这个例子虽短,但已经完整体现了 Hook 的典型工作流: 1. 下断点 2. 命中断点 3. 读寄存器 4. 自动继续 很多逆向题的动态脚本,本质上都是在这个骨架上继续加逻辑 --- ## IDA Hook 模板 下面给一个比较通用的模板,适合做题时直接抄过去改 ```py import struct import idautils import ida_dbg import ida_idd import ida_segment import idc HOOK_RVA = 0x1234 moduleBase = 0 _read_memory = lambda ea, n: ida_idd.dbg_read_memory(ea, n) r_u8 = lambda ea: _read_memory(ea, 1)[0] r_u16 = lambda ea: struct.unpack("<H", _read_memory(ea, 2))[0] r_u32 = lambda ea: struct.unpack("<I", _read_memory(ea, 4))[0] r_u64 = lambda ea: struct.unpack("<Q", _read_memory(ea, 8))[0] _w = lambda ea, data: ida_idd.dbg_write_memory(ea, data) w_u8 = lambda ea, x: _w(ea, struct.pack("<B", x & 0xFF)) w_u16 = lambda ea, x: _w(ea, struct.pack("<H", x & 0xFFFF)) w_u32 = lambda ea, x: _w(ea, struct.pack("<I", x & 0xFFFFFFFF)) w_u64 = lambda ea, x: _w(ea, struct.pack("<Q", x & 0xFFFFFFFFFFFFFFFF)) invalidate_cache = lambda ea, size: ida_dbg.invalidate_dbgmem_contents(ea, size) rebase = lambda ea : moduleBase+ea get_reg = lambda reg_name: ida_dbg.get_reg_val(reg_name) set_reg = lambda reg_name, val: ida_dbg.set_reg_val(reg_name, val) def get_main_module_base(): """获取主模块基址(通常为模块列表的第一个)""" module = idautils.Modules().__next__() print(f"[*] Main module: {module.name} at {module.base:#x}") return module.base class Hook(ida_dbg.DBG_Hooks): def __init__(self): super().__init__() self.bp = rebase(HOOK_RVA) self.hit_count = 0 def dbg_bpt(self, tid, ea): if ea != self.bp: return 0 rax = get_reg("RAX") rdi = get_reg("RDI") self.hit_count += 1 print("rax = %#x, rdi = %#x" % (rax, rdi)) ida_dbg.request_continue_process() ida_dbg.run_requests() return 0 def dbg_process_exit(self, pid, tid, ea, code): print("Total hit count -> %d" % self.hit_count) return 0 try: idc.del_bpt(hook.bp) hook.unhook() except Exception: pass moduleBase = get_main_module_base() hook = Hook() idc.add_bpt(hook.bp) hook.hook() print("bp = %#x" % hook.bp) ``` 这个模板实际做题时只用改两处: - `HOOK_RVA` - `dbg_bpt()` 里的处理逻辑 它很适合用来做: - 参数采样 - 状态变量观察 - VM 解释器 Hook - 批量 patch 检查点 --- ## 多断点处理 多断点处理是实际写脚本时非常常见的问题,很多人一开始只会写单断点脚本,比如: ```py if ea == bp1: ... ``` 但如果目标变成: - `func_a` 入口记录参数 - `func_b` 中间 patch 某个检查 - `func_c` 返回前打印结果 如果还是把所有逻辑都堆在一个 `if/elif/elif` 里,脚本很快就会变乱 这里介绍两种常见的处理方式 ### 一:最直接的 if-elif 适合断点少且处理逻辑简单的时候 ```python class Hook(ida_dbg.DBG_Hooks): def __init__(self): super().__init__() self.bp_a = 0x401000 self.bp_b = 0x402000 def dbg_bpt(self, tid, ea): if ea == self.bp_a: self.handle_a() elif ea == self.bp_b: self.handle_b() else: return 0 ida_dbg.request_continue_process() ida_dbg.run_requests() return 0 ``` 优点是简单直接。缺点也很明显:断点一多就开始失控。 ### 二:“地址 -> 处理函数”映射表 这是最推荐的通用写法。 思路是把每个断点和它的处理函数绑定起来: ```python class Hook(ida_dbg.DBG_Hooks): def __init__(self): super().__init__() self.handlers = { 0x401000: self.handle_func_a, 0x402000: self.handle_func_b, 0x403000: self.handle_func_c, } def dbg_bpt(self, tid, ea): fn = self.handlers.get(ea) if fn is not None: fn() else: return 0 ida_dbg.request_continue_process() ida_dbg.run_requests() return 0 def handle_func_a(self): rdi = ida_dbg.get_reg_val("RDI") print("func_a arg =", hex(rdi)) def handle_func_b(self): print("patch func_b check") def handle_func_c(self): print("func_c hit") ``` 这种写法的好处很明显: - 结构清楚 - 每个断点逻辑互相独立 - 后面新增断点时只要往字典里塞一个映射 如果你的脚本断点多且断点后要处理的逻辑比较复杂,建议用这种写法 ## 注意事项 多断点脚本要处理好以下几点: * 统一管理运行时地址。 如果目标开了 PIE,最好不要把一堆绝对地址散落在脚本里,而是统一按 `base + rva` 组织 * 每个 handler 尽量只做一件事 让 `dbg_bpt()` 只负责分发,真正的采样和 patch 逻辑放到独立函数里,后面维护会轻松很多 * 注意旧 Hook 残留 反复执行脚本时,如果旧的 `DBG_Hooks` 对象还活着,就容易出现重复输出和旧逻辑继续报错 其次,建议大家遵循下面的编码规范 ```py def dbg_bpt(self, tid, ea): if ea == self.bp_a: self.handle_a() elif ea == self.bp_b: self.handle_b() else: return 0 ida_dbg.request_continue_process() ida_dbg.run_requests() return 0 def dbg_bpt(self, tid, ea): fn = self.handlers.get(ea) if fn is not None: fn() else: return 0 ida_dbg.request_continue_process() ida_dbg.run_requests() return 0 ``` 在上面的回调实现中,对于脚本未主动处理的断点(即不在自动化逻辑内的断点),统一直接 `return 0` 这样处理的好处是:当我们在动态调试过程中**手动设置临时断点**,想逐步跟进某个函数的内部实现时,命中断点后 IDA 会**暂停而不是自动继续**。反之,如果回调对所有断点都一律调用 `request_continue_process()`,那么手动断点也会被自动恢复执行,就失去了手动调试的机会 --- ## IDA Hook 实战 这里用一道VM题做示例,因为VM题静态分析通常是比较费时的,这里讲怎么利用Hook技术来提速 题目链接:<mark class="encrypted">3d4K9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6K6K9r3q4J5k6g2)9J5k6i4N6W2K9i4W2#2L8W2)9J5k6h3y4G2L8g2)9J5c8W2W2T1y4U0V1I4b7@1N6#2</mark> 开头是用户输入key,输入长度不足42则用`\0`补齐,可以知道flag长度为42 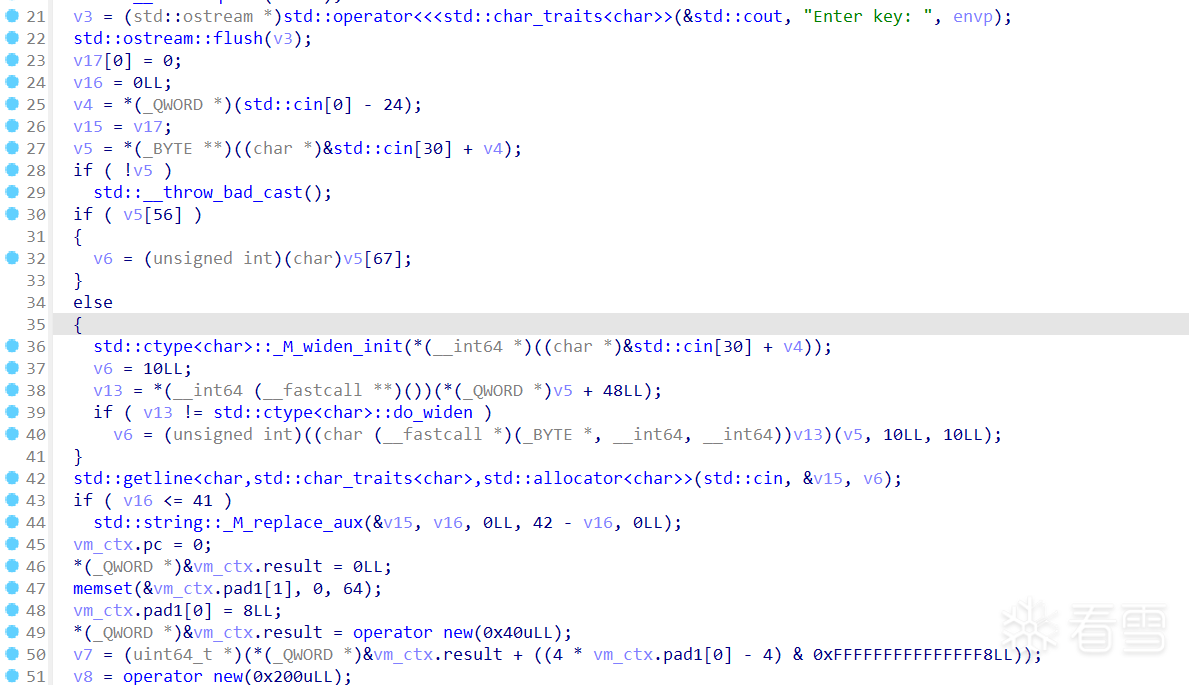 然后是`do-while`结构的`interpreter`,程序会把`.vmp`段的数据作为VM字节码执行 ```c v9 = 16LL; regs = vm_ctx.regs; vm_ctx.code_len = 0x7AELL; while ( v9 ) { *regs++ = 0; --v9; } vm_ctx.code = (uint8_t *)&unk_5D2AA7E12040; *(_QWORD *)&vm_ctx.pc = 0xFFC00000000LL; std::string::_M_assign(&vm_ctx.input, &v15); vm_ctx.running = 1; vm_ctx.input_cur = 0LL; do { if ( vm_ctx.pc >= vm_ctx.code_len ) break; interpreter(&vm_ctx); } while ( vm_ctx.running ); v11 = vm_ctx.regs[15] != 1; ``` > 这里是根据伪代码稍微分析了一下VM结构体,实际上用hook的思路不怎么需要分析 经常写VM题的同学可能知道,很多VM题都是套一层VM解释器但实际上算法并不复杂~~(通常是杂鱼异或 ~~ 所以我们可以先定位到一些关键的指令实现。比如:异或、比较 这两个指令还是比较好找的,分别是opcode `0x4e`和`0x6b`分支 **xor** 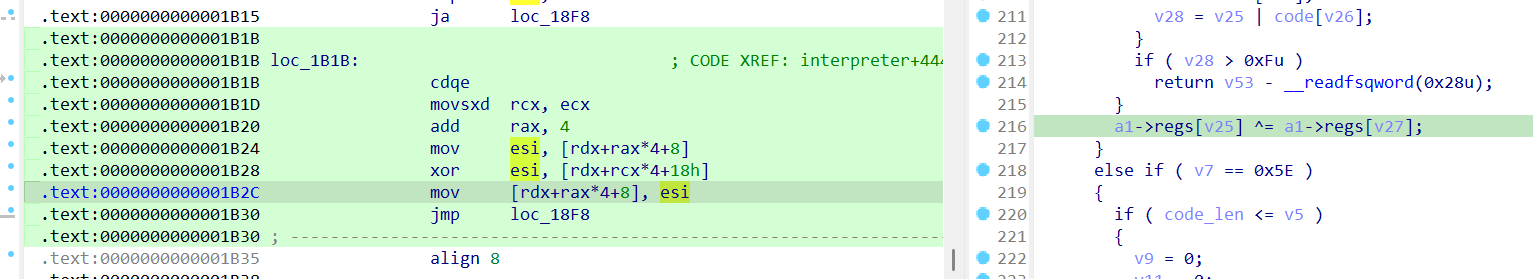 **cmp** 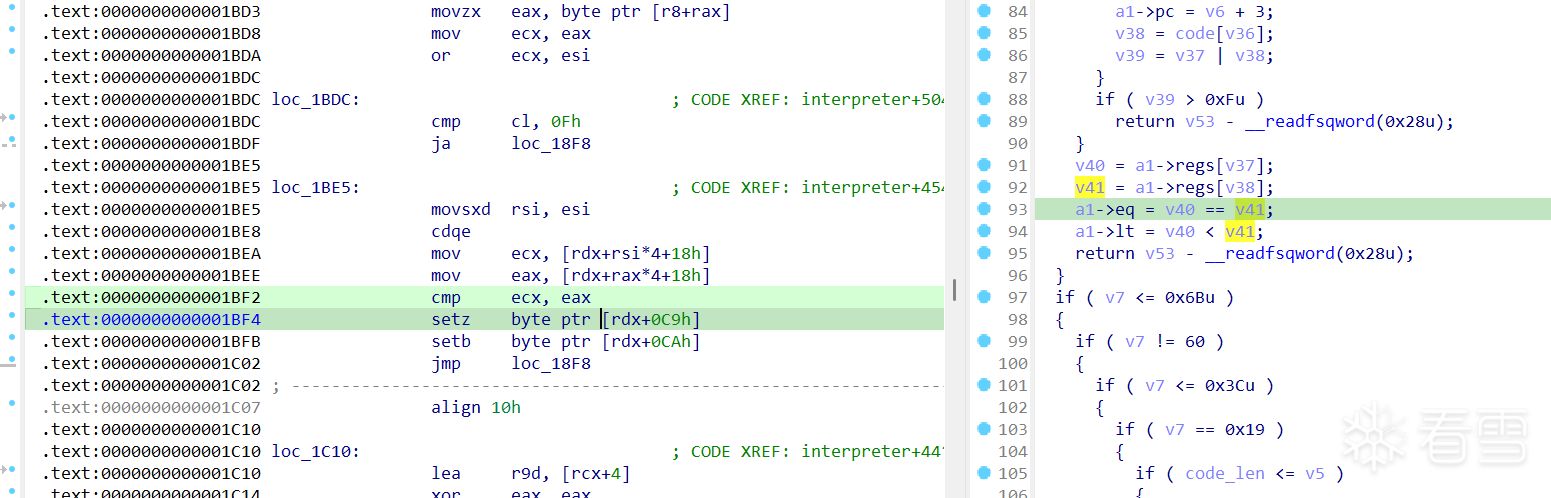 接下来写个Hook脚本判断一下是不是简单的单字节异或,这里用到的就是我们之前给出的Hook模板 ```py import struct import idautils import ida_dbg import ida_idd import ida_segment import idc moduleBase = 0 _read_memory = lambda ea, n: ida_idd.dbg_read_memory(ea, n) r_u8 = lambda ea: _read_memory(ea, 1)[0] r_u16 = lambda ea: struct.unpack("<H", _read_memory(ea, 2))[0] r_u32 = lambda ea: struct.unpack("<I", _read_memory(ea, 4))[0] r_u64 = lambda ea: struct.unpack("<Q", _read_memory(ea, 8))[0] _w = lambda ea, data: ida_idd.dbg_write_memory(ea, data) w_u8 = lambda ea, x: _w(ea, struct.pack("<B", x & 0xFF)) w_u16 = lambda ea, x: _w(ea, struct.pack("<H", x & 0xFFFF)) w_u32 = lambda ea, x: _w(ea, struct.pack("<I", x & 0xFFFFFFFF)) w_u64 = lambda ea, x: _w(ea, struct.pack("<Q", x & 0xFFFFFFFFFFFFFFFF)) invalidate_cache = lambda ea, size: ida_dbg.invalidate_dbgmem_contents(ea, size) rebase = lambda ea : moduleBase+ea get_reg = lambda reg_name: ida_dbg.get_reg_val(reg_name) set_reg = lambda reg_name, val: ida_dbg.set_reg_val(reg_name, val) def get_main_module_base(): module = idautils.Modules().__next__() print(f"[*] Main module: {module.name} at {module.base:#x}") return module.base class Hook(ida_dbg.DBG_Hooks): def __init__(self): super().__init__() self.bp_cmp = rebase(0x1BF2) self.bp_xor = rebase(0x1B28) self.hita = 0 self.hitb = 0 def dbg_bpt(self, tid, ea): if ea == self.bp_cmp: self.hita += 1 elif ea == self.bp_xor: self.hitb += 1 else: return 0 ida_dbg.request_continue_process() ida_dbg.run_requests() return 0 def dbg_process_exit(self, pid, tid, ea, code): print("[*] cmp hit count -> %d" % self.hita) print("[*] xor hit count -> %d" % self.hitb) return 0 try: hook.unhook() idc.del_bpt(hook.bp_cmp) idc.del_bpt(hook.bp_xor) except Exception: pass moduleBase = get_main_module_base() hook = Hook() idc.add_bpt(hook.bp_cmp) idc.add_bpt(hook.bp_xor) hook.hook() print("[*] cmp breakpoint = %#x" % hook.bp_cmp) print("[*] xor breakpoint = %#x" % hook.bp_xor) ``` 挂上调试器,这里给个建议,有些题目的调试可以开启`在程序入口断点`这个选项 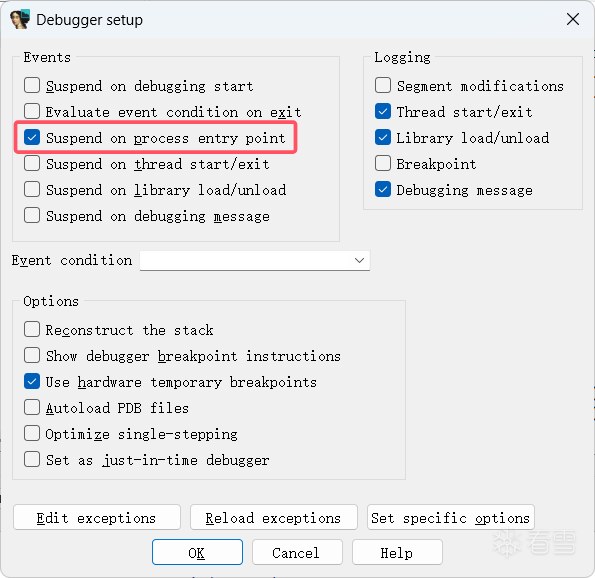 运行脚本,然后在linux调试端随便输点文本,得到回显 ``` [*] Main module: /home/s1nyer/IDAdebug/IDA8.3/challenge at 0x5613b760c000 [*] cmp breakpoint = 0x5613b760dbf2 [*] xor breakpoint = 0x5613b760db28 Debugger: process has exited (exit code 1) [*] cmp hit count -> 43 [*] xor hit count -> 42 ``` 很好,程序进行了42次异或运算,和flag长度一致,符合预期;但为什么比较指令比异或多执行了一次呢?Oh!可以猜到程序在密文比对完毕后肯定要根据某个标志位来判断是否匹配,从而进入成功/失败分支,类似于下面: ```c if (matched) goto success; else goto failed; ``` 当然直接这么判断可能有点经验主义了,我们改一下`dbg_bpt`调试回调逻辑再重新调试 ```py def dbg_bpt(self, tid, ea): if ea == self.bp_cmp: self.hita += 1 print("[*] cmp hitted %d" % self.hita) elif ea == self.bp_xor: self.hitb += 1 print("[*] xor hitted %d" % self.hitb) else: return 0 #ida_dbg.request_continue_process() #ida_dbg.run_requests() return 0 ``` 在每次断点命中时,输出是哪个指令命中了,并注释掉了它自动`continue`的代码,由我们手动控制,然后就能在IDA输出窗口顺序看到 ``` [*] Main module: /home/s1nyer/IDAdebug/IDA8.3/challenge at 0x651d75bfc000 [*] cmp breakpoint = 0x651d75bfdbf2 [*] xor breakpoint = 0x651d75bfdb28 [*] xor hitted 1 [*] cmp hitted 1 [*] xor hitted 2 [*] cmp hitted 2 [*] xor hitted 3 ...... ``` 可以看到是先`xor`再`cmp`并且两者是交替进行(这里如果读者手动操作体验就更明显了 我们再把注释掉的自动继续代码还原,让它一路跑完,可以得到下面输出 ``` [*] xor hitted 41 [*] cmp hitted 41 [*] xor hitted 42 [*] cmp hitted 42 [*] cmp hitted 43 // 多出的那次比较 Debugger: process has exited (exit code 1) [*] cmp hit count -> 43 [*] xor hit count -> 42 ``` 这个输出就完全印证我们关于VM算法流程的猜想了,接下来我们完善这个脚本,把xor和cmp的右值提取出来就OK啦!(完整代码就不贴了,上核心代码) ```py class Hook(ida_dbg.DBG_Hooks): def __init__(self): super().__init__() self.bp_cmp = rebase(0x1BF2) self.bp_xor = rebase(0x1B28) self.enc = b"" self.key = b"" self.hita = 0 self.hitb = 0 def dbg_bpt(self, tid, ea): if ea == self.bp_cmp: ctx = get_reg("RDX") eax = get_reg("EAX") self.enc += (eax & 0xff).to_bytes(1) print("[*] enc[%d] = %x" % (self.hita, eax & 0xff)) self.hita += 1 elif ea == self.bp_xor: rdx = get_reg("RDX") self.key += r_u8(rdx + 0x18 + 11 * 4).to_bytes(1) print("[*] key[%d] = %x" % (self.hitb, self.key[self.hitb])) self.hitb += 1 else: return 0 if len(self.key) == 42 and len(self.enc) == 42 : print("[+] key -> %s" % self.key.hex()) print("[+] enc -> %s" % self.enc.hex()) return 0 ida_dbg.request_continue_process() ida_dbg.run_requests() return 0 def dbg_process_exit(self, pid, tid, ea, code): print("[*] cmp hit count -> %d" % self.hita) print("[*] xor hit count -> %d" % self.hitb) return 0 try: hook.unhook() idc.del_bpt(hook.bp_cmp) idc.del_bpt(hook.bp_xor) except Exception: pass moduleBase = get_main_module_base() hook = Hook() idc.add_bpt(hook.bp_cmp) idc.add_bpt(hook.bp_xor) hook.hook() print("[*] cmp breakpoint = %#x" % hook.bp_cmp) print("[*] xor breakpoint = %#x" % hook.bp_xor) ``` 输出如下: ``` ...... [*] key[38] = 7 [*] enc[38] = 33 [*] key[39] = 17 [*] enc[39] = 22 [*] key[40] = 18 [*] enc[40] = 2e [*] key[41] = 3a [*] enc[41] = 47 [+] key -> 6cb47cfc07962a92603fe9b4bae75430c9d3ecfa0c3276711f65ef5944aaca18609cf602c6360717183a [+] enc -> 08d50e887cae1af050078880d9ca6d56adeac1ce3e00155c7d54de6e699af87954ffce3aa00533222e47 ``` 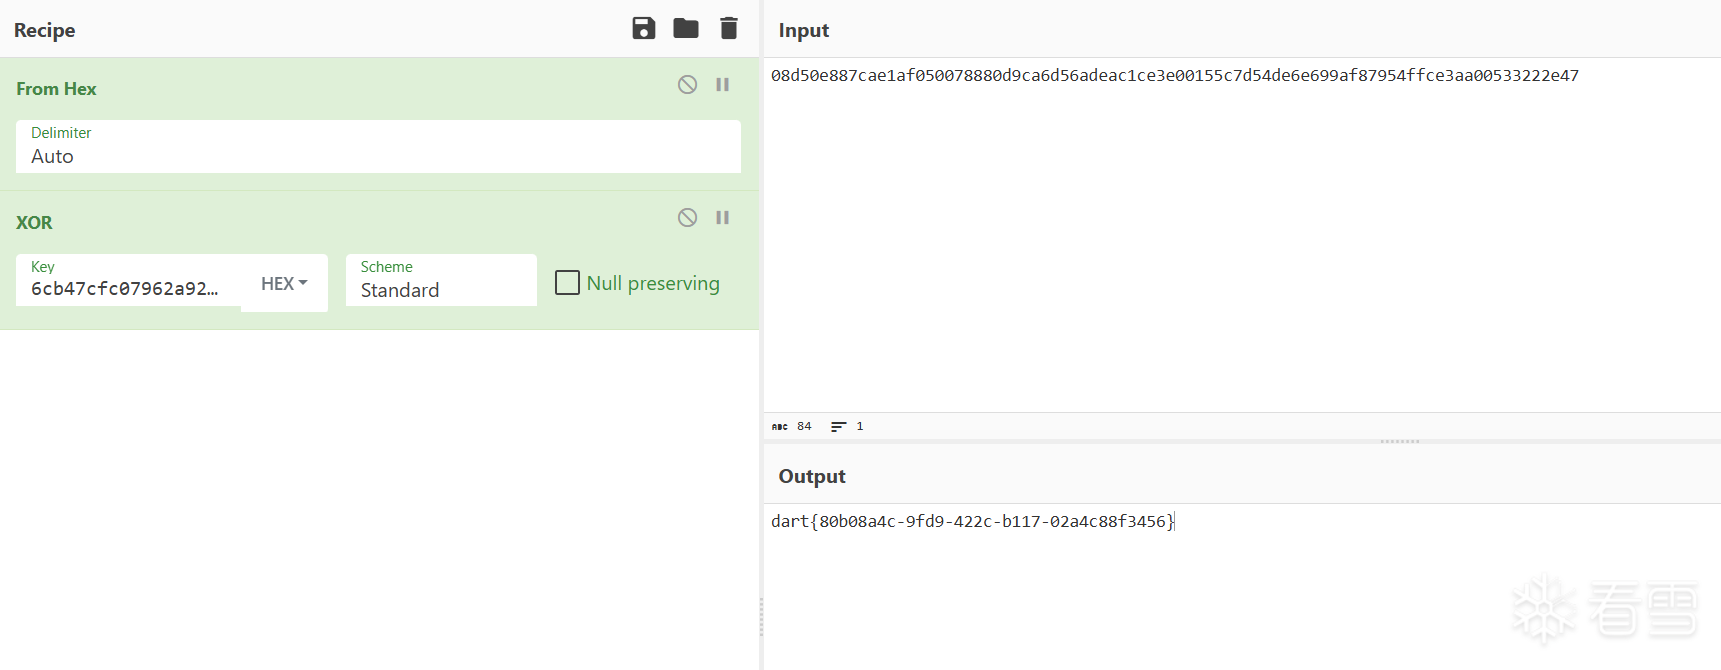 当然这个例子只是抛砖引玉,从这个模板出发,下面这些它都能做到 - 观察函数参数和返回值 - 批量追踪状态机 / 分支切换 - 修改函数参数并批量测试 - 记录循环中每轮的关键状态 - 在关键比较点取现场值 - 自动 patch 某类检查点 - 做轻量级 trace,而不是全程手动跟 - ······ 它不一定适合所有题,但一旦进入“我已经知道关键点在哪,只是懒得手搓”的阶段,Hook 基本就是性价比最高的方案 --- ## 总结 IDA Hook 不是一个高级但冷门的技巧,它本质上是把调试器事件变成脚本入口 如果把手工调试看成:**观察 + 记录 + 修改** 那么 Hook 做的事情就是把这三件事:自动化、批量化、事件驱动化 对逆向来说,最值得记住的一点是这个思路: **Hook 的核心不是“自动下断”,而是“在事件发生的瞬间接管现场”** 一旦你习惯了这种思路,很多原本需要手点很多次的动态分析过程,都会自然地变成一个简洁的批处理脚本
登录后可查看完整内容
传递专业知识、拓宽行业人脉——看雪讲师团队等你加入!!
最后于
2026-4-27 12:16 被S1nyer编辑 ,原因: 修改几处笔误,优化文章结构,完善注意事项
#调试逆向
收藏
・
48
点赞
・
30
打赏
分享
分享到微信
分享到QQ
分享到微博
赞赏记录
参与人
雪币
留言
时间
skylake_core
感谢你分享这么好的资源!
2026-9-7 17:24
wx_晨梦
期待更多优质内容的分享,论坛有你更精彩!
2026-7-16 05:37
hackroad
这个讨论对我很有帮助,谢谢!
2026-6-19 17:02
曹无咎
你的分享对大家帮助很大,非常感谢!
2026-5-26 16:04
海峰无敌
谢谢你的细致分析,受益匪浅!
2026-5-13 23:18
hsanren
+1
你的帖子非常有用,感谢分享!
2026-5-11 10:27
离人怎挽
感谢你的贡献,论坛因你而更加精彩!
2026-5-6 17:33
mb_jczrphjk
你的帖子非常有用,感谢分享!
2026-5-4 12:21
x_req
你的分享对大家帮助很大,非常感谢!
2026-5-2 19:59
程序原
期待更多优质内容的分享,论坛有你更精彩!
2026-5-2 05:54
边缘
你的帖子非常有用,感谢分享!
2026-4-30 13:08
樂夜无殇
感谢你的积极参与,期待更多精彩内容!
2026-4-30 09:32
lrhtony
这个讨论对我很有帮助,谢谢!
2026-4-30 00:41
pexillove
非常支持你的观点!
2026-4-28 19:10
需要渗透高手
你的分享对大家帮助很大,非常感谢!
2026-4-28 16:57
andy张刘
为你点赞!
2026-4-28 13:26
asdll
这个讨论对我很有帮助,谢谢!
2026-4-28 08:53
mb_vlzxhmta
你的帖子非常有用,感谢分享!
2026-4-27 20:44
wx_让我来,蟹蟹
你的分享对大家帮助很大,非常感谢!
2026-4-27 17:56
马来
感谢你分享这么好的资源!
2026-4-27 14:21
OneMoreThing
为你点赞!
2026-4-27 13:11
零_721409
你的帖子非常有用,感谢分享!
2026-4-27 12:02
cr_lgdx
感谢你的贡献,论坛因你而更加精彩!
2026-4-27 11:27
Dy1an
+1
为你点赞!
2026-4-27 09:35
我的小拇指啊
期待更多优质内容的分享,论坛有你更精彩!
2026-4-27 02:07
nevinhappy
+1
这个讨论对我很有帮助,谢谢!
2026-4-26 23:24
yuanyouran
+1
期待更多优质内容的分享,论坛有你更精彩!
2026-4-26 21:43
SYearn
+10
谢谢你的细致分析,受益匪浅!
2026-4-26 20:53
梧桐生
你的分享对大家帮助很大,非常感谢!
2026-4-26 19:45
及桥
期待更多优质内容的分享,论坛有你更精彩!
2026-4-26 19:40
查看更多
赞赏
×
1 雪花
5 雪花
10 雪花
20 雪花
50 雪花
80 雪花
100 雪花
150 雪花
200 雪花
支付方式:
微信支付
赞赏留言:
快捷留言
感谢分享~
精品文章~
原创内容~
精彩转帖~
助人为乐~
感谢分享~
最新回复
(
10
)
wx_Huber Barrientos
雪 币:
0
能力值:
( LV1,RANK:0 )
在线值:
发帖
0
回帖
212
粉丝
1
关注
私信
wx_Huber Barrientos
2
楼
感谢分享
2026-4-27 03:03
0
靴子
雪 币:
20
活跃值:
(1680)
能力值:
( LV2,RANK:10 )
在线值:
发帖
19
回帖
565
粉丝
1
关注
私信
靴子
3
楼
感谢分享
2026-4-27 08:50
0
pxhb
雪 币:
8223
活跃值:
(7431)
能力值:
( LV7,RANK:110 )
在线值:
发帖
11
回帖
432
粉丝
24
关注
私信
pxhb
2
4
楼
收藏
2026-4-27 11:34
0
fengyunabc
雪 币:
5386
活跃值:
(6187)
能力值:
( LV4,RANK:50 )
在线值:
发帖
11
回帖
632
粉丝
27
关注
私信
fengyunabc
1
5
楼
感谢分享。
2026-4-27 12:30
0
院士
雪 币:
7164
活跃值:
(7669)
能力值:
( LV2,RANK:10 )
在线值:
发帖
0
回帖
262
粉丝
5
关注
私信
院士
6
楼
厉害,感谢分享。
2026-4-27 15:08
0
PPTV
雪 币:
11442
活跃值:
(4562)
能力值:
( LV2,RANK:10 )
在线值:
发帖
4
回帖
217
粉丝
0
关注
私信
PPTV
7
楼
感谢分享
2026-4-27 17:44
0
Imxz
雪 币:
112
活跃值:
(9435)
能力值:
( LV2,RANK:10 )
在线值:
发帖
6
回帖
754
粉丝
9
关注
私信
Imxz
8
楼
tql
2026-4-28 10:41
0
需要渗透高手
雪 币:
114
活跃值:
(280)
能力值:
( LV2,RANK:10 )
在线值:
发帖
0
回帖
42
粉丝
1
关注
私信
需要渗透高手
9
楼
谢谢
2026-4-28 16:57
0
kienmanowa
雪 币:
33
活跃值:
(2188)
能力值:
( LV2,RANK:10 )
在线值:
发帖
0
回帖
35
粉丝
0
关注
私信
kienmanowa
10
楼
谢谢
2026-4-28 21:38
0
dayDReam_10
雪 币:
214
能力值:
( LV1,RANK:0 )
在线值:
发帖
1
回帖
13
粉丝
2
关注
私信
dayDReam_10
11
楼
可以
2026-8-22 18:09
0
游客
登录
|
注册
方可回帖
回帖
表情
雪币赚取及消费
高级回复
返回
S1nyer
1
4
发帖
1
回帖
60
RANK
关注
私信
他的文章
[原创]cclibc:一个强大的CTF Glibc环境管理工具
582
[原创]第二届软件系统安全赛决赛 StudentManagement 详解
5748
[原创]逆向手的锋刃:IDA Hook从入门到实战
13365
[原创]第二届软件系统安全赛 robo_admin 题解
6234
关于我们
联系我们
企业服务
看雪公众号
专注于PC、移动、智能设备安全研究及逆向工程的开发者社区
看原图
赞赏
×
雪币:
+
留言:
快捷留言
为你点赞!
返回
顶部