-
-
[原创]Pwn栈溢出漏洞原理——栈&栈帧的结构讲解
-
发表于: 1天前 102
-


0x00【前言】
栈溢出是最经典的内存破坏漏洞,也是Pwn的入门第一课,很多教程直接甩一个栈布局图,但是有一个疑问一直困扰新手:既然old_ebp保存了上一层栈帧的基址,函数返回的时候pop ebp就能切回到上一层栈,那我们为什么还需要返回地址ret_addr呢?
我将用一段简单的C++代码,跟着函数调用流程,一步步拆解栈,栈帧,ebp,ret指令,最后讲清楚栈溢出漏洞是怎么发生的。
重要前置知识点:Linux用户态栈从高地址向低地址增长,但是C语言数组缓冲区写入是从低地址向高地址填充,这是栈溢出能够发生的根源。
0x01【栈&栈帧是什么】
进程的内存空间里,栈是一块专门用来支撑函数调用的内存区域,保存局部变量、参数函数返回上下文。
栈:整块大内存,先进后出,向下增长(esp/rsp变小)
栈帧:每一次函数调用,都会在栈上开辟一块独立的内存区域,就是栈帧。函数执行完毕,栈帧销毁。
我们编写一段简单的C++代码:
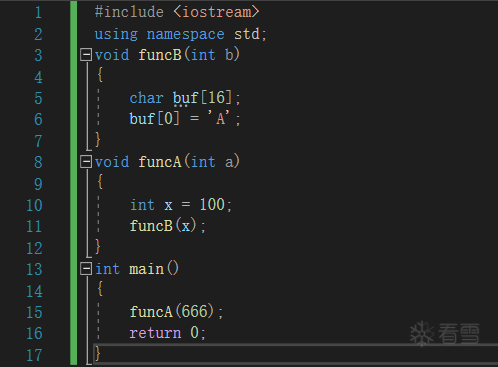
调用链main-->funcA-->funcB,栈帧在内存里叠放顺序(高地址-->低地址):main栈帧-->funcA栈帧-->funcB栈帧
当前正在执行funcB,我们操作的就是funcB的栈帧。
栈帧由两个寄存器框定:
ebp:栈基址,栈帧的锚点(高地址一侧,进入函数后固定不变)
esp:栈顶指针(低地址一侧,会动态变化)
调用链路:main()-->funcA(666)-->funcB(100)
main里执行funcA(666)
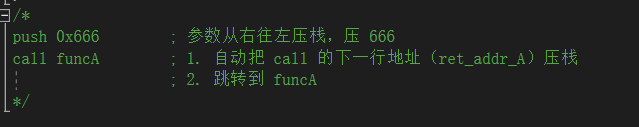
此时栈上多了ret_addr_A,这个地址是main中call funcA之后的那条指令地址,funcA跑完ret就要回到这里
进入funcA,执行
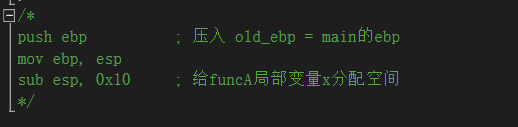
funcA的栈帧布局:
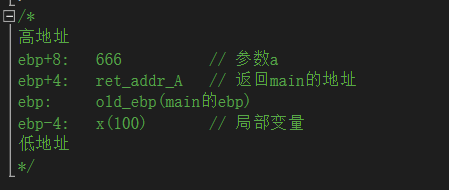
funcA内部执行funcB(x)
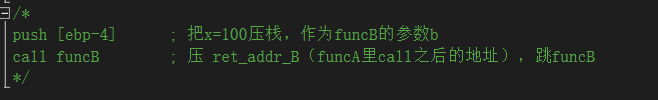
进入funcB(当前最内层栈帧)
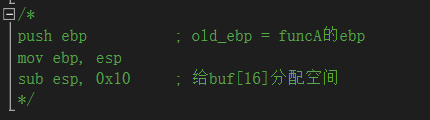
funcB栈帧布局:
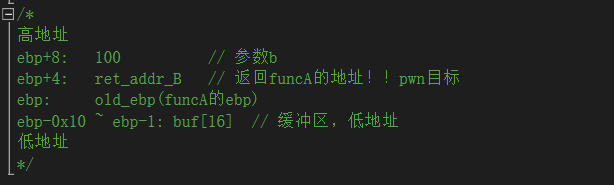
现在funcB再跑buf[0]='A'
funcB执行到末尾,准备return
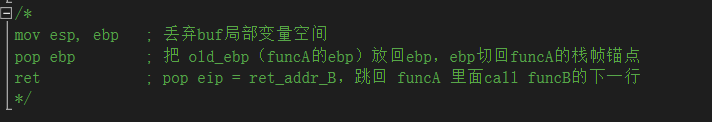
现在回到funcA继续运行
funcA跑完,同样准备return
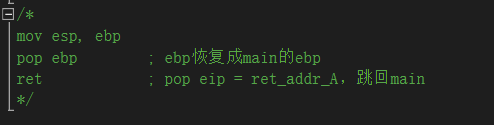
回到main
main最后return,程序结束
ebp的作用
每进一个函数,保存上层ebp(old_ebp)到栈上,形成链表funcB-->funcA-->main
固定标尺:不管esp怎么浮动,参数、局部变量都用ebp+偏移地址访问
函数返回时,pop ebp恢复上一层函数的栈基址,调试器栈回溯bt就是靠这条链
如果这条链断了(old_ebp被溢出覆盖),bt就乱掉,返回后栈错乱,不一定立刻崩溃
ret指令的作用
从栈上取出提前存好的ret_addr,赋值给eip
把程序流切回调用方,也就是call后面的代码
ret_addr一旦被我们覆盖,ret的时候eip就被控制,这就是栈溢出的核心
0x02【栈的结构】
接下来看一下栈的结构:
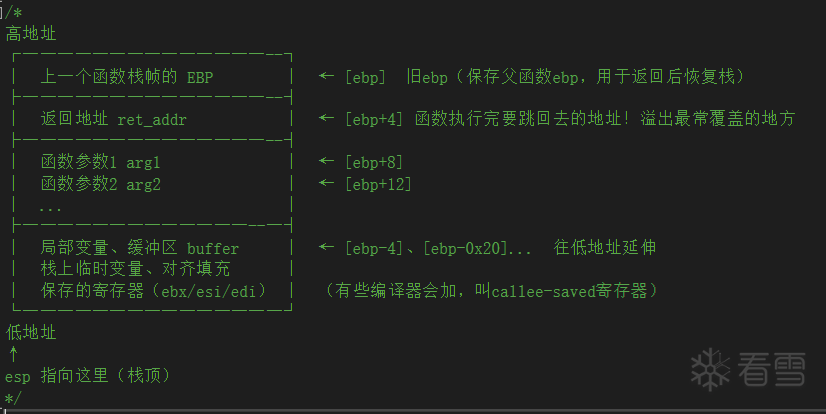
调用流程
1.调用方:从右往左压入参数-->push b;push a
2.call func:自动把下一条指令地址(ret_addr返回地址)压栈,然后跳转到func
3.func函数开头标准栈:
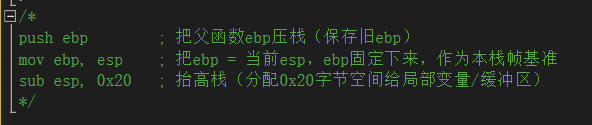
之后整个函数内部,访问变量都用ebp做偏移,非常方便
4.函数结尾:
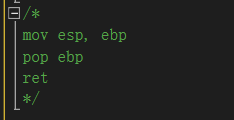
ret等价于pop eip:把栈上的返回地址弹给指令寄存器eip,就回到调用处继续执行
0x03【栈溢出漏洞原理】
漏洞根源:无边界校验的写入函数(gets,strcpy,scanf等),向缓冲区写入超长数据
例如:
buf只有16字节的空间:
前16字节:填满buf
接下来4字节:覆盖old_ebp(栈帧链表节点)
再接下来4字节:覆盖ret_addr
正常情况下:func执行ret,eip=ret_addr(旧地址)
溢出之后:ret_addr(新地址),被我们可控数据覆盖,ret执行时,eip变成我们写进去的地址,程序流被劫持
这就是栈溢出漏洞,简单而言就是精心构造一个输入数据,覆盖掉ret_addr,让程序跳转到我们的目标地址
其实栈溢出是Pwn入门的漏洞,原理还是很简单的,只不过栈的结构和帧栈的理解对新手而言比较难理解,剩下的就交给exp好啦
补充:
1.只覆盖old_ebp一般不会立刻劫持eip,只是栈锚点错乱,后续上层函数寻址错乱,只有覆盖ret_addr才会在ret瞬间拿到eip控制权
2.32位一个地址是4字节,64位一个地址是8字节,所以覆盖ret_addr的时候,32位和64位的覆盖字节有所差距,所以在做题之前要先弄清楚是32位还是64位
3.64位还有一个点就是:栈需要16字节对齐,call指令会自动压入8字节ret地址,所以进入函数时rsp%16==8,函数内部再sub rsp保证对齐,否则部分libc函数(比如printf、scanf等)会crash
赞赏

|




