VMProtect3.5.1还原演示
Author: malware/zhouqing Date:2026/8/20 Title:Agent能力的演示
第一章 背景介绍 在早期 VM攻防当中,红方通常采用手写反汇编器解析OpCode做解释器的手段对被VM保护的程序进行分析。在2019年,一篇名为《SATURN》的论文发表于第3届ACM软件保护研讨会,证明了一种不依赖特定 VM 语义知识的通用反混淆路径的可行性。
《 SATURN》基于Remill将Binary抬升至LLVM IR后采用DFS路径遍历算法恢复CFG(二进制控制流图)后利用 LLVM 内置优化 Pass 和 Souper 超级优化器,消除常量展开、死代码插入、基于算术的不透明表达式等常见混淆模式。对于优化无法解决的不透明谓词,则交由SMT求解器(Z3)处理。然后将 Remill 特有的 State 结构体操作转化为普通函数参数和局部变量,恢复栈和函数参数,使代码接近源码编译结果。(基于ABI的调用约定逆向与寄存器/栈槽的语义重构)
其中, Remill是由安全公司Trail of Bits开发和维护的开源项目,代码托管在GitHub的lifting-bits组织下。根据《SATURN》的测试,Remill与 McSema、RetDec、MCTOLL 等现有二进制提升框架对比,这些工具在面对混淆代码时均失败。与Triton(符号执行工具)对比,《SATURN》生成更小、更优化的 SMT 查询,求解效率更高。
7月21日的时候,我在linkedin(领英)上发现了一篇关于VMProtect逆向的推文,“Static devirtualizer for VMProtect 3.0-3.5. Lifts virtualized code to LLVM using Remill and strips the VM layer through optimization.”
Saturn》一致,旨在不对VM保护程序进行针对性的指令集架构处理,尝试还原出程序当中原始的运行逻辑。作者开发的MogVMP利用remill的抬升能力,抬升一个handler编译解密出下一个handler地址循环抬升解密,并利用LLVM的alloca特性使得VMProtect的寄存器轮转等内容在编译时自然地被消除。在还原VMProtect基于vJmp与flag&mask实现的条件跳转时,利用LLVM提供的变量污点分析能力还原分支跳转。在针对VMProtect当中基于rdtsc时间指令反调试时同样利用LLVM的污点分析能力对remill产生的变量进行活跃分析最终实现反反调试。
2025年12月的一篇技术文章《深入浅出Ollvm混淆原理及反混淆技术》,揭示了一种基于动态执行的OLLVM反混淆还原方法。该方法基于Unicorn的动态模拟执行机制,实时捕获程序对关键数据结构的读写操作,辅助分析混淆后变量的真实语义。
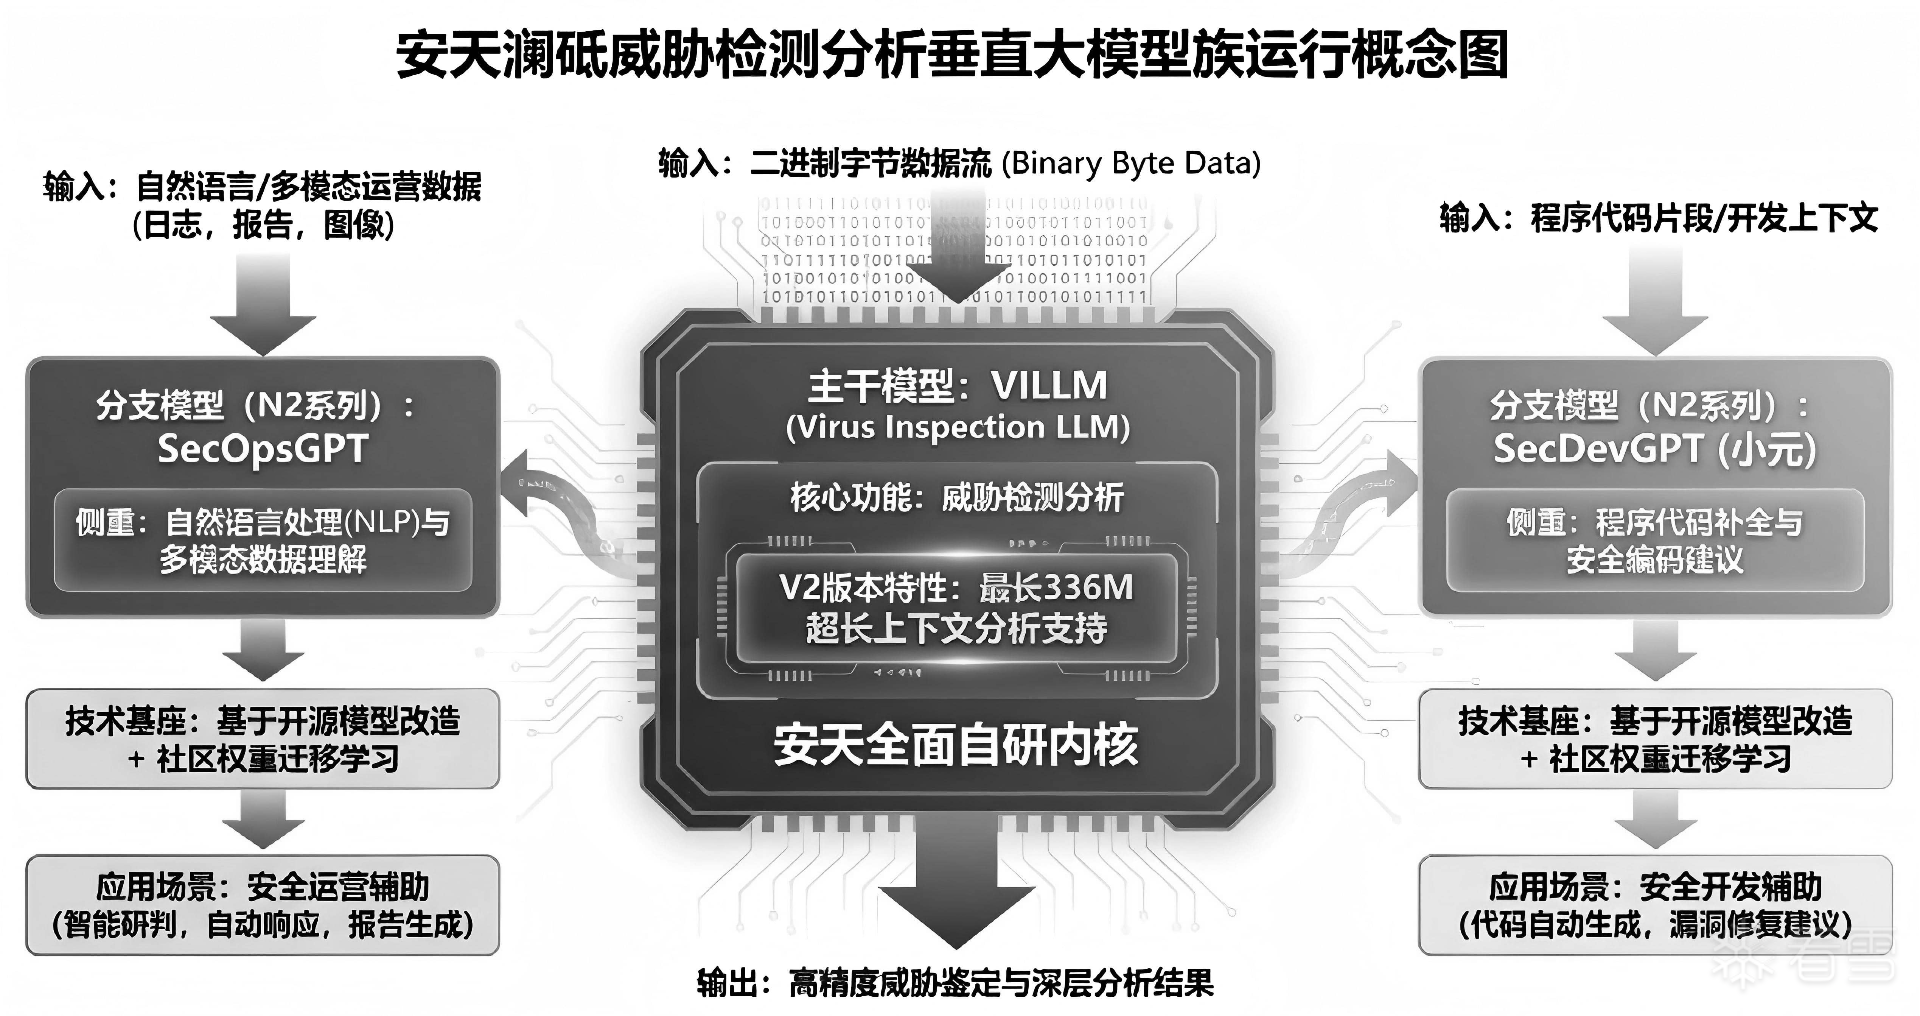
年 7月20日,一款名为AVLCode的 AI 智能编程与安全分析桌面助手出现在密界的视野当中,其搭载的澜砥威胁检测分析垂直大模型由安天自主研发,面向二级制、脚本等对象进行分析鉴定,突破开源模型局限,将检测文件的大小扩展到数百兆字节级别(亿Token上下文),在处理二进制数据时提供500~1000倍的性能。
VILLM(Virus Inspection Large Language Model)可处理二进制字节数据、进行威胁检测分析,支持最长336M的超长上下文分析。另外两个分支模型SecOpsGPT(大安)侧重自然语言处理与多模态数据理解、SecDevGPT(小元)侧重程序代码补全,分支模型基于开源模型改造并使用社区权重进行迁移学习训练,分别用于安全运营辅助和安全开发辅助。
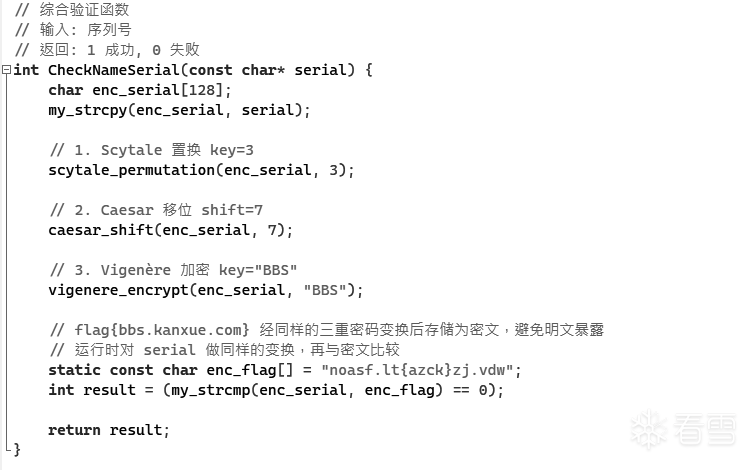
第二章 样本构建 Trace部分的逻辑,所以相对合适的构造方式是利用古典密码学的置换代换的思想构造串联的双射空间,这能够让Trace覆盖相对多的算法部分。输入一段提示词,让deepseek生成代码,具体代码见附录:
用 C 编写一个 Crack Me,调用 MessageBoxW 告诉用户是否验证成功,反复思考一下CheckSerial的设计,我的期望是一个古典密码学,通过一个 key 进行轮转。
- 从简单的置换(如 Scytale 密码)到单表代换(如 Caesar 密码),再到多表代换(如 Vigenère 密码),复杂度逐步提升。
预期的结果是 flag{bbs.kanxue.com}
VMPSDK,而具体的CheckNameSerial则并不添加VM保护。这创造了一个选择明文攻击条件,便于我们快速观察预期的En(flag),就像一道CTF题目一样。蓝方期望红方还原程序当中被混淆的算法而暴露出预期的密文以及针对用户输入而产出的En(serial)是怎样的,方便红方判断算法还原的准确性。
函数名
等级
备注
scytale_permutation
Ultra(超级虚拟化)
置换
caesar_shift
Virtual(虚拟化)
单表映射
vigenere_encrypt
Virtual(虚拟化)
多表映射
第三章 分析环境 remill的源码clone到本地后,准备一个LLVM(version 17+)的编译环境将其编译好作为静态削弱混淆的基础插件。然后我们编写一个x64dbg的动态调试插件能够支持Dump、Trace功能,我将其取名为malware。当前,我们的分析环境如下:
工具名
备注
LLVM 17源码及工具链(Windows平台)
编写 pass/opt优化/重编译程序
基于 Unicorn和Zydis的 X64Dbg动态调试插件
保存程序动态执行路径及数据
二进制抬升器 Remill-lift-17.exe(Windows平台)
用于将 Binary抬升至LLVMIR生成.ll
AVLCode/VLLM( 澜砥大模型)
辅助 分析混淆规则
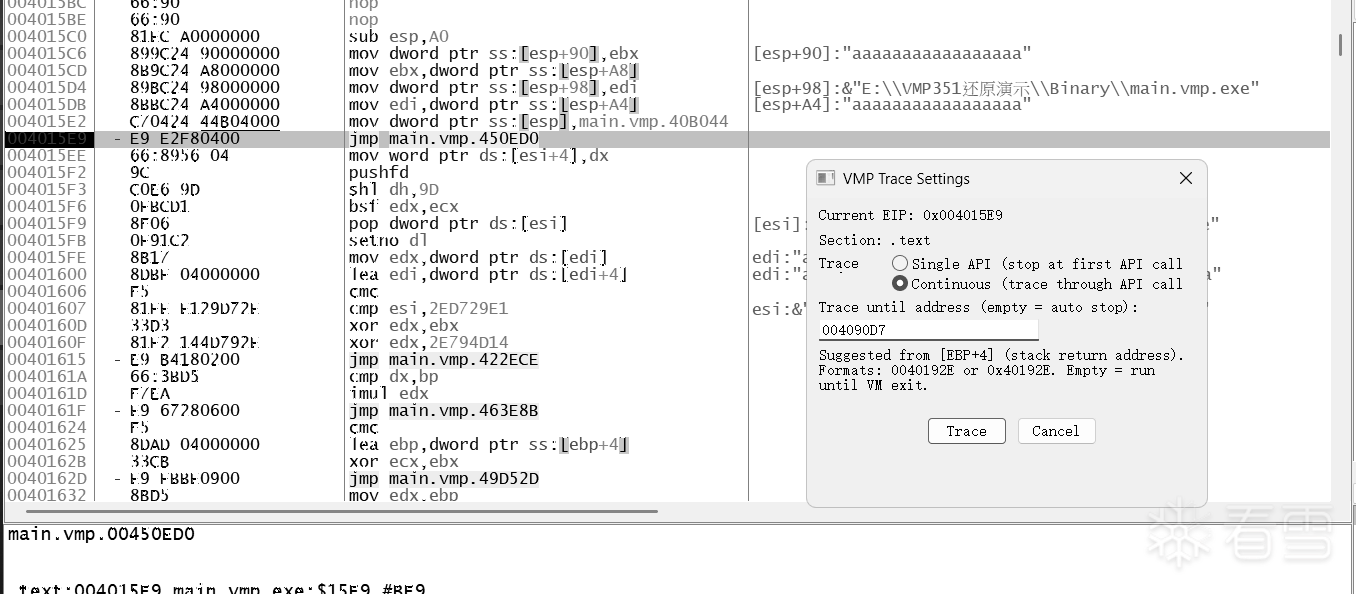
接下来,我通过 Trace插件进行程序控制流的跟踪,值得一提的是until address会根据ebp智能计算目标地址,但是由于程序似乎并非MSVC编译,不依赖mov ebp,esp的方式进行栈帧的管理,导致这个方法失效了,需要手动填写目标地址。
同时可以发现函数头并没有被 VM,这是VMP SDK所带来的弊端。通过没有被VM掉的函数头,我们向AVLCode询问其函数的参数。
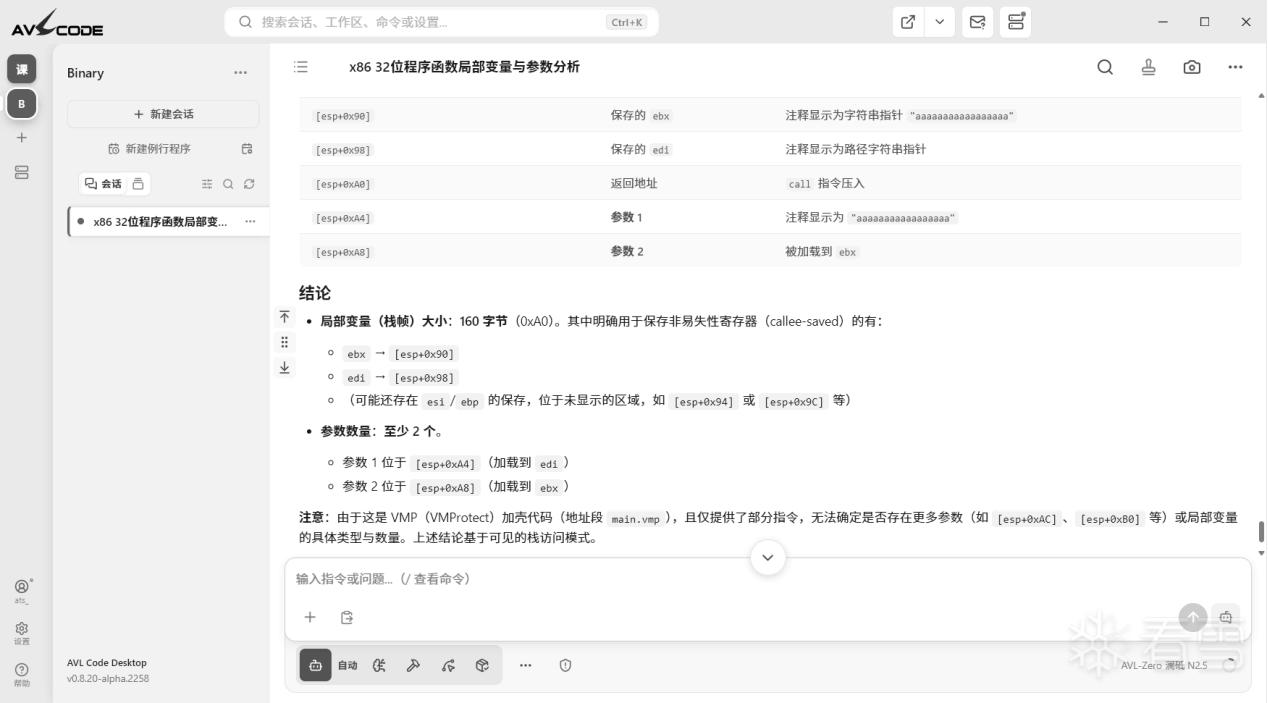
AVLCode询问,创建好工作区后,输入提示词:
目标是 x86 32bit 程序,程序似乎并非MSVC编译,请帮我判断一下该函数的局部变量数量和参数:
-----------
函数头部汇编代码
-----------
stack point大小(0xa0)和俩个函数参数的信息: 函数入口指令 sub esp, A0h 表明该函数分配了 0xA0(160)字节 的栈空间。
在 x86 32 位调用约定(cdecl/stdcall)下,栈布局(从低地址到高地址)为:
偏移 (相对于 esp)
内容
说明
[esp+0x00] ~ [esp+0x8F]
局部变量区域
约 144 字节的临时存储空间
[esp+0x90]
保存的 ebx
注释显示为字符串指针 "aaaaaaaaaaaaaaaaa"
[esp+0x98]
保存的 edi
注释显示为路径字符串指针
[esp+0xA0]
返回地址
call 指令压入
[esp+0xA4]
参数 1
注释显示为 "aaaaaaaaaaaaaaaaa"
[esp+0xA8]
参数 2
被加载到 ebx
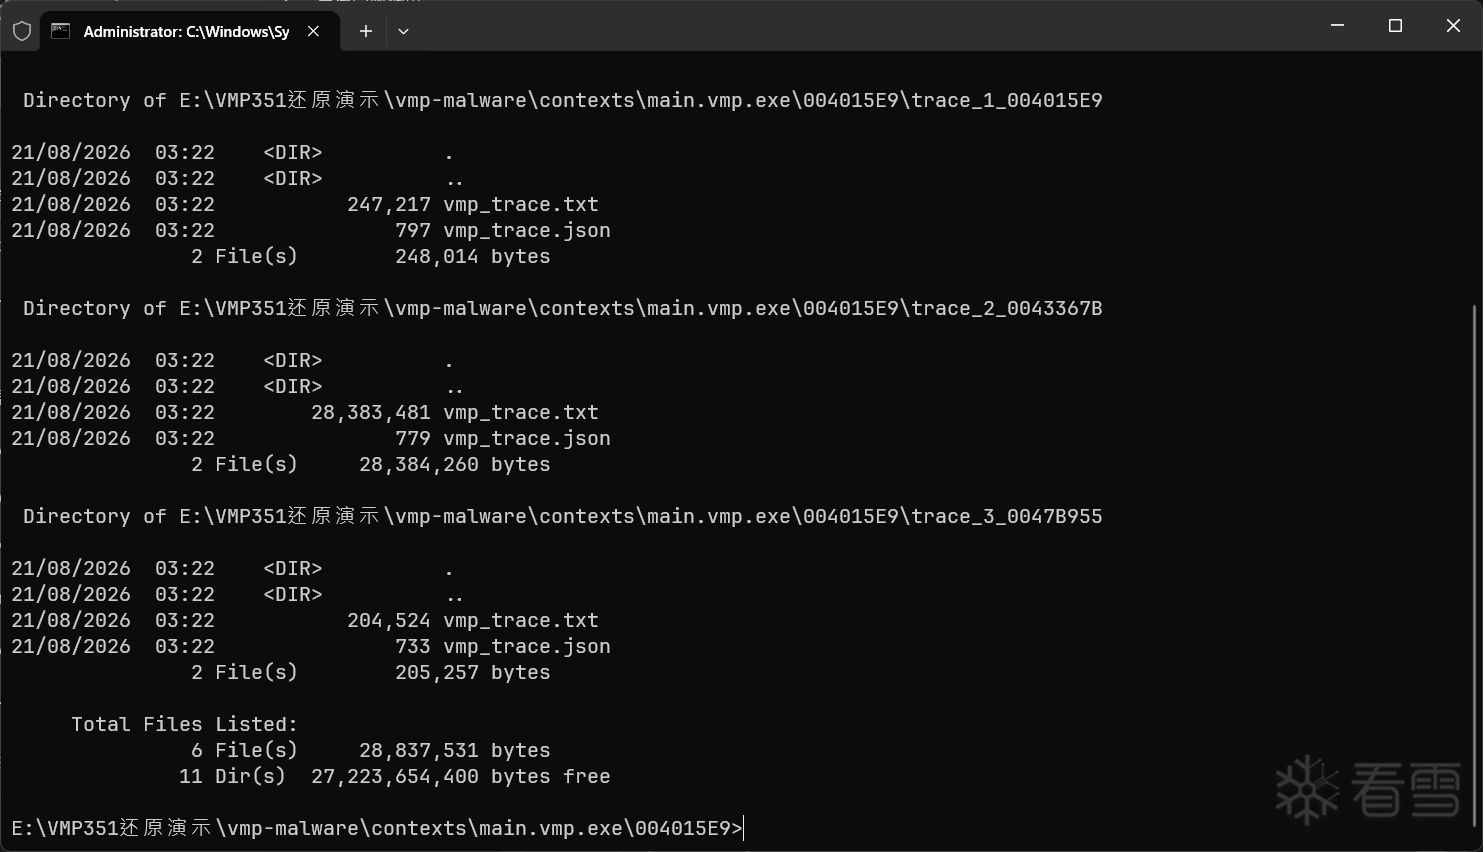
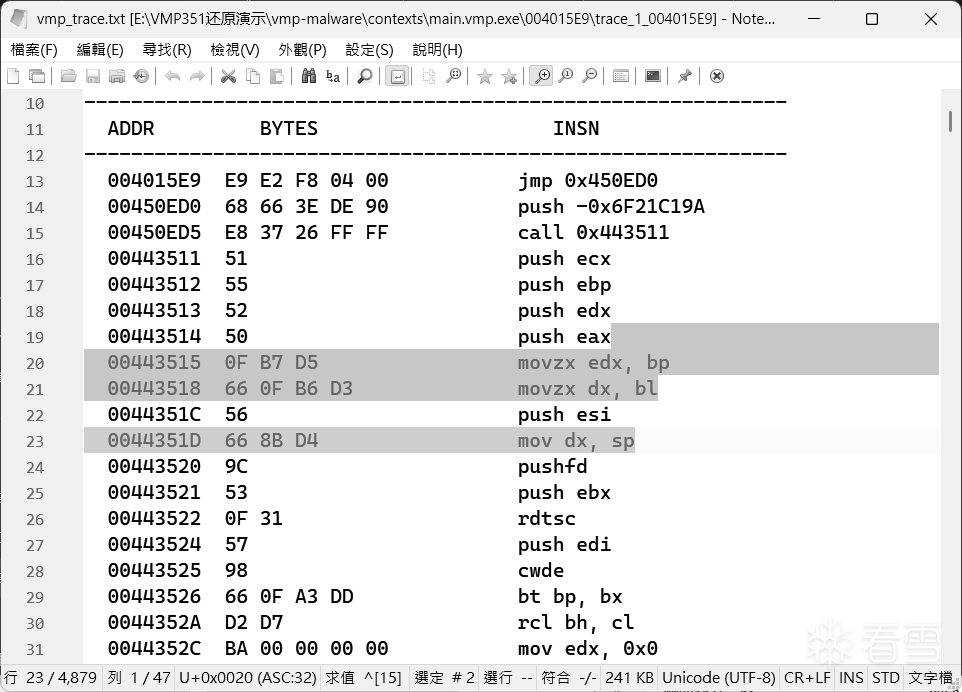
Trace后的产物,004015E9产生了3次Trace,这说明了程序共有3次执行到了.vmp0 section(区/节)之外的地址然后被我们的动态调试插件所捕获。同时注意到第二份和第三份的Trace文件相比第一份,所占用的磁盘空间bytes每一次都在上升一个量级。
004015E9的Trace文件与现有的信息,我们可以构造出这样的控制流:
0XA0个活跃变量,2个函数参数,一个指向了serial(用户输入ebx)一个则是一个const常量0x3(edx)
0x004015E9 ~ 0x 00408F50 (一段未知的算法)
Strlen
0x00433678 ~ 0x00408F38(一段未知的算法)
Strcpy
0x0047B955 ~ 0x0046E27D
0x004090D7 ( .text段代码,说明VM执行结束了)
api。接下去则是去分析Trace当中的VM了。
第四章 混淆削弱 常量折叠和死代码消除 Trace当中所存在的死代码。通常情况下要做个活跃变量分析,通过将控制流产生的SSA数据流来判断什么变量在被读取前就被二次写入了,进而消除掉未被利用的代码。我们将这样的一种过程称之为死代码消除。
而常量折叠在控制流的体现上则是将未知的跳转,例如 jmp reg,通过传递state和memory等数据经过LLVM后自动削弱掉不必要的计算,最终产生一个常量目标地址。同时一种相对常见的处理方案是利用Triton等符号执行框架去计算可行的路径,最终算出一个常量目标地址。
LLVM当中,-O1优化参数对应着常量折叠、死代码消除。它是如下指令的缩写,接下来我介绍一下各个参数的含义。
opt -S -dce -simplifycfg -constprop -gvn raw.ll -o optimized.ll
各个参数的含义如下:
Pass
作用
-dce
死代码消除:删除从未被使用的指令。
-simplifycfg
控制流简化:合并基本块、消除空块、简化分支。
-constprop
常量传播:将可静态确定的计算(如 add i32 1, 2)折叠为常数。
-gvn
全局值编号:识别并消除重复的计算。
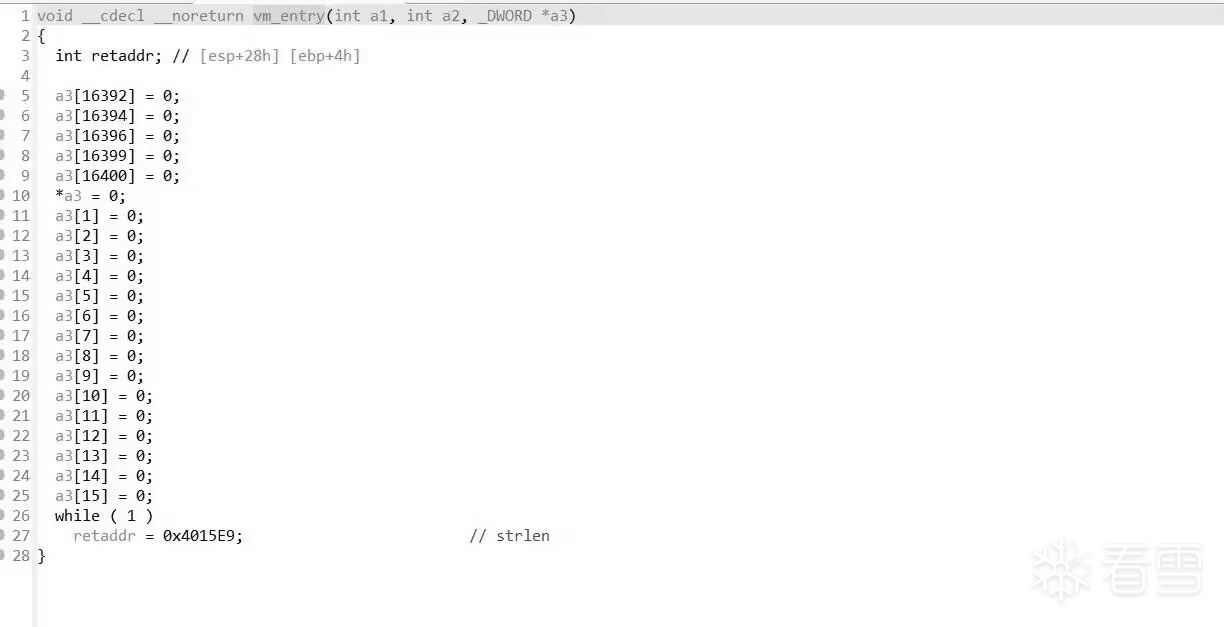
不建模函数优化方案的缺陷 Trace,我们利用remill将其抬升至.ll文件,使用上述的-O1优化,这个.ll文件比较大,有500多MB。然后我们利用llc(LLVM工具链中的静态编译器后端)将.ll链接到.obj文件,然后用IDA打开,F5反编译查看,可以看到,我们的vm_entry很干净,vm_entry入口的key丢失了,给vm_context区域设置为0后执行strlen退出VM,因为.ll没有拼接起来所以链接出的.obj反编译看上去vm_ret像是在死循环。
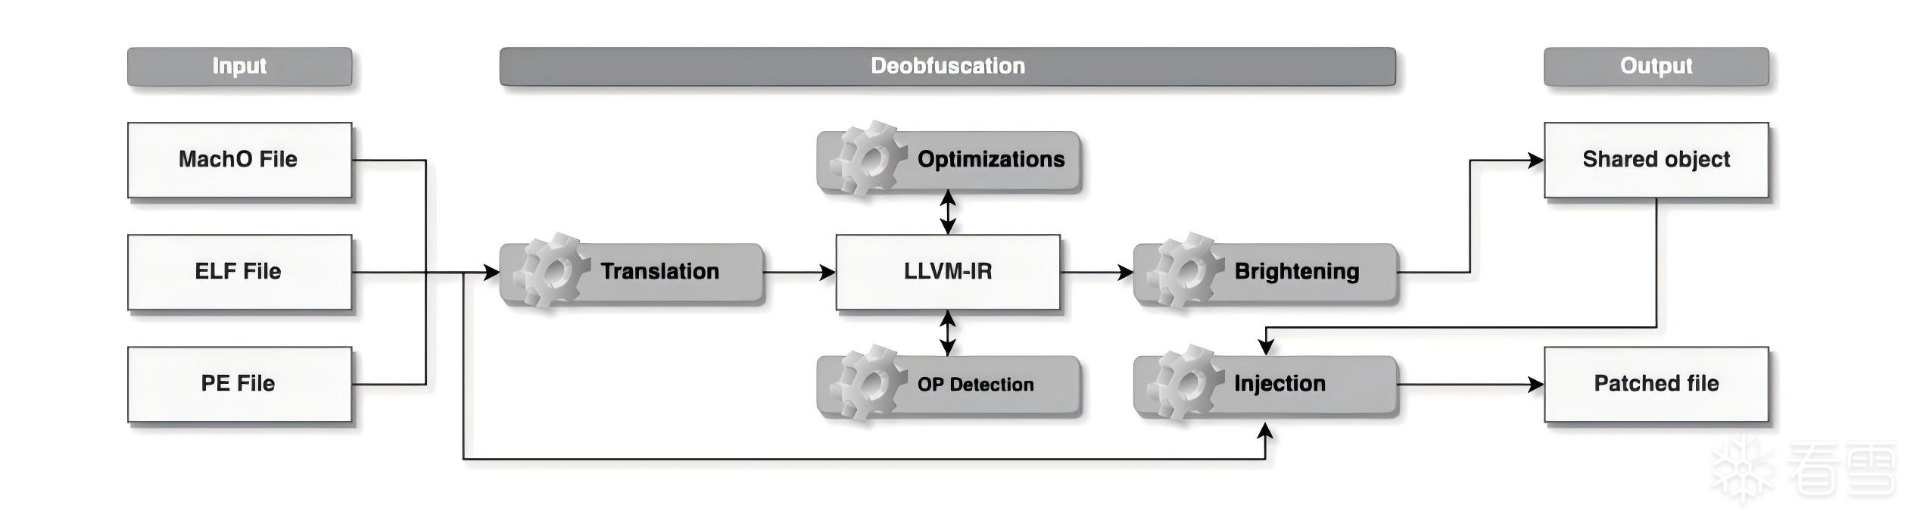
总之,直接利用 LLVM削弱VM函数,会导致几乎全部的信息丢失,这就要求我们构建专门针对VMProtect3.5.1的LLVM工具。 或者把虚拟机的执行过程当作普通程序代码,整体通过翻译器例如 remill翻译成LLVM IR,再让编译器优化器把“虚拟机层”当作冗余代码折叠掉。
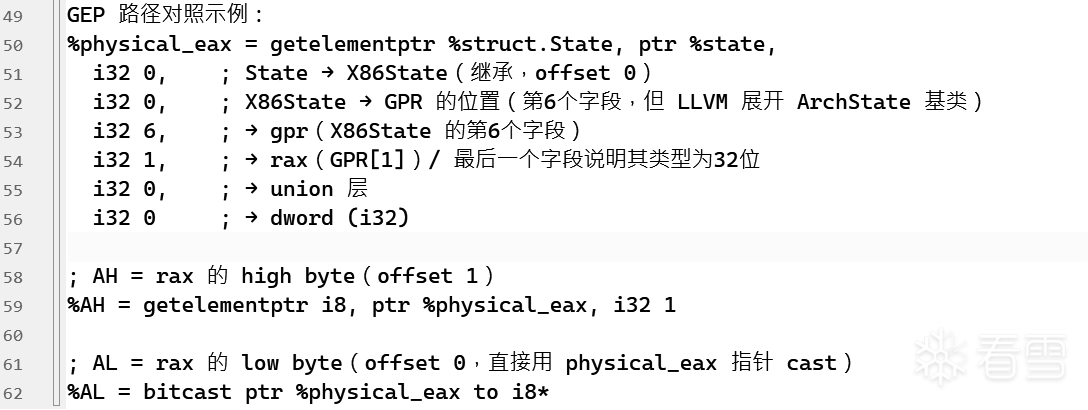
ElementPTR 建模削弱混淆 VMProtect Ultra当中的混淆函数,针对32bit的寄存器操作拆分成了俩个16bit寄存器或多个8+16bit的MBA混淆运算,基于此利用LLVM ElementPTR的特性建模,形如:
% physical_ eax = getelementptr inbounds %struct.State, ptr %state,
i32 0, i32 0, i32 6, i32 1, i32 0, i32 0
% physical_ ebx = getelementptr inbounds %struct.State, ptr %state,
i32 0, i32 0, i32 6, i32 3, i32 0, i32 0
而 physical_ah(高位)physical_ax physical_al(俩个低位8bit) 则是physical_eax的高位和低位寄存器,一个32-bit guest register是 State 中的一个 32-bit storage slot,而LLVM允许通过GetElementPTR + typed load/store从这个slot的不同 byte/word offset 建模 AL/AH/AX 等子寄存器视图,从而利用TBAA / Alias Analysis / MemorySSA 等分析削弱混淆。
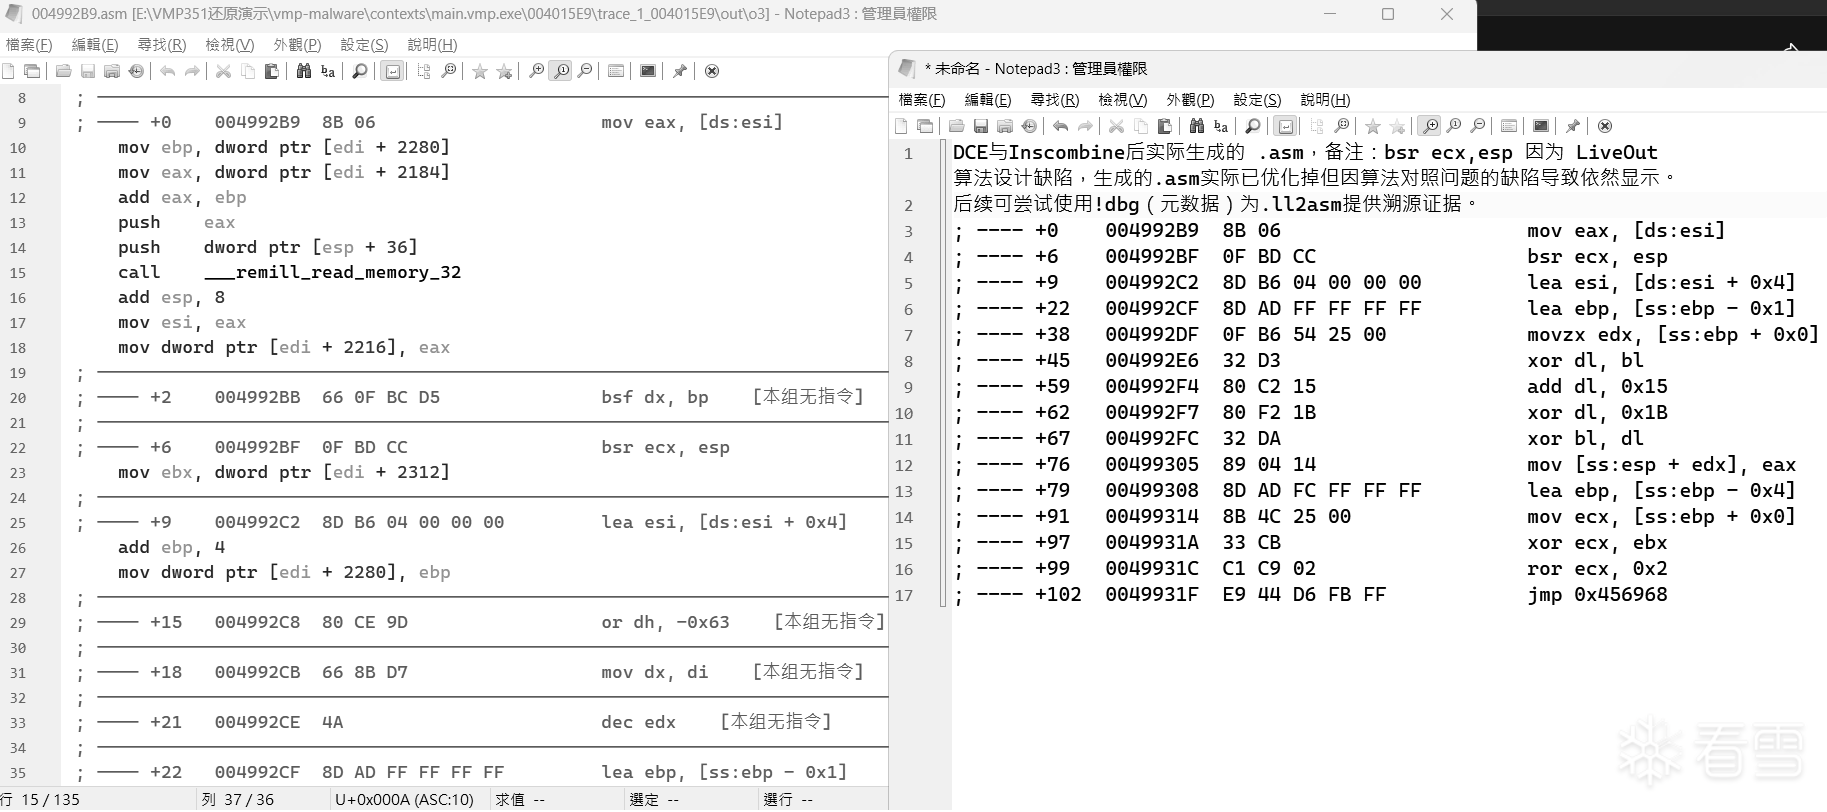
在 remill 的基础上进行 DCE LLVM直接O3优化混淆函数导致信息全丢的现象,这里有一个办法是LiveOut建模去欺骗编译器。
vip、vmcontext、vmkey等符号后,编写代码标记其在LLVM函数(handler)结束后,生命周期依然是有效的。而其他函数过程产生的中间变量设置undef属性,要求LLVM在最终要对其进行常量折叠和死代码消除。
最终,可以看到下图的清理效果,同时我们可注意到 xor ecx,ebx并没有被优化掉,因为ebx是vmkey,用于解密下一个handler的地址。
LiveOut 活跃变量建模欺骗编译器本质上依赖我们对现有数据建模的准确性,对此, VMProtect 团队也不曾多让,设计了“寄存器轮转”这一机制动态的切换寄存器所代表的 vm runtime state ( VM 运行时状态)。
handler 间内部利用的 reg 进行污点分析,当 reg 发生变化时尝试溯源构建寄存器轮转后变化后的映射关系。
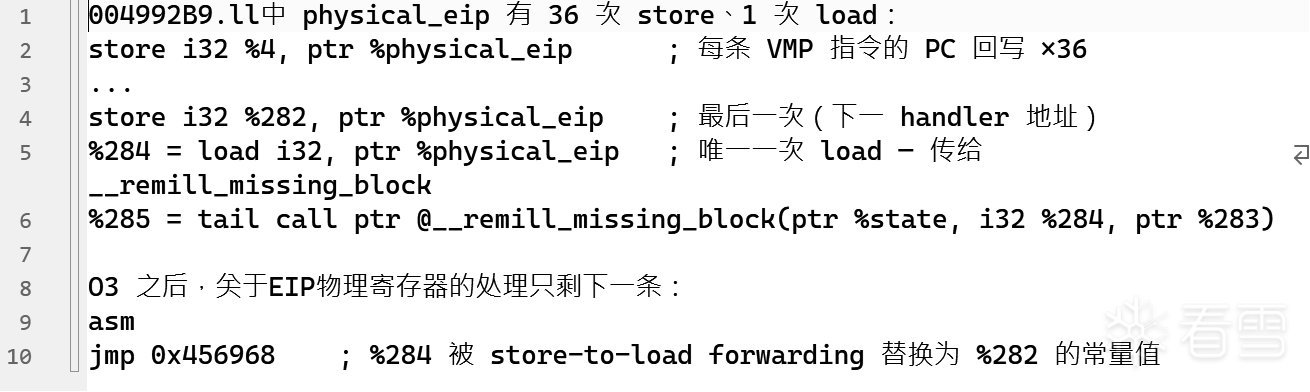
针对 Handler基本块尾部跳转的处理
Trace,基于此,LLVM的O3自身就可以优化关于EIP寄存器的操作,只保留基本块尾部的下一个基本块。借此强调指针这一概念的重要性,GEP把寄存器的状态变成可寻址的内存位置,LLVM的别名分析和常量传播自然接管了存活判断,不需要我们手写规则去删physical_eip的store。
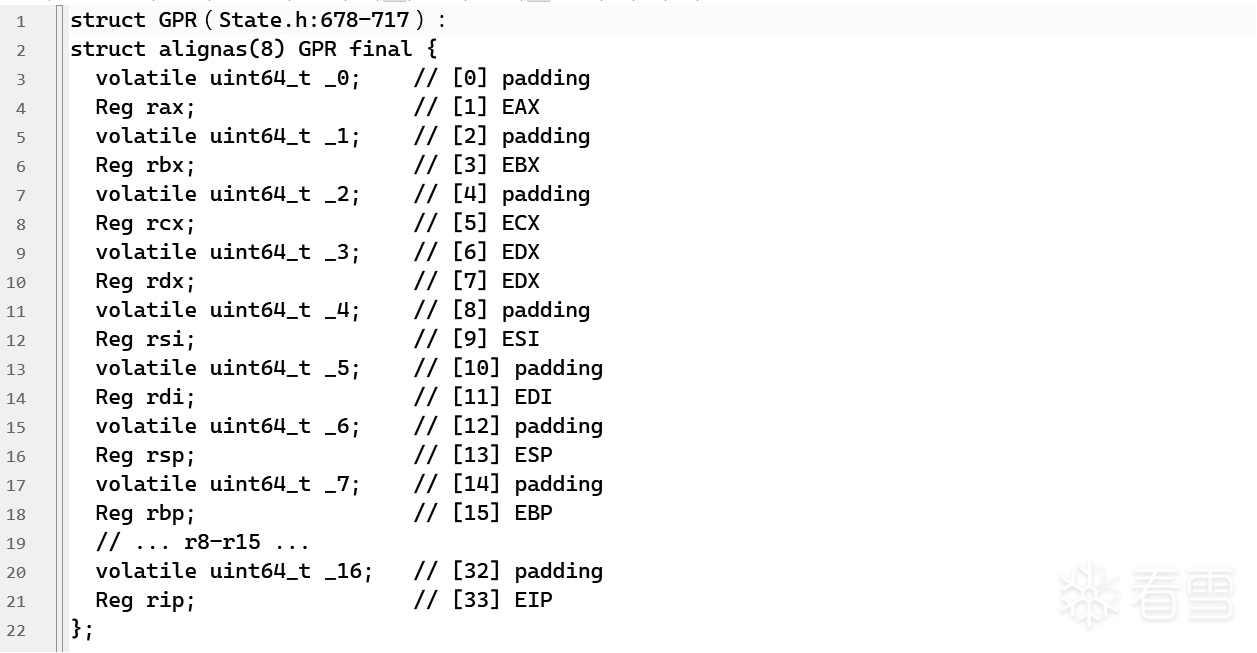
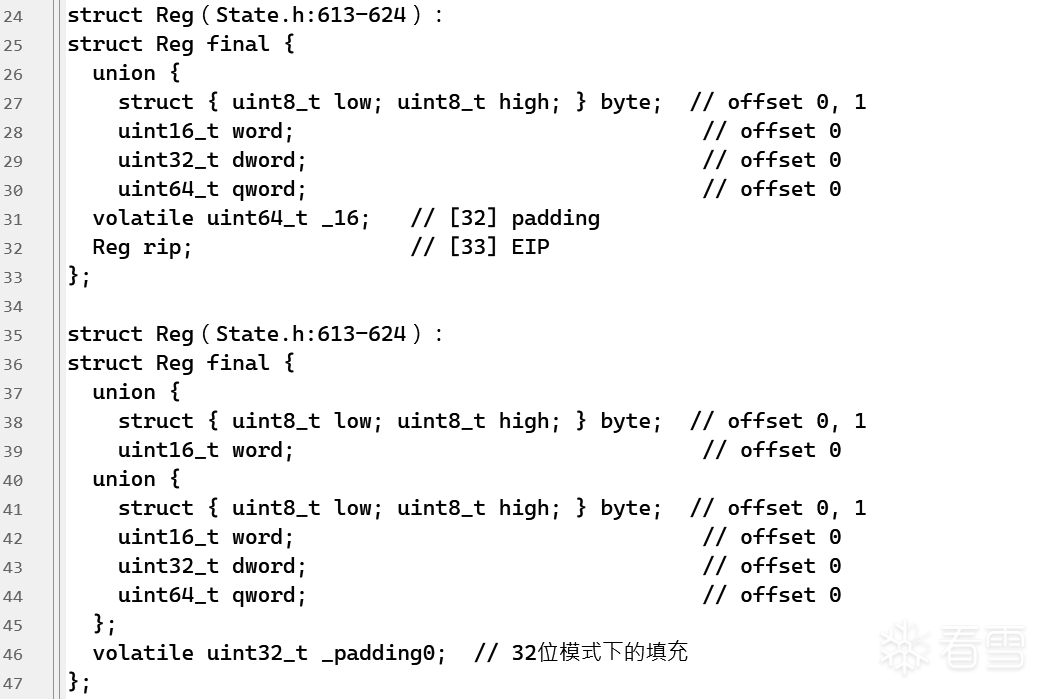
针对 IR的寄存器映射关系还原 remill的State.h源码中,存在着这样的GPR(General-Purpose Registers/通用寄存器)结构,其与我们的物理寄存器映射关系如下:
Reg 结构体用于以多种位宽访问同一个物理寄存器,精确模拟 x86 CPU 的寄存器访问行为。第二个版本可能是为了兼容 32 位二进制模式而做的调整。( _padding0 用于确保在 32 位和 64 位模式下结构体大小相同,同时二进制抬升器以 32 位模式运行时,防止意外访问高 32 位数据。
remill结构体,可以针对示例代码做如下解释,还原 .ll 文件当中IR关于 GPR(通用寄存器)的映射关系:
针对 VM 建模正确时它是有效的 。
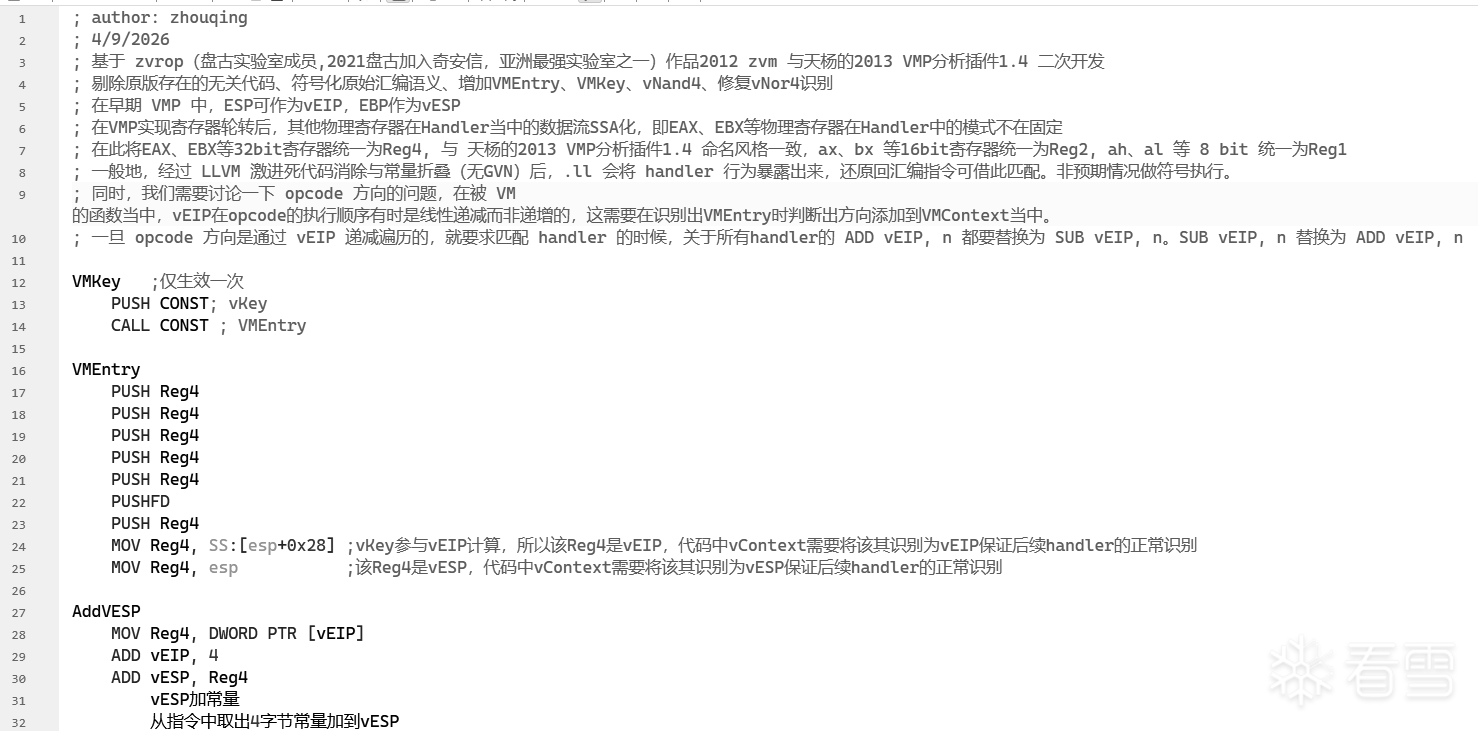
第五章 VM 指令分析 Handler 模式匹配 zvrop的2012 zvm与天扬的2013 VMP分析插件1.4基础上完善了VMP特征识别功能。
。 一般地,经过 LLVM 激进死代码消除与常量折叠(无GVN)后,.ll 会将 handler 行为暴露出来,还原回汇编指令可借此匹配。非预期情况做符号执行。
同时,我们需要讨论一下 opcode 方向的问题,在被 VM 的函数当中,vEIP在opcode的执行顺序有时是线性递减而非递增的,这需要在识别出VMEntry时判断出方向添加到VMContext当中。
。
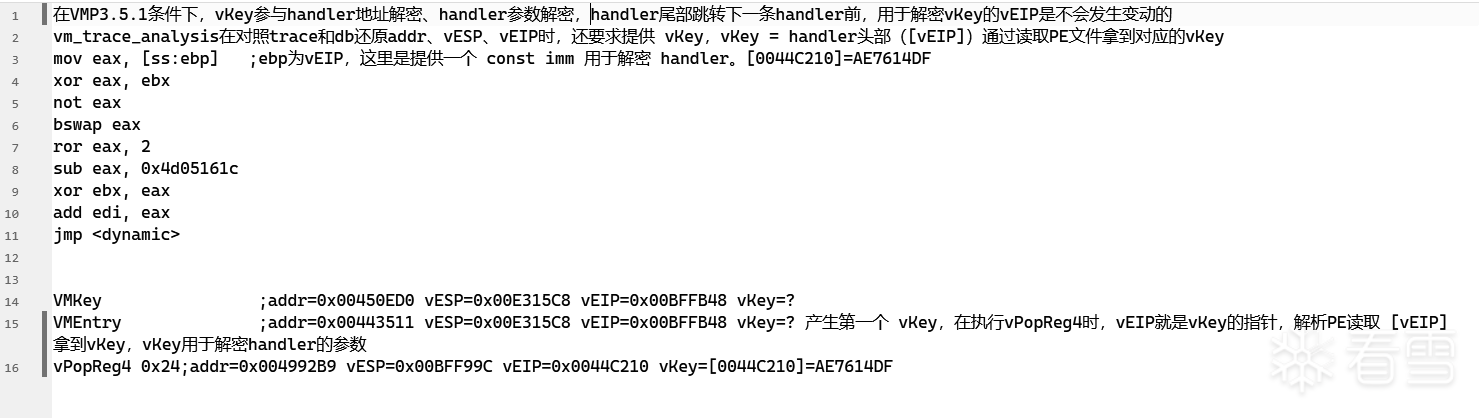
Handler 参数还原 VMP3.5.1条件下,vKey参与handler地址解密、handler参数解密,handler尾部跳转下一条handler前,用于解密vKey的vEIP是不会发生变动的。在我们已经做好了handler的匹配的基础上,通过追踪vEIP的数据流,基于Triton做符号执行拿到参数。如下方的 vPopReg4 0x24。
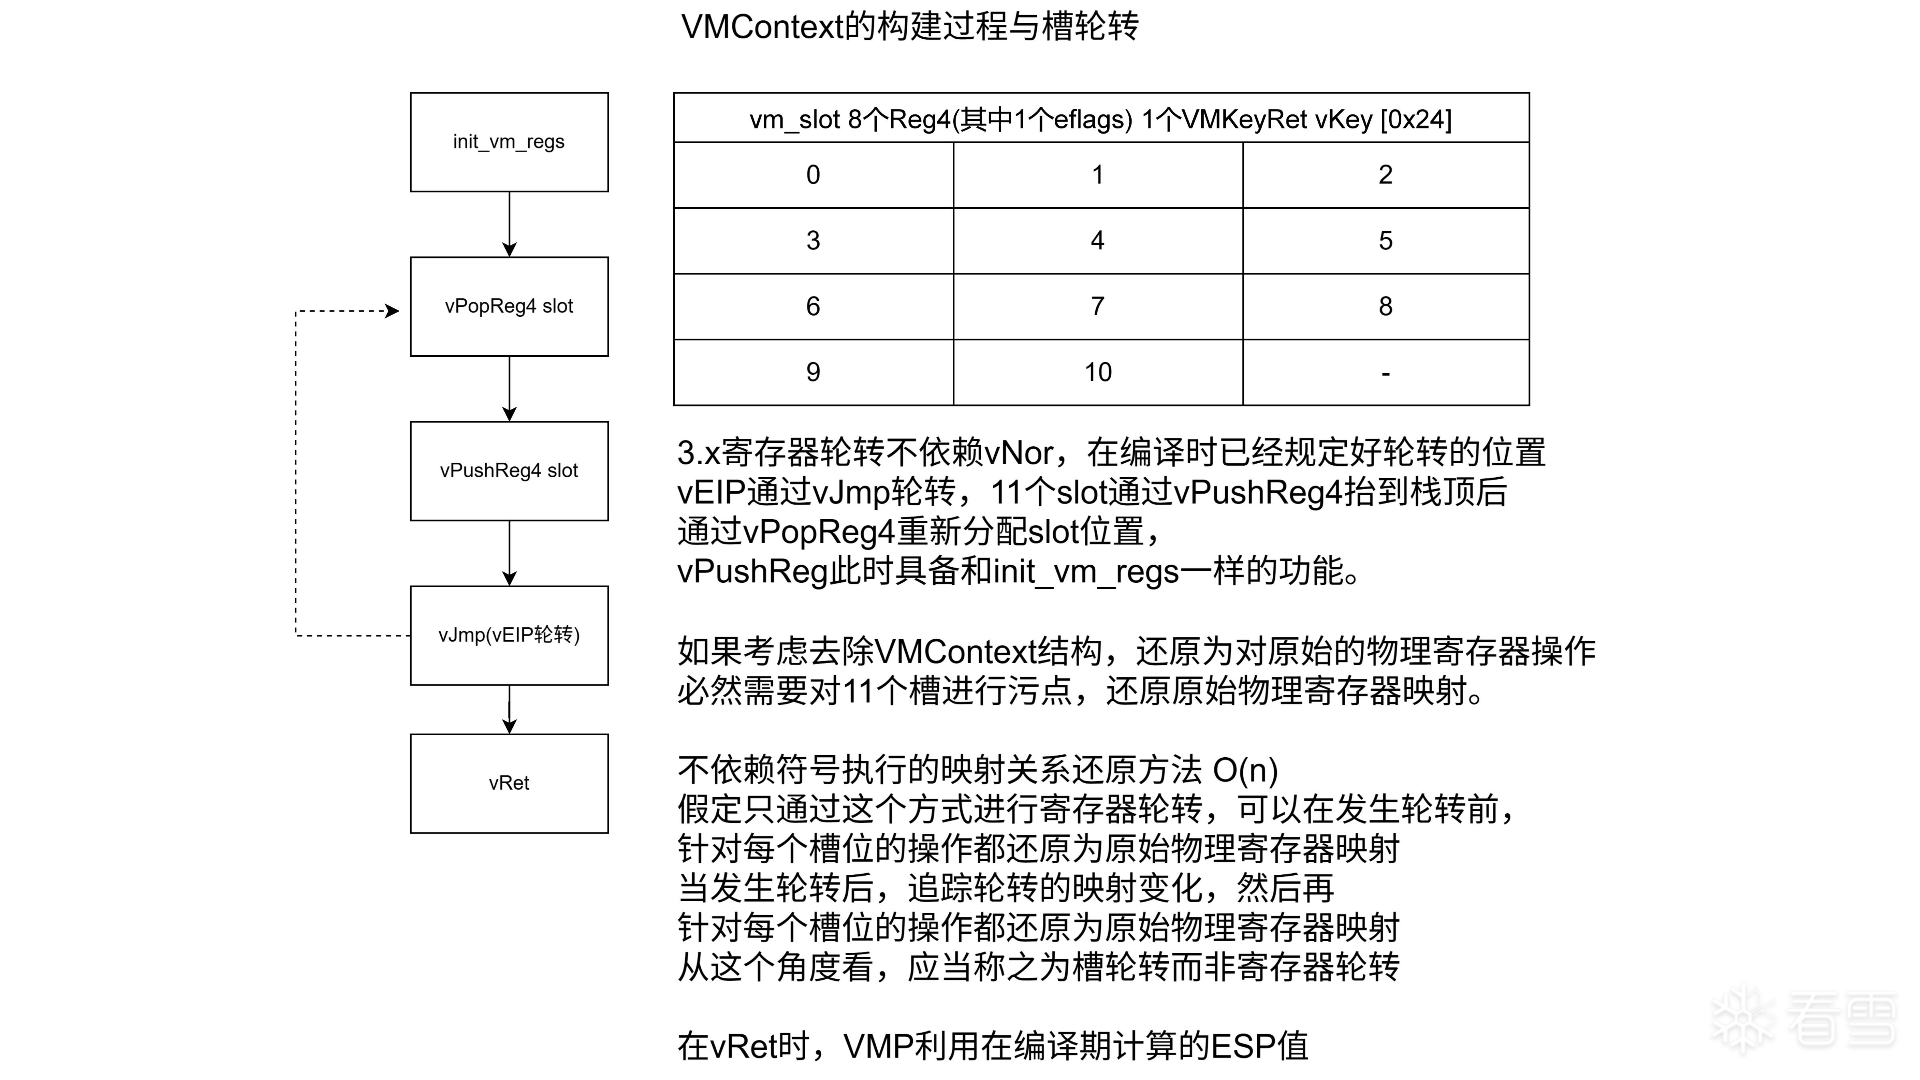
物理寄存器轮转与槽轮转 VMProtect 的逆向分析和静态还原 -2009 中国软件安全峰会》 VMP 将所有寄存器都存放在了堆栈的结构中( VM_CONTEXT ),结构中的每一项代表一个寄存器或者临时变量。但在运行过程中,其中的项所映射的真实寄存器都是不固定的,可以把它比作一个齿轮,每做完一个动作,部分项的映射就互换了一下位置,或者执行完一段指令,齿轮就按不固定的方向和度数转动一下,然后全部的项映射就改变了。 VMP 在生成字节码的过程中,维护了一份结构中每一项所映射的真实寄存器,但这只存在于编译过程,而在运行时是没有明确的信息的。这直接导致了分析和识别的难度。
在此基础上,寄存器轮转的概念可细化为物理寄存器的轮转和 VMContext 的槽轮转,物理寄存器的轮转在 VM 的表现为 vESP 、 vEIP 所对应的物理寄存器发生变化,例如在早期 VMP 当中, vESP 通常对应着 ebp 物理寄存器而 vEIP 通常对应着 esi 物理寄存器。
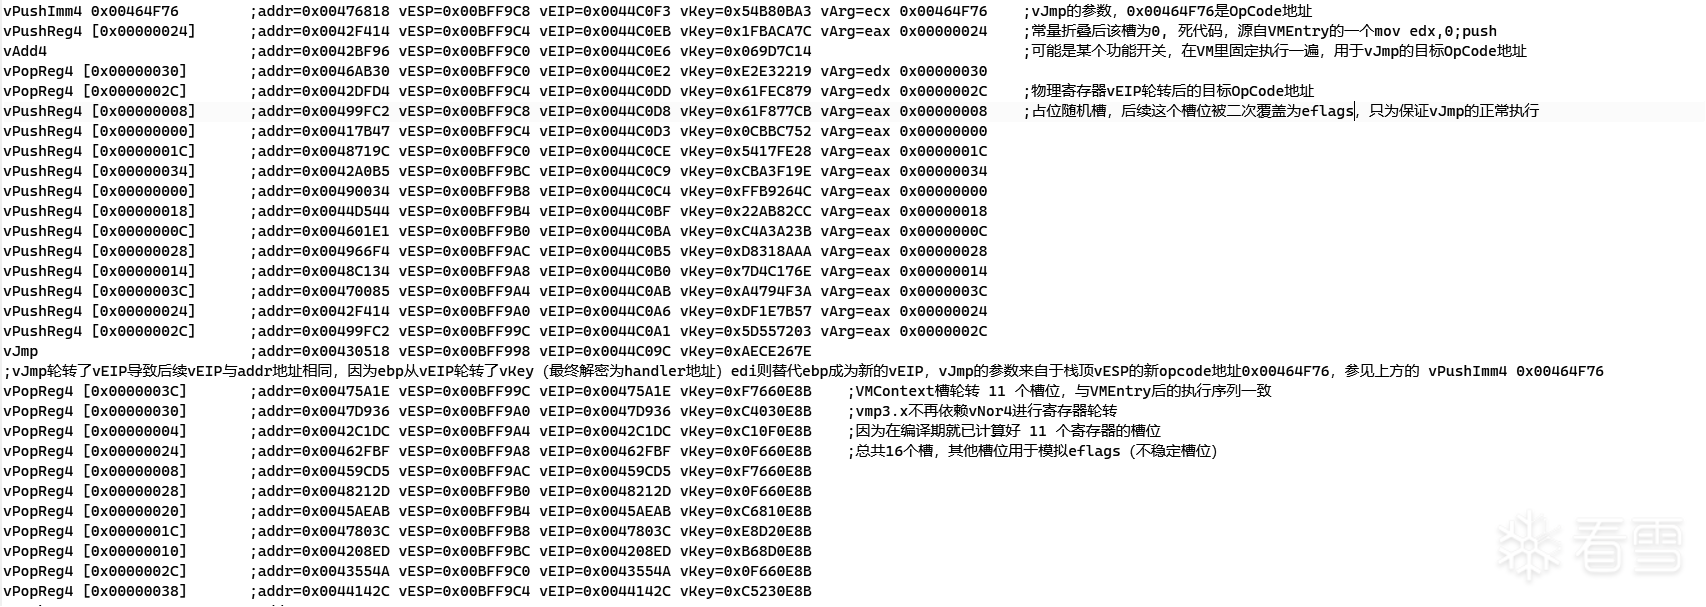
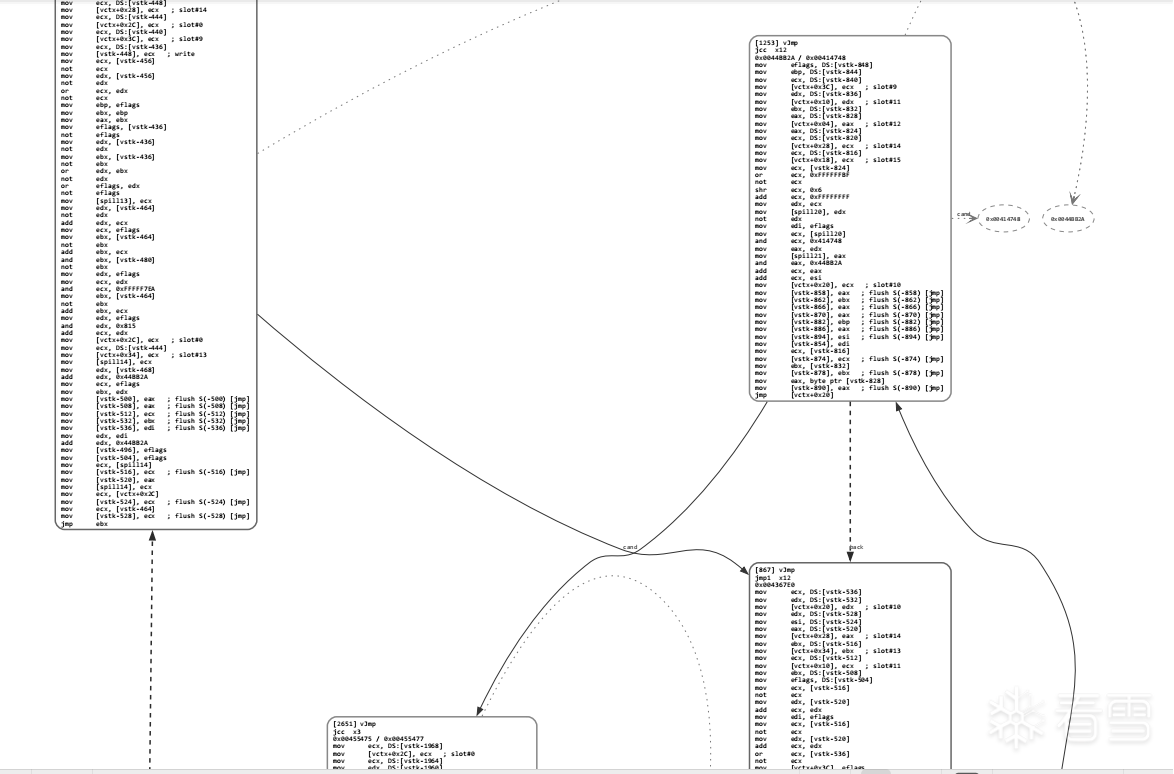
vJmp当中,具体的vEIP寄存器轮转过程参见下图vJmp的行为分析,由ebp变化为了edi,这就导致前文所介绍的handler模式匹配与参数还原失效。因为模式匹配依赖vEIP、vESP所识别出的物理寄存器是正确的。
由于通用物理寄存器的数量有限,排除在 x86处理器下默认的esp,vEIP和vESP的轮转选择只有7个。
VMContext的槽轮转,这是一种针对VM虚拟化出来的上下文结构的一种混淆方式,3.x寄存器轮转不依赖vNor,在编译时已经规定好轮转的位置vEIP通过vJmp轮转,11个slot通过vPushReg4抬到栈顶后通过vPopReg4重新分配slot位置,如果考虑去除VMContext结构,还原为对原始的物理寄存器操作必然需要对11个槽进行污点,还原原始物理寄存器映射。
指令序列的还原 Handler的模式匹配,还原参数,追踪完物理寄存器轮转与VMContext的槽轮转后,可还原为VMP的虚拟化指令集语义,同时提供VMEntry时的寄存器映射。
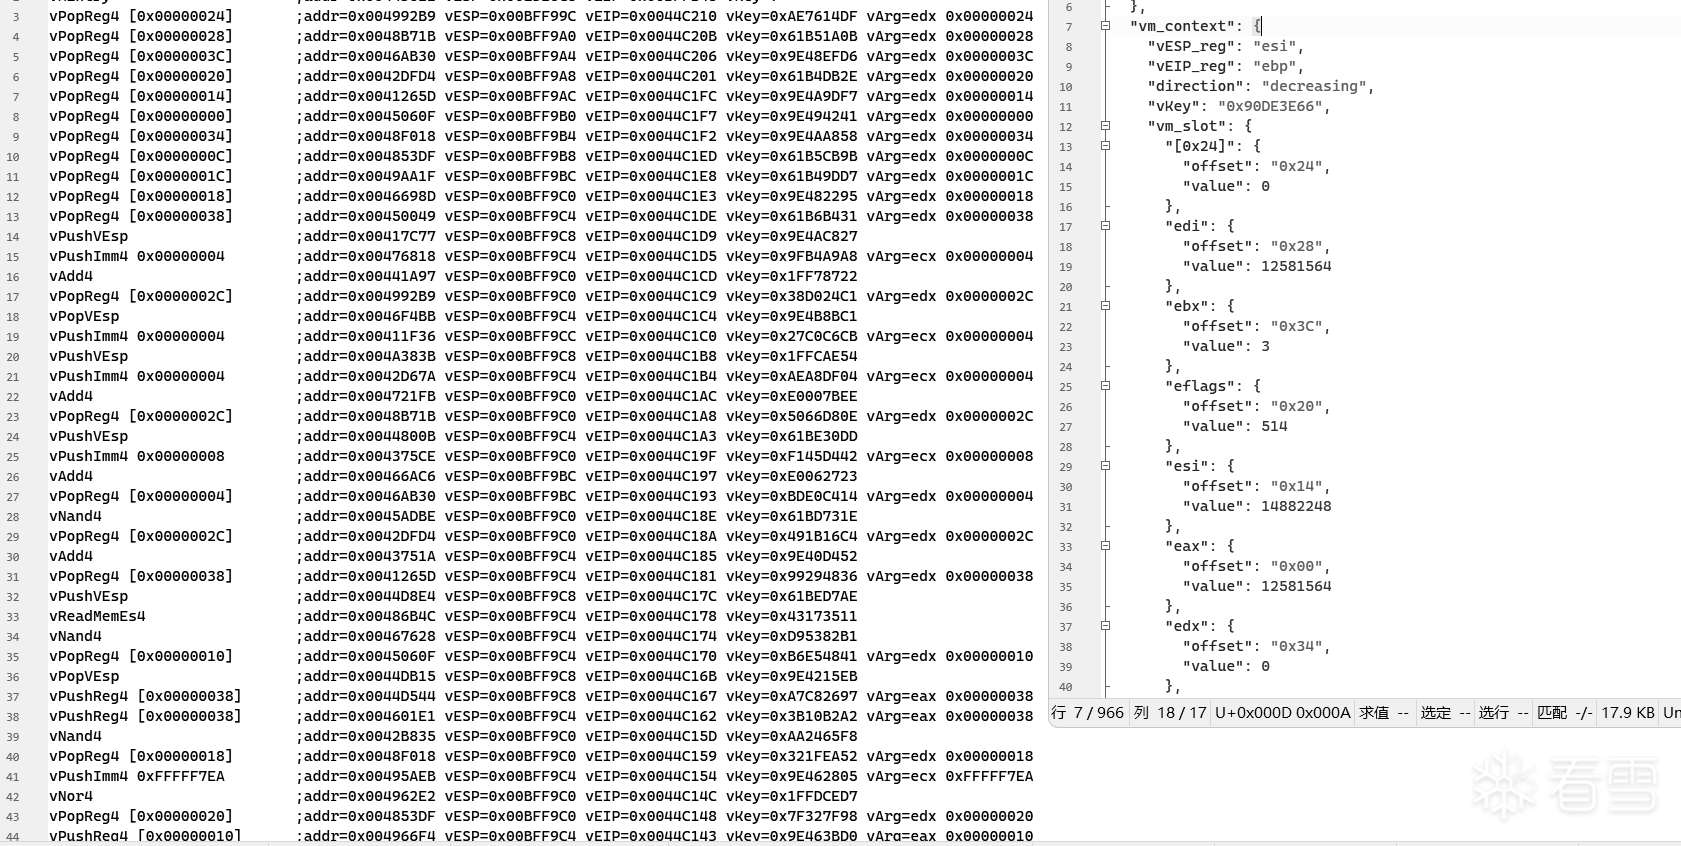
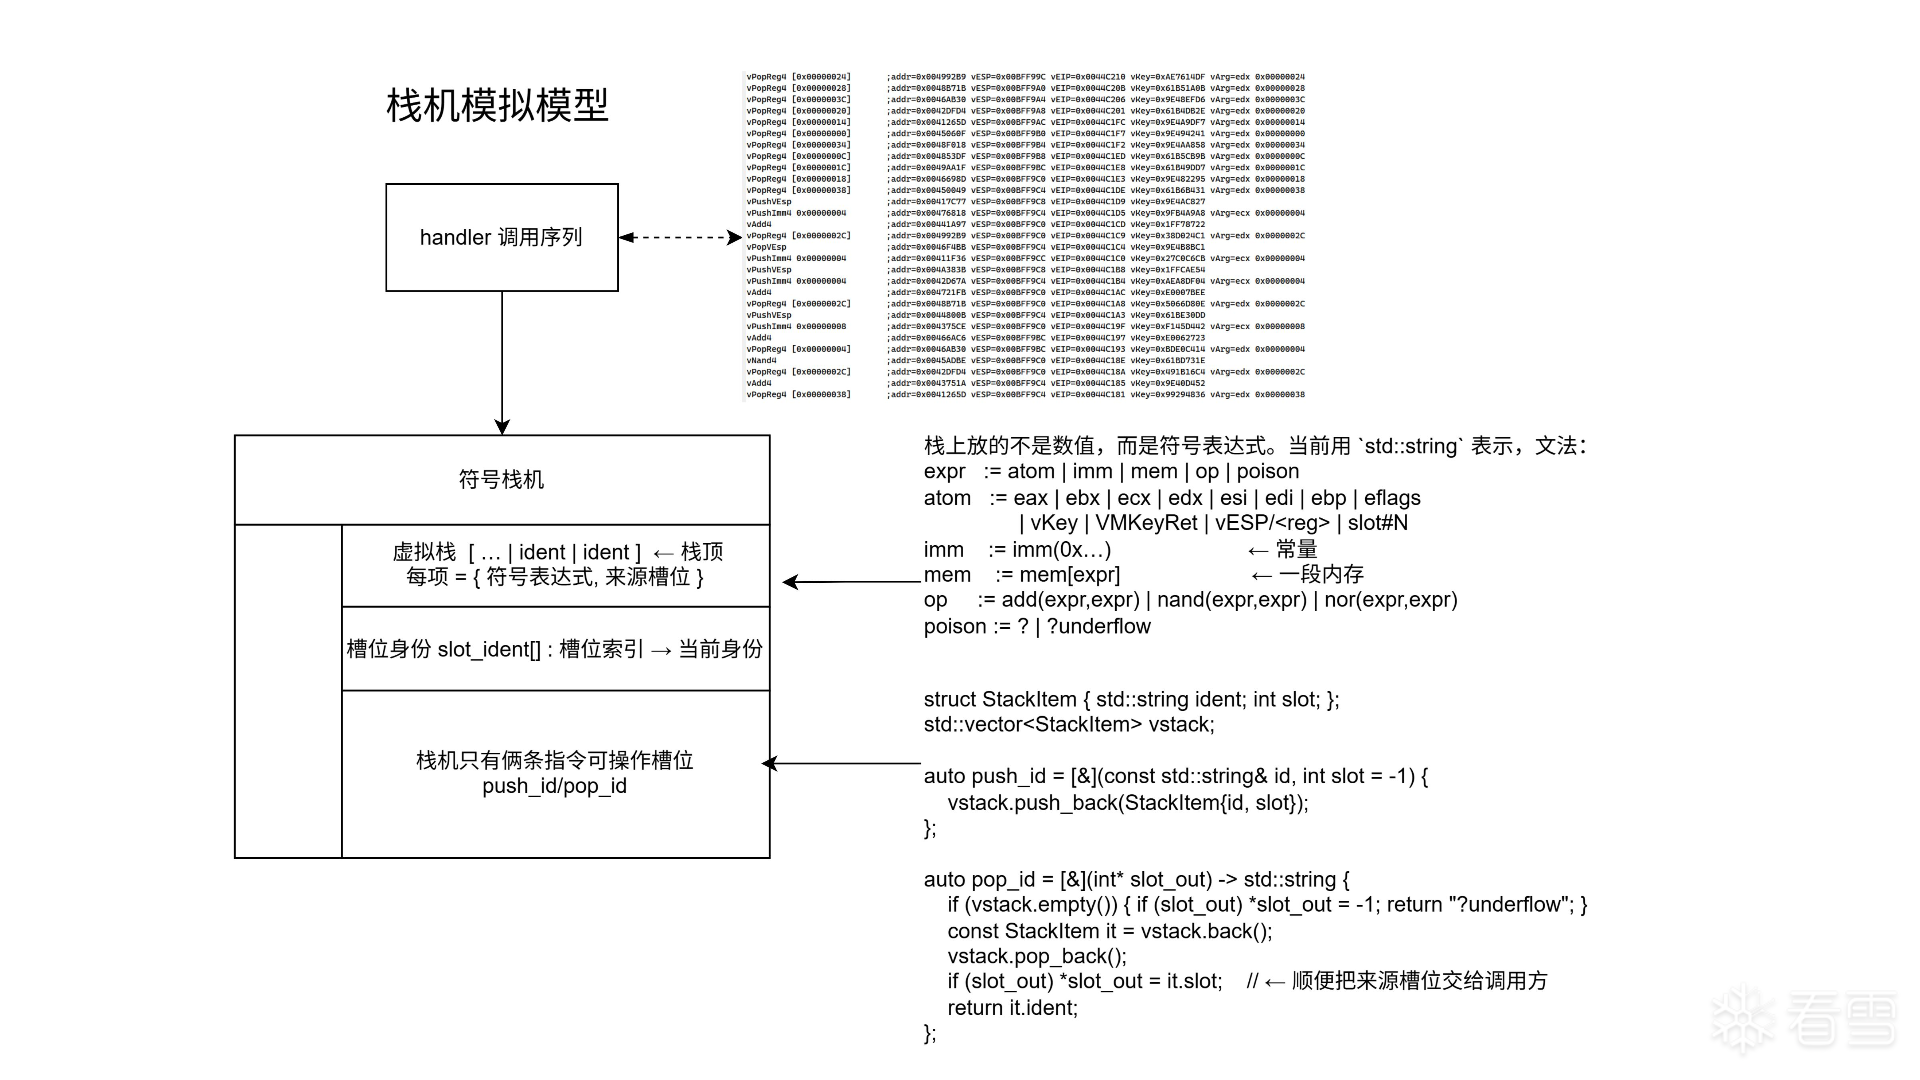
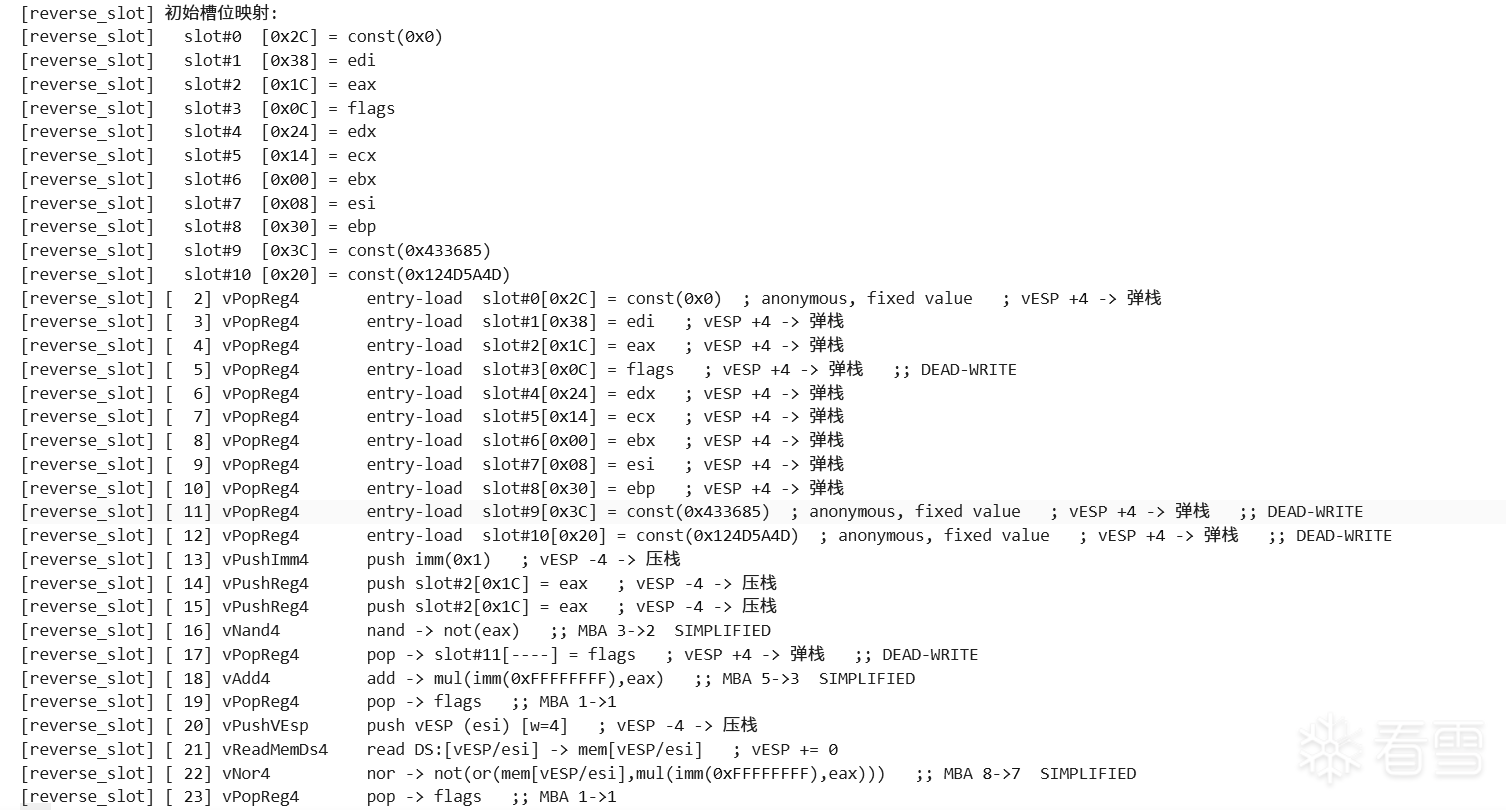
第六章 VM 行为分析 栈机模拟工具 VMContext槽位映射关系的基础上,我们可以写个解释器去模拟VM栈机,去跟踪VMContext的槽轮转以及还原VMContext槽未所对应的物理寄存器操作,这里简单介绍一下我们的栈机模拟工具,模型主要由槽位偏移、槽位索引(偏移/4)、身份(对应的物理寄存器)、槽位ID(按照槽位偏移升序(0..N-1)四部分构成。该工具最终会还原每个VM指令的参数符号化来源以及对应的物理寄存器(无法识别的情况为?,该情况为占位空闲/不稳定槽,后续会被二次覆盖),具体栈机模型如下图所示:
第一个 VM 行为分析 scytale_permutation函数,这是我们在还原时会遇到的第一个VM函数,现在来尝试还原第一个VMTrace,该函数会产生3个VMTrace,意味着VMP三次进入虚拟机,三次退出完成目标。总计3个VM函数。
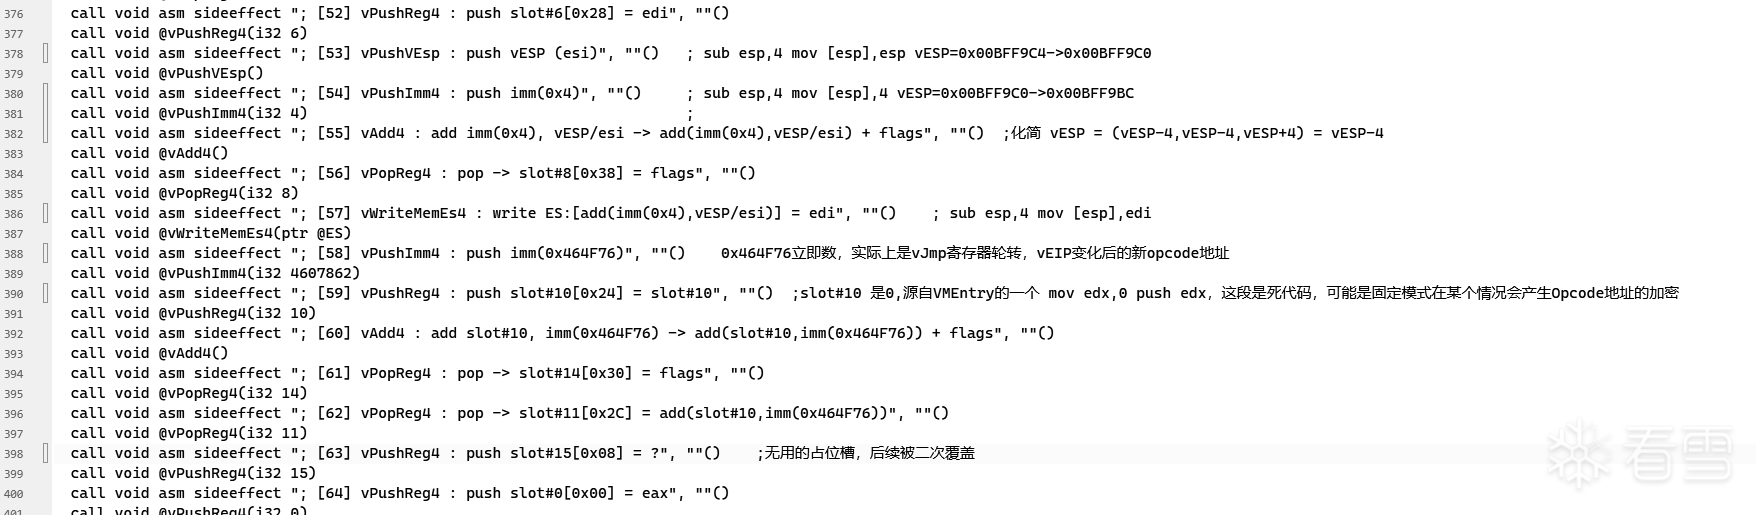
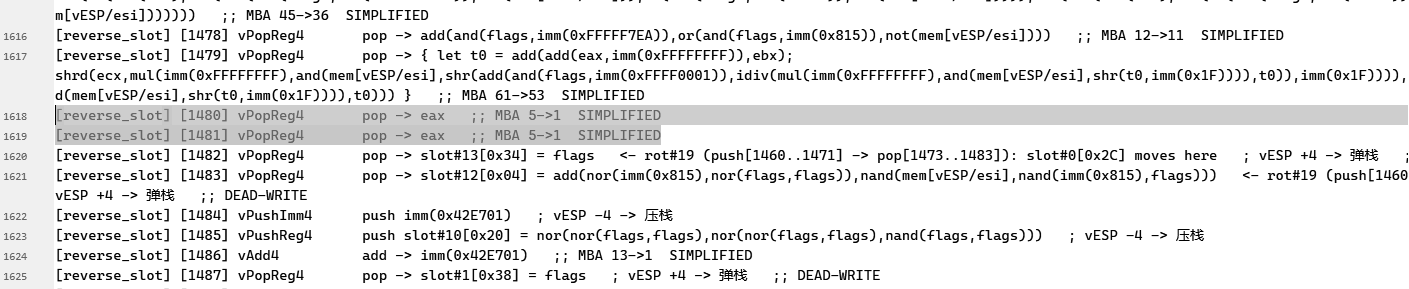
VMEntry后初始化完VMContext,有一系列关于vESP的操作代码,由于我们的栈机模拟工具追踪了handler的完整参数符号化来源,所以很多代码都不需要去看,因为那是MBA混淆的一部分。只需要看最后一个有效的handler就可以观察完整的MBA混淆后的代码了。同时注意到VMKeyRet(VM在push vKey call xxx)时产生的返回地址没有被用到,这意味着VMKeyRet这个槽是无用槽,可直接被优化掉。
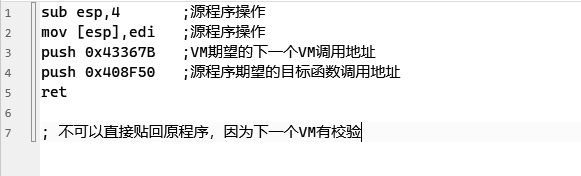
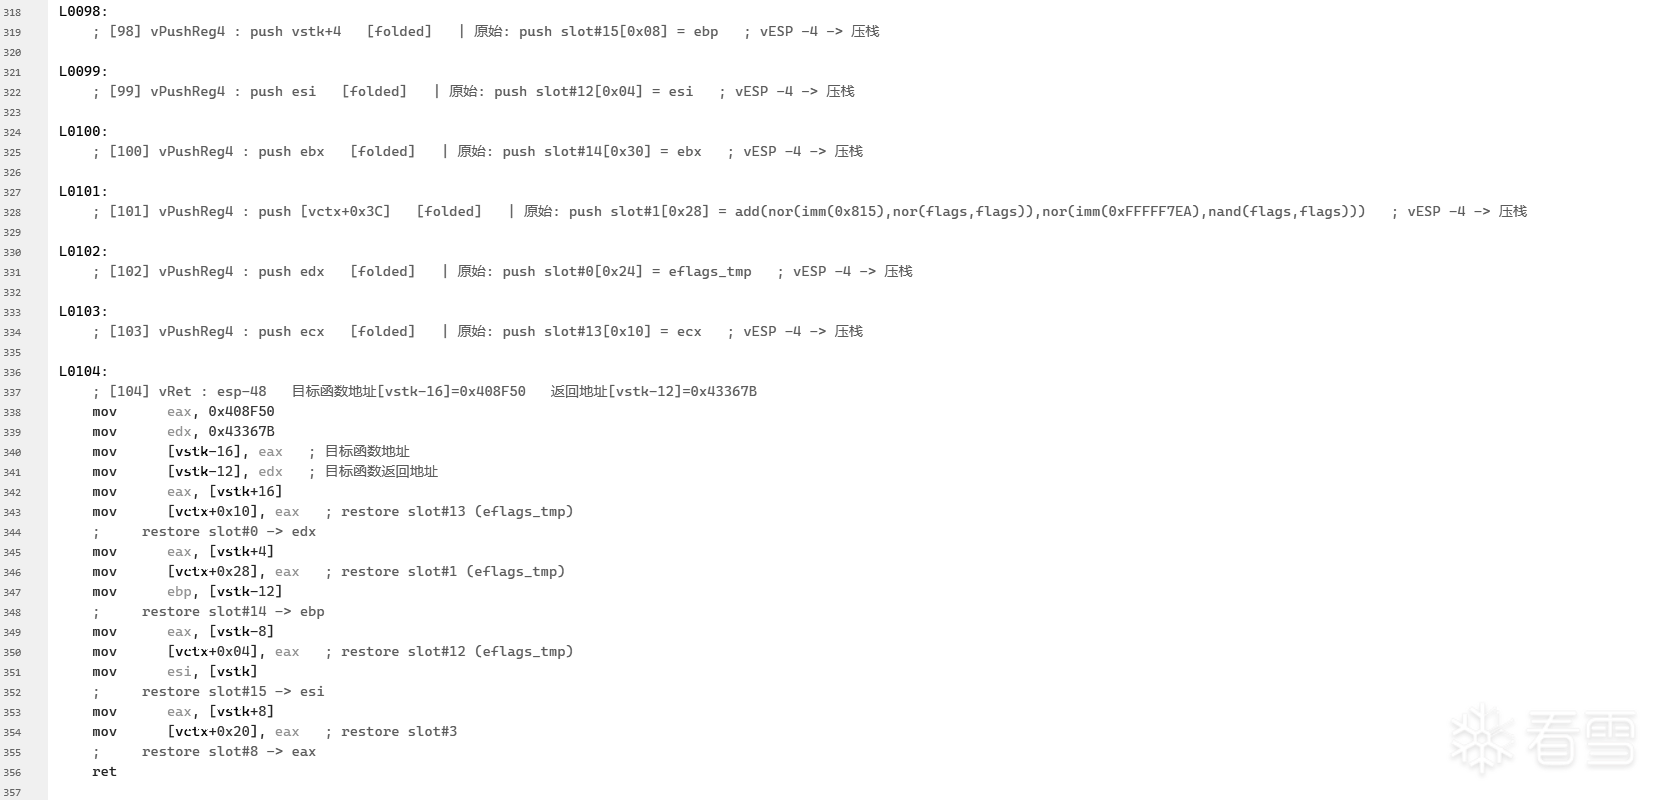
sub esp,4;mov [esp],edi。然后发生了槽轮转。
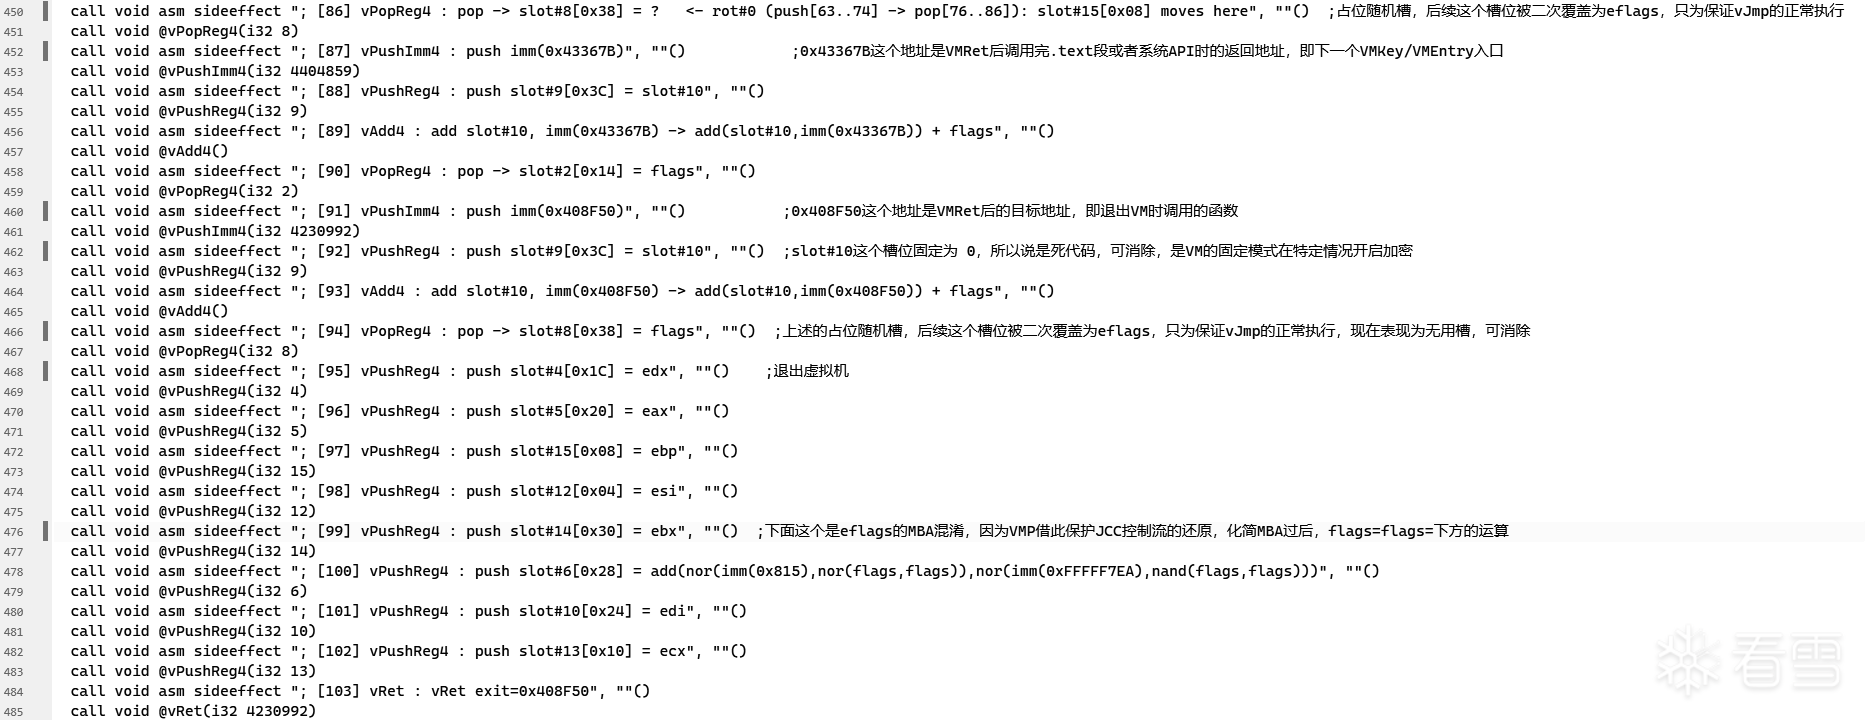
0x43367B这个地址是VMRet后调用完.text段或者系统API时的返回地址,即下一个VMKey/VMEntry入口。0x408F50这个地址是VMRet后的目标地址,即退出VM时调用的函数。然后还有关于flags的MBA混淆,实际上这条指令没有带来任何的变化,可化简为flags=falgs。因为VMP借此保护JCC控制流的还原,化简MBA过后。同时还注意到;slot#10这个槽位固定为 0,所以说是死代码,可消除,是VM的固定模式在特定情况开启加密。(来自于VMEntry的mov edx,0; push edx)
VM的行为:不过值得注意的是,还原后的汇编无法直接替换第一个VM函数,因为第二个VM函数有校验 。需要同时更改 vEIP为第二个VM函数所需要的Opcode首地址才行。
vJmp 的三种模式 一个是 taken目标地址一个是fail失败时地址,往回跳转的便是循环结构,反之这是普通的条件分支。(在分析循环的时候忘记条件跳转时产生的错误结论: 一个是 Opcode头部、一个是Opcode尾部 。 ) 如果判断要跳出循环则依赖传入一个新的 handler地址与0x815之类的掩码计算。如果是寄存器轮转,则直接传入下一条handler地址。
vJmp的参数有俩个,分别为 Opcode地址、NextHandler。如果是循环,NextHandler就直接在编译期算好,从vEIP取出来就行了但需要传Opcode地址。如果不是循环,Opcode地址就在编译期算好,需要传个NextHandler。
指令模式与 Handler分配机制表
模式
Opcode 地址
NextHandler
典型场景
( 错误) 循环 back-edge
运行时压栈传入( vPushImm4)
编译期定,从 vEIP 取立即数
循环体末尾跳回循环头
条件跳转
运行时压栈传入( vPushImm4)
编译期定,从 vEIP 取立即数
条件跳转
顺序流
编译期定,从 vEIP 取立即数
运行时压栈传入
普通指令顺序执行
寄存器轮转
编译期定
编译期定(直接传下一 handler 地址)
handler 轮换,无需运行时解析
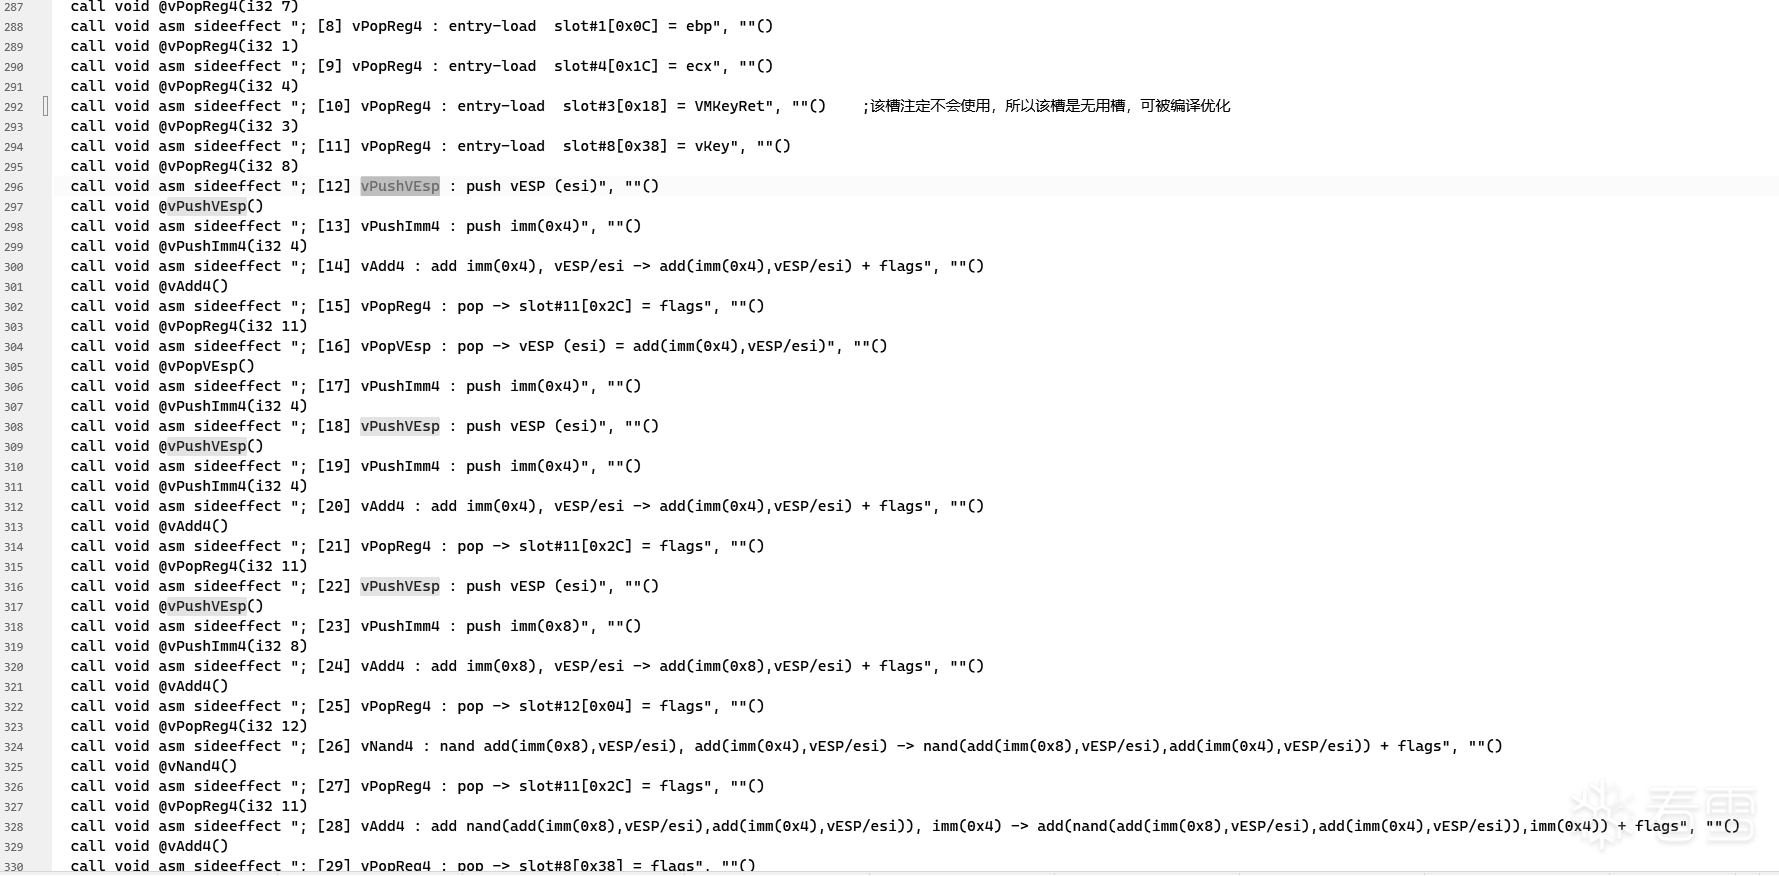
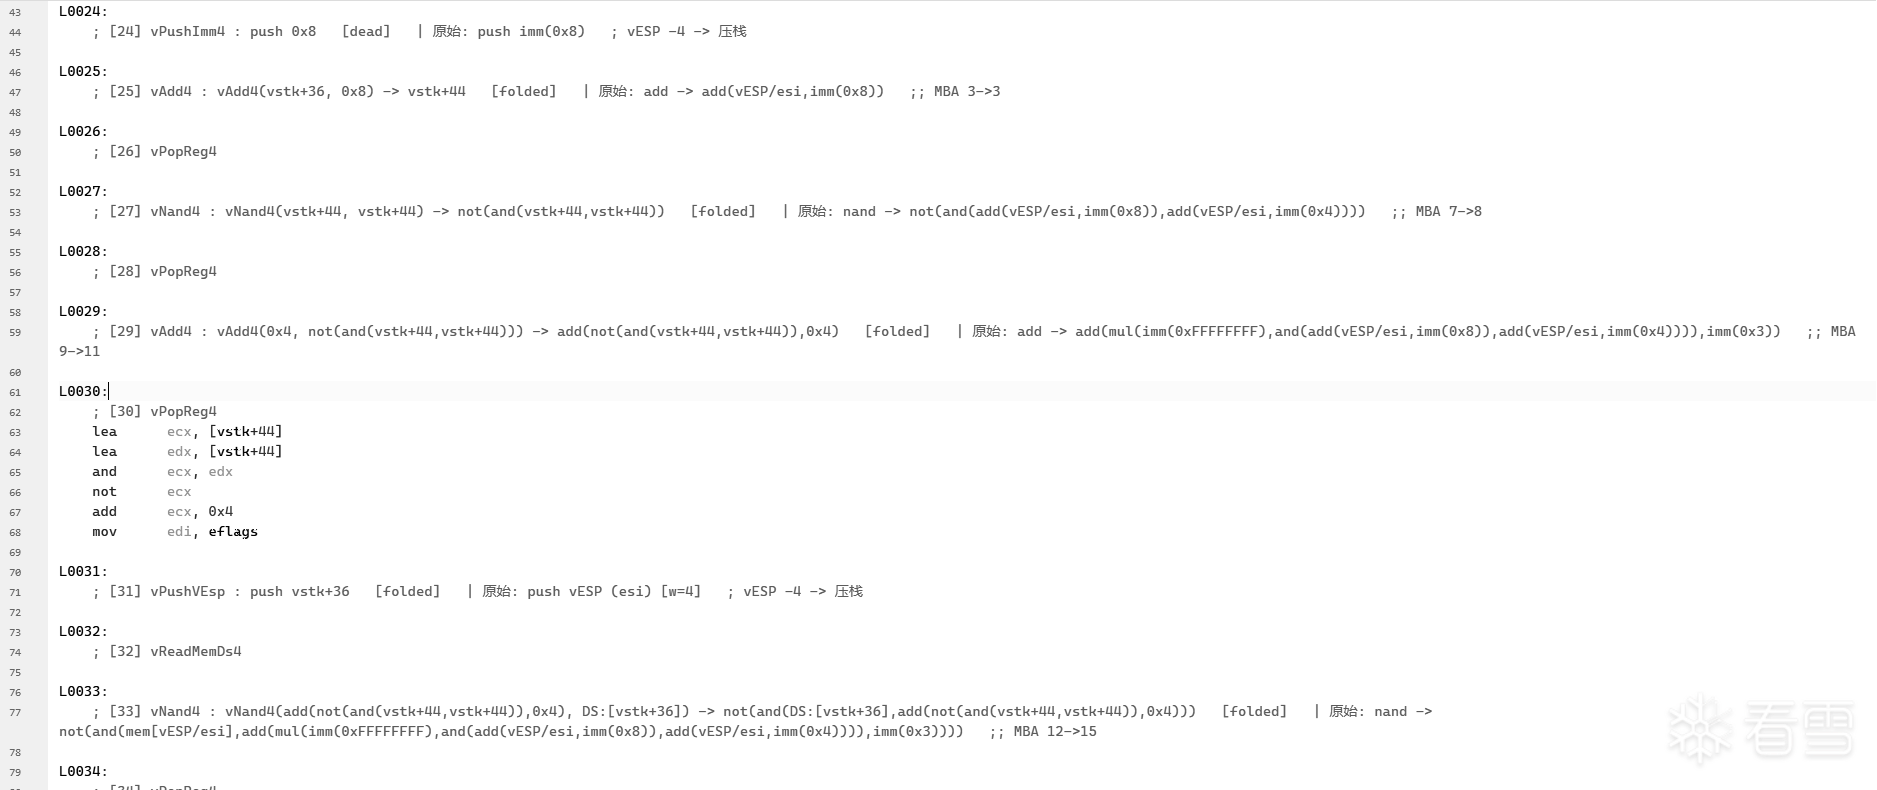
降级二级指令 push 、 pop 为基于一级指令 sub add 的表达 vPush、vPop前缀算子对栈的副作用,即push在32bit下会让esp-4、而pop会让esp+4。如果不做修复,我们将无法还原函数的参数传递等一系列基于栈esp的实现内容。
修复二级指令 vPushImm4、vPushReg4、vPushVEsp、vPopReg4为基于一级指令sub add的表达
call void asm sideeffect "; [13] vPushImm4 : push imm(0x1)", ""()
call void @vPushImm4(i32 1)
call void asm sideeffect "; [14] vPushReg4 : push slot#2[0x1C] = eax", ""()
call void @vPushReg4(i32 2)
call void asm sideeffect "; [17] vPopReg4 : pop -> slot#11[----] = flags", ""()
call void @vPopReg4(i32 11)
call void asm sideeffect "; [20] vPushVEsp : push vESP (esi)", ""()
call void @vPushVEsp()
MBA 化简 VMProtect基于栈实现了MBA混淆,利用GAMBA解混淆同时用z3验证正确性,这里给出GAMBA的适配方案。
降级策略: GAMBA 表达不了或解析不了的算子(mem/ shld / shrd / idiv / mul / sub / pow / shr / shl)先递归化简其参数,再整体登记为一个不透明变量。这样外围 MBA 仍能被化简,且语义严格等价(变量化不改变任何东西,只是让 GAMBA 看不见内部)。
GAMBA的simplify()内部每次化简都起一个 multiprocessing.Process + Manager , 因此内联内部调用函数进行优化 :
方式
285 次化简耗时
simplify_mba() (原 API)
166 秒
gamba_simplify_fast() (内联三步)
0.8 秒
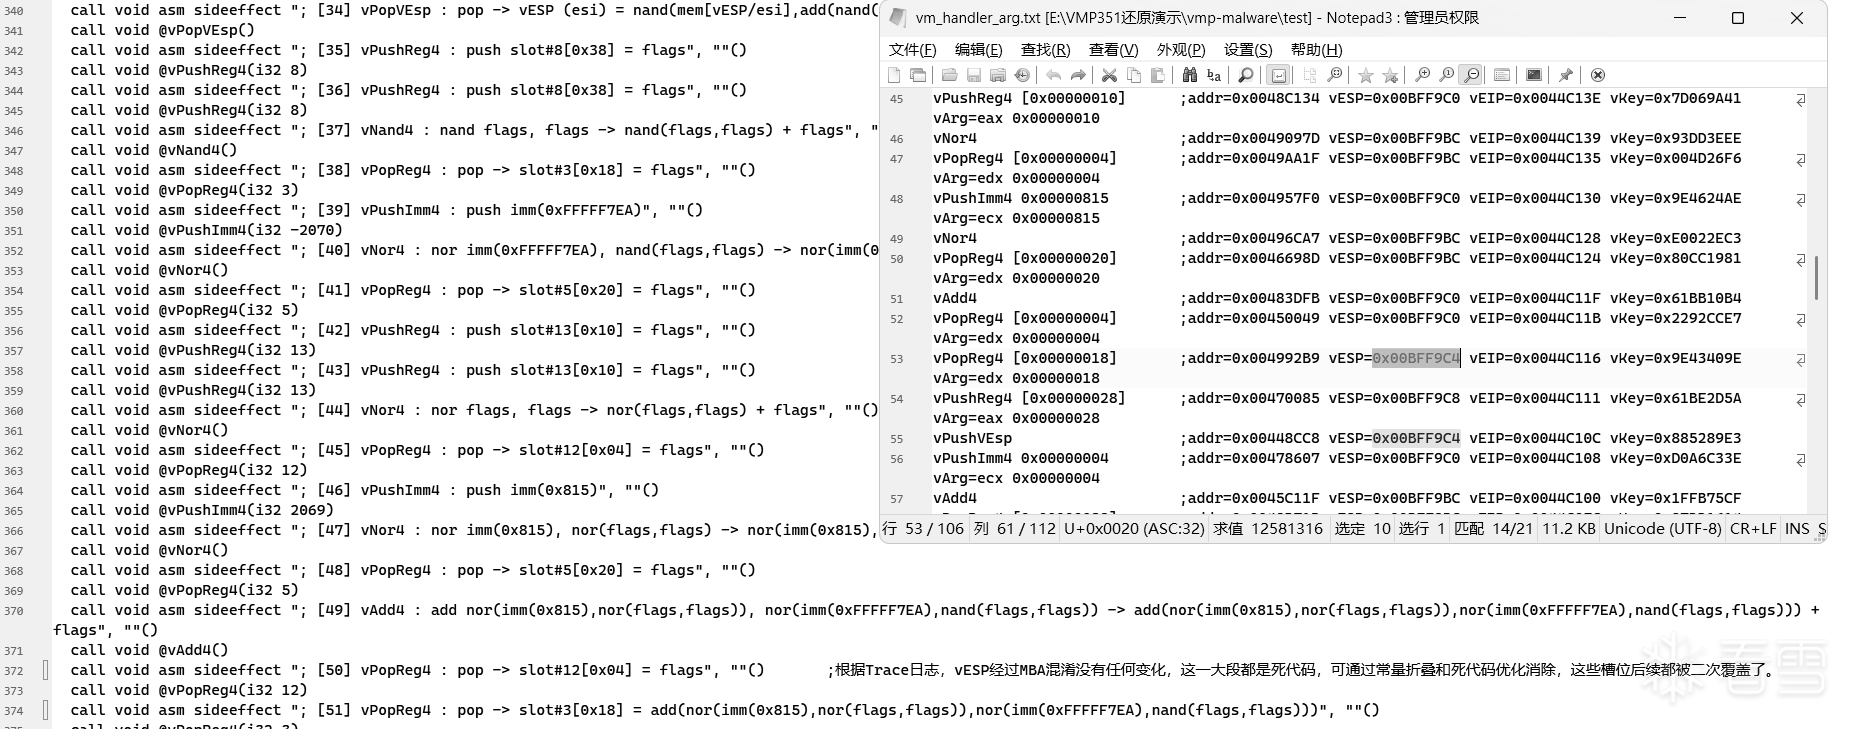
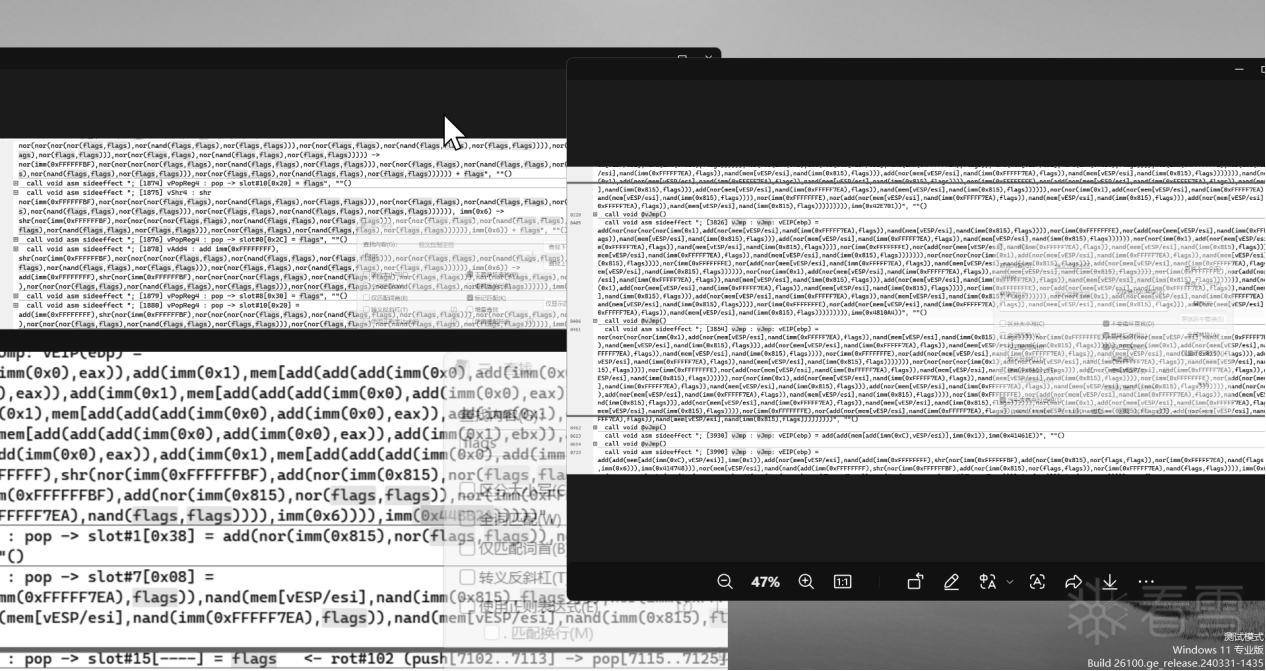
栈帧 SSA 化消除死代码产生伪汇编 push、pop为基于一级指令sub add的表达,以及其他handler关于esp变化都正确的基础上,我们可以针对VMProtect栈机产生的变量进行活跃分析,前提是将栈帧SSA化。在死代码消除的基础上,我们根据栈机的特性,指定一个规则PUSH、AUL(位运算)不生成指令,只在栈上记值;直到 pop 到寄存器/写内存/控制流边界(vJmp)时,才把整条表达式折叠成以目标寄存器为目的的指令序列。这样 push 0xFFFFF7EA 会变成 and eax, 0xFFFFF7EA 里的立即数操作数。同时需要注意如何防止死代码消除删掉栈里的参数 , 如下方第三张图所示。
伪汇编 2LLVMIR
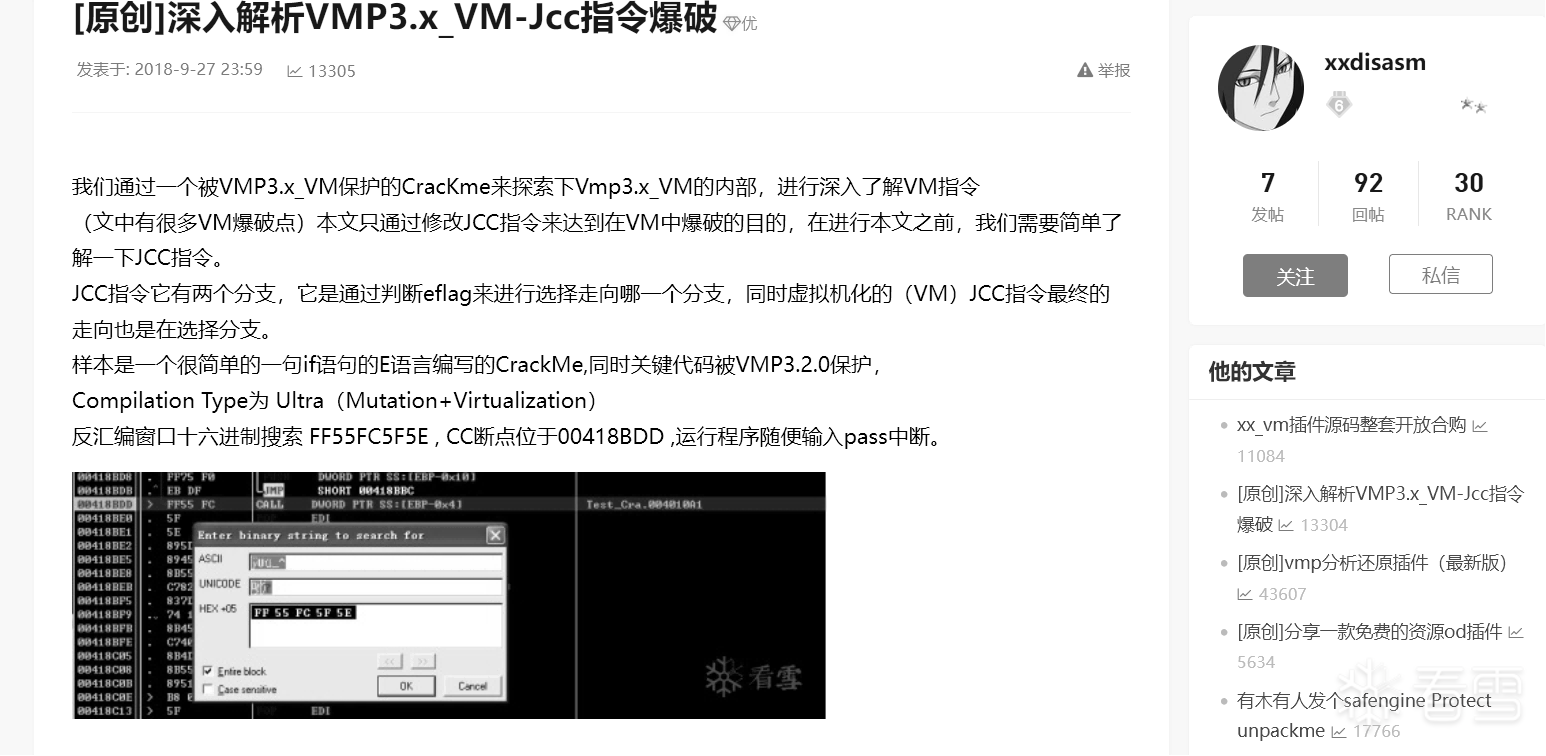
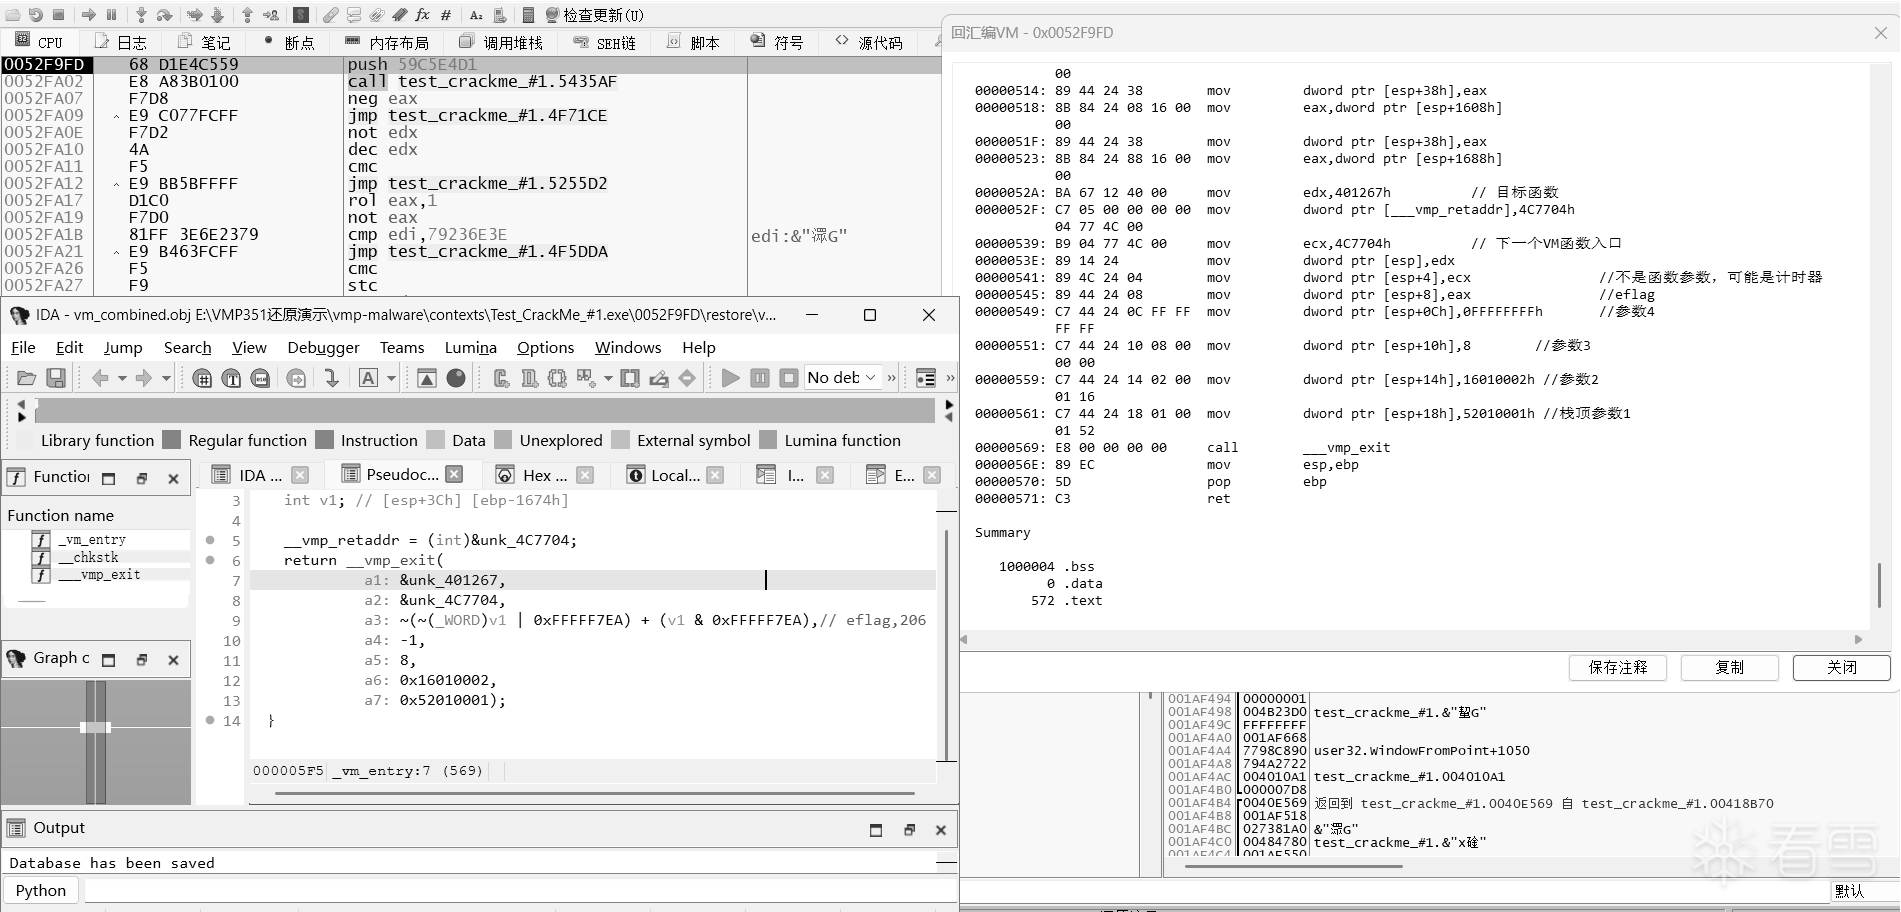
xxvm 的 demo 还原 VM的能力了,由于我们借鉴了xxvm的经验,所以用他的demo(https://bbs.kanxue.com/thread-247040.htm/ [原创]深入解析VMP3.x_VM-Jcc指令爆破 )进行测试,后续再还原我们相对复杂的古典加密算法CrackMe。第一个函数0052F9FD如下图所示,IDA参数顺序反了,原因是2LLVMIR对函数参数的解析顺序反了,这就导致了显示异常。第一个VM函数为读取serial内容,这里输入了“123,123“
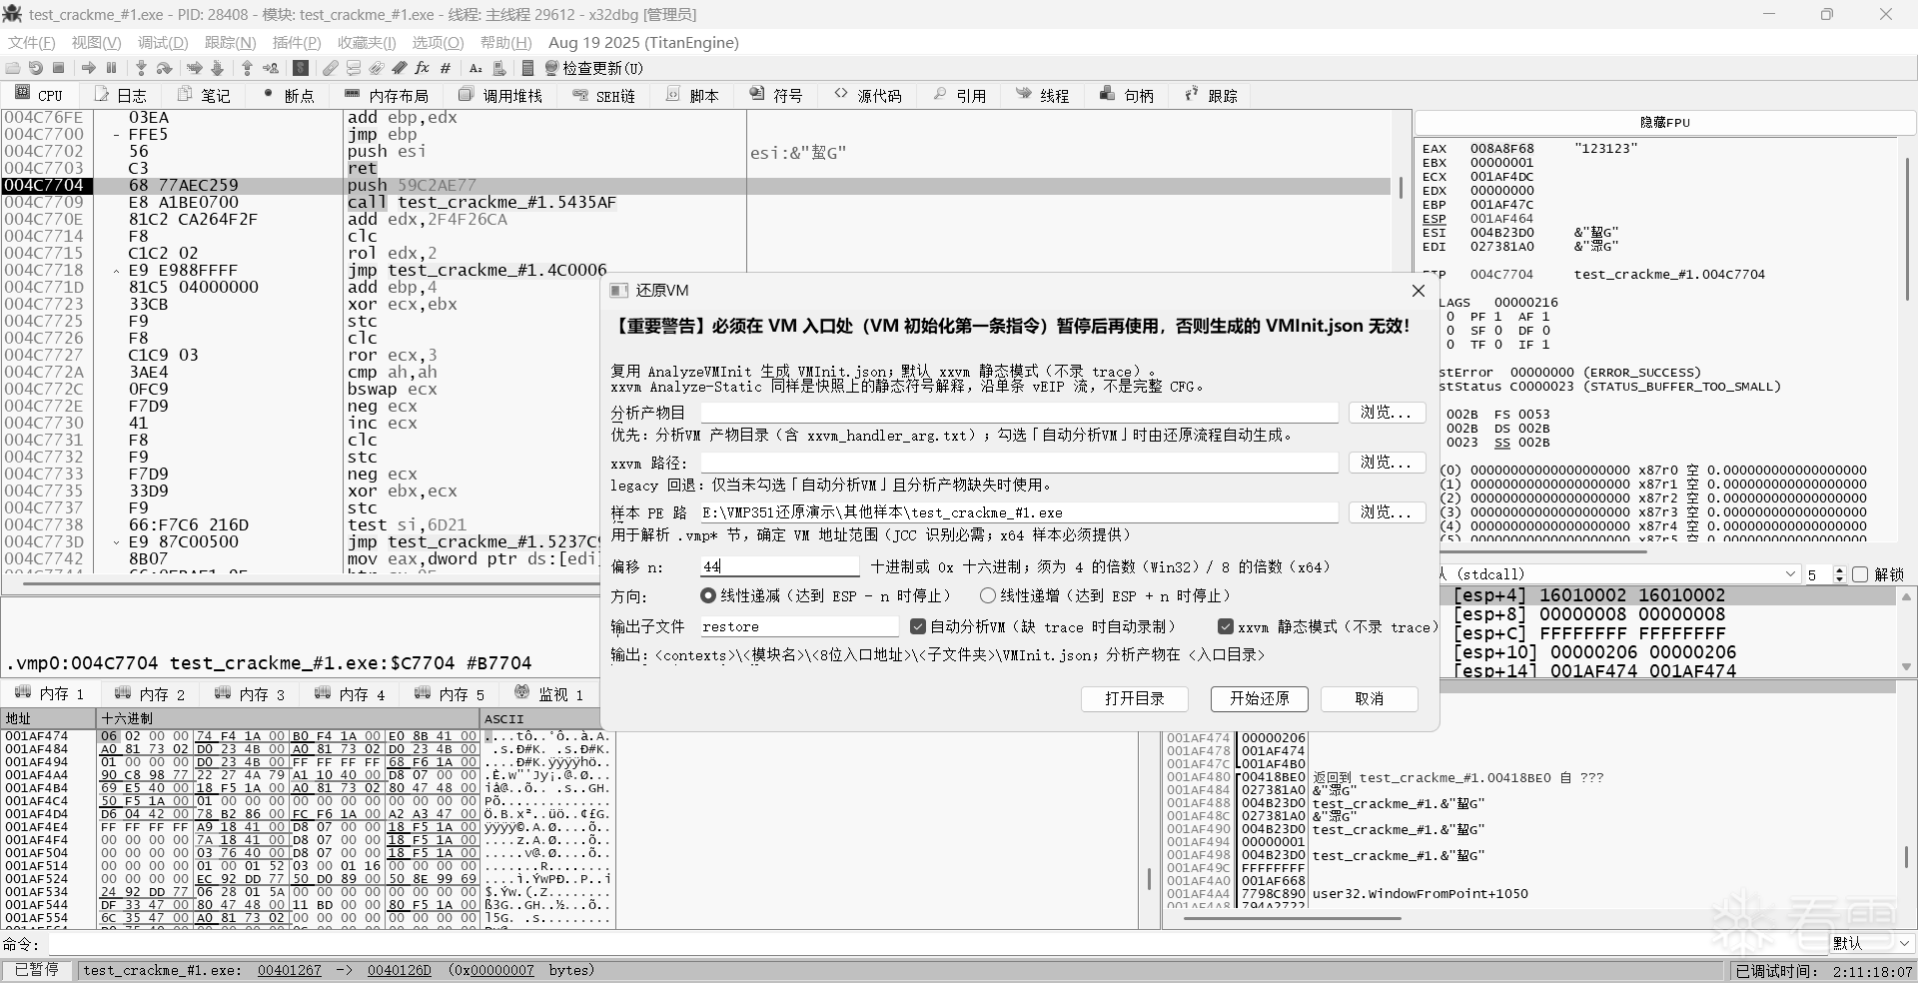
VM,到下一个VM函数入口004C7704下断,此时Dbg的寄存器窗口EAX已经变为了“123123”,我们右键插件malware->vmp3.x->还原VM,只需要填写偏移n为44(VMP初始化时候所依赖的11个槽)然后点击开始还原即可,默认使用的是xxvm的静态模拟执行模式,如果取消勾选则使用unicorn进行模拟。
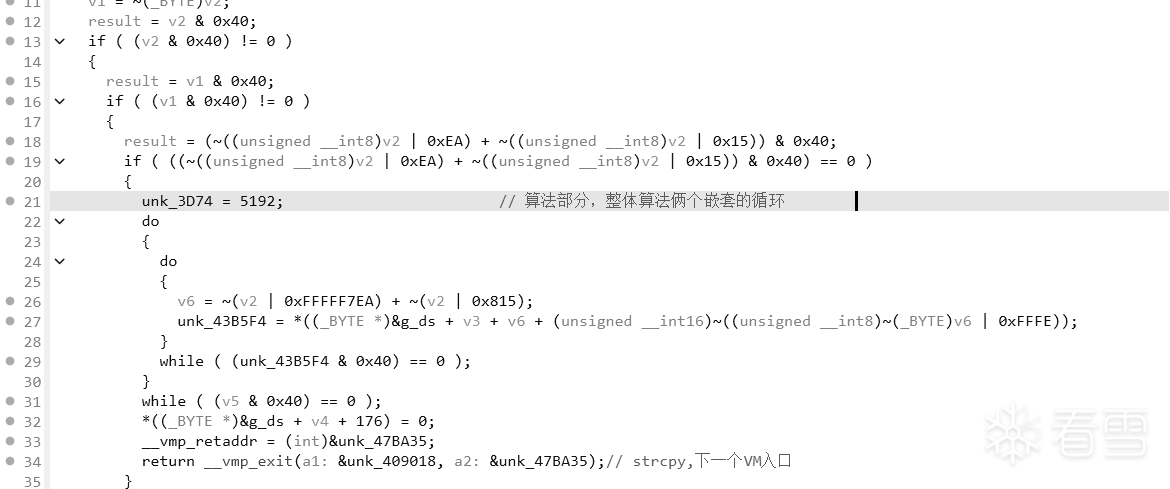
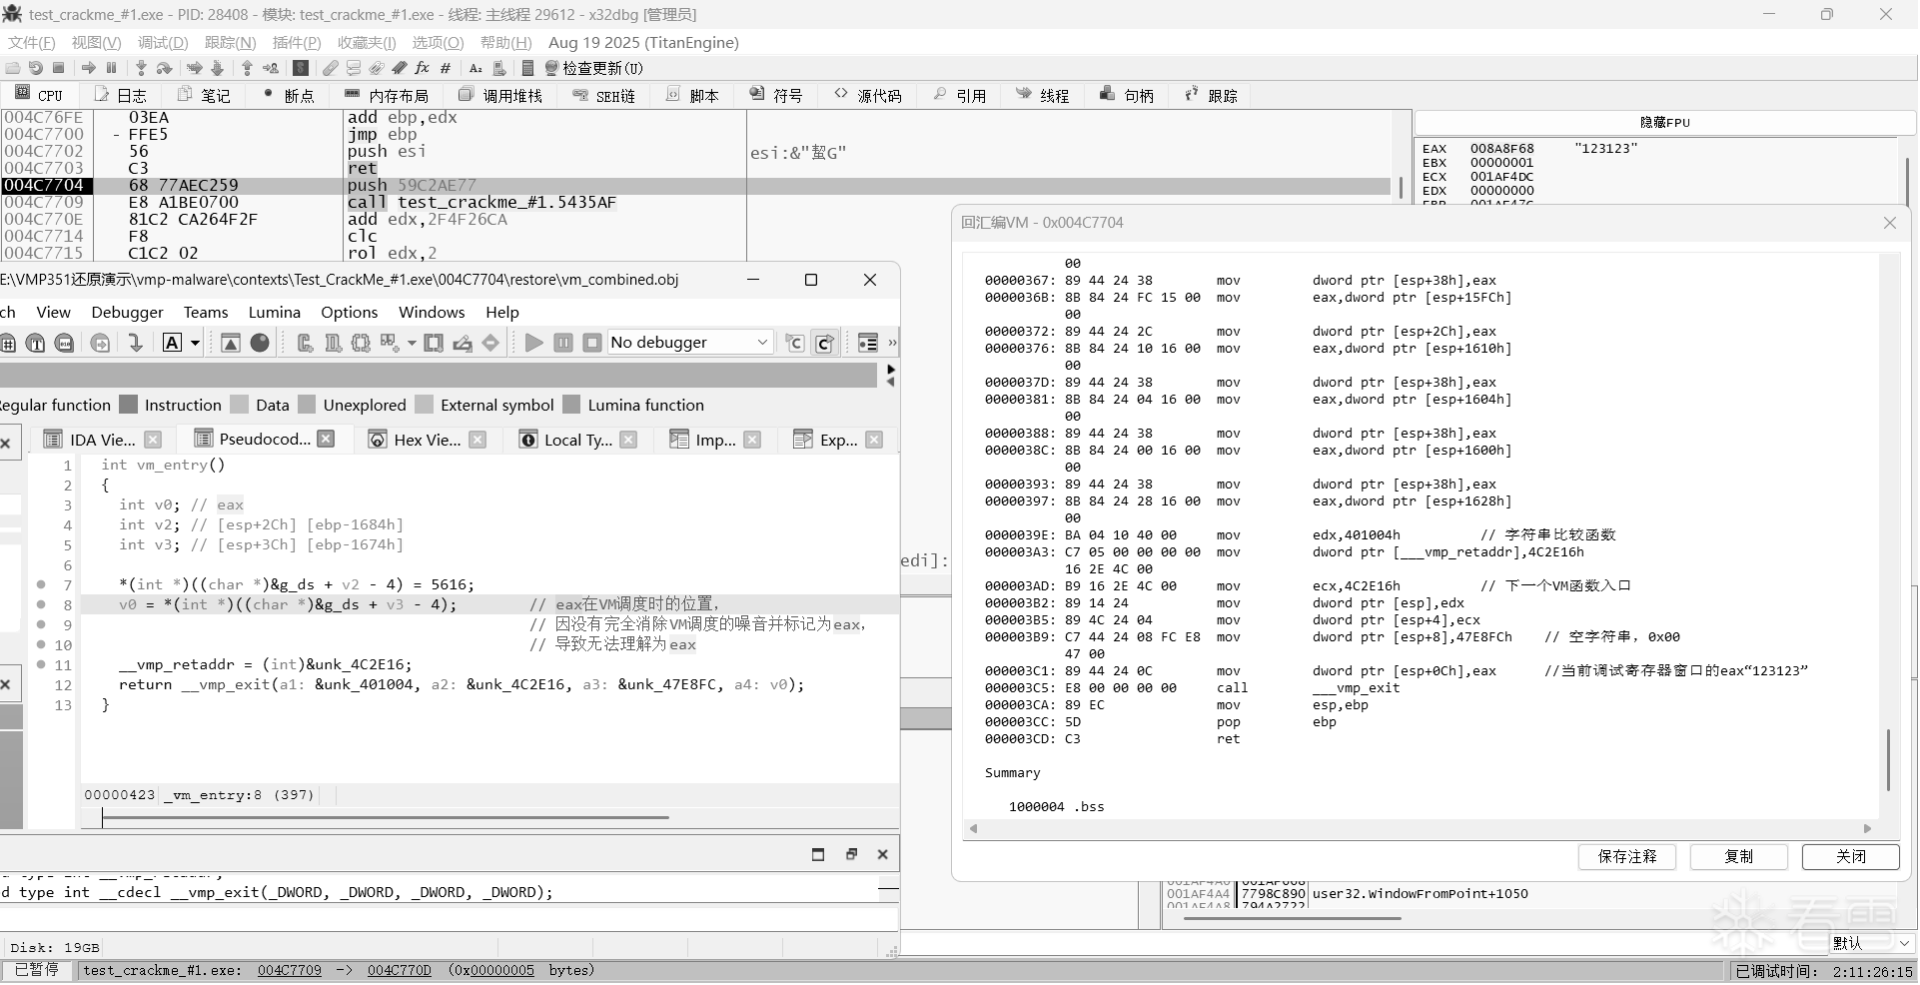
VM函数的执行内容为字符串比较,比较用户输入的serial是否为空,其中IDA反编译的结果存在这样的问题flags在VM调度时的位置,因没有完全消除VM调度的噪音并标记为eflags,导致无法理解(也有可能是寄存器)。
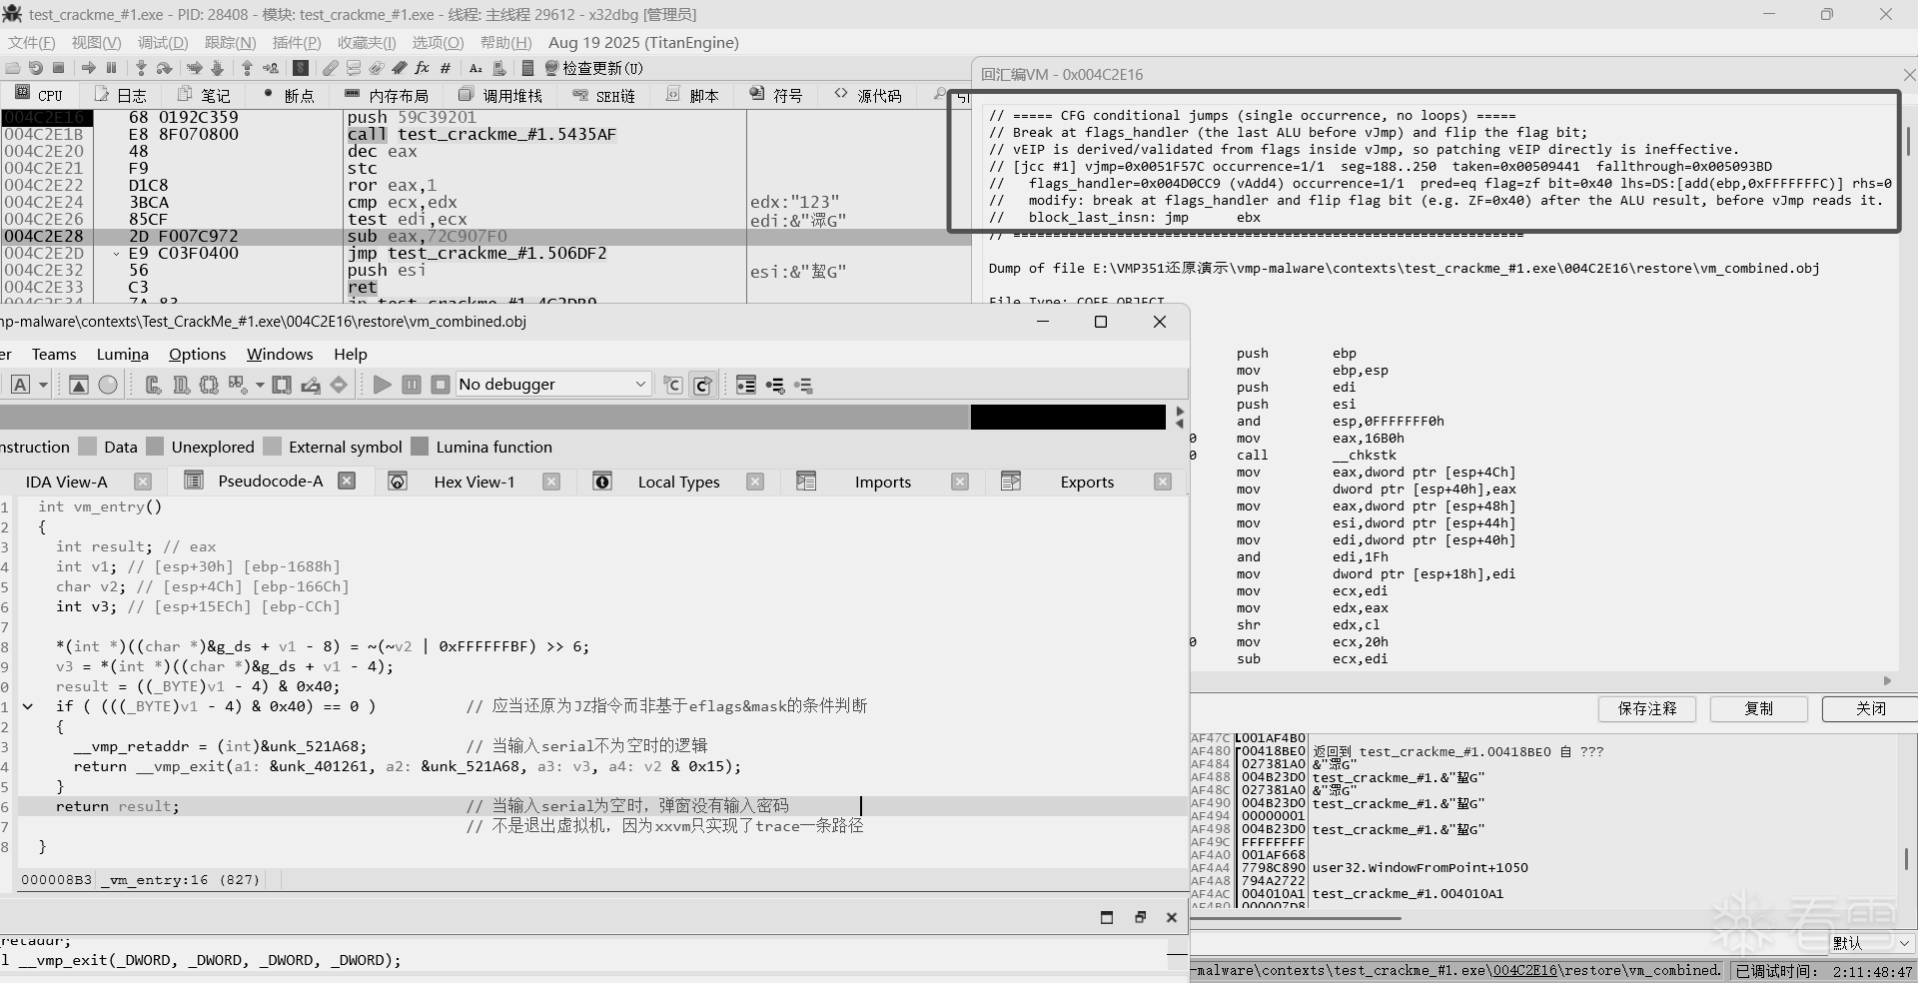
VM函数004C2E16,这里出现了第一个条件跳转,同时IDA反编译结果存在一定的问题,条件跳转应当还原为二级JZ指令而非基于一级指令eflags&mask的条件判断,当输入serial不为空时,调用函数00401261,下一个VM入口,当输入serial为空时,弹窗没有输入密码,不是退出虚拟机,因为xxvm只实现了trace一条路径,只能分析这一条路径的VM功能。
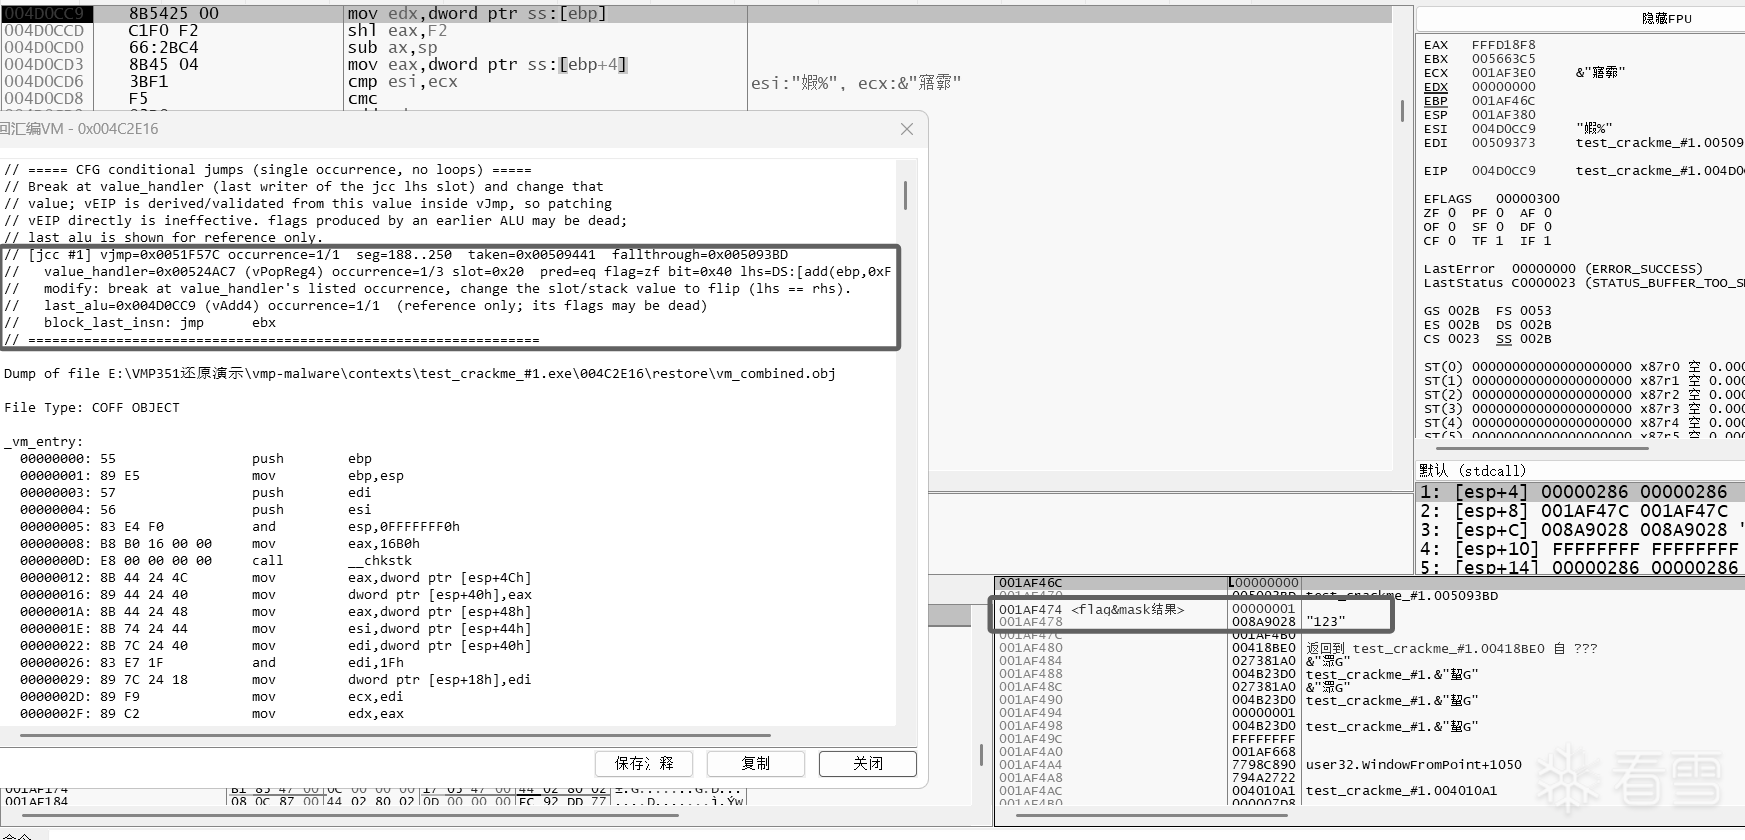
JCC即vJmp的地址和俩个参数Taken、Fail正确和失败时的OpCode地址,以及最后一个计算出eflags的handler地址,可以看到vAdd4,我们可以对其产生的标志位进行修改测试下。
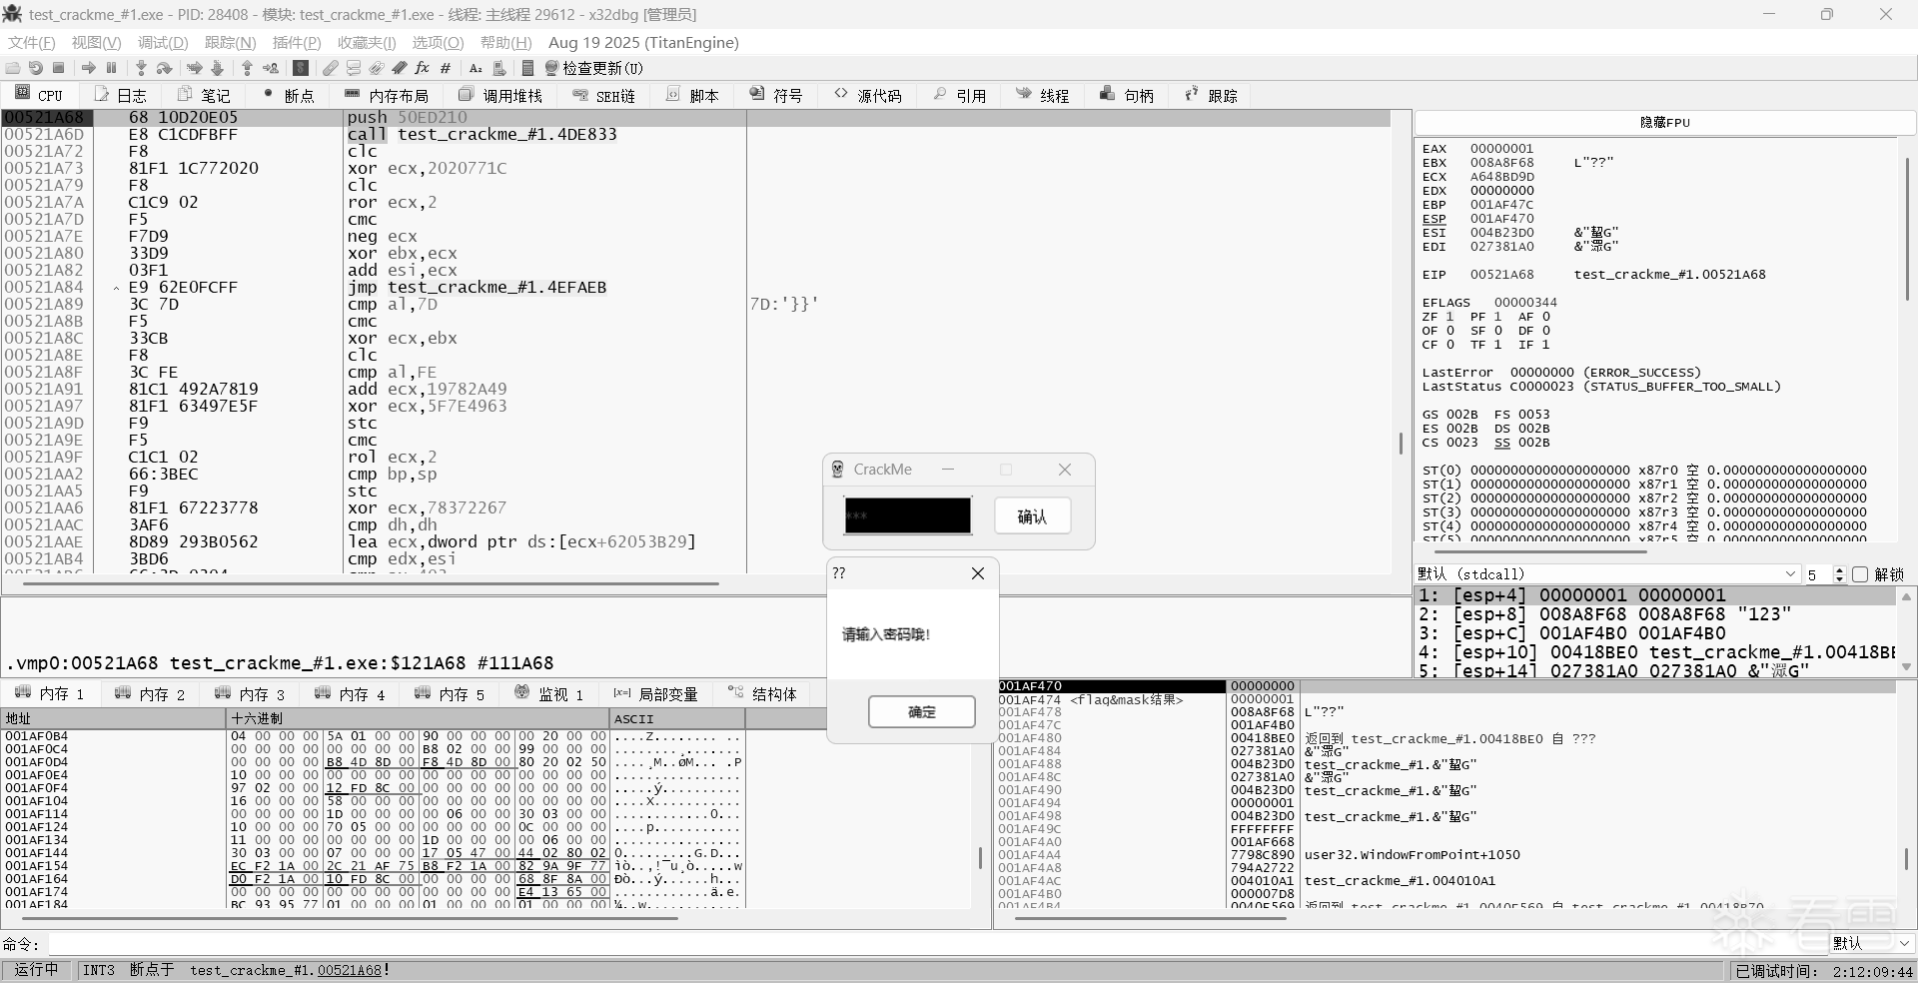
vJmp溯源,可以看到最后一个ALU位运算的handler地址,在栈里将flags&mask的结果取反置为1,可以看到程序成功运行“请输入密码”。
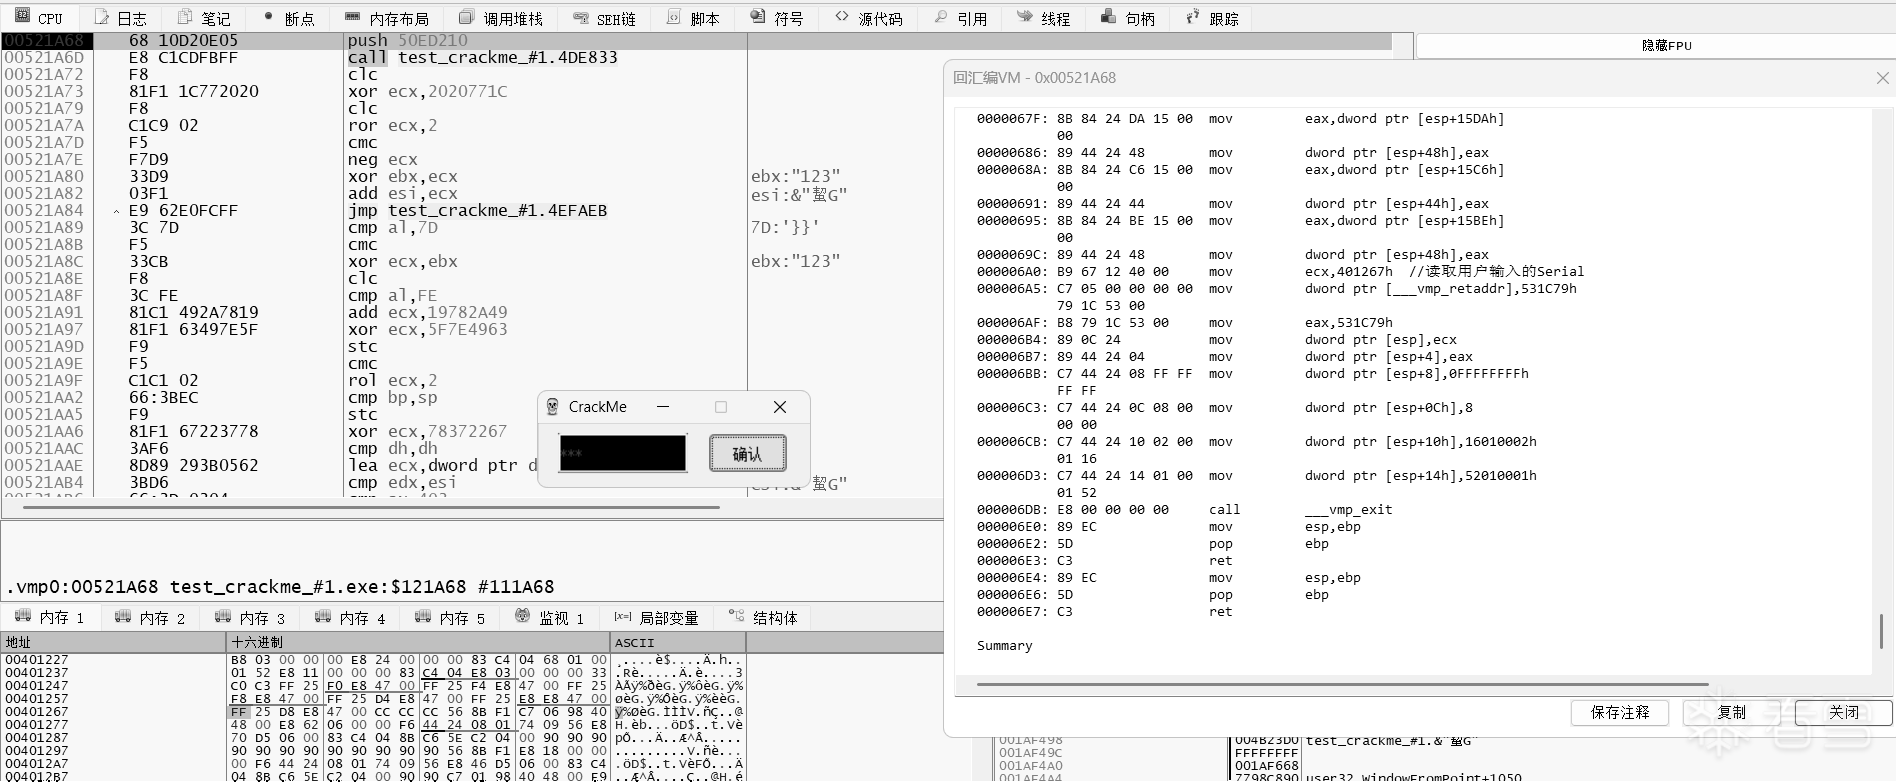
Handler最终执行只执行1次,这说明我们如果要Patch这个程序只需要给004D0CC9这个地址挂hook,给flag&mask的结果强制置为0即可。接下去我们开始分析第四个VM函数00521A68,内容是读取编辑框内容,第五个VM函数地址是531C79。
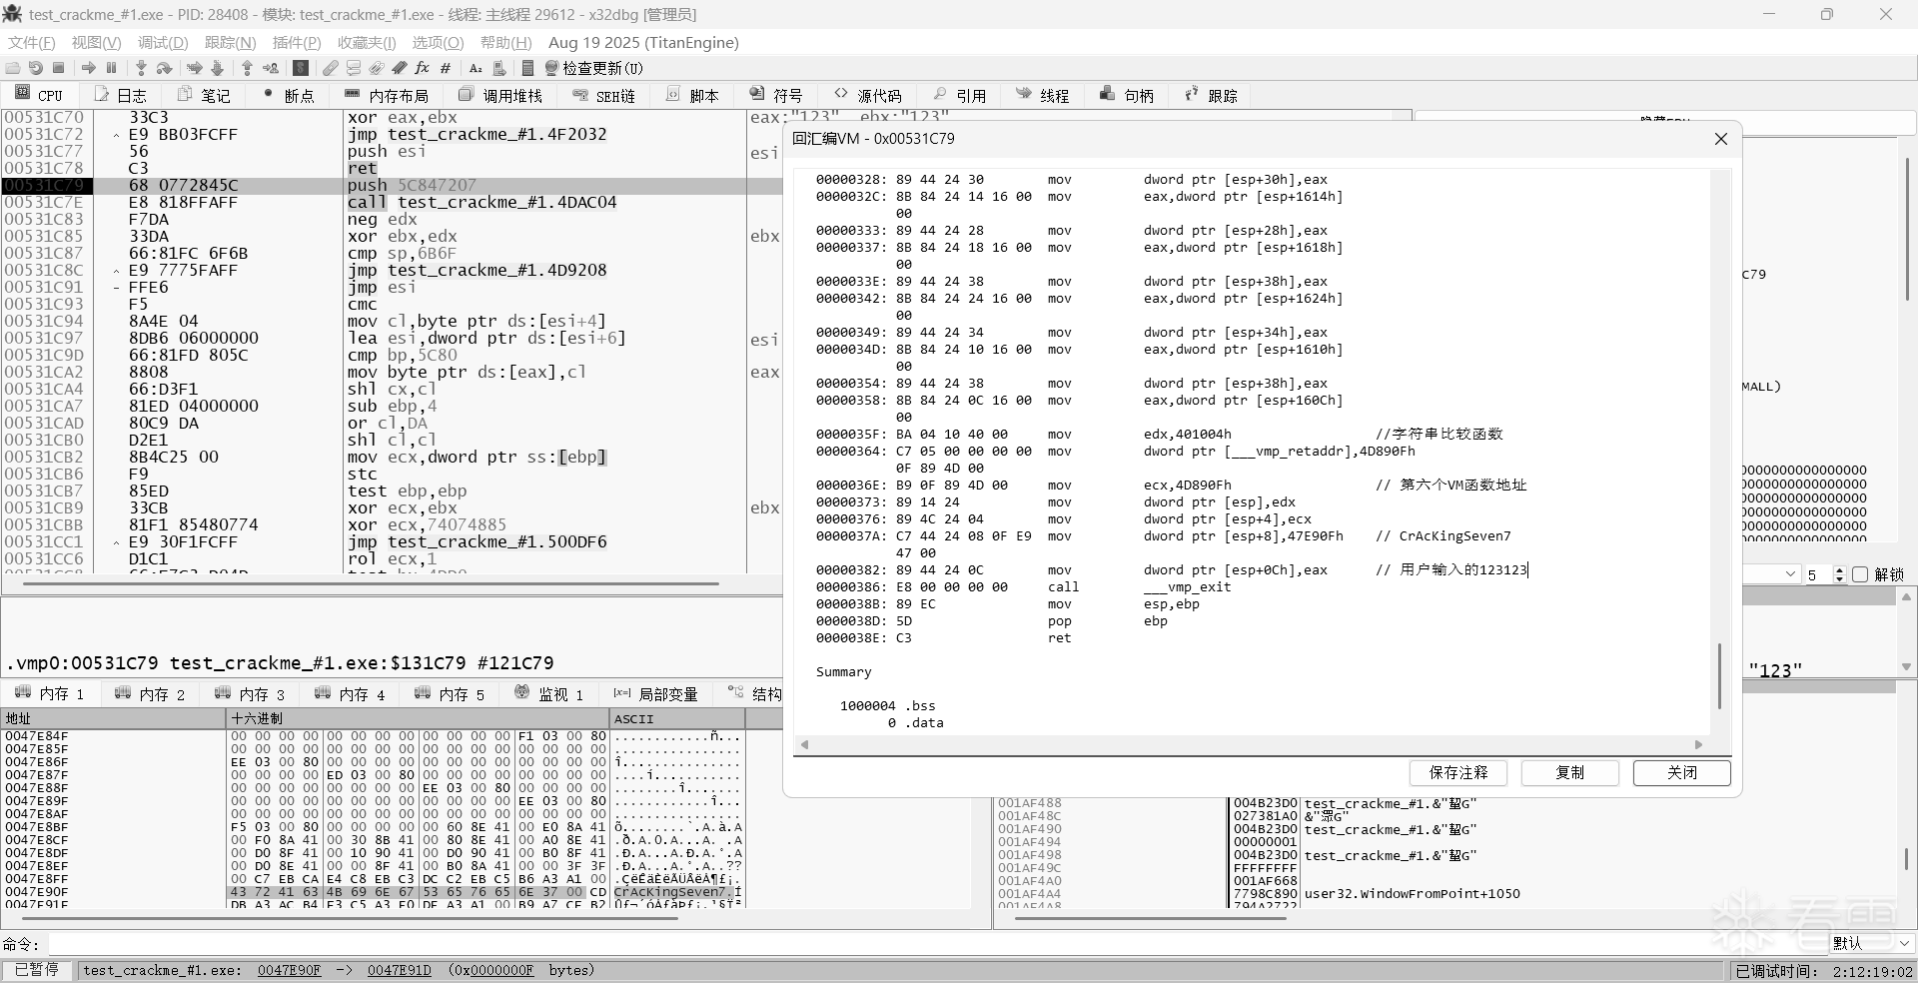
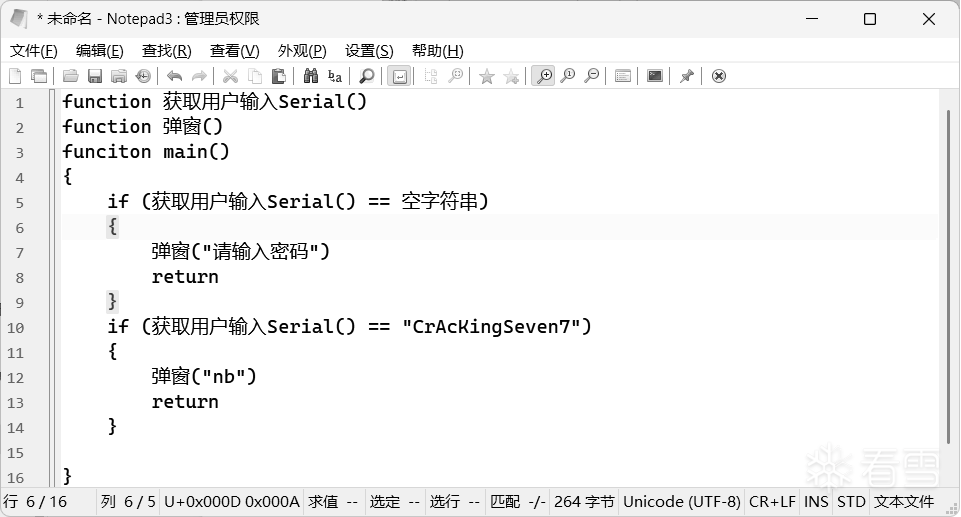
在第五个 VM函数531C79地址下断点,看汇编,程序行为是调用字符串比较函数,传入CrAcKingSeven7和用户输入的“123123”进行比较。
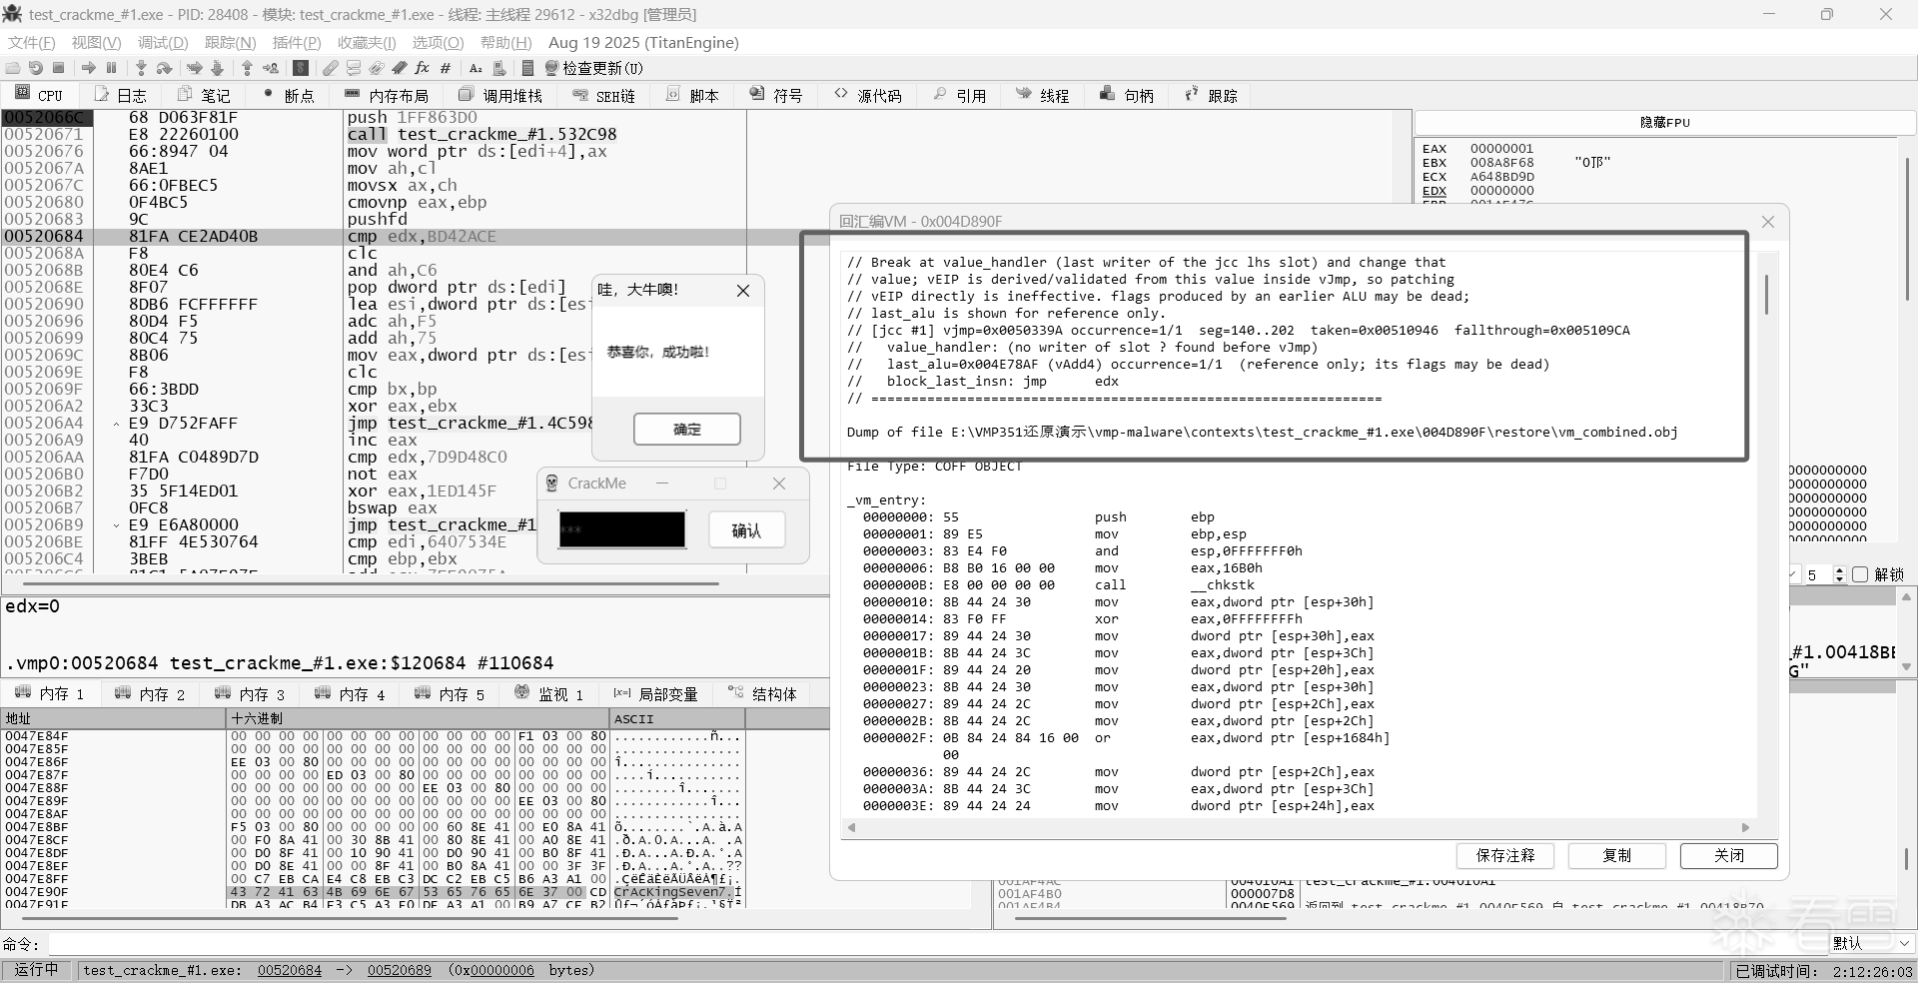
VM函数004D890F地址下断点,可以看到有个条件跳转,在最后一个产生eflags的ALU位运算handler对产生的flags&mask置为1,代表着我们输入的内容与预期的字符串相同。当然,如果你知道另一个Opcode的地址,可以直接在vJmp挂Hook进行操作,把 [vSP] 直接改成 taken/fail,实现vEIP的劫持(更为稳定但缓慢的方式是溯源产生影响跳转的eflags的ALU指令,对zf位取反)。
可以看到,程序弹窗, “哇,大牛逼!恭喜你,成功啦!”。
xxvm的demo程序。
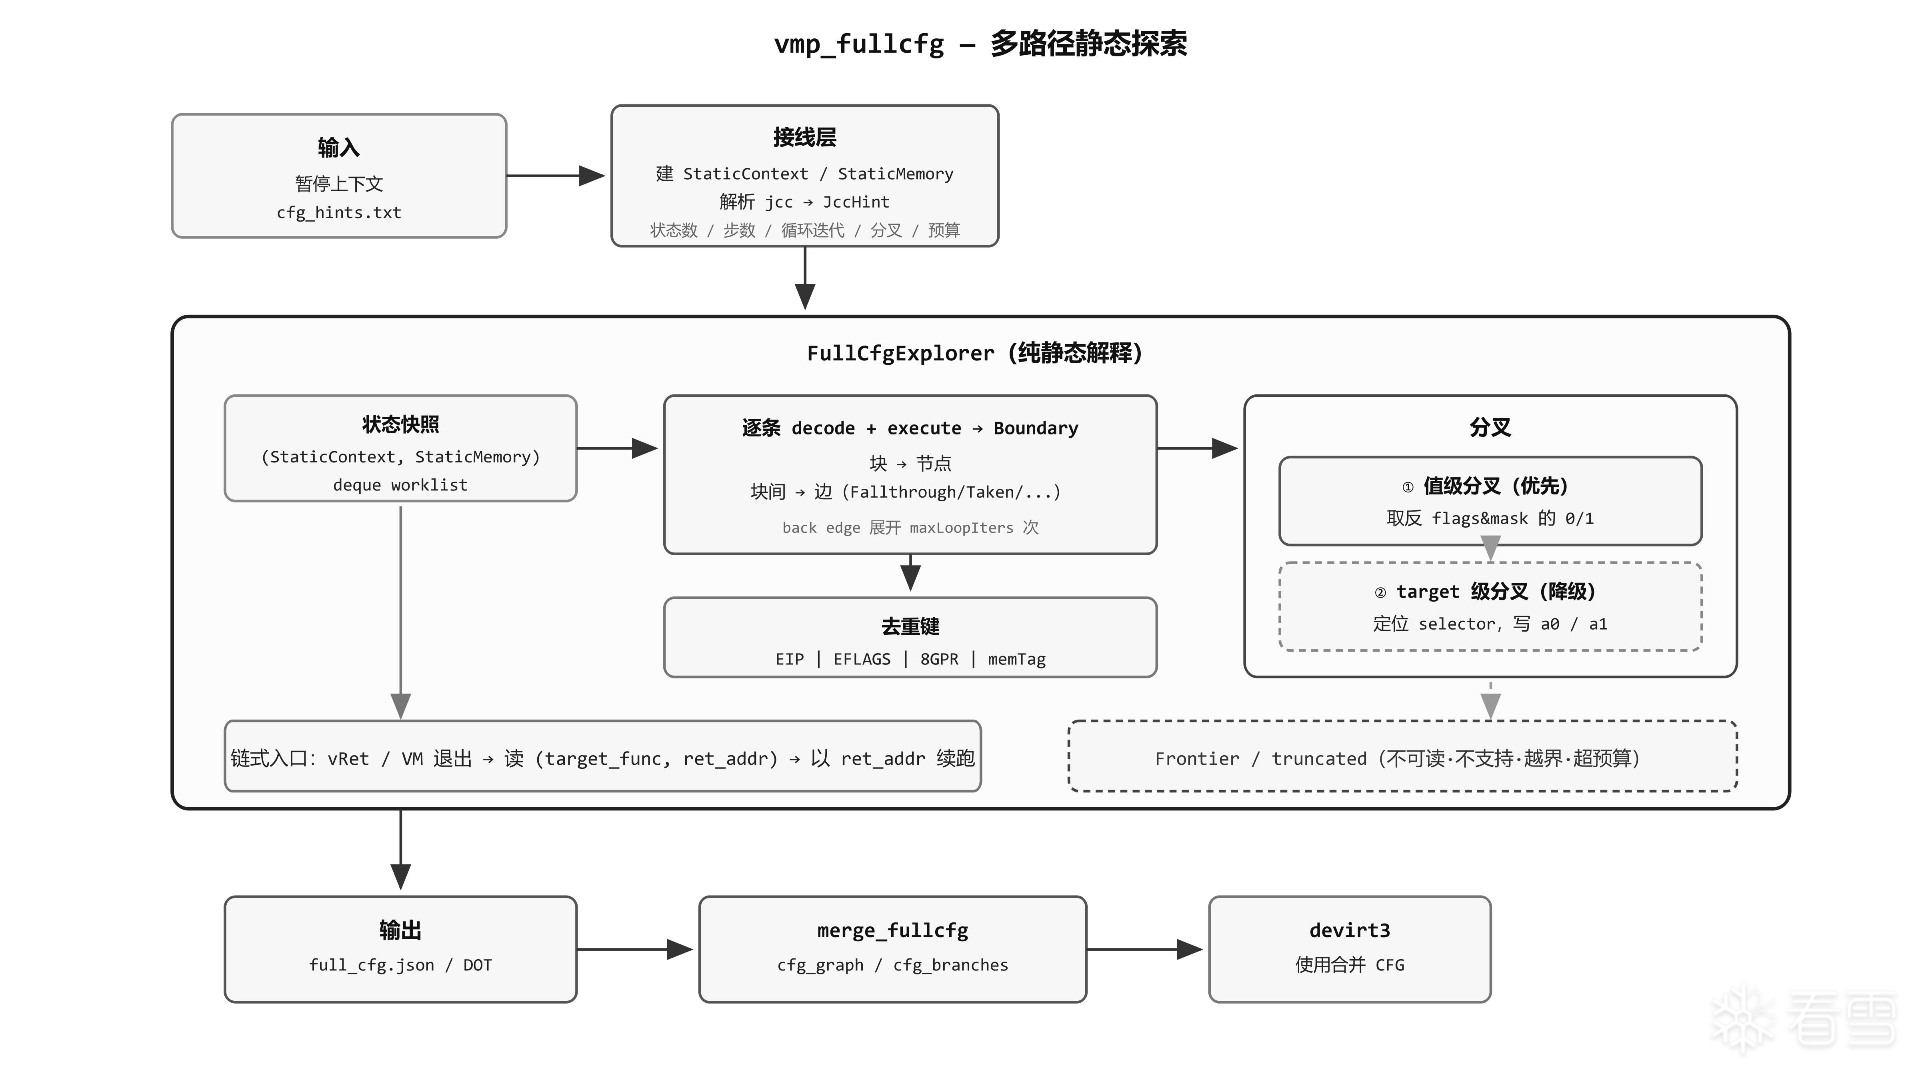
全部分支模拟 VM函数的完整逻辑,就需要解决xxvm本身只模拟一条Trace路径导致CFG不完整的问题。根据上述手动修改VM中条件跳转的方法,先模拟一条Trace,识别出条件跳转结构,知道另一个Opcode的地址,保存快照,在vJmp挂Hook进行操作把 [vSP] 直接改成 taken/fail,实现vEIP的劫持。更为稳定但缓慢的方式是溯源产生影响跳转的eflags的ALU指令,对zf位进行取反。最终模拟出另一条分支。然后循环往复,做好去重即可拿到程序被VM的全部分支。但需要注意的是,这仅是模拟一个局部VM的全部分支,在vRet后需要在同步vEIP的基础上进一步地模拟下一个VM入口才能逐步还原整个VM函数的控制流。
VM 调度结构 GAMBA化简了大量的MBA混淆,虽然程序当中依然存在一些不透明的变量导致MBA混淆没有化简。并利用伪汇编将其转为LLVMIR。
LLVM的alloca特性让线性的LLVMIR得以不断地常量折叠与化简,最终移除掉VMProtect的寄存器轮转结构。
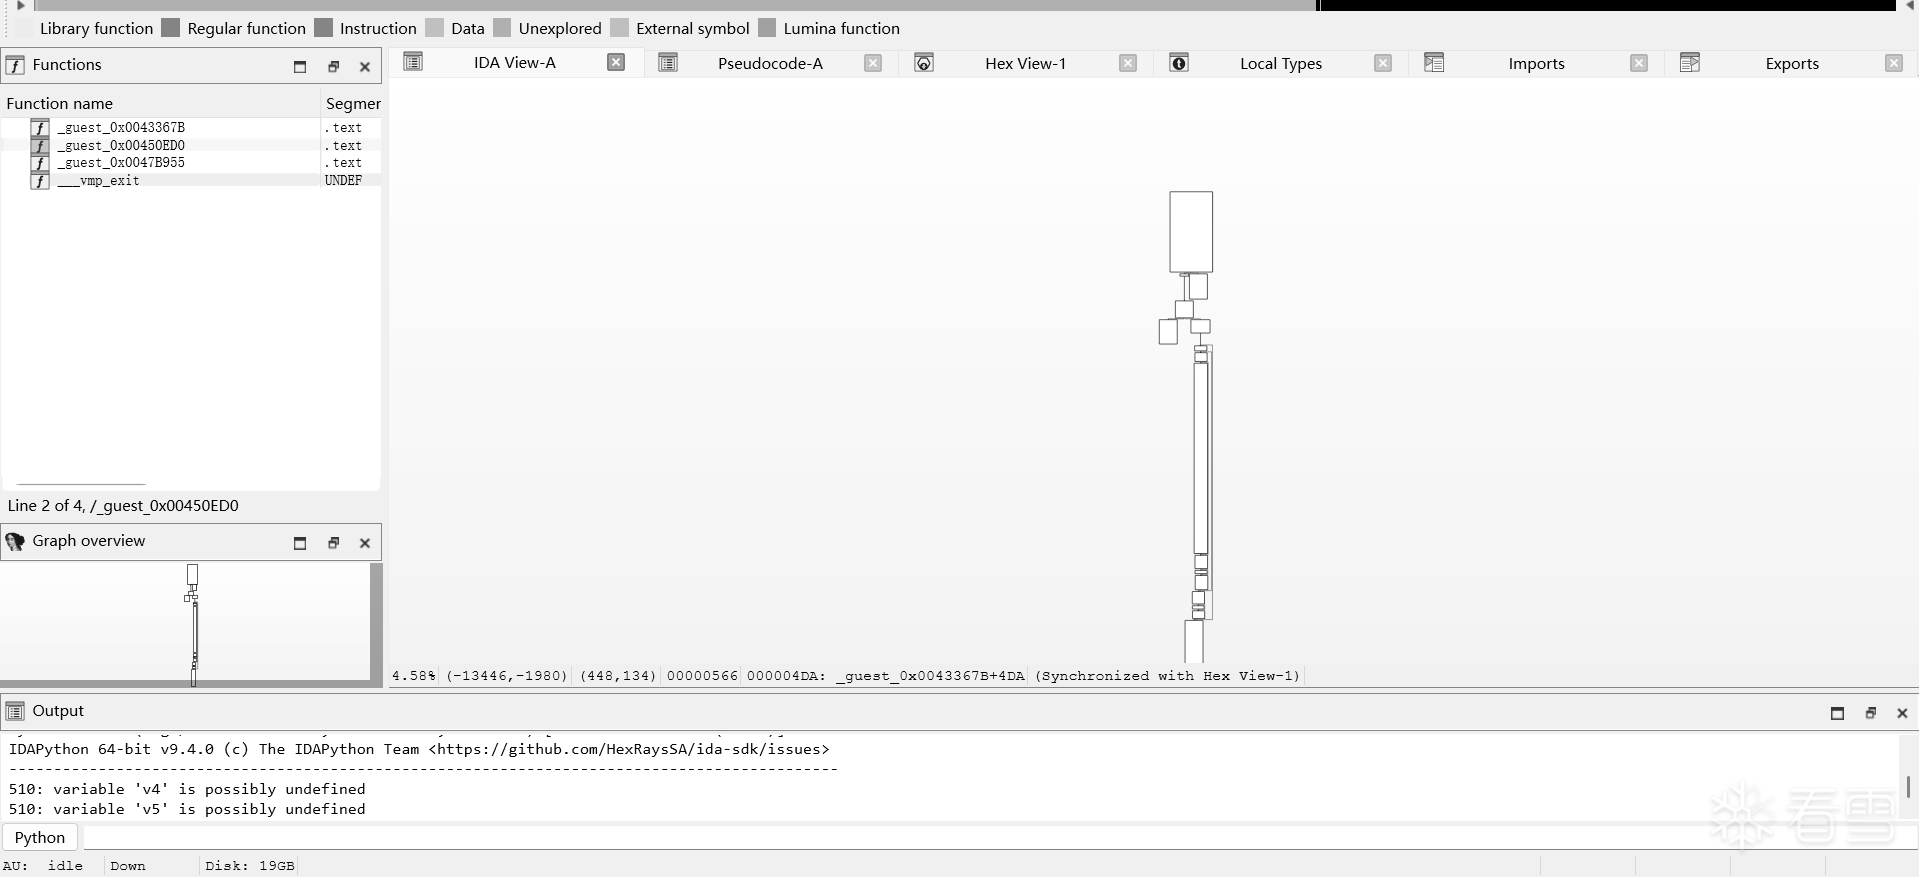
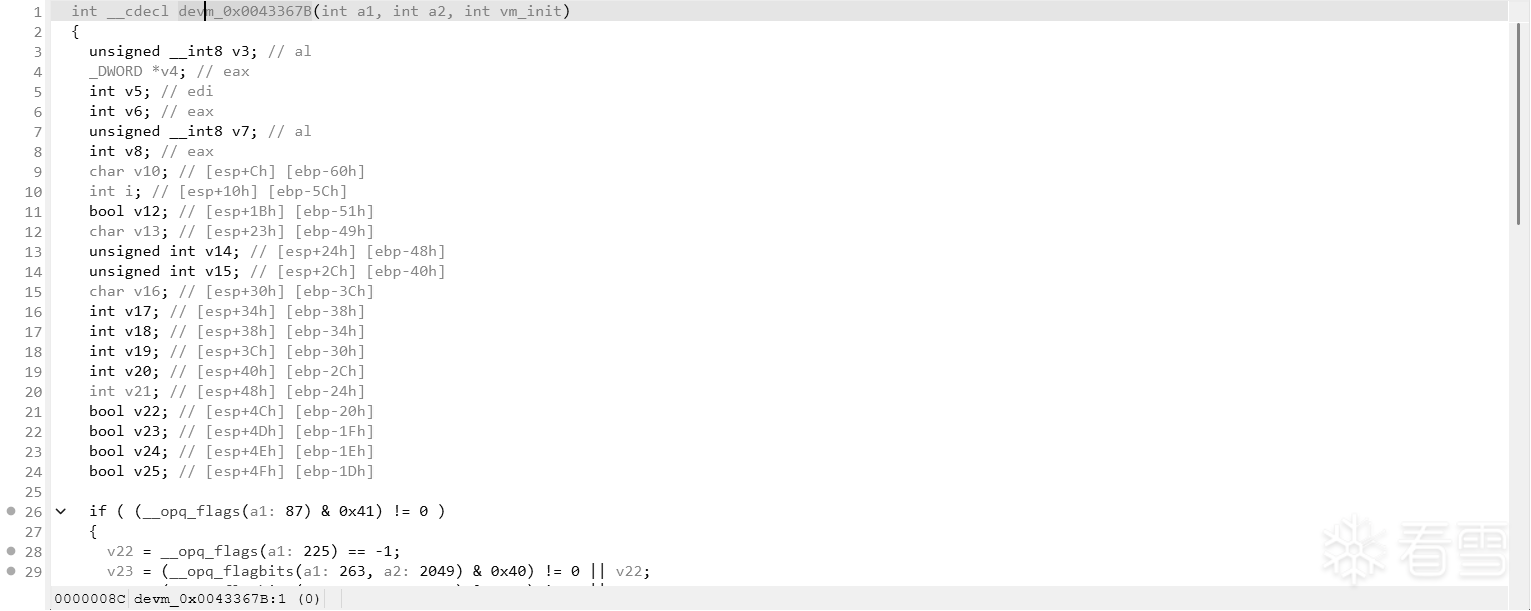
VM 参数还原 这里对 IR编写一个pass进行处理,最终还原出第二个VM函数0x0043367B的参数为2个。因为只有局部VM,所以必须再添加一个vminit。
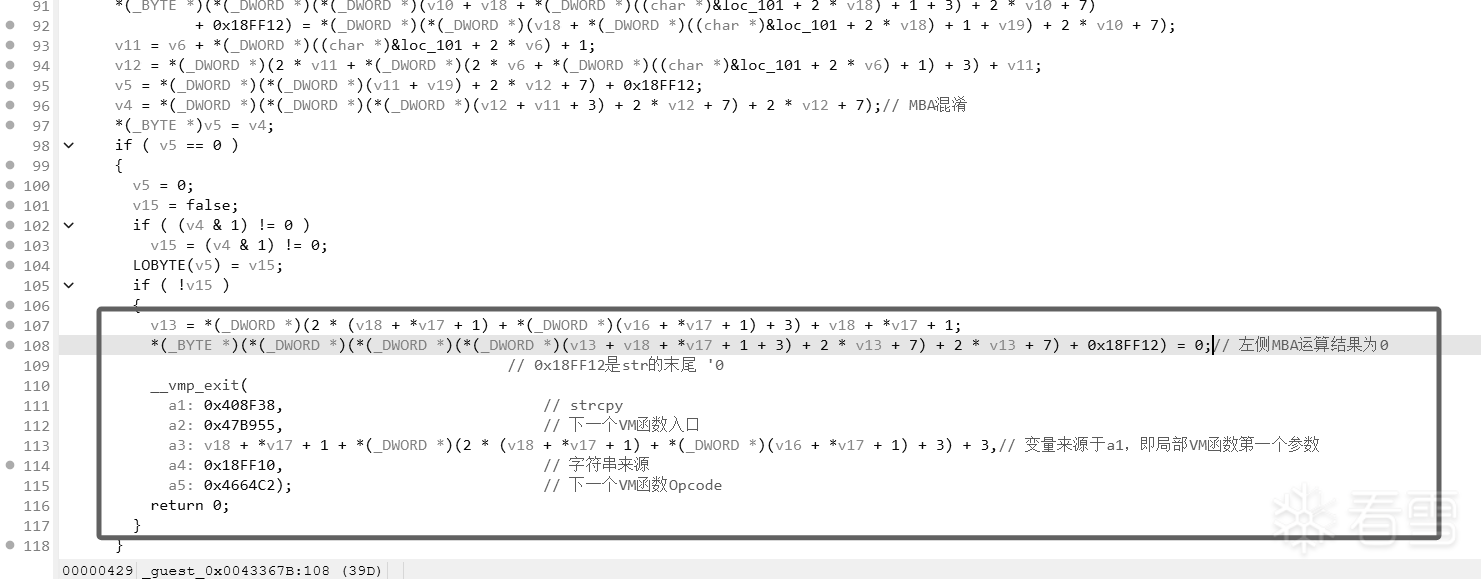
VM的时候,会调用目标函数,如果不在最后一个VM里,那么我们需要对__vmp_return进行一下处理,还原出参数。根据vRet排除8个必然出现还原的物理寄存器,追踪真正对程序栈进行写入后没有再次读取与写入的情况同时要保证与栈中关于中间运算产生的死代码相切割。下图为第二个局部VM函数结束时的API调用。
合并局部 VM VMProtect针对一个函数当中存在多个其他函数调用的情况会采用退出虚拟机的方式使得目标函数能够调用(如果其他函数也被VM了,那该函数将会直接内联到VM里执行而不退出虚拟机)
VM,如果要完整分析一个函数的行为则需要对其进行合并。有多少个局部VM可以根据有多少vRet进行溯源推测,在我们还原一个局部VM函数产生obj时,可以对产生的__vmp_return符号进行追踪分析其参数,第一个参数为目标函数地址,第二个参数为下一个VM函数入口。根据下一个VM函数入口继续追踪,虽然下一个VM函数入口的参数依赖目标函数的返回值,但是不继续追踪,连完整的函数CFG都还原不了。基于此,可以不断地溯源追踪,追踪将局部VM连成一条链。
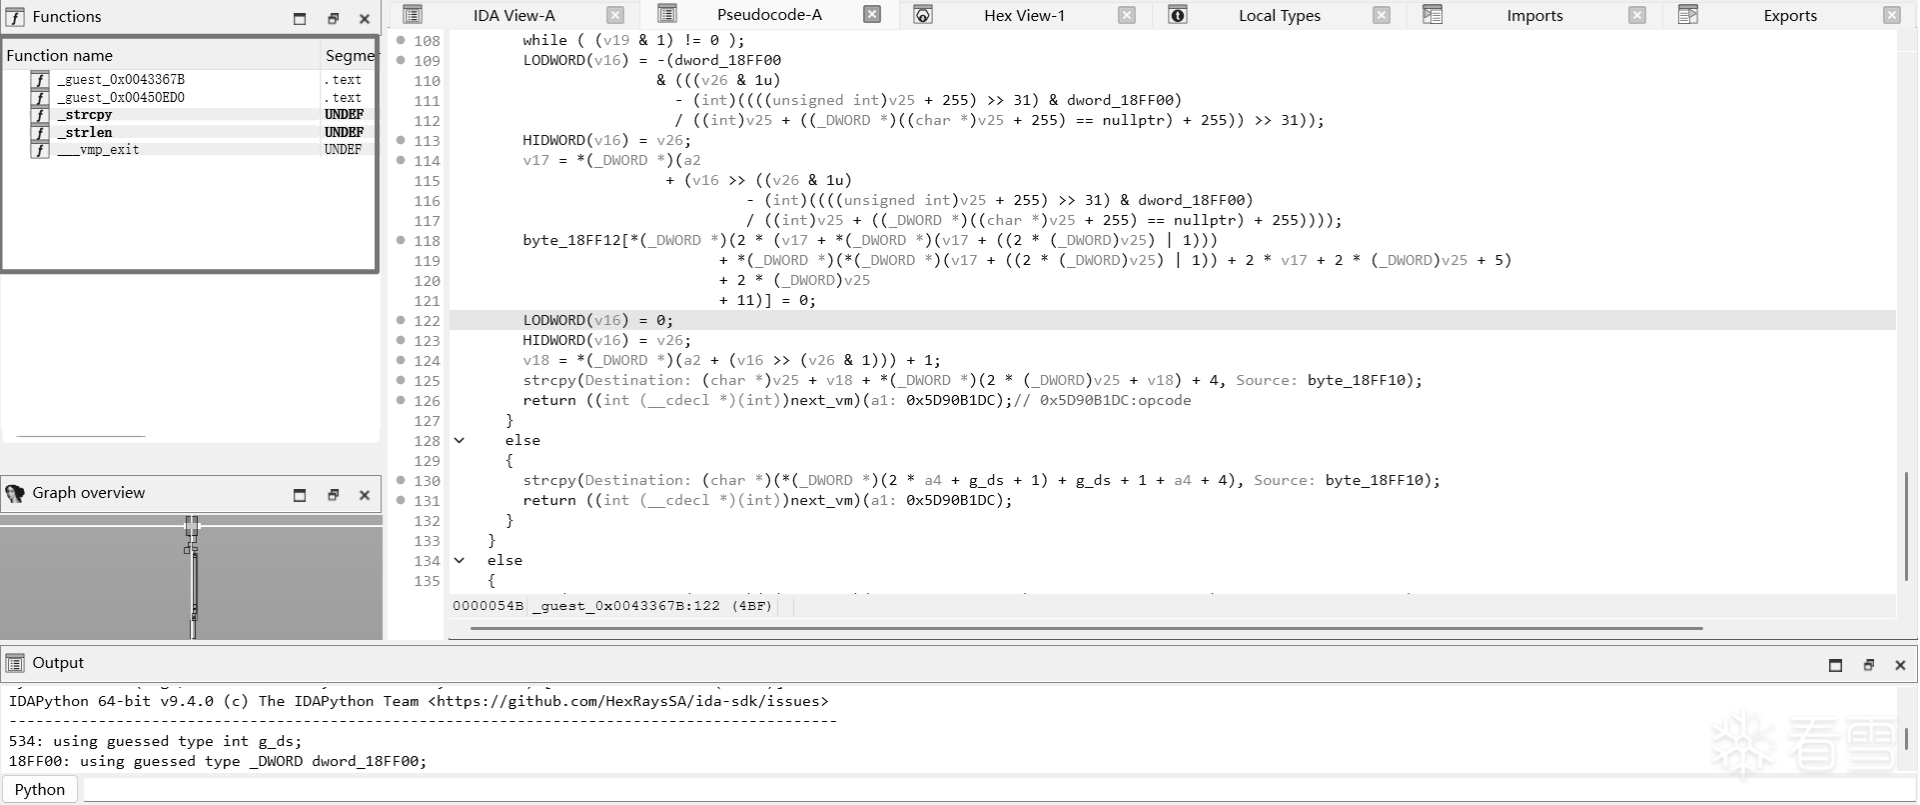
第一个函数行为分析 VM,开始给第一个函数进行分析,可以看到该程序调用了strlen、strcpy参数。结合程序给的“古典加密算法Crackme”信息,我们可以构造这样的提示词“分析算法,该算法以去除了大量的虚拟化,从古典加密算法的置换、仿射、多表仿射角度进行分析”
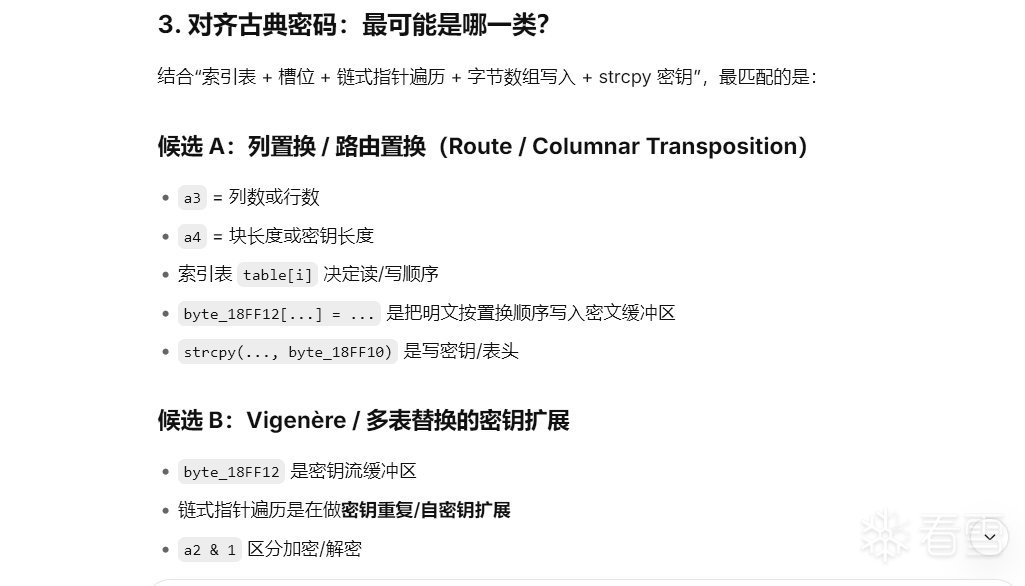
DeepSeek的分析,第一个函数大概率是列置换和路由置换。
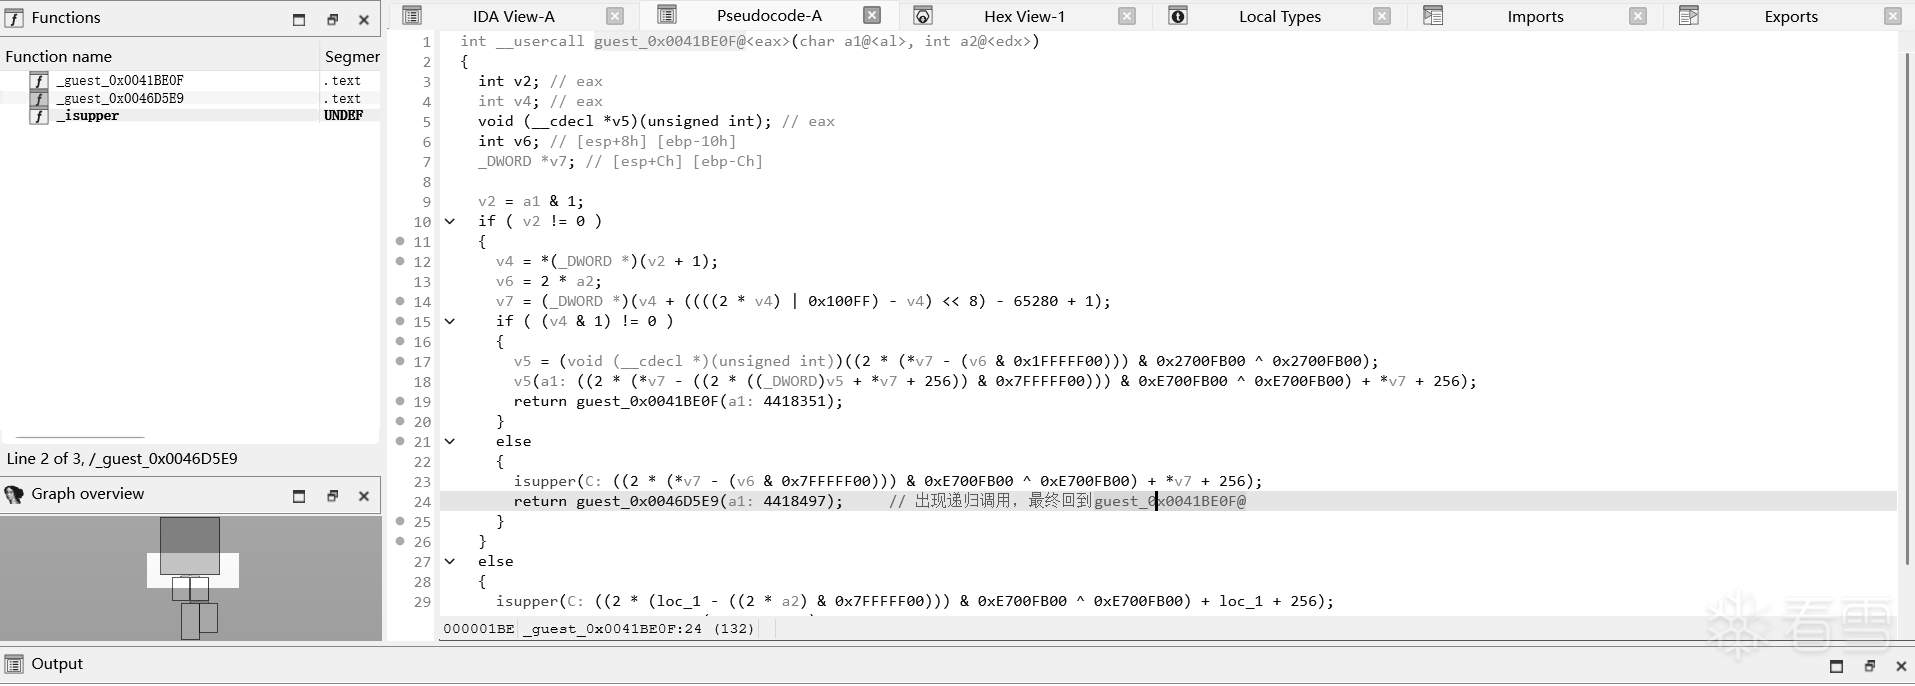
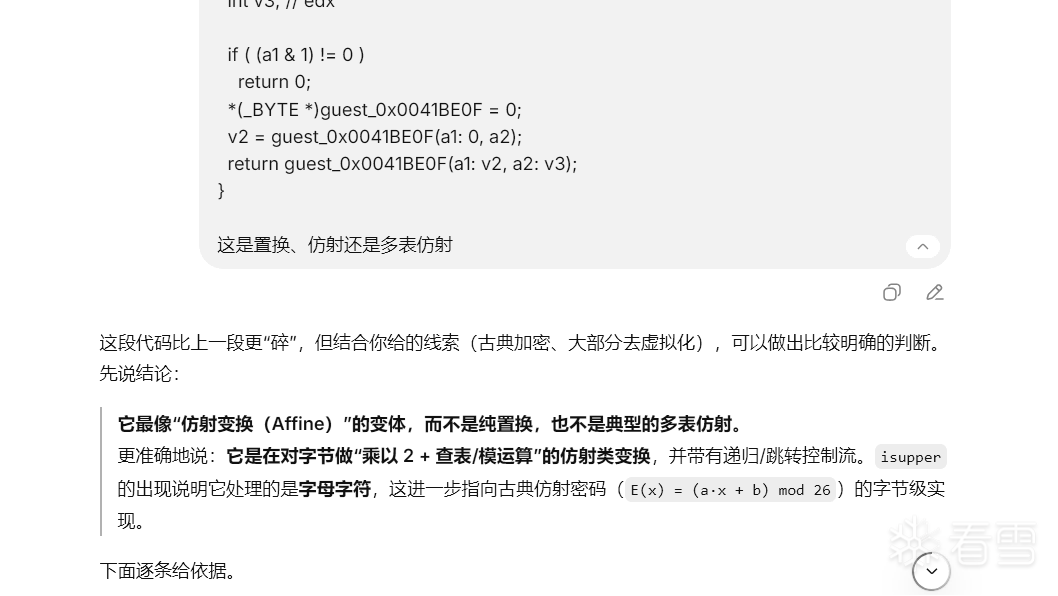
第二个函数行为分析 0x0041BE0F存在递归调用的情况,在之前的上下文基础上。给全部函数作为上下文丢进去,“ 这是置换、仿射还是多表仿射 ”。 根据 Deepseek的分析,第二个函数大概率是仿射变换。
总结
第七章 附录 LLVM 仓库: fedK9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6Y4K9i4c8Z5N6h3u0Q4x3X3g2U0L8$3#2Q4x3V1k6D9L8s2k6E0i4K6u0r3L8r3I4$3L8g2)9J5k6s2m8J5L8$3A6W2j5%4b7`.
能力:一套模块化、可重用的编译器与工具链基础设施,核心是 LLVM IR——一种带类型的、SSA 形式的中间表示。前端(Clang 等)把源码降到 IR,后端把 IR 降到目标机器码,中间夹着一整套与目标无关的优化 pass(常量折叠、GVN、死代码消除、指令合并等)。对本工作而言,LLVM 的价值有两层:一是它提供了 IR 层面的规范化与优化框架,很多 MBA 混淆在 IR 上会先被部分折叠;二是它的 pass 基础设施和 opt/llc 工具链,方便把提升后的代码送进自定义分析或化简流程。
Remill 作者: Trail of Bits(成立于 2012 年,总部位于美国纽约的一家独立的安全研究与咨询公司 )
仓库: 9aeK9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6Y4K9i4c8Z5N6h3u0Q4x3X3g2U0L8$3#2Q4x3V1k6D9K9h3k6@1K9h3&6Y4i4K6u0V1j5X3W2@1M7#2)9J5c8Y4u0W2L8h3W2D9L8l9`.`.
能力:一个二进制提升( lifting)库,把x86、x86-64、AArch64等架构的机器指令语义翻译成LLVM IR。它按指令逐条建模语义(每条指令对应一段 IR 片段),输出的是可被LLVM工具链继续处理的IR模块。在「二进制→IR →化简→反编译/分析」这条流水线里,Remill是入口:把目标二进制提升成LLVM IR,后续的优化、MBA 识别与化简都在 IR 层完成。
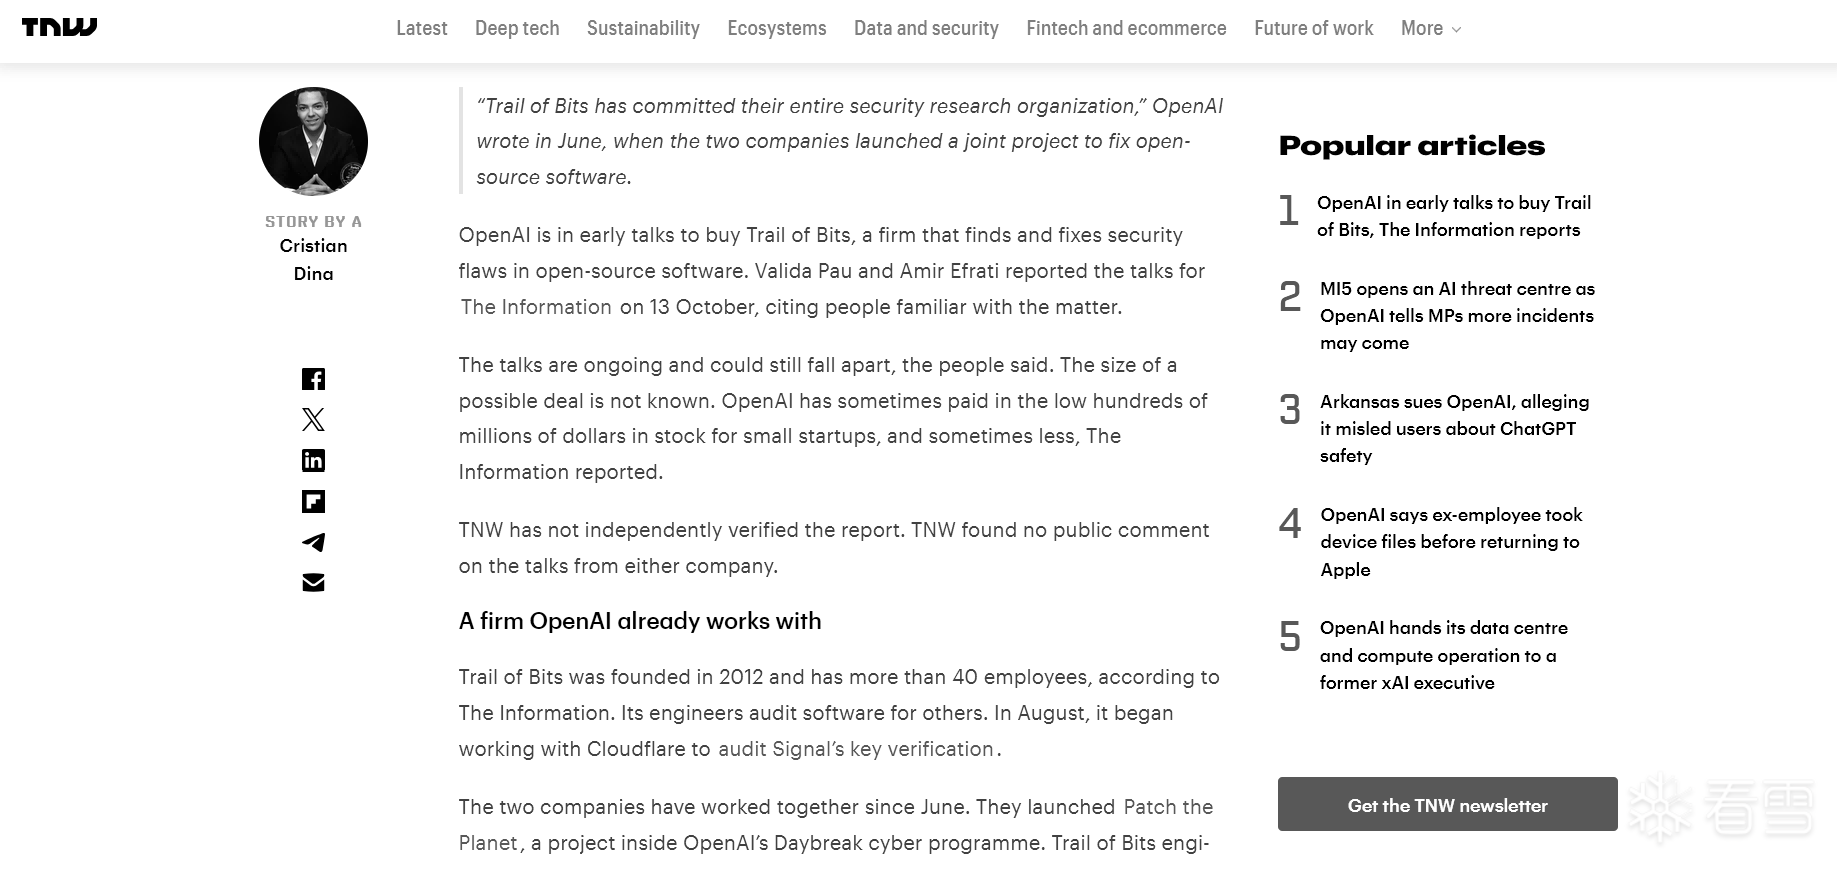
近期有报道称 OpenAI正在就收购Trail of Bits进行初步谈判。
OpenAI in early talks to buy Trail of Bits, The Information reports
040K9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6@1K9r3g2F1k6i4S2@1N6$3g2T1i4K6u0W2j5$3!0E0i4K6u0r3L8X3g2%4M7#2)9J5c8X3!0H3k6h3&6S2K9g2)9J5k6s2c8J5j5h3W2D9i4K6u0V1L8$3k6Q4x3X3c8T1K9i4c8K6i4K6u0V1j5h3y4I4N6h3W2K6K9i4c8A6L8$3&6Q4x3X3c8@1j5h3I4C8M7H3`.`.
SiMBA 作者: Tim Blazytko(Automated Detection of MBA Obfuscation 系列文章作者)
仓库: 931K9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6Y4K9i4c8Z5N6h3u0Q4x3X3g2U0L8$3#2Q4x3V1k6p5k6h3&6#2N6X3!0e0L8$3k6@1N6$3q4J5k6g2y4G2L8s2g2@1K9h3!0F1M7#2)9J5c8W2y4A6e0f1u0m8i4@1g2r3i4@1u0o6i4K6R3^5f1Y4g2K6N6l9`.`. 实现,也有 Python 绑定思路)
能力:基于线性 MBA 理论(Σ cᵢ·xᵢ + Σ cᵢⱼ·xᵢ∧xⱼ + ...),把表达式规约成线性组合,再查表合成最简形式。对 nor/nand/and/or/xor + add/sub + not 这类位运算+加法混合几乎是量身定做。
局限:主要覆盖线性 MBA(bitwise 与算术的线性组合);shl/shr/shld/shrd/idiv 不在核心覆盖内——但你的表达式里这些多半是外围结构,MBA 核心在 nor/add 层,可以剥离处理。
GAMBA 8bfK9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6Y4K9i4c8Z5N6h3u0Q4x3X3g2U0L8$3#2Q4x3V1k6p5k6h3&6#2N6X3!0e0L8$3k6@1N6$3q4J5k6g2y4G2L8s2g2@1K9h3!0F1M7#2)9J5c8V1N6m8e0f1u0m8
关键信息
归属: Denuvo Software Solutions(与 SiMBA 同一团队)。
定位:基于 SiMBA 迭代化简非线性 MBA 表达式,核心思路是隔离线性子式、重构后交给 SiMBA 处理。
主程序: simplify_general.py 用于通用 MBA,simplify.py 用于线性 MBA。
验证选项:加 -z 可调用 Z3 做等价性验证,确保化简结果语义正确。
与你日志的匹配点:你之前担心的 shl/shr/idiv 与位运算混叠问题,正好是 GAMBA“子式变量替换 + 迭代 SiMBA”策略试图覆盖的场景。命令行直接传表达式即可,格式简单:
bash
python3 src/simplify_general.py "你的表达式"
AVLCode AVLCode
作者 /团队:安天澜砥团队(安天科技集团)
仓库 /官网:92aK9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6%4N6%4N6Q4x3X3g2S2N6X3I4U0L8$3c8W2i4K6u0W2j5$3^5`.
能力:一款国产 AI智能编程与安全分析桌面助手,核心定位为“智能编码开发+二进制安全分析”双主线。底层搭载安天自研的澜砥威胁检测分析垂直大模型,支持亿级Token超长上下文,原生面向二进制数据处理。安全分析侧内置一套只读工具集,包括哈希与熵计算、字符串与IOC抽取、PE/ELF/Mach-O解析、反汇编、C/Java伪代码反编译、YARA规则匹配,并明确提及“代码反混淆与数据解密”能力。全链路适配国密SM2/SM3/SM4,样本与业务数据在本地部署模式下不出域,支持Windows/macOS/Linux及国产操作系统原生分发。
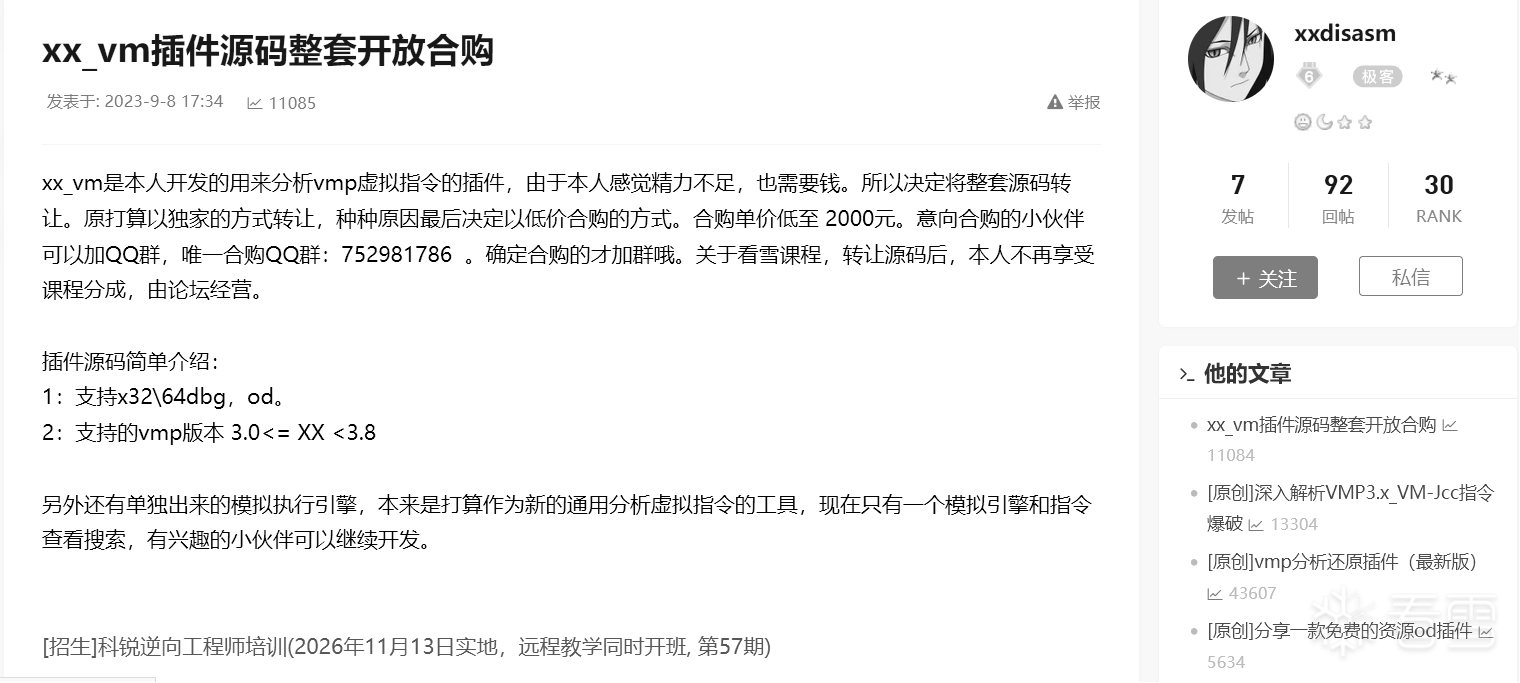
XXVM https://bbs.kanxue.com/homepage-674721.htm
https://bbs.kanxue.com/thread-250711-1.htm
VMProtect xx_vm Chinese Decompiler
xx_vm_releasevmp虚拟代码分析还原插件,可以自动化的分析由vmp保护的虚拟代码,提供了包含丰富信息的日志文件,通过对日志伪代码的分析,我们几乎可以还原出原始指令。从而达到分析目的。目前我们已经开发出ollydbg适用的插件,后续我们也会对接其他主流调试器。
Support Version 3.x
Support Debuger: ollydebug, x64dbg
第八章 结尾 感谢看雪论坛 ,这是一片净土 ……
感谢安天,这是一座泰山北斗 ……
还有 JMPOEP、飘云阁、吾爱破解、学破解论坛、精易论坛,这是属于内地在世界上所独有的文化
这篇工具与文章是帮工厂客户解决某激光排版软件加密狗时匆忙的制作,很多内容相对不完善,例如在 VM参数还原部分在局部VM函数最终合并时会失灵。程序关于局部变量的读写没有移除vESP的结构,而是将[vESP+n]的读写抬升为一个变量,这就产生了byte_18FF00与byte_18FF12这样的情况,对于数组不够友好。同时在控制流分支边界条件的还原不够充分,只能还原出程序控制流的基本骨架,甚至可能把for循环还原成递归的形态,对于加壳的VMProect保护程序需先脱壳,总之当前还存在很多的问题……如果未来业务还在发展,应该会继续开发这款工具。
文章基于 remill的通用混淆削弱工具暂时还没实现好,只是利用AVLCode验证了可行性,我们可以快速地基于澜砥VILLM等专门面向二进制汇编分析的大模型分析程序当中存在的混淆规律,然后利用remill将混淆的二进制程序翻译为LLVM的IR,将澜砥大模型分析的混淆规律交由开发Agent例如Cursor、ClaudeCode快速开发LLVM的pass验证混淆削弱的可行性。
文章关于 VM分析的部分主要基于论坛xxvm作者开发的工具进行二次开发实现,在分析样本的过程中我们逐步拆解了VMProtect的架构,并尝试给出了一定的还原方案,最终作者还原了xxvm的demo程序以及分析了古典加密算法CrackMe的行为,但关于vstk和vJmp条件跳转的还原部分依然不够理想。
近期有报道称是 OpenAI正在就收购Trail of Bits进行初步谈判,显然,基于 LLVM和二进制翻译的Cyber大模型安全将成为一种重要的方向:The two companies have worked together since June. They launched Patch the Planet, a project inside OpenAI’s Daybreak cyber programme. Trail of Bits engineers use OpenAI’s GPT-5.5-Cyber model and its Codex tools to find bugs in open-source projects. They check the findings, write patches and work with the maintainers on fixes.
OpenAI is trying to build a substantial cybersecurity business, The Information reported. In September, it put $1bn behind cyber defence for water utilities and community banks under Daybreak.
OpenAI in early talks to buy Trail of Bits, The Information reports
705K9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6@1K9r3g2F1k6i4S2@1N6$3g2T1i4K6u0W2j5$3!0E0i4K6u0r3L8X3g2%4M7#2)9J5c8X3!0H3k6h3&6S2K9g2)9J5k6s2c8J5j5h3W2D9i4K6u0V1L8$3k6Q4x3X3c8T1K9i4c8K6i4K6u0V1j5h3y4I4N6h3W2K6K9i4c8A6L8$3&6Q4x3X3c8@1j5h3I4C8M7H3`.`.
冰与火的战歌:Windows内核攻防实战高级班!从零到实战,融合AI与Windows内核攻防全技术栈,打造具备自动化能力的内核开发高手。
最后于 5小时前
被zZhouQing编辑
,原因: 编辑图片
上传的附件: