-
-
[原创] xNext:把代码审计做成可追踪、可恢复的流水线 —— 我用它审计了 Firefox 源码
-
发表于: 2026-10-16 23:33 271
-


xNext:把代码审计做成可追踪、可恢复的流水线 —— 我用它审计了 Firefox 源码
感谢Deepseek梁老师的15号给我返还的赠送金,让我觉得我又行了,所以我决定把我最近自用的代码审计skill给大家介绍一下。
0. skill地址
vnext
156K9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6Y4K9i4c8Z5N6h3u0Q4x3X3g2U0L8$3#2Q4x3V1k6V1K9h3q4F1k6r3W2S2L8X3c8A6j5g2)9J5c8Y4k6F1k6i4S2@1
1. 快速开始
这是一个什么skill,他是用来做什么的
设计他的目标是把我的代码审计能力蒸馏成可以复用的skill,让我可以稳定刷cve。
最初的设计目标是为了能够稳定的完成开源的超大项目的代码审计,面向的开发语言和问题是Top15的开发语言,每种语言Top10的安全问题,所以他不是一个完全通用性的代码审计skill。为了确保LLM可以稳定的执行审计,skill内部做了很多工程化的设计,保证可以稳定的长时间执行代码审计。
适用于哪些目标呢?
如果你有一个几十兆的小仓库,那么可能直接在cli里面设计一个skill.md就好了,但是如果你想要审计几百兆,几个G的项目时,可以考虑使用这个skill。
这个skill目前的表现怎么样?
我在 skill 设计过程中固化了一套优化流水线:
审计 skill 审计 → 实证 skill 验证 → optimizer skill 完成 skill 优化测试 → 审计 skill 审计闭合优化
目前还是早期版本,只完成了两次完整流水线优化。审计过 WebKit、Chrome V8 与 Firefox 源码。其中 WebKit 和 V8 的重点是验证新 skill 的规则、流程设计、A/B 测试和代码开发问题,真正大规模审计的项目是 Firefox 浏览器源码。
v3 是我之前设计的一个代码审计skill,v3的部分linux kernel的漏洞发现能力实证信息: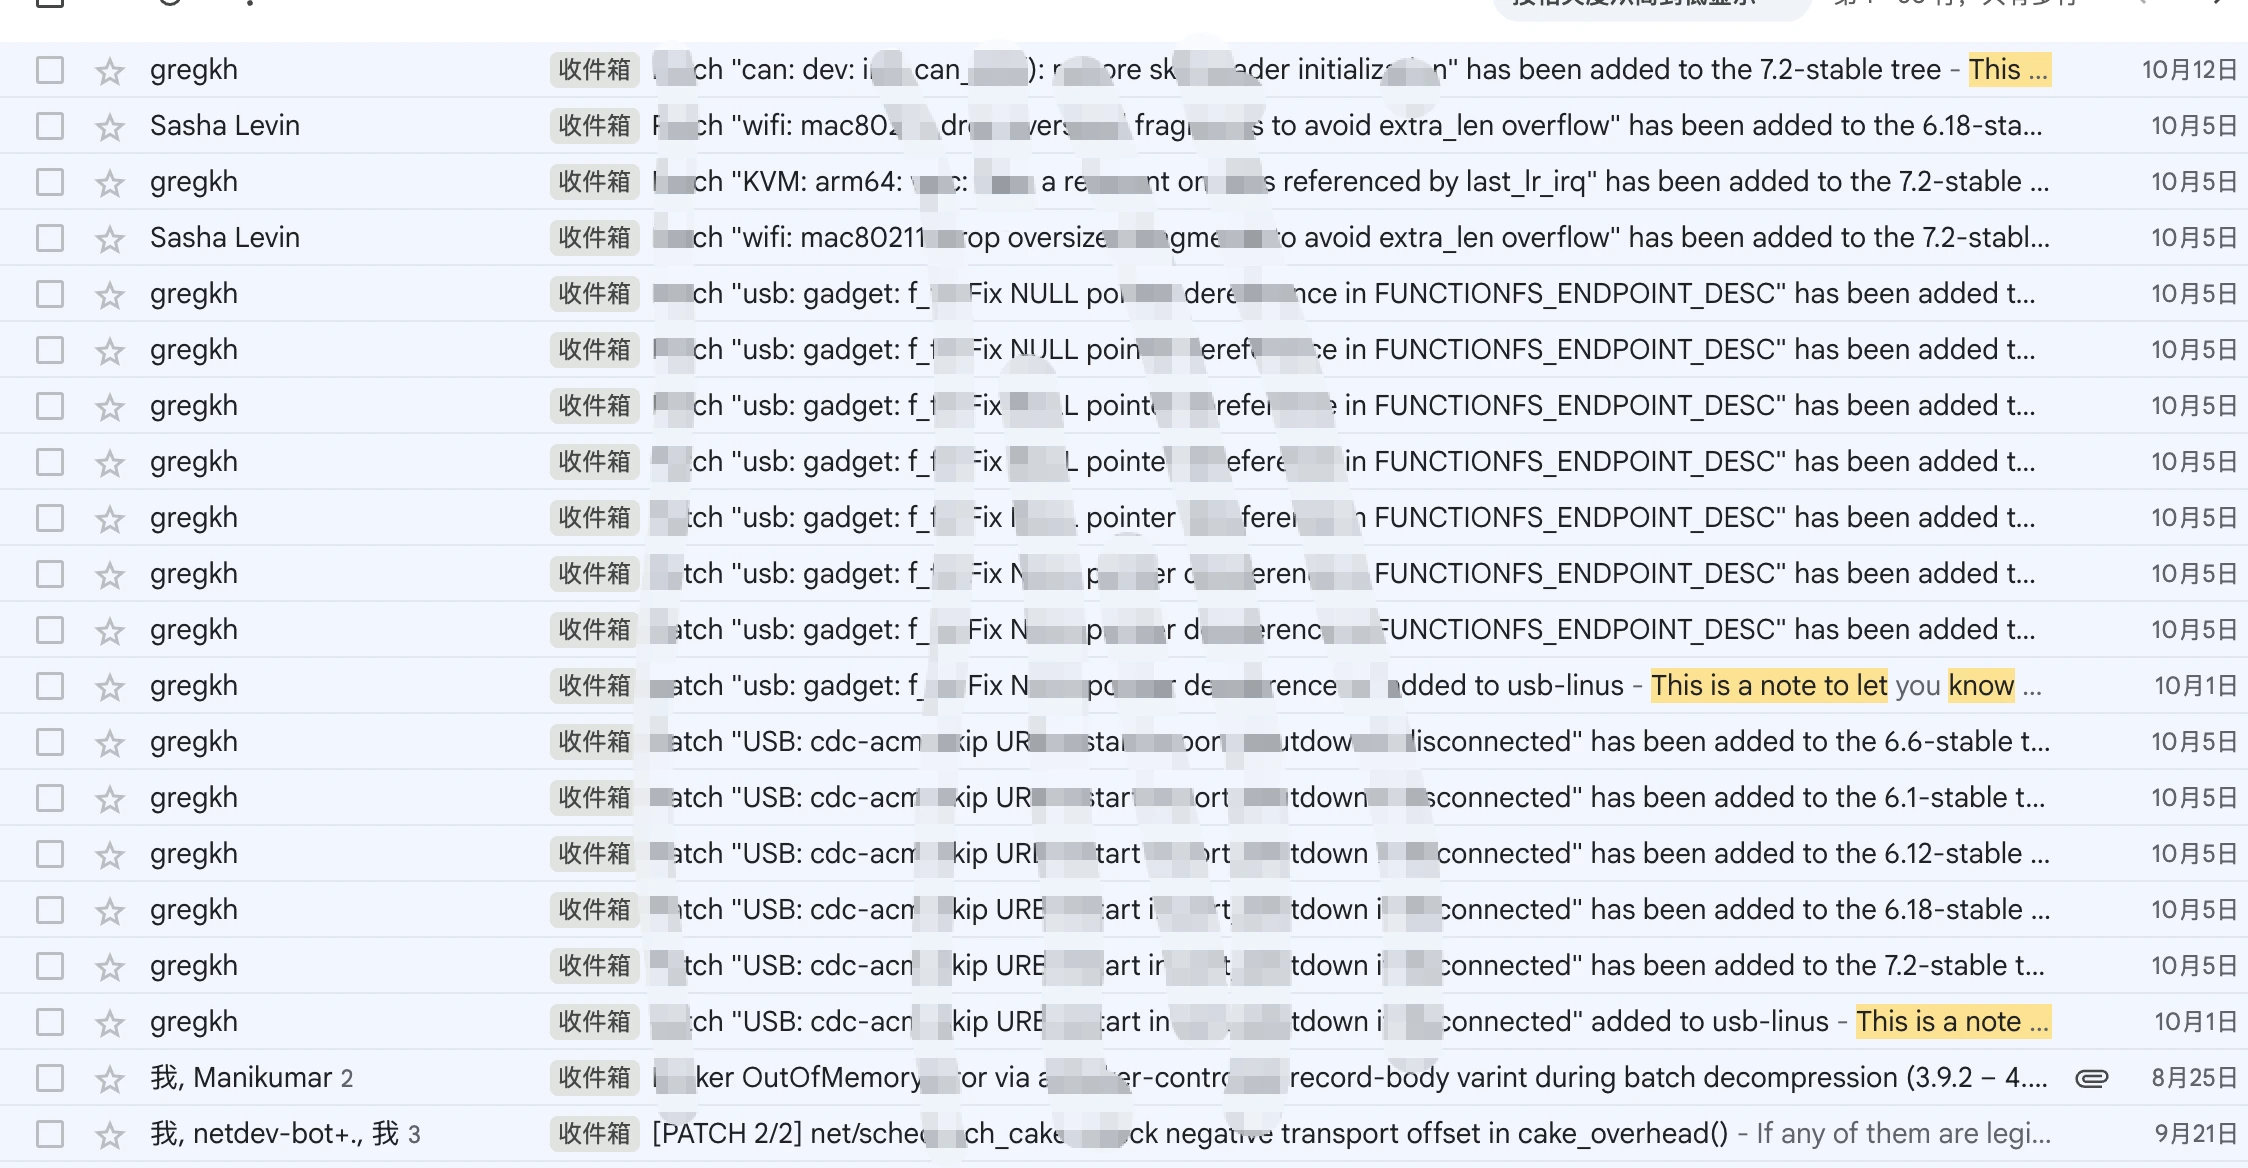
WebKit的对比(我只验证了critical存在):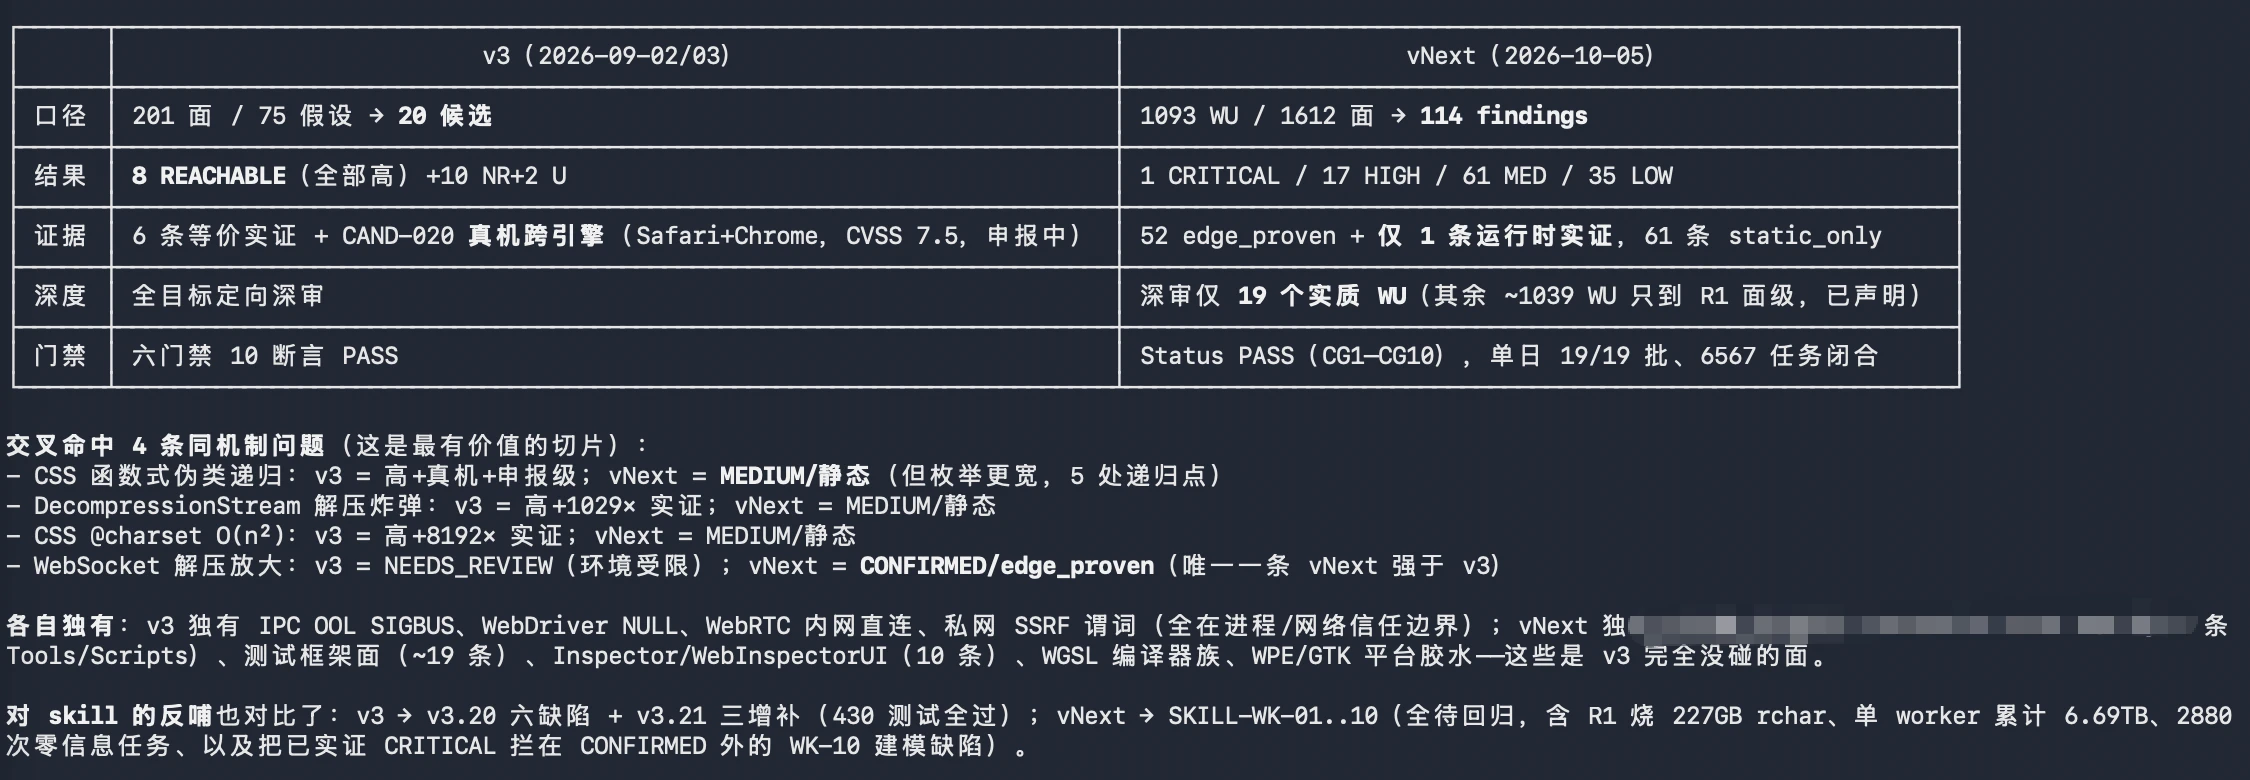
firefox的审计一共有84个batch,目前进行到了第54批次,统计的审计结果如下:
| 区段 | 批数 | 发现 | HIGH | MEDIUM | LOW | CONFIRMED | NEEDS_REVIEW | edge_proven |
|---|---|---|---|---|---|---|---|---|
| 1–42 | 42 | 457 | 29 | 140 | 288 | 340 | 116 | 367 |
| 44–48 | 5 | 53 | 4 | 22 | 27 | 36 | 17 | 41 |
| 49–54 | 6 | 410 | 21 | 220 | 169 | 294 | 116 | 348 |
| 合计(已完批) | 53 | 920 | 54 | 382 | 484 | 670 | 249 | 756 |
| 0055(未闭合) | — | 142 | 12 | 67 | 63 | 142 | 0 | 142 |
v3版本与xNext的比较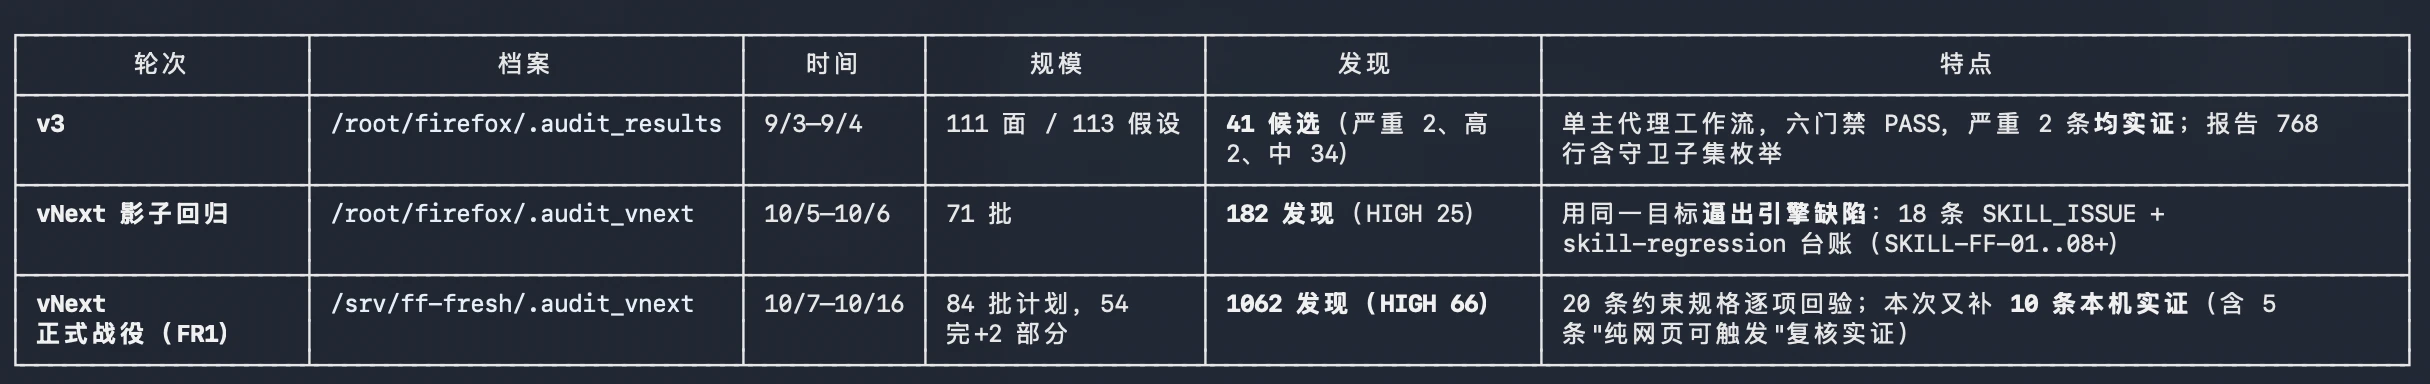
我从high里面筛了一下,纯网页触发不需要用户手势,不需要本地条件,不需要先攻破别的进程的有7条,人证+使用cve-ghsa-draft skill实证的有5条确认。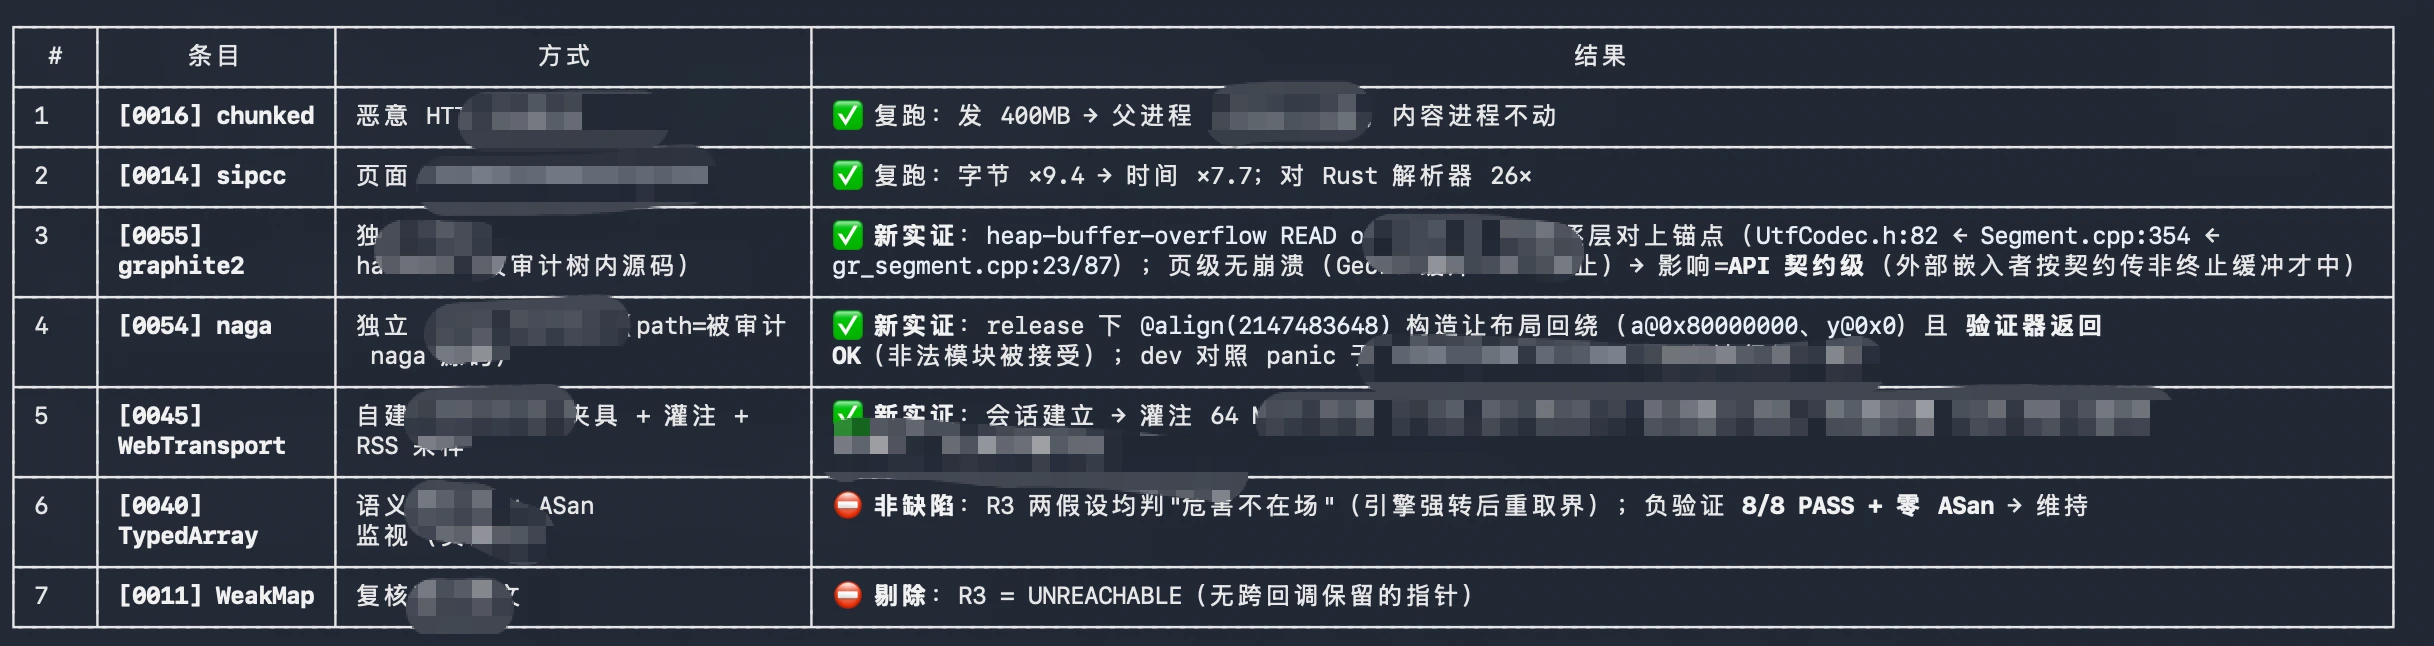
其他的没有时间证明,实际的可能没有这么多问题,所以具体是不是真实存在,各位经常审计的大佬可以自己测试一下,注意,为了避免不必要的麻烦,我已经剔除了firefox_audit.md里面每个问题的source->sink信息
他的优势是什么?
- 基于前几个版本的实战经验,完全重新设计,抛弃历史包袱,流程更成熟。
- 更注重:超长时间任务执行、证明与反证明、跨 Batch 交接、结构化覆盖校验。
他的缺陷是什么?
- Firefox 审计尚未完全完成(84 个 batch 只跑完 54 个),没有更多 token 继续跑完以进一步提升 skill 能力。
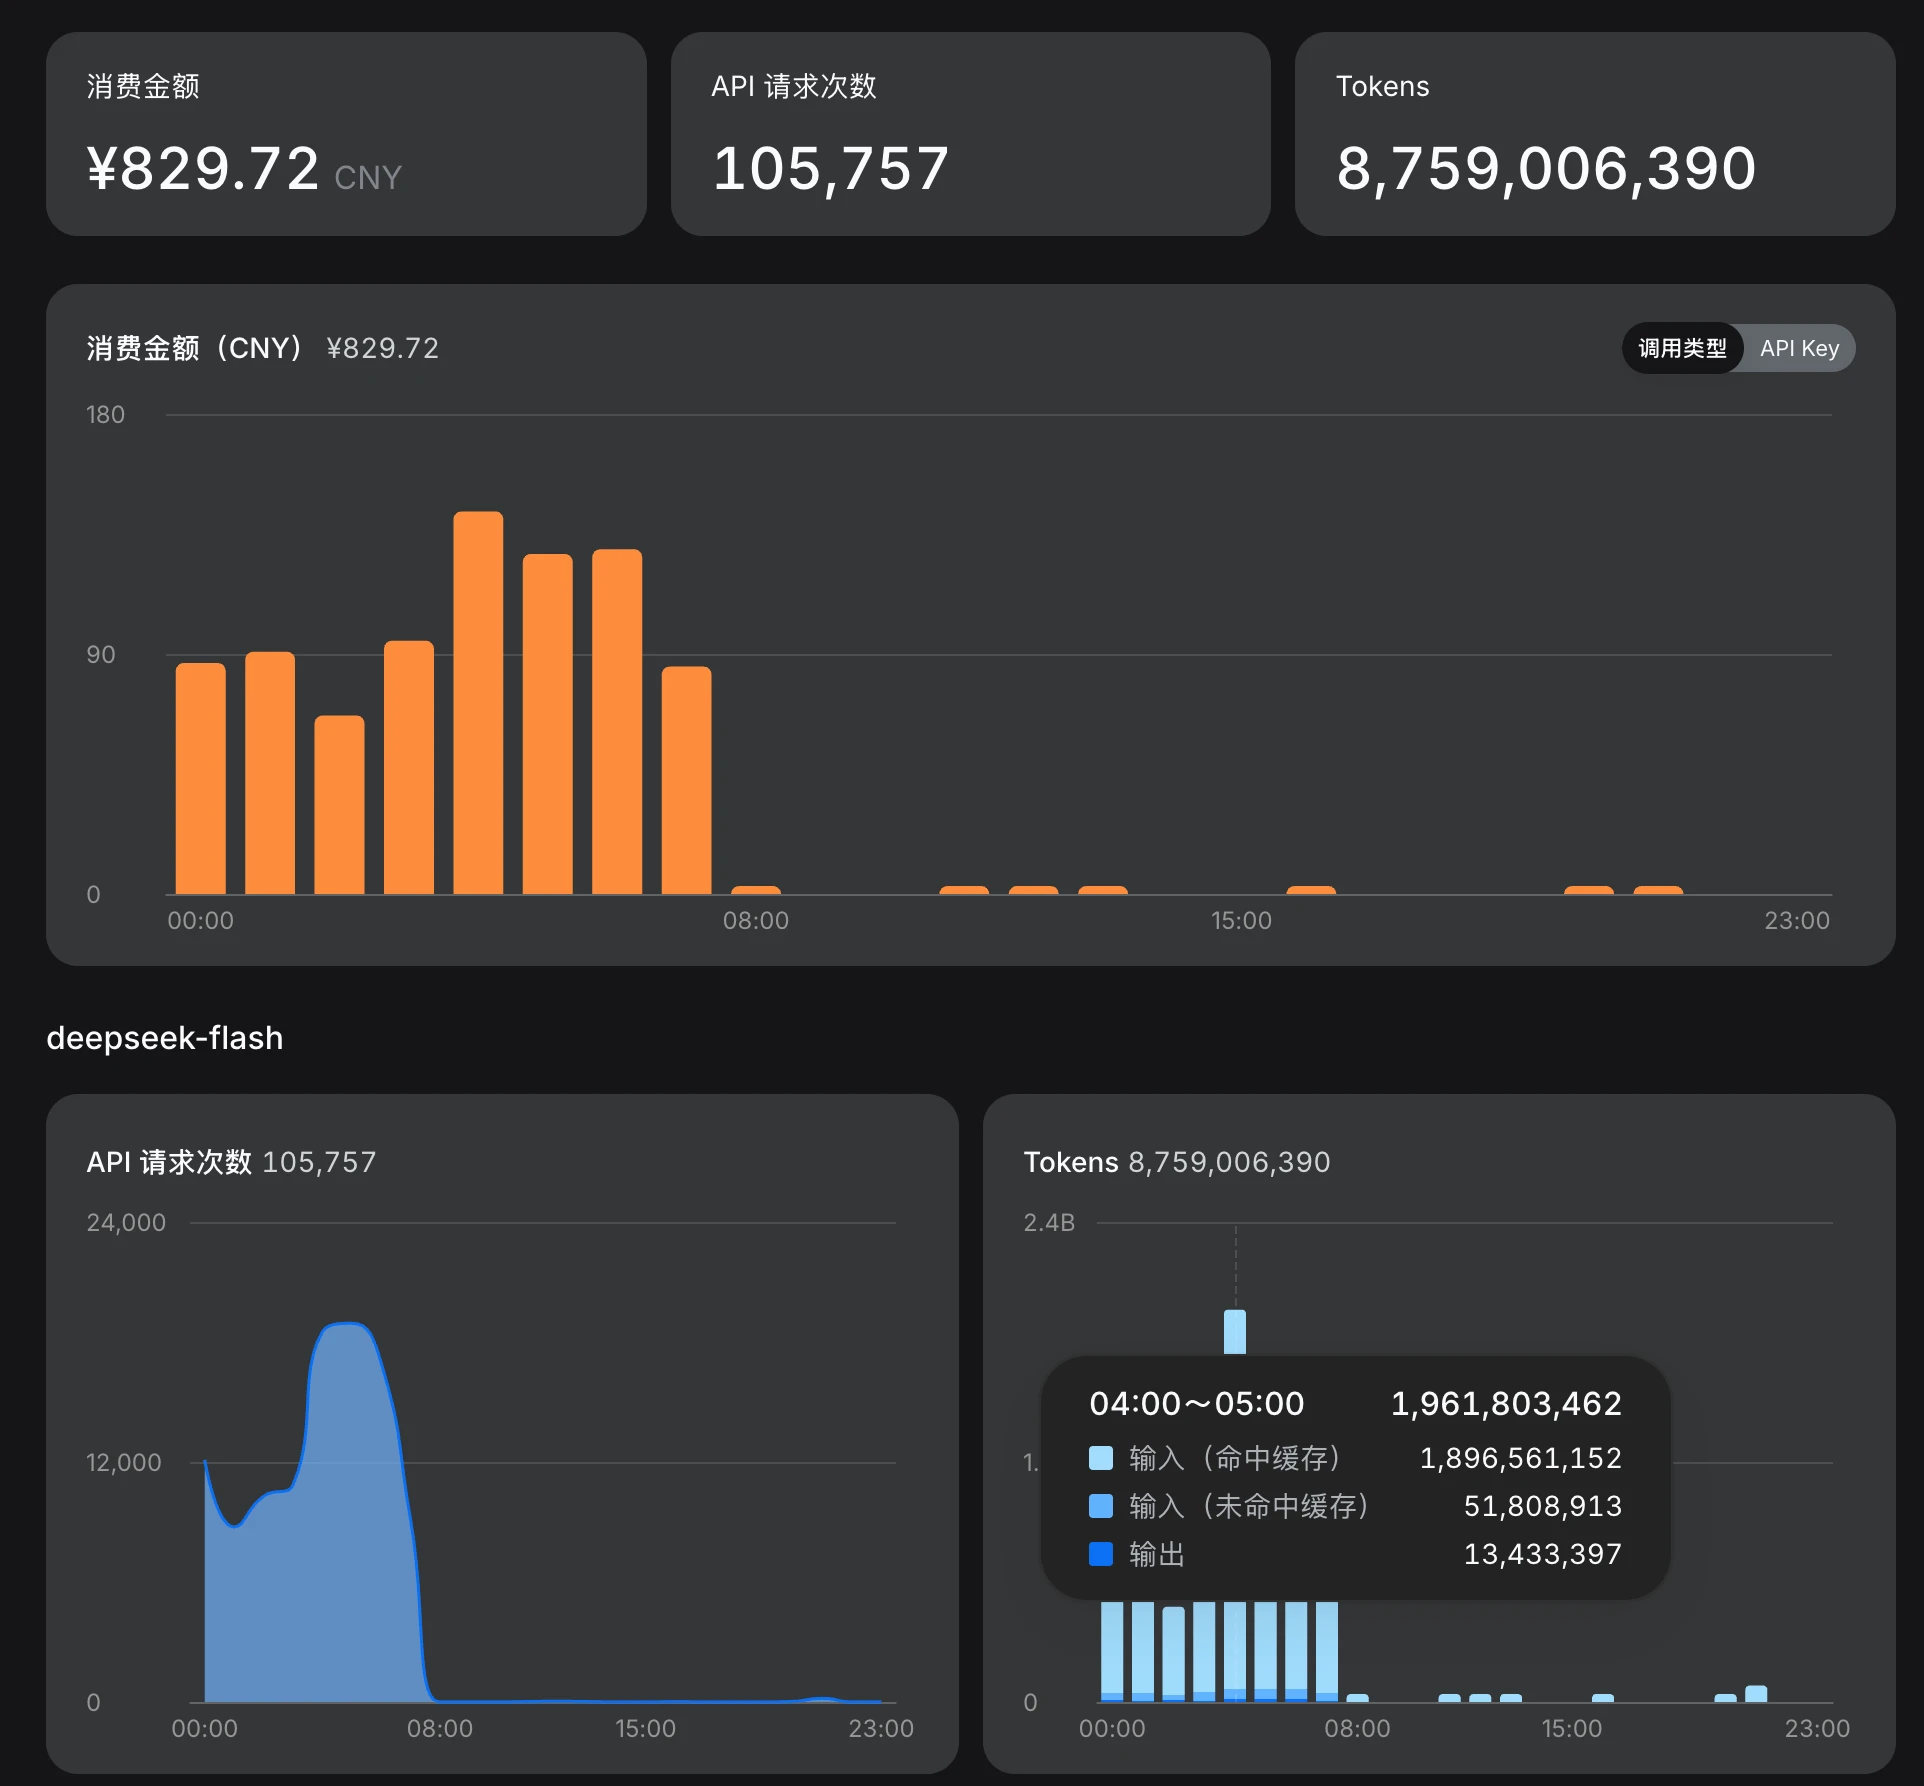
- 为了提升覆盖率增加了很多约束,token 消耗较高。10 月 15 日到 16 日早上,Firefox 7 个批次的测试直接跑完了 920 RMB 额度(目前主要工作重点就是定位和优化 token 消耗)。
- 尚未完成所有 Top15 目标语言的验证,无法证明对所有目标语言都有效。
- 开始审计后大量读取代码会让电脑卡顿。
怎么使用呢?
如果你还想试试,请使用 Claude + Deepseek(或其他模型),安装本 skill 进行代码审计。
重点:请在 Docker 环境中测试。
- 选择 Claude 的原因:我测试过 OpenCode、Harness、Antigravity、Gemini CLI 等工具,它是目前最稳定的。
- 选择 Deepseek 的原因:便宜,能干活。
直接下载安装即可测试。如果你对实现技术感兴趣,继续往下看。
2. 技术实现
1. 整体架构:各部分如何协作
可以把系统分成“宿主”“流程引擎”“分析辅助”和“持久化/评估”四层:
flowchart TB
    U[用户或审计负责人] --> S[SKILL.md 操作合同]
    S --> H[宿主 Agent]
    H --> CLI[CLI 命令入口]
    CLI --> C[Campaign 与 Batch 控制]
    C --> I[清点、组件图与规划]
    I --> Q[持久化任务队列]
    Q --> H
    K[安全知识与静态热点] --> Q
    H --> Q
    Q --> W[R0-R6 工作流与校验门槛]
    W --> DB[(SQLite 事件与状态)]
    W --> A[(内容寻址证据)]
    DB --> R[报告与能力评估]
    A --> R
- 宿主 Agent:读取任务、检查目标代码并返回结构化结果。它是分析执行者,不属于本项目内置的静态分析器。
- CLI 与 Campaign 控制层:把用户意图转换为初始化、清点、规划、任务、阶段和结案操作。
- 清点与规划层:识别源码、语言、构建单元及候选连接,再将范围分配给 Work Unit 和 Batch。
- 持久化任务队列:负责调度、领取、租约、收集、重试和提交,使工作中断后仍可继续。
- 工作流层:实施 R0-R6 的顺序、输入合同和完成条件。
- 安全知识与热点分析:只提供候选方向、反证提示和验证方法,不直接发布漏洞结论。
- SQLite 与证据仓库:分别保存状态/事件和较大的不可变材料;报告从两者推导。
- 评估层:检查流程材料和独立能力证据。它与日常审计分开,避免「能运行」被误写成「有效果」。
2. 执行机制:从输入到结果发生了什么
一次正常运行的数据流如下:
- 初始化:用户指定目标仓库、Campaign ID、快照、审计模式和预算。若未显式给快照,系统只接受干净 Git 工作树自动生成的提交标识。
- 清点:
inventory扫描源文件、语言和构建单元;graph生成本地依赖和候选边界,并保留无法识别的项目。 - 规划:
plan根据文件数量、组件和边界拆出 Work Unit 与 Batch,生成稳定的计划及交接记录。 - R0 校验:Batch 开始前重新计算范围内文件摘要;发现代码漂移时阻塞 Batch,并记录受影响范围。
- 任务调度:每个阶段先生成持久化任务。Worker 领取任务后得到范围、输出 schema、分析要求、相关安全知识和热点摘要。
- Agent 分析:宿主 Agent 读取允许的源码,返回 Surface、假设、可达性判断、反证、覆盖处置或实验评估。
- 收集与提交:
task-collect检查任务身份、Worker、输出大小、必填结构和范围完整性;阶段提交再检查代码锚点和阶段关系,并写入事件和证据。 - 复核与实验:对重要结论安排独立反驳和裁定;只有能解决关键未知时才运行实验,并记录命令、环境、输出和限制。
- Batch 收尾:R6 检查该批次的证据、发现、类别覆盖、交接和剩余风险。
- Campaign 收尾:所有相关 Batch 和 Handoff 对账后,单独执行 Campaign 门槛并生成最终报告。报告同时显示发现与限制。
为什么要拆成 R0-R6?
R0-R6 实际上构成一条逐步收紧结论的证据漏斗:
R0 固定事实基础
 ↓
R1 画出攻击面和边界
 ↓
R2 提出可证伪假设
 ↓
R3 用静态代码证据验证
 ↓
R3.5 由独立角色尝试推翻
 ↓
R4 从安全类别角度检查遗漏
 ↓
R5 只对关键未知做实验
 ↓
R6 对账范围、证据和剩余风险
其中有两条互补的审计路径:
- 假设驱动路径(R1-R3.5): 从攻击入口出发,提出具体假设,再沿代码链验证并反驳,适合回答“这条攻击路径是否真实存在?”。
- 类别覆盖路径(R4): 按计划内的安全类别逐项回看工作单元,适合回答“我们是否因为没有提出某个假设,而完全漏掉了一类风险?”。
R5 不是每条假设的必经步骤,而是前两条路径都无法解决关键行为问题时才启用。R6 也不再做新的漏洞推理,而是检查前面的工作是否能够诚实结案。
R0:先证明“我们检查的是同一份代码”
设计动机: 代码审计结论只能对特定版本成立。如果审计过程中代码被修改,旧行号、调用链和防护条件都可能失效。没有 R0,后续证据即使写得很完整,也可能指向不同版本的代码。
输入: Campaign 冻结快照、Batch 清单、Work Unit 文件范围和预期摘要。
主要动作:
- 确认 Batch 中的每个文件都属于冻结清单;
- 重新计算当前文件摘要,并与预期摘要比较;
- 发现漂移时记录受影响的工作单元和结论,并阻塞相关 Batch。
输出和门槛: 生成包含快照、范围和文件摘要的 R0 收据。只有 R0 完成,R1 才能开始。
为什么不能省略: Git 提交号只能说明计划检查哪个版本;R0 还要证明 Worker 开始工作时实际读到的文件仍是那个版本。
R1:先画攻击地图,不急着判断漏洞
设计动机: 审计最容易犯的错误之一,是直接搜索危险函数,却不知道攻击者从哪里进入、以什么身份进入,以及数据跨过了哪些组件和信任边界。R1 先建立“地图”,把事实发现与漏洞判断分开。
输入: 通过 R0 校验的工作单元、源文件、组件图、候选边界和仅供导航的热点线索。
主要动作:
- 识别外部入口、调用主体、组件归属和源码位置;
- 记录每个入口是已检查、未产生假设、延期还是仍需处理;
- 对计划器给出的候选边界逐一确认、否认或保留未解决状态;
- 明确哪些路径被检查、排除或延期,不能只上报“有发现”的文件。
输出和门槛: 形成带源码锚点的 Surface、边界审查和范围处置记录。边界漏审、路径处置缺失或源码位置无效都会阻止 R1 提交。
为什么不能与 R2 合并: 如果只保存最终假设,那么“检查过但没有形成假设”的入口会从记录中消失,系统也就无法区分“没有问题”和“根本没有看过”。
R2:把怀疑写成可以被推翻的假设
设计动机: “这里看起来危险”不能被验证。R2 要把直觉转成结构化、可证伪的问题:谁能控制什么输入,经过什么机制,在什么条件下,可能到达什么敏感操作。
输入: R1 的入口与边界、工作单元范围、适用的语言风险资料、机制卡片和热点摘要。
主要动作: 从六个互补分析轴检查风险:
- 入口轴: 从外部 Surface 和攻击主体出发;
- 机制轴: 从反序列化、注入、内存错误等失效机制出发;
- 状态/生命周期轴: 检查初始化、并发、缓存、清理和状态转换;
- 修复变体轴: 查找已修复问题的相邻实现、复制版本或绕过变体;
- 边界轴: 检查跨组件、跨权限域和跨语言连接;
- 差异行为轴: 比较配置、平台、版本、错误路径或部署模式差异。
每个轴都必须记录 APPLICABLE、NOT_APPLICABLE 或 DEFERRED。没有生成假设也是合法结果,但必须说明检查了什么;标记不适用或延期也必须给出范围和理由。
输出和门槛: 每条 Hypothesis 都要绑定工作单元、来源轴、种子证据、机制、已知入口和源码位置。缺少这些字段的“猜测”不能进入 R3。
为什么使用六个轴: 单一提示方式容易形成思维盲区。六个轴不是要求把仓库机械地扫描六遍,而是要求对不同思考角度逐项交代,防止某个角度被无声省略。
R3:用静态证据验证真实可达性
设计动机: 危险入口和危险操作同时存在,不代表攻击者能够让数据从前者到达后者。R3 把“可能”推进为有代码证据的临时判定。
输入: R2 的全部假设以及冻结快照中的源码和构建材料。
主要动作:
- 从声明的攻击主体和入口开始,追踪有序调用链或数据流;
- 为链上的关键边提供源码证据;
- 检查认证、校验、编码、权限、不可达部署条件等反证和拦截条件;
- 对每个假设给出
REACHABLE、UNREACHABLE或NEEDS_REVIEW。
输出和门槛:
REACHABLE必须有非空、有序且逐边有证据的路径,并说明前置条件;UNREACHABLE必须有可信的阻断证据;- 证据不足必须保留为
NEEDS_REVIEW,不能靠猜测补齐; - 静态分析不能把结果写成“已经通过运行实验证实”,经验性确认只属于 R5。
为什么仍称为临时判定: R3 的链条可能遗漏间接调用、部署差异或隐藏防护,因此重要结论还要经过 R3.5 的独立反驳。
R3.5:让另一个角色专门寻找“我们为什么错了”
设计动机: 提出假设的人容易偏向证明自己的判断。R3.5 将确认偏误当成流程问题处理,而不是寄希望于同一个 Agent 自我纠正。
输入: R3 判定及其支持证据、反证和未解决条件。
主要动作:
- 由身份不同的 Worker 独立寻找遗漏防护、错误调用链、不可控输入或被夸大的影响;
- 反驳者不能先看到其他反驳者的结论;
- 裁定者不能裁定自己提交的反驳;
- 对初始
UNREACHABLE结论进行复活复核,防止错误的否定结论让真实风险永久消失。
输出和门槛: 保存反驳证据、争议点、正反材料、裁定者和最终处置。成功反驳或复活会重新打开假设,并使依赖旧结论的下游结果失效,直到重新检查。
为什么放在 R4 前: R4 要基于一组经过质疑的假设和判定检查类别覆盖;否则错误的早期结论会被后续覆盖表原样放大。
R4:从安全类别反向检查遗漏
设计动机: 即使每条已提出的假设都验证得很好,Agent 仍可能完全没有想到某类风险。R4 不再只问“这些假设对不对”,而是问“计划要求检查的风险类别是否真的检查过”。
输入: 计划内的 Work Unit/安全类别组合,以及 R2 假设和 R3 判定。
主要动作:
- 对每个计划内的工作单元和安全类别记录
COMPLETE、NOT_APPLICABLE或DEFERRED; - 保存检查证据、覆盖范围和未解决问题;
- 可以把已经存在的正式 Finding 归属到相应类别,但不能借类别任务绕过 R2-R3 流程直接制造 Finding;
- 没有发现漏洞可以是有效结果,但“零发现”必须伴随检查证据。
输出和门槛: 所有计划组合都必须有可解释处置。新发现的候选问题要作为剩余风险保留,或重新送入假设验证路径。
为什么 R3 和 R4 都需要: R3 保证单条结论有深度,R4 保证计划范围有广度;只有深度会漏类别,只有广度又容易退化成打勾式检查。
R5:只在静态证据无法回答时做实验
设计动机: 有些问题取决于运行时配置、库版本、序列化格式或并发行为,单看源码无法可靠判断。但“能运行一条命令”也不代表实验可信,所以实验必须晚于静态分析,并绑定具体未知。
输入: 需要经验性确认的假设、R3/R4 暴露的关键未知、实验配方、环境和工具链信息。
主要动作:
- 说明为什么需要实验,以及实验要区分哪些可能结果;
- 记录前置条件、精确命令或动作、输入、观察、工具版本、保真度和清理结果;
- 将实验绑定到对应 Hypothesis;未绑定的独立运行不能升级 R5 结论;
- 工具缺失、环境不安全或实验不可行时,明确记录
NOT_FEASIBLE或NEEDS_REVIEW。
输出和门槛: 生成可复核的实验材料和评估。启动失败、超时或环境缺失不是“漏洞不存在”的证据;外部实验还需要来源和审阅者证明。
为什么不是所有假设都实验: 实验昂贵、可能有副作用,也可能因环境失真产生错误信心。源码证据已经足够时,额外实验不会自动让结论更可靠。
R6:结案前对账,而不是再做一次分析
设计动机: 前面各阶段分别产生入口、假设、判定、复核、类别记录和实验。如果不统一对账,很容易出现“发现有证据,但交接没完成”或“报告说已覆盖,实际还有延期路径”的情况。
输入: R1-R5 的全部阶段材料、正式 Finding、Handoff、漂移事件、遗漏路径和剩余风险。
主要动作:
- 核对阶段产物是否与 Batch 清单一致;
- 列出仍开放的跨批次交接、漂移、延期、排除范围和未知问题;
- 区分已证实发现、被否定假设、未解决风险和工具/环境限制;
- 从不可变记录推导 Batch 报告,而不是让 Worker 自行填写工具拥有的统计字段。
输出和门槛: 生成 Batch 结案证据和剩余风险声明。任何必需材料没有闭合时,Batch 应保持开放或阻塞。
在这些阶段中,程序、Agent 和人分别负责什么?
| 参与者 | 能负责的事情 | 不能自动保证的事情 |
|---|---|---|
| xNext 运行时 | 固定阶段顺序,生成任务,检查 schema、范围、源码锚点、证据引用和覆盖数量,保存事件并阻止缺项结案 | 不能仅凭字段齐全判断调用链在语义上一定正确,也不能证明漏洞真实存在 |
| 宿主 Agent/Worker | 阅读源码,识别入口,提出假设,追踪调用与数据流,寻找反证,解释实验观察 | 不能自行修改阶段门槛,也不能把未经证实的判断包装成运行时已验证事实 |
| 独立反驳者和裁定者 | 从不同立场复核高风险结论,比较正反证据并记录争议处置 | 独立身份本身不等于判断正确,仍可能共同遗漏同一问题 |
| 人类操作者或安全审阅者 | 决定审计范围、预算、例外和外部隔离要求,检查高影响结论并承担最终使用责任 | 不能因为流程完整就宣称项目绝对安全 |
因此,R0-R6 的主要价值是让推理过程可追踪、缺口可见、结论可反驳。它能验证很多结构条件,但无法自动验证所有语义真相。
3. 设计权衡:为什么这样做
| 选择 | 获得的优势 | 付出的代价或潜在问题 |
|---|---|---|
| 固定快照和严格漂移处理 | 证据与代码版本一致 | 活跃开发中的仓库需要额外冻结和重验证成本 |
| 拆分 Work Unit/Batch | 可并行、可恢复、适合大仓库 | 边界划分不当会增加交接;过度拆分可能提高上下文和调度成本 |
| 事件追加而非覆盖状态 | 可以审计历史和解释修订 | 数据模型、报告投影和下游失效处理更复杂 |
| 候选与结论分离 | 降低把模式匹配当漏洞的风险 | 需要 Agent/审阅者投入更多验证工作 |
| 严格 JSON 合同和失败关闭 | 结果更可组合,缺失覆盖不易被隐藏 | Worker 输出必须精确,可能增加重试和操作负担 |
| 安全知识按任务注入 | 控制上下文并记录遗漏内容 | 预算裁剪可能产生语言/风险类型偏差,需要评估监控 |
| 独立反驳和留出评估 | 更容易发现过度确信,并能测量真实能力 | 需要额外 Agent、人工裁定、样本和成本 |
| 资源受控实验而非内置强沙箱 | 实现简单,可记录常规行为实验 | 无法安全承载对抗性本机代码,必须依赖外部隔离 |
| 覆盖优先于体积,必需项不能为省 token 省略 | 覆盖缺口无法被悄悄掩盖,结论更可信 | token 消耗很高,且目前没有事前成本预测和预算闸门(见第 12 节) |
4. token的问题怎么解决
token 消耗为什么这么高
| 成本来源 | 具体机制 |
|---|---|
| 任务数量随规模增长 | 每个 Work Unit 至少一个 R1 任务和一个 R2 任务;R3、R5 按假设数量生成任务;R3.5 还要追加反驳、裁定和复活复核任务;R4 按安全类别生成任务 |
| 每个任务都要重新读代码 | Worker 必须真实阅读工作单元内的源文件才能声明覆盖;默认一个 Work Unit 最多可达 1000 个源文件 |
| 上下文被反复注入 | 每个任务都携带范围、输出 schema、分析要求、安全知识条目、机制卡片和热点摘要;不同任务之间无法共享这部分输入 |
| 输出要求结构完整 | 覆盖优先于体积:R1 要对每条边界逐一给出处置、证据和理由,R2 要对六个分析轴逐一表态,即使结论是“不适用” |
| 单个结果可能极大 | 结果软目标为 1 MiB,硬上限为 4 MiB。1 MiB 的 JSON 大致相当于数十万 token 量级的输出,单个任务就可能消耗巨量预算 |
| 失败要整份重交 | 覆盖不全或结构错误会被拒绝;任务保持租约,但 Worker 需要重新提交完整结果,之前的输出成本无法回收 |
| 独立复核是额外成本 | 反驳和裁定要求独立审阅者重新阅读证据,本质上是对重要结论付出第二次甚至第三次分析费用 |
简单估算方式:总成本 ≈ 任务数 × (每任务输入上下文 + 代码阅读量 + 结构化输出)× (1 + 重试率)。在大型仓库中,这几个因子会同时放大。
我们已经做了哪些优化
- R2 默认使用紧凑模式,一个 Work Unit 一个任务,而不是拆成六个分析轴任务;
- 任务中的文件列表按目录分组,避免重复路径前缀;
- 热点报告在任务上下文中只保留计数,不重复可从工作单元推导的路径列表;
- 安全知识按任务预算裁剪,并记录被省略的内容,避免整份知识库进入每个提示;
- R1 任务输入用边数量替代完整边 ID 列表;
- 审计范围可以用
--categories限定,未选中的安全类别不会产生任务; - 支持记录
input_tokens、cache_read_tokens、output_tokens,结案报告会汇总各操作用量和缓存命中率。
目前主要工作重点就是继续定位和降低 token 消耗。
附录 A:术语小词典
| 术语 | 简明解释 |
|---|---|
| Host Agent(宿主 Agent) | 实际接收审计任务、阅读代码并提交分析结果的 AI Agent |
| Campaign(审计活动) | 围绕一个固定代码快照组织的一次审计 |
| Batch(批次) | 可以单独安排、继续和收尾的一组工作 |
| Work Unit(工作单元) | 规划器分配的一小块代码审查范围 |
| Surface(入口) | 外部用户、数据或系统进入被审计项目的位置 |
| Principal(主体) | 能发起请求或控制输入的用户、服务或其他调用方 |
| Sink(敏感操作) | 需要验证的操作,例如文件写入、命令执行或权限变更 |
| Reachability(可达性) | 在给定条件下,输入能否沿路径到达敏感操作 |
| Counterevidence(反证) | 会削弱或推翻某项风险假设的代码事实或实验观察 |
| Handoff(交接) | 跨工作单元的事项、负责人、证据及处理状态 |
| Artifact(证据材料) | 可引用、可校验地保存的任务输入、输出或实验材料 |
| Held-out test(留出测试) | 不提供给日常发现流程、用于独立衡量能力的测试样本 |
最后
这个 skill 目前还是早期版本(只完整跑过两次优化流水线),token 消耗仍然偏高,Firefox 也只完成了 54/84 个 batch。
但它已经验证了几件事:
- 超大仓库可以拆成可恢复的 Batch 长时间跑;
- 用严格的证据合同 + 独立反驳,能显著降低 LLM 的幻觉结论;
- 覆盖优先于省 token,结论可信度会明显提升。
欢迎有兴趣的朋友直接拉取试试,或者在评论区讨论:
- 你觉得 R0-R6 这个漏斗设计哪里可以再简化?
- 有没有更好的 token 优化思路?
冰与火的战歌:Windows内核攻防实战高级班!从零到实战,融合AI与Windows内核攻防全技术栈,打造具备自动化能力的内核开发高手。
赞赏

|




