声明:仅用于安全技术研究与教学,全部分析在隔离测试设备/离线环境中完成。
加固的 VMP 各家做法差异极大,而这个差异直接决定了"要花多少代价去还原"。
把两个真实样本并排拆开:
两条主线结论:
壳 A:16 个 opcode 的混淆写已全部提取、跳转表 16/16 逐项验证、#238 的解释器路径真机跑通;
但「编号 → Java 方法名」经命名路六轮、七条路逐条实测后裁决为「运行时观测面已穷尽」(那层索引不在运行时数据里)。
壳 B:分派链五跳全部实测闭合、handler 语义覆盖率 99.9%(只剩 1 个 sshll(SIMD) 形状);
但 handler 内部的逐指令语义仍未做到。
两次实验都做了,且都如实给了结论:一次命中(数值级验证)、一次未命中(保留为否决)。
更巧的是,两边的卡点性质相反:
壳 A
壳 B
(1)脱壳 / 指令抽取类工作:解决的是"DEX 拿不回来" ——
在 ART 里插桩或内存 dump,再把 code_item 重新填回去。这类工作的终点在 Java 层:拿到能反编译的 dex 就算成功。
本文不问"代码在哪",而问**"壳的虚拟机长什么样、怎么分派、能还原到哪一步"**—— 两者的技术栈只在"样本相同"这一层重叠。
(2)模拟执行 / 符号执行:本文壳 A 侧走的就是这条路。
优点是能"一步步跑";代价有两个:① 模拟器的指针/上下文传递与真机有差异;
② 模拟器里"跑得通"不等于真机上"跑得对"。
(3)动态插桩 / hook:在有 RASP 的样本上,它们本身就是被针对的对象;因此本文全程用 "零代码改写"的定点取数 ——
只替换一个数据指针或表项(core+0x20、16 项跳转表、JNIEnv[215]),不插桩指令、不改代码页。
(4)加固壳 VMP 分析:
① 两个商用壳并排;
② 把分派链跑到运行时;
③ 干预式验证。
一句话:本文的定位是"结构 + 分派 + 机制"三层,并且三层都以可检验的形式给出。
libdexjni01.so 的 98% 内容是加密数据;明文只有 ~11 KB 的 loader stub。链路是:
关键点:解密目标段不在模块基址上,而是运行时 mmap 出来的 RWX 段 ——
所以静态在 module.base+0x13090 处看到的是密文,必须让 loader 真跑一遍。
本项目用 unidbg 跑通 sub_13F8(期间需注册壳的自定义 svc 63505 = mmap2 反模拟检查),
再从正确的基址连续 dump,得到 payload_clean_full.so(103 函数)。
cL 函数体调用 loc_10950 —— VM 入口。序言建立 VM 环境后进入主循环:
入口序言(0x10950 起,实测):建栈 SUB SP,SP,#0x2A0、把两个入参存到 [SP,#0x10]/[SP,#0x18]、
X21 = X0(JNIEnv/对象)、X25 = X29 - 0x90(虚拟内存的落点),
随后把 0x7D492 处的数据(ldp q1,q2 + ldur q0,共 44 字节)搬进 X25,
并把哨兵指针(off_107FF0)快照到 [SP,#0x20](供 opcode 15 校验)。
最后 MOV W8,#0xA —— VM 的初始 opcode 是 10,与动态 trace 的首个 opcode 一致。
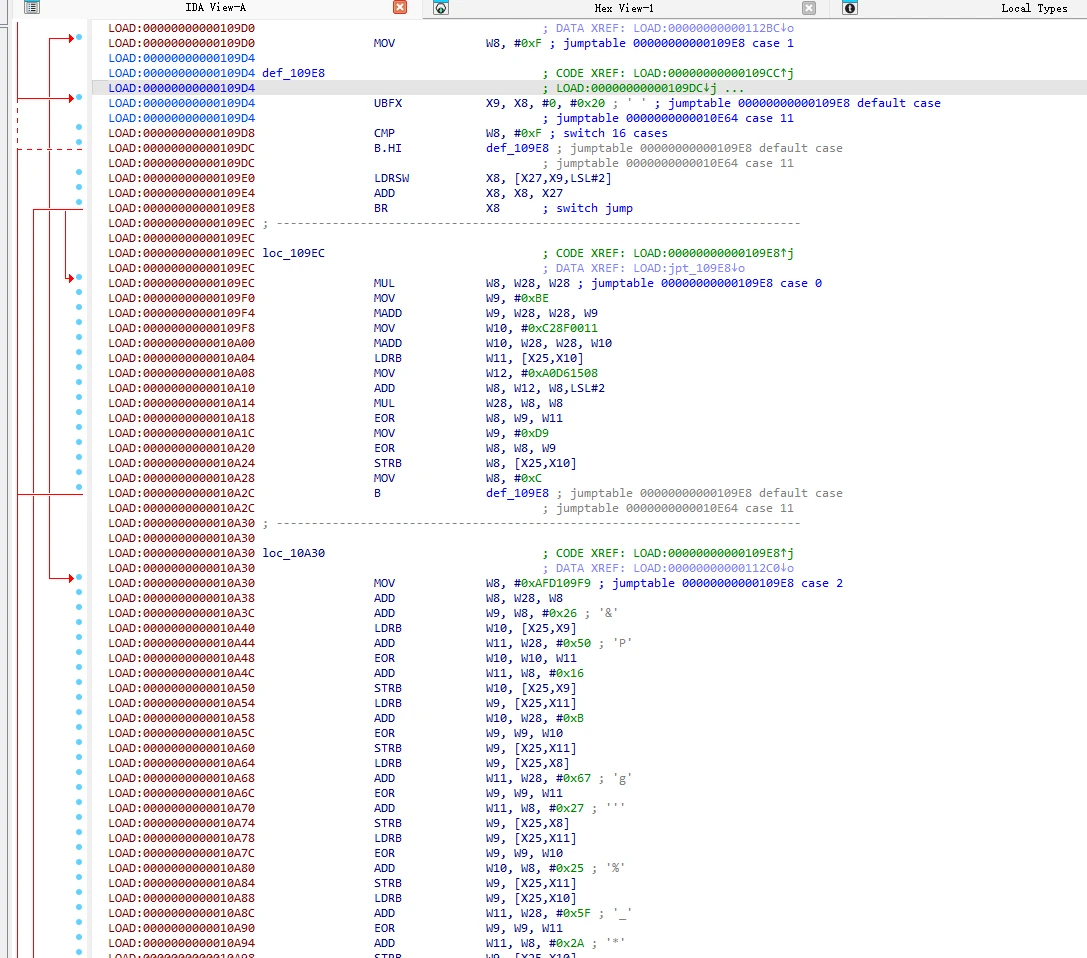
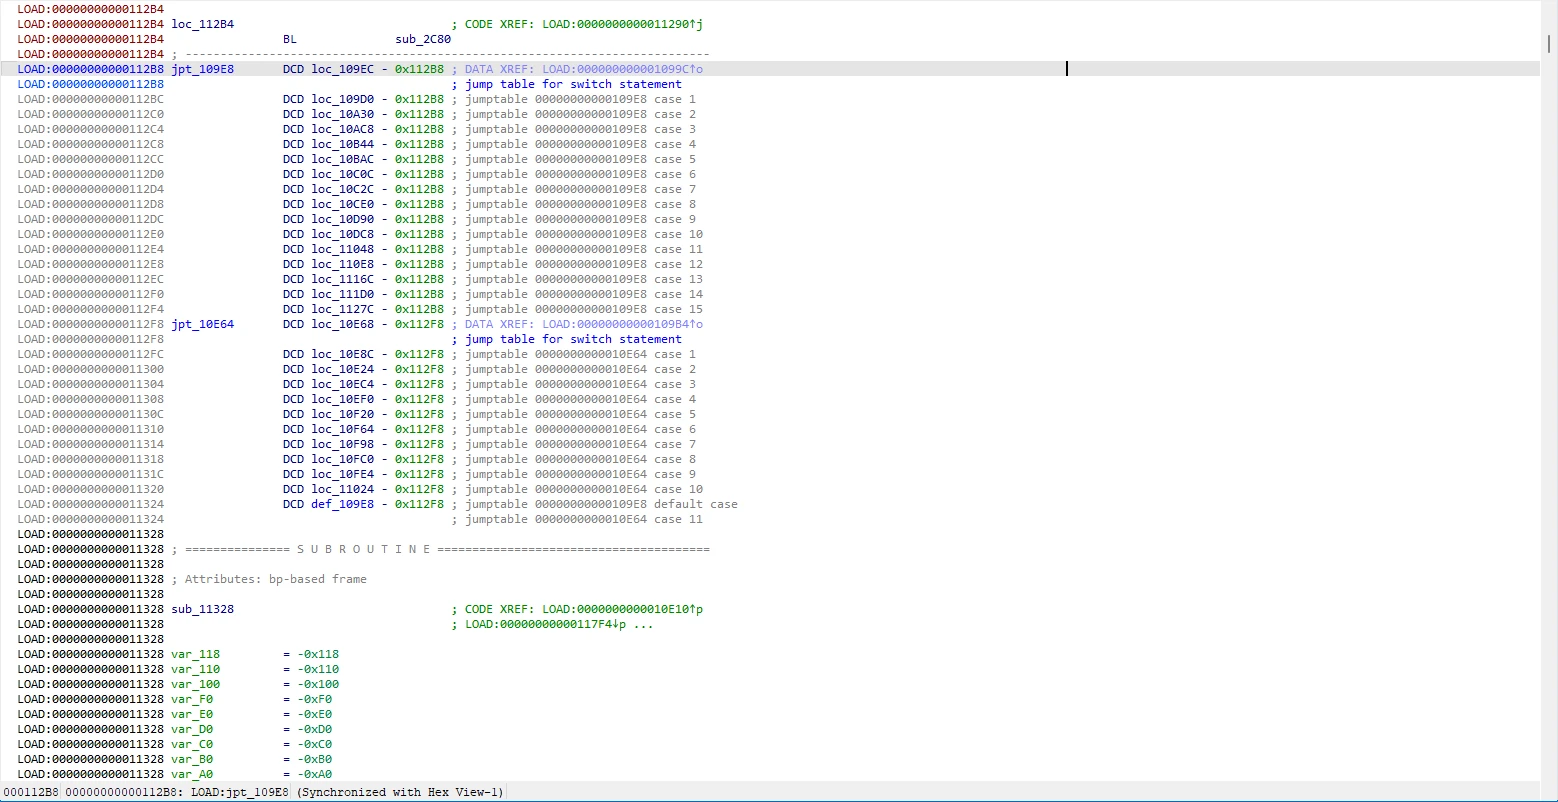
主跳转表在 0x112B8:16 项,逐项验证全部指回 16 个 opcode 的入口(相对偏移,LDRSW + ADD + BR)。
壳 A 的 VM 主循环与 16 项跳转表(IDA 反汇编)
三个状态对象:
对整段解释器逐个 case 做符号化反汇编提取,得到 16 个 opcode 的语义表 ——
每个 opcode 的"X25 混淆写次数"与 next 都是可核的:
统一模式:byte[X25 + addr] ^= key,其中 addr/key 都由 W28(+W19)经混淆算术派生 ——
也就是说,数据在执行过程中被就地解密。以 opcode 14 为例(6 条,与手工核对逐字一致):
W28 状态链只有 4 类更新原语,这是"可符号化"的前提:
⚠️ 一处待解的疑点:addr 由 32 位寄存器算出(如 W28 + 0xAFD109F9),
在 W28 初值 0xE568AAEC 下会得到远大于栈区的偏移。这说明二选一:
要么这些 case 只在特定的 W28 值(状态链推进到某处)时才会被执行,
要么它们的地址语义需要按某种截断/取模理解。目前静态无法判定,必须靠动态 trace 的 W28 序列来闭合。
混淆写轮给出答案:是"前者"—— dispatch trace 实测该流程里 VM 只执行 op1/op5/op10/op15(三次运行一致),
其余 12 个 opcode(也就是 41 条混淆写所依附的全部)一次都没被 dispatch;
也就是说只有状态链推进到别的 W28 序列时才会进入那些 case(而那条短循环四步的混淆写次数都是 0)。
opcode 10 占 157 条指令(实测),是"偷指令"真正发生的地方:
即:opcode 10 = methodID 查表 → JNIEnv 槽位调用 → 按返回类型(12 case)写 VM 寄存器文件。
cL(#239) 里的 KeyGenerator.getInstance("AES") 调用链正是经此完成 —— 与动态 JNI 日志一一对应。
编号探针·1(把"参数面"直接读出来):把 JNIEnv 表 +0x568 那一项换成探针(零代码改写)后,
VM 自己发起的 1345 次调用(caller 落在 payload 的匿名 rwxp 段)里,x2(即上面的 W23 = W0 − 1)取值是:
⇒ W23 是参数数组的序号(与"逐参数解析"、模拟器里的 w22/w23 参数计数完全吻合),
不是"被保护方法的编号"(那是 #238/#239 的量级)。这也解释了为什么"在 VM 层区分 #238/#239"注定做不到:
VM 层结构上不含这个信息(见本节后面的实测)。
编号探针·2(同一天,把"方法编号"本身也读出来):编号探针·1 只 hook 了 +0x568,
+0x558(第一次调用)与 loc_12BD4(methodID 解析)那两格是空的。本轮把 loc_12BD4 的入口
改成一条 b <trampoline>(只覆盖 1 条指令,其余原样重放),记下它的入参 W0:
命名路:六轮实验,把「编号 → Java 方法名」这条锚点逐条走完。
一共七条路(六条运行时 + 一条静态)全部实测排除,只剩"行为级对拍"(高成本、非"名字级"):
⇒ 三条结论:
边界:本项是代码级最小插桩(只覆盖 1 条指令、其余原样重放),与其它各项的"零代码改写"口径不同;
装置:一个 hook loc_12BD4 入口的注入体(只覆盖 1 条指令、其余重放)。
基于上述语义实现了 Python 符号执行模拟器(X25 bytearray + W28/W19 32-bit + vm_regs[8]),
四步验证全部通过:
⇒ #239 这条路径是"真闭环"的:解释器语义 + 状态链 + 模拟器三者互证。
真机补测—— 这条"闭环"曾有一个缺口,现已按实测补上:首次对拍时
只有 opcode 序列一致、状态值并不一致;按反汇编推出公式并用真机读数校验后,四步状态值全部对上(4/4):
两处修正都来自反汇编,不是凑数:
✅ 补完:op10 之后的 W19 也从"实测值"升为"公式"。
op10 是一条内嵌二级分发(x26 = 0x112F8,一张 12 项表);真实路径逐跳解开后是:
代入 0x176b ⇒ w8 = 0x96 ⇒ W19 = 0x4e03 - 0x96 = 0x4d6d,与真机读数逐位吻合;
且穷举 w23(= 参数数 − 1)为 0/1/2/4/8 都得到同一个 0x4d6d⇒ 它是这条参数循环结构的不动点,
与本条路径上的运行时数据无关(X24 的内容只影响 VM 寄存器文件与下一 opcode)。
复现:纯离线,把二级跳转表与真机读数对拍。
#238(AES/CBC 加密)进入 VM 后,unidbg 在 opcode 10 的大 case 处崩掉:
判断:
主解释器 → opcode 10 的寄存器/栈上下文传递在 unidbg 中失效,
疑似壳在 opcode 9→10 的寄存器保存/恢复中发生高位指针被截断(低 32 位被损坏),
而非 longjmp/异常切栈(解密后的 payload 中未见 setjmp/longjmp/signal 特征)。
三条旁证交叉确认:
静态能做到哪一步:16 个 opcode 的混淆写已经全部提取(41 条),
连 opcode 之间的 next 也已确定(多数固定、两个动态)。但要让这 41 条真正解开 X25 的内容,
必须先知道路径上每一刻的 W28 —— 没有动态 trace,W28 就是未知的。
⇒ 壳 A 的"最后一格"不是"看不懂汇编",而是"缺一份运行时状态序列"——
而这恰好可以用壳 B 项目里已经跑通的"真机带外取证 + ROM 打点"补上。
✅ #238 所在的解释器路径在真机上跑通了,且用的是零代码改写的办法
只把 16 项跳转表——RWX 段里的数据——换成记录 stub。
多轮实测给出的结论:
⇒ 四点结论:
① "卡点在模拟环境而非 VM 语义"被真机数据直接证实—— unidbg 崩掉的 opcode 10 在真机上正常执行,
后续 5,1,15 完整走到 op15 哨兵校验通过;
② 文章缺的"运行时状态序列"这一格补上了(W28/W19 实测值);
③ X25 在这条路径上不被写—— 所以"X25 里藏着 VM 字节码程序"这个说法要修正:VM 的"程序"就是
这条由分发流程决定的 opcode 序列,X25 只是 44 字节的初始化数据区;
④ 顺带查出现有模拟器的状态更新与真机不一致,并已按反汇编 + 实测修正到 4/4 一致。
关于"逐条区分 #238 与 #239":两次专门采集(v6 读 X25 区 96 B、v7 再读栈帧上部 X29+0x00..0x2F)
都没有在任何 VM 层可见位置找到 methodID(238/239 的 u32/u64 搜索均未命中)。
这反而给出更强的结论:VM 层对被保护方法完全同构(序列、W28/W19、X25 全同)——
#238 与 #239 在 VM 层的执行一模一样,差异只落在 op10 内部处理的 JNI 方法上。
所以"区分"在 VM 层既不必要也不可行(要抓 methodID 得在 op10 handler 内部插第二个记录点,那就不是"零代码改写"了)。
✅ 补:那个"第二个记录点"已经插上了—— 把 methodID 查表器 loc_12BD4 的入口
换成一条 b <trampoline>(只覆盖 1 条指令、其余原样重放),就拿到了它的入参 W0 = 方法编号本身
(63 个不同编号、范围 0x13d~0x1057、同一编号稳定重复)。结论因此更精确:
编号不是"搜不到",而是"不以 VM 状态形式存在"—— 它是 loc_12BD4 的瞬时寄存器实参。
③ 档扰动实验:先预测、再让真机证伪—— 前两档都是"观察式一致",这一档是干预式:
⇒ 4/4 命中:模型给出了可被推翻的预测,而真机没有推翻它。
**第二个扰动(更强):表项[15] → stub_1。**假设 op1 的 next = 15 ⇒ 分发链会变成 op1 → op1 → op1 …。
事先预测:VM 永不退出⇒ ① trace 出现连续大量 op=1;② 32,768 条的环形缓冲被打爆(日志出现 # OVERFLOW);
③ 该调用线程被拖死。实测:记录 4,845 条里 4,842 条是 op=1(99.9%)、末尾 20 条全为 op=1、
日志出现 # OVERFLOW pos=5798855(缓冲溢出时的分派计数),App 进程随即消失 ——
而在同一触发流程下正式版每次调用只有 4 条记录。⇒ 预测成立(相差 5 个数量级)。
③ 档只动过两个表项([5]、[15])。既然跳转表只有 16 项,那就把每一项都单独试一遍——
这样"③ 档"就不再是"分派层的抽查",而是逐条 opcode 的可证伪验证。
方法:对 i = 0..15 各跑一轮,注入体编译时把表项[i] 重定向到 stub_1(-DREMAP_FROM=i -DREMAP_TO=1),
每轮先 force-stop 重启 App(干净起点,上一轮的注入随进程消失),并另有一个同源码不加宏的对照组。
事先写下的预测(机械、可被推翻):模型给出的真实路径是 10,5,1,15 ⇒
⇒ 16 / 16 命中。三条推论:
环境前置(本轮踩过的坑,值得记):① 壳 A 样本同样要先开反检测环境(/data/local/tmp/start_bank.sh:
时间窗 + setup_stealth + 重启 zygote)——不跑的话 ptrace attach 会一直挂着;② 注入目标要选主进程
(ps 里 NAME=com.mobile.bank 且 PPID 不在本 App 的 pid 集合内的那个——壳还有同名子进程/隔离进程);
③ App 冷启动后要等 ~14 s再注入(payload 还没解密完时注入体会报"16 项跳转表未找到")。
完整 16 轮原始记录与逐条判定;分析与批量采集脚本均为纯离线。
在动手之前先回答一个问题:壳 B 的 VMP 到底保护谁?
判据是 Dalvik opcode 的合法区间 —— 0x00–0xE2 ∪ 0xFA–0xFF,
其中 0xE3–0xF9 是 AOSP 保留的 unused 区:若壳把方法换成了自定义指令集,必然在这里露馅。
对 5 份业务/三方 dex(合计 210,061 个有代码方法,按本表求和)实测:
复算与口径(补):
需要说明的是:工作区现存的 dex 与做这张表时用的那一批存在
±1.6% 的版本差异("三方库合集"现测 56,598、"壳 RASP"现测 3,361 与表中一致;
另两份现值 50,497 / 45,021 与表中的 50,495 / 45,746 略有出入)。
差异来自 dump 轮次 —— 不影响结论:严格口径(每个 code_item 的首指令)
的保留区命中在任何一版上都是 0,即"业务方法 100% 标准 Dalvik"这一点稳定成立。
⇒ 业务方法 100% 是标准 Dalvik 字节码,ijm_vmp 只覆盖壳自身——
这条判据同时决定了"要不要继续逆它"。
壳 B 的执行体 libexec.so 与壳 A 不同:它不是 UPX(PT_LOAD(rx) 的 filesz == memsz),
而是代码段整体加密—— 磁盘上按 4 KiB 扫描,多处"可解码指令为 0",.symtab 也被破坏。
真正的代码在运行时解密到「紧跟 so 之后的匿名可执行段」:
真机上(root、无侵入 dd if=/proc/<pid>/mem)取出那 581,632 B 后:
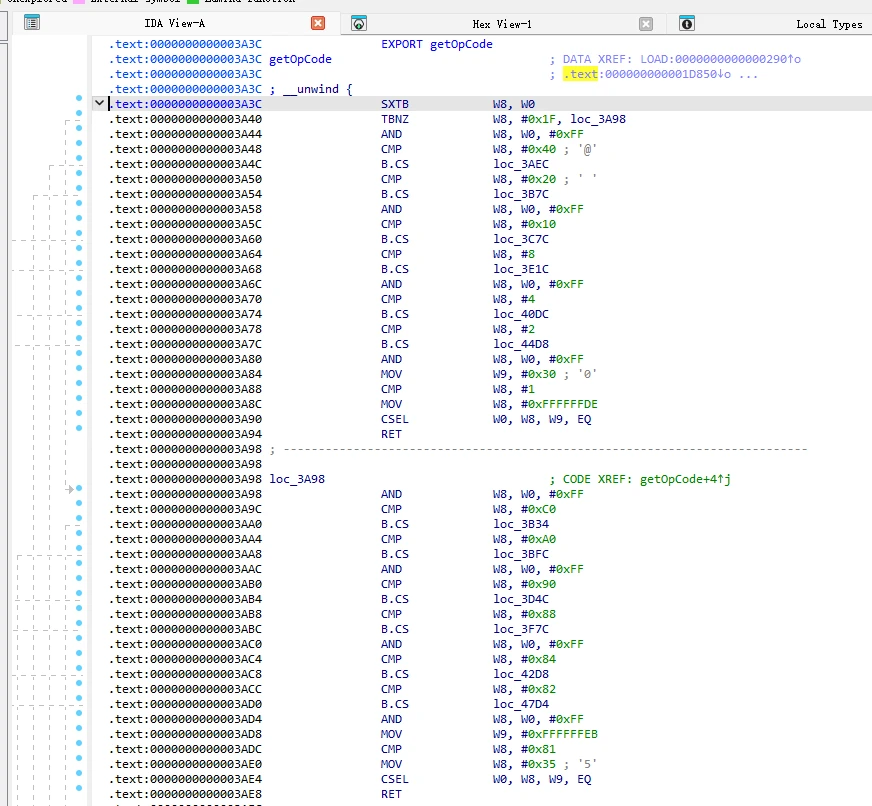
壳 B 的分派是跨两个 so的。libexecmain.so(唯一导出符号 getOpCode,0x3a3c,4244 B)负责前半段:
(a) getOpCode 是一张 256 项的双射置换表。
它是纯二分决策树(内部 128 个 ret、253 个 cmp + 126 个 csel,bl/blr/br/adrp 全为 0),
因此可以静态还原:反汇编后跑一个只认 mov/cmp/and/sxtb/tbnz/b.hs/bics/csel/csinc/csinv/ret
的迷你解释器,喂 0x00–0xFF,得到 256 个 opcode → 256 个互不相同的内部编号(值域 -128..127)。
壳 B 的 getOpCode:纯二分决策树的 256 项置换表(IDA 反汇编)
(b) 它还构造"553 项分派描述符"。
构造函数(.init_array[0])malloc(0x40) 出一个描述符挂到全局 core:
跳板只做一件事 —— 按索引转发:
真正的执行体在 libexec.so 的解密段里。把它的 r--p 段(36,864 B)按 8 字节小端扫一遍,
找"值落在解密段范围内的函数指针"的连续片段,得到 18 张表、合计 872 项、去重后 531 个 handler 地址:
真机实测证明 thunk_i = 某个 Java native 方法的实现指针
(ArtMethod->data_)⇒ 它内嵌的常量是"第 i 个被注册的
native 方法的编号"。因此本节指令集对照表里"VM 指令集 / opcode"的表述应理解为
"方法编号的分发空间"。
被一并标为"待重新审视"的"变长指令编码"一项,曾据离线证据判为成立——
描述符 +0x00 指向的表当时被读成"变长指令的边界表":(u32 累计偏移, u32 长度) 对、98 项、
相邻项满足 off[i+1] == off[i] + len[i](98/98 自洽)、累计总长 0x229 = 553 字节、
单条长度 1 ~ 53 B。
这 531 个 handler 到底有几种"形状"?(纯静态聚类,无真机:
把寄存器编号归一成 xR/wR、立即数归一成 #I、条件码归一成 CC 后做指纹)
⇒ "531 → 十几类"这个预期过乐观:只有把相似度放宽到 0.70 才降到个位数(那时已把语义不同的
handler 混为一类,失去意义)。合理口径(0.850.90)下是 5059 类;但前 10 类就覆盖 89~93% 的表项——
既然 371/531(70%)的 handler 只被引用 1 次、最高频那 1 个就占 15.4%,正确的成本模型是
"按频次 × 形状排序,先做头部",而不是"先聚类再全做完"。
长度也高度集中在三段:78 条(149 个)、15 条(135 个)、2627 条(74 个)。
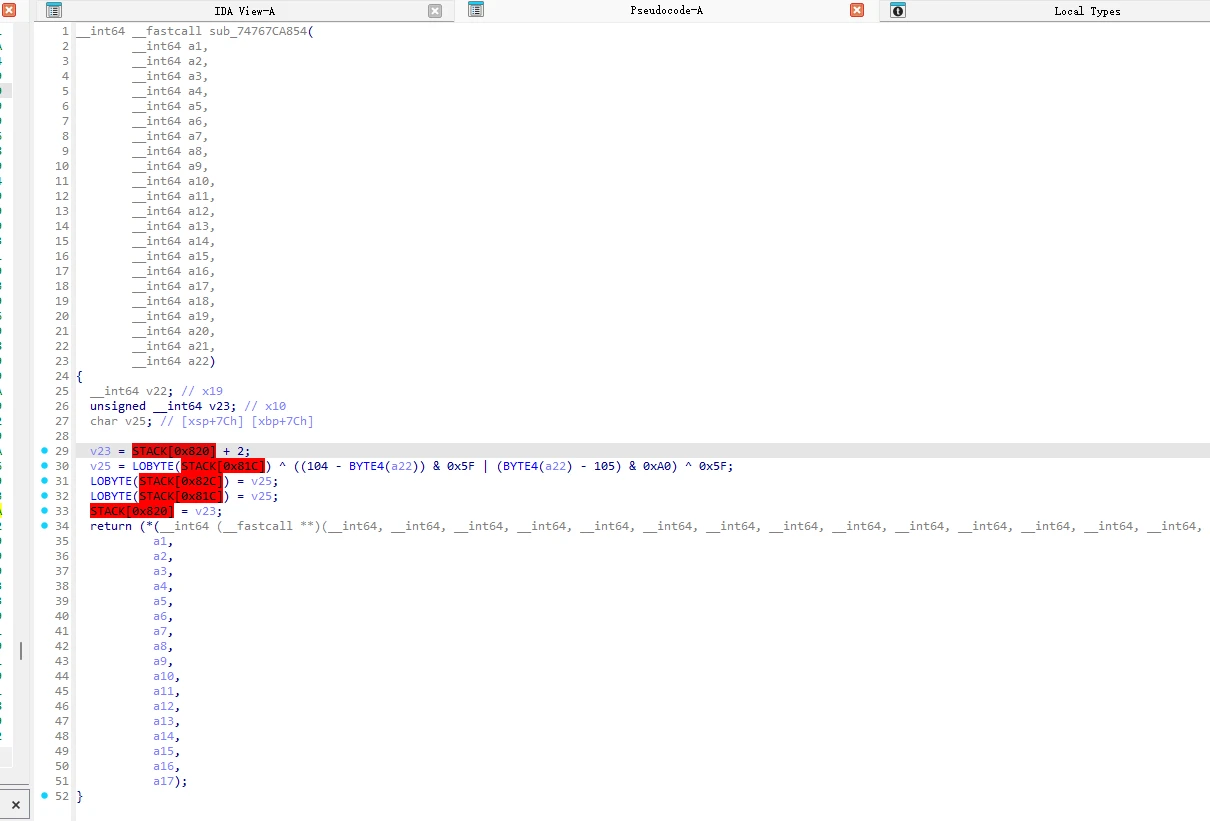
反编译最高频那个 handler,VM 的形态一目了然 —— threaded-code:
即:VM 状态(IP + 虚拟寄存器)放在栈上,22 个通用寄存器把状态直接传给下一个 handler,分派靠尾调用
—— 没有中心 dispatch 循环,所以前面那 **811 处 br/blr**就是这 443 个 handler 的尾巴。
壳 B 最高频 handler 的伪代码:VM 状态在栈上 + 尾调用分派(IDA F5 反编译)
描述符的 +0x00 一直记作 &unk_29150("疑为长度表")。它确实就在磁盘上(.data 段,不是运行时才填的),
把它按 (u32, u32) 读出来,98/98 项全部满足 off[i+1] == off[i] + len[i]:
⇒ 当时(早些时候)据此读成"变长指令的边界表":每条指令的起点与长度,
于是壳 B 的"VM 程序"第一次有了形状 —— 98 条指令、总长 553 字节。
这个语义后来被更正了(结构自洽 ≠ 语义,事后再看这一步是明显的过度推断):
把描述符 +0x00 置成未映射地址后,SIGSEGV 直接指认了读它的代码(匿名解密段 +0x50810)——
那里的用法是按段遍历一张 24 字节/项的方法表:
⇒ 它是 「553 项方法表」的 98 段分段索引:第 i 段覆盖方法表的第 [off[i], off[i]+len[i]) 项。
而 off[97] + len[97] = 538 + 15 = 553 恰好闭合 —— 所以"总长 553"与"553 项表"不是巧合,是同一个 553。
而它紧挨着的另一半是 +0x08 的553 项指针表:0x28008 + 553 × 8 = 0x29150(正好接到边界表开始),
0x29150 + 98 × 8 = 0x29460(正好是 .data 结束、.bss 开始 —— 那儿只有 core 变量那 8 字节)。
8 + 553×8 + 98×8 恰好等于 .data 的大小 0x1460—— 一个字节不多、一个字节不少:
⇒ 这两张表不是"碰巧都在 .data",而是同一套结构的两半(一张运行时填、一张静态写死),
被描述符一起交给 VM。
(指令集对照表里"变长编码"那一行已作废:+0x00 是方法表分段索引,不是指令边界。)
静态"看得见"还不够 —— 于是做了一次干预实验(仍是零代码改写:只写数据,注入体只改边界表里的一个字节;
把 so 推到 App 的 lib/arm64/ 后"启动即注入",注入体内部每 5 ms 轮询 core 变量,一填好就动手):
末列 = logcat 里 chromium 标签的行数(WebView 侧日志):A/B 组 25~26 行说明进程跑到了 WebView 初始化,
C 组只有 9/7 行 ⇒ 崩得更早。这一列只是“进程跑到哪一步”的旁证,与结论无关。
而 C 组的崩溃栈直接指认了壳的自检:
⇒ 三条结论:
边界:崩点在自检链的 Java 侧;"到底哪一条指令错位、错位后走了哪条岔路"还没逐条定位;
B 组只试了表项[0] 一处,不能推出"任意单点改动都被容忍"。
再往下钻两层:决定崩不崩的既不是「总量」也不是「形态」,而是「具体哪三项」
最早一轮(连续区间扫档)给出"≤12 稳 / ≥16 崩";又一轮(破坏形态 + 重复)把它修成"某段连续错位 ≥16 项";
但把破坏位置换一下又对不上了 —— 于是有了这张三轮自我修正表:
第三轮的做法:① 同样项数换位置;② 专挑"减少量最大"的单点;③ 二分到 4 项;④ 单点定位 + 重复验证。
⇒ 错位量完全不是自变量(−2 B 崩、−67 B 稳、−52 B 稳)。于是往下做单项二分:
判据也升了级:PID_after 从"单次查询"改成 6 次 × 1 s 的采样序列(排除"恰好查在重启窗口"的假阳性),
并用 logcat -b events 确认观测到的消失是进程自己死(am_proc_died 没有对应的 am_kill):
⇒ 结论:关键项 = 边界表的 {14, 65, 83}。
崩在哪(两轮合起来才完整):只要动了边界表,壳的隔离进程就普遍报
demoSMExecption: 完整性校验-签名校验失败(Java FATAL)——
"动边界表 = 壳自检失败"这条成立;但主进程是否退出,只取决于动的是不是 {14,65,83},
且主进程那一条没有Java FATAL、也没有新 tombstone ⇒ 更像 native 侧的静默退出。
把"改这张表 ⇒ 壳退出"一路修到"关键项 = {14,65,83}",但为什么是这三项一直空着。
两项实验把它补上。
(a) 先把崩因抓全(先前几轮只证明了"进程消失")。方法:先起流式 logcat 再冷启动 App
(不然环形 buffer 会把关键行冲掉 —— 这套设备上踩过的老坑)。跑 -DPATCH_IDX=14 -DPATCH_VAL=1:
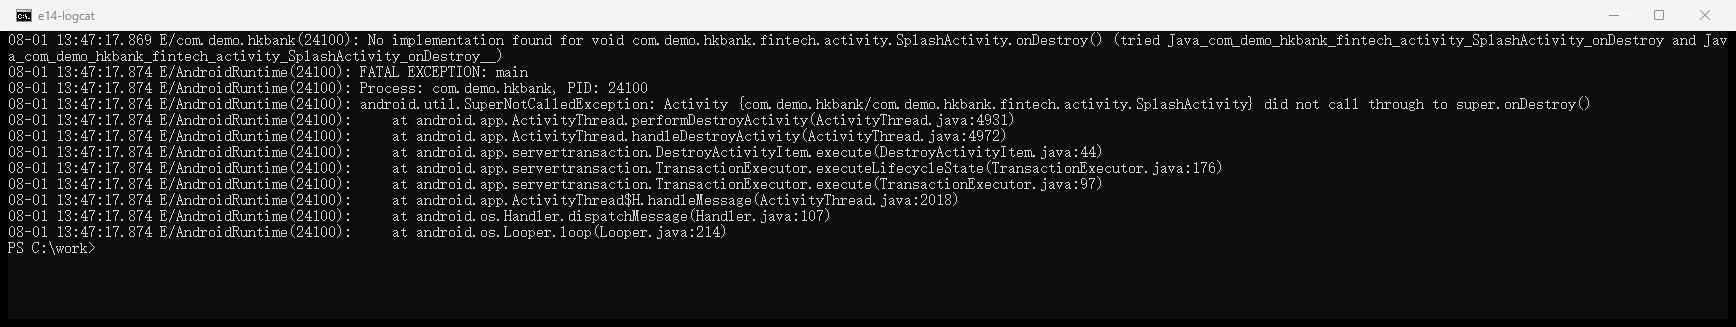
⇒ 崩因是 SplashActivity.onDestroy() 的 native 实现缺失⇒ 覆写里走不到 super.onDestroy() ⇒
SuperNotCalledException ⇒ 主进程被 kill。⇒ 改这张表影响的是「native 方法注册」,而不是「VM 指令流」。
改边界表 ⇒ SplashActivity.onDestroy() 的 native 实现缺失 ⇒ SuperNotCalledException(原始 logcat)
(b) 让"读表的人"自己暴露。把 *(core+0x00)(这张表)改成未映射地址0xdead00000
(只改一个数据字段,零代码改写),进程立刻 SIGSEGV:
fault addr 里的 0x54 = 10*8+4⇒ 崩在 ldr w10,[表 + i*8 + 4](读 len 字段,当时 i = 10)。
core+0x00 置非法地址 ⇒ SIGSEGV:fault addr 0xdead00054、pc 落在匿名解密段 +0x50810
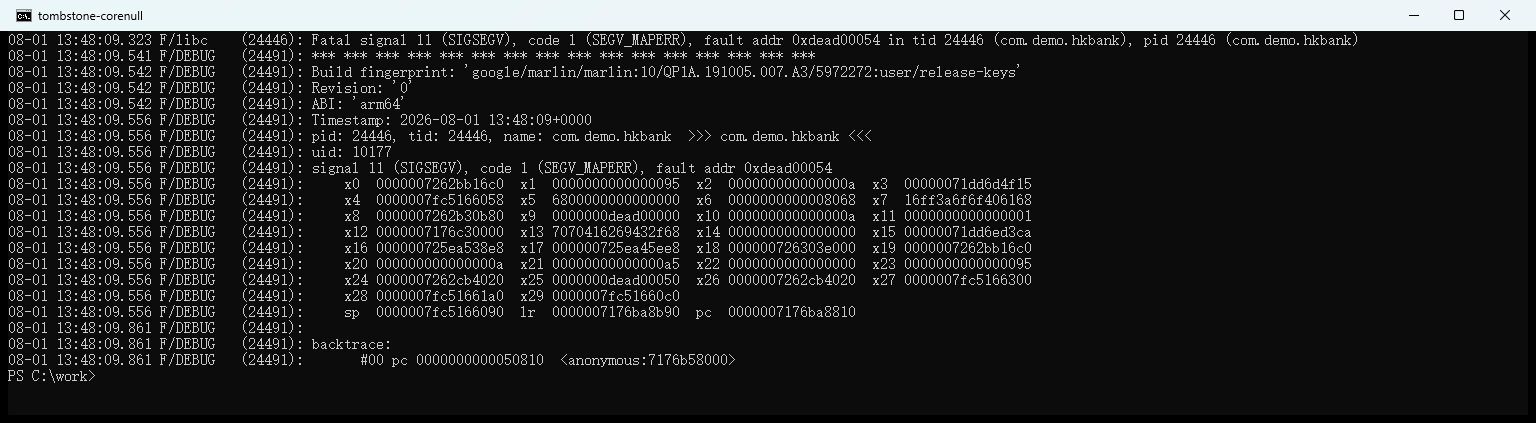
读它的那段代码就在匿名解密段 +0x507f8..+0x50864。
(c) 于是三项被完全解释:len[i] 改成 1 ⇒ 第 i 段只覆盖第一项,段内其余项被漏掉(不注册)。
锚定到索引的方法名套进来:
⇒ 这三段漏掉的恰好是 Activity 生命周期回调的 native 实现:一漏,框架调到它时就
No implementation found,覆写里走不到 super.xxx() ⇒ 崩。
而组 94 漏了 52 项却在测试路径上没人调用⇒ 稳 —— 这也顺带解释了
"为什么错位 52 B 的组反而稳、错位 2 B 的组反而崩"。
(d) 再往上追一层:遍历是「按需」的,不是「启动全量」的。遍历函数的入口是匿名解密段 +0x507c0
(入参 w2 = 段索引);全段扫它的调用点只有两个(+0x50b20 / +0x50b8c),
都在 +0x509d0 的一个循环里。hook 入口、记录每次的 w2 与调用者 lr,两次独立运行逐条一致:
这 11 段合计覆盖 31 / 553项,而且清一色是 Activity / Fragment 生命周期回调 +
dispatchTouchEvent / onKeyDown + SQLiteOpenHelper(attachBaseContext、onCreate、onStart、
onResume、onPause、onStop、onDestroy、onKeyDown、onConfigurationChanged、onDestroyView…)。
⇒ 三条互相独立的结果对上了:
途中一个坑:定位那个函数时指纹法误匹配到匿名解密段 +0x19a9c(同形序言在这个段里很常见),
改用"段基址 + 固定偏移 + 首字断言"才准 —— 在"函数序言高度同形"的段里,指纹法不可靠。
为什么只观测到 B 也算清了 —— A 是死分支。
A 之前那段混淆算术是不透明谓词(r = (w2−0x30) mod 64 → 5 连乘 → 魔数乘 → 旋转 → 与
0x19999998 比较):枚举 r 的全部 64 种取值、以及 w2 ∈ [0, 0x100000) 的 100 万个值,
没有一个能走到 A(w8 最大只到 0x13B52B0C,远小于阈值);
而 B 之前的"循环计数"恒为 0(三个连续整数之积必被 6 整除)⇒ "每段恰好遍历一次"是必然,不是采样。
(与 handler 混着 OLLVM 风格混淆链是同一路数。)
边界:+0x509d0 自己是被间接调用的,再往上没追到。
结论:{14,65,83} 的"关键"不是这张表的某种神秘属性,而是这三段的尾部恰好是生涯周期回调。
证据:本节的崩溃栈与 tombstone 现场;做法:
一个注入体把 core+0x00 置成非法值(只写数据、不改代码),让读它的代码自己崩出来。
边界:len 改 0 的情形未单独验证;匿名解密段 +0x507f8 那个函数的调用者没往上追。
VM 的状态位置是已知的
(IP = STACK[0x820]、虚拟寄存器 = STACK[0x81c]/[0x82c]、描述符槽位 = [x8,#0x20] …),
所以可以**按"碰了哪些位置 + 怎么收尾"**给 531 个 handler 分类(每个 handler 取反汇编基本块):
⇒ 头部 4 族覆盖 89.3% 的 handler / 95.1% 的表项;"531 个逐个定性"因此可以压成
"取指推进 + 虚拟寄存器算术 + 原子检查 + 绑定写入"四件套。
另外两点实测结论:
F1 族("IP 取指/推进")是最值钱的一族,那它到底怎么推进 IP?如果 VM 是变长编码,
步长就应当是那条指令的长度—— 于是有一个可离线验证的交叉断言:
"把每个 handler 里『读 IP 之后的 add/sub #k』抽出来,k 的分布应与长度表同形"。
实测(531 个 handler):读 IP 槽 [sp,#0x820] 的正好 279 个—— 访问模式算出的
F1 族 279 个完全一致(两条互相独立的口径给出同一个数);其中
⇒ 与长度表的长度谱(1B×17 > 2B×24 > 3B×12 > 4B×6 > 5B×7 …,取值 1~53)同形(都以小值为头部,
且 handler 侧的步长值是长度表长度值的子集:{1,2,3,4,5,8,9} ⊂ {1..10,13,15,20,21,25,32,33,53})。
另外发现 10 个 handler 的步长是寄存器(x9)⇒ 与"变长编码"自洽:
长度既可以是立即数,也可以是指令流里的字段。
运行时证据显示:那张表其实是
「553 项方法表」的分段索引(len[i] = 第 i 段含多少个 24 B 方法项),不是"变长指令的长度"。
因此"IP 步长分布与长度谱同形"这条交叉断言降级为巧合性观察,不能再当作语义证据;
F1 族"推进 IP"这个事实(279 个 handler 读 STACK[0x820])本身不受影响,
但"步长 = 指令长度"这个对应关系作废。
边界:这是静态语义标注 + 一次交叉对比,不是逐条 handler 的干预式验证;
要把 F1/F2 两族的运算语义都做到 ③ 档,需要给 handler 内部的输入槽造变体并做真机对拍(成本高,未做);
与它相邻的那一跳(thunk → dispatch 的索引常量)已经用同一手法验证通过。
(纯离线:把每个 handler 的 IP 步长与边界表对照。)
"每类在动哪些状态",把 F1 族的"IP 步长"落到了数。
"531 个 handler 逐个还原运算"一直被当成无底洞(handler 里混着 OLLVM 风格的位运算混淆链)。
本轮换问法:不逐条猜,而是先把"同形状"的 handler 合并,再用解释器把混淆链跑掉、只看净值。
做法(纯离线,用一个 AArch64 子集解释器跑具体值 + 扰动差分):
三条结果:
(a) 531 个 handler 只有 168 种形状,而且头部极其集中:
⇒ 头部 4 种形状就覆盖 61% 的 handler / 66% 的表项。
(b) 同形状的 handler 是"同一模板 + 不同参数":形状 1 的 95 个 handler 是同一段指令、
只有栈槽偏移不同;形状 3 更极端 —— 1 个 handler 被 134 个表项共用。
所以"531 个各不相同的 handler"更准确的说法是少数模板 × 操作数槽。
(c) 解释器把混淆链跑掉后露出净值。最有代表性的是形状 2(134 个 handler,全表最长混淆链):
解释器逐条执行 + 单变量枚举 256 次之后,输出只剩一行:
即 dst = (byte[slot] − 0x69) ^ byte[0x81c]—— sub/and/orr/eor 那 7 条全部抵消
(对 0~255 全枚举验证)。同形状的 134 个 handler 里,只有 slot 这个"操作数槽"在变。
同一手法还给出另两类:
形状 3 的静态现场:0x74767CA8AC —— 134 项表项共用的分派尾(IDA 反汇编)
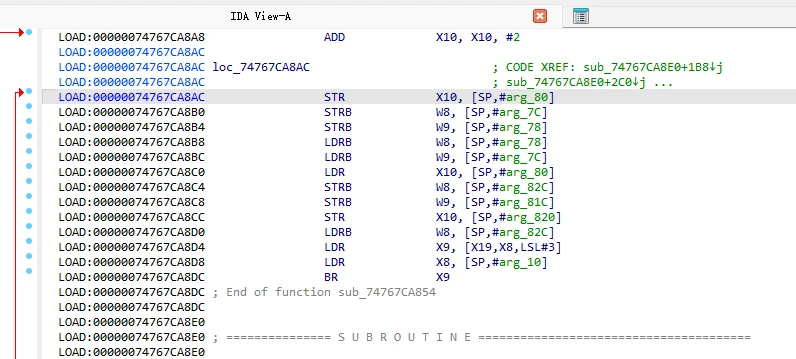
边界:
没做的原因:三个条件要同时成立 ——
① 靶子要在采集窗口内被执行:handler 是按需触发的(98 段实测只走到 11 段、覆盖 31/553 项),
上一段那次 thunk 常量干预就出现过"三次冷启动都没捕到表项 43",最后改用一个"每次运行都出现"的靶子;
② 要能定位该 handler 的共享栈帧与它的输入槽偏移:handler 之间是 br 尾调用(不建新帧)、帧还是 JIT 那一层,
而槽偏移随形状变(形状 2 用 [sp,#0x6c] + [sp,#0x81c]);
③ 还要在 br 前后各取一次值:尾调用没有返回点,只能在"下一个 handler 入口"读寄存器。
而满足这三条的代价是放弃"零代码改写"—— 要写运行期栈槽/寄存器,而壳带完整性校验(改边界表即自检失败);
再加上 handler 地址不是 16 B 对齐、相邻间距最小 4 B,入口只能靠"段基址 + 固定偏移 + 首字断言"定位。
离线一侧已给出 167/168 种形状的净值表达式,且可被反汇编独立复核 ⇒ 这一格留在"下一层"。
工具:把 531 个 handler 压成 168 种形状的四个关键函数——
下面代码里的 sim(ins, 输入) 是那个 AArch64 子集解释器的入口(寄存器 / 栈槽 / 符号访存 / 浮点四类状态,
step() 逐指令推进);完整实现 784 行,这里只摘"机制"部分:shape() / pattern_tags() 做形状指纹与结构语义标注,
discover() / match_expr() 做具体值模拟 + 扰动差分 → 真值表归约。
缺了它,本节所有净值就只能靠"我说它抵消了"。
真跑一次的输出(--json handler_tables.json --anon <解密段.bin>):168 shapes, 12 rendered, 0 unknown;
头部 4 种形状覆盖 61% 的 handler / 66% 的表项。形状 2(134 handler / 134 表项)的代表元
0x74767ca854 反汇编 15 条,解释器给出的净值是
x8 = (in + 0xffffff97 (mod 2^32)) XOR mem[0x81c],即 (mem[0x6c] − 0x69) ^ mem[0x81c]——
中间那 5 条 sub/and/orr/eor 混淆链被自动抵消,这就是本节“静态语义”的来历;
形状 3(1 个 handler / 134 表项)解出 x8 = mem[0x10] → x9 = mem[x19 + x8] → br x9,
也就是 threaded-dispatch 的“取指 → 查表 → 派发”那一跳。
分派链要闭合,需要四跳。已把第 3 跳在运行时取到:
运行时实测(描述符就是构造函数 malloc(0x40) 出来的那 0x40 字节):
⇒ 与静态结论完全对上:+0x18/+0x20 在磁盘上确实是 0,
由 libexec.so 在运行时填成"解密段里的两个跳板函数"。
两个跳板几乎逐条相同:ldp q1,q0,[x3] → stp q1,q0,[sp] → bl #…124C ——
即把第 3 个参数指向的 32 字节搬到栈上,再转发给同一个 dispatch 主体(段内 +0x5224C)。
dispatch 主体里就是描述的那个同构分派模板:
而那张表(libexec.so 的 rw-p 段 +0xAED0)里的值,静态看是一串无意义的数:
⇒ 表项 = 目标地址 − 常量 0x430E51A3。这就是"静态接不上"的直接原因:
它不是"值为 0 的表",而是一张被常量混淆过的表—— 不知道那个常量,就还原不出目标。
一条跨运行稳定性结论:本次运行时 dump 的匿名段(712,704 B)与既有
两次运行 dump 出的解密段前 581,632 字节逐字节一致⇒ 解密段内容跨运行稳定(ASLR 只改地址、
不改内容),因此可以把运行时地址换算成段内偏移,在已有的离线 dump 上做静态分析。
再往下追一层:dispatch 主体调用的 0x74767A53E8(段内 +0x563E8)已反汇编 —— 它做的是
为一段 VM 程序分配"解码表":
⇒ 到这里,"索引 → 结构体 → 解码表 → 分派"的骨架已经贯通。
**最后一块拼图:core+0x08 那张 553 项表。**它在 libexecmain 的 rw-p 段偏移 8,实测:
thunk 前半是变参序言(保存 x0–x7/q0–q7 到栈 + 栈 canary,就是 va_start 的实现),
尾部唯一差异就是传给 dispatch 的索引:
⇒ 五跳链条(注意定性:其中第 2 跳是静态推断,且已被本节的干预实验证伪;第 3 跳由本次实验直接证实"确实被调用";其余各跳仍是静态推断 + 一致性证据):
⏳→✅ "运行时走哪条"这一格也已补上(② 档):不追 br x8 的 handler 目标,而是记录分派索引本身——
把描述符里的一个数据指针*(core+0x20) 换成一段汇编 trampoline(不动任何指令、不做 mprotect),
trampoline 记下 x1 / lr / x2 / x8 后 br 回原跳板,语义等价。真机(Pixel XL,Android 10)跑出 30 条记录:
⇒ 30/30 逐位一致,"模型预测 == 真机记录"成立,壳 B 的验证强度由此进入 ② 档。
两处副产物值得单独记:
③ 档干预实验:改了那张"分派表",行为却没变 —— 预测未命中
前两档都是"看起来一致",这一档用干预去戳它:把 core+0x08 指向的 553 项表的某一项改成另一项的值
(只写 8 字节数据):表项[399] ← 表项[43](即让"索引 399"指向 thunk_43)。
⇒ 结论(如实记录):"553 项表[i] = thunk_i"这一跳在运行时并未被 dispatch 读取——
它"看起来完全像分派表"(553/553 落 r-xp、间距规整),
但改它并不能改变行为。`机制只做到"记录现象",机制留了三种可能待验
(① 初始化时被消费;② 运行期另有一份副本;③ thunk 地址另有来源)。
机制:答案是 ①+② 的组合——
那张 553 项表是注册期"编号 → thunk 地址"的来源,壳在注册时把地址写进 ArtMethod->data_;
运行期分派读的是 ArtMethod->data_(也就是那份"副本"),不再读表。三条独立证据:
① ArtMethod->data_ = thunk_252 的运行时地址(实测:+0x18 = 0x78f3b99fdc);
② 直接改 ArtMethod->data_ ⇒ 分派一次即崩、对照存活(③ 档,本节末);
③ 206 个 native 方法的 fnPtr 与 553 项表直接对位 62 项⇒ 表项 == 注册进 data_ 的值。
——所以"第 2 跳降级为静态推断"要准确理解:它不是错的,只是只在注册期成立。
把上面这套机制从"事后解释"升级为"事前预测并命中"。** 改表是**注入到"已完全启动"的进程**(复现步骤原话「需先完全启动再 attach」)⇒ 表早被消费掉了, 所以"改它无效"并不奇怪。新一轮改用**注入体 + 启动即注入**(pid 一出现立刻注入), 并内置**时机判据**:同时抢装 RegisterNativeshook —— 只要记到注册调用,就证明我们确实在注册之前动手。 实测 **改表t=+41ms、首次注册 t=+727ms`(差 686 ms)✓。
⇒ 对照 9/9都能记录到"索引 43"的分派,而注册前把它毒化后这个分派 3/3 不再出现——
唯一自洽的解释:壳在注册期读那张表、把值写进方法的 ArtMethod->data_,运行期调用它时用的是被写坏的入口。
⇒ 三种可能全部判定:
① 该表在初始化(注册)期被消费✅ 证实(注册前改 ⇒ 行为按预测改变;注册后改 ⇒ 无效);
② 运行期另有一份副本✅ 证实(副本就是 ArtMethod->data_);
③ thunk 地址另有来源❌ 证伪(表项 == 注册进 data_ 的值,62 项对位)。
两条"如实记录的坑":(a)改一个"在本窗口内不被调用的索引"(如 399/252)是测不出差异的
—— 这也解释了最早那两次"毒化表项"实验(索引 43 / 399)为什么看着"毫无影响"(触发流程里观测到的分派几乎只有索引 43);
(b)x1 是 thunk 内嵌常量,"改走另一个 thunk"与"本来就调到那个 thunk"的 (x1, lr) 完全一样
⇒ 判据必须用毒化这种二值形式(或比对 ArtMethod 本体)。
这正是 ③ 档的价值:干预能暴露静态推断的漏洞。本节链条里标"实测"的第 2 跳因此降级为"静态推断"。
查到 thunk 的真实入口,并把 ③ 档做成了
⇒ 篡改 2/2 崩、对照 2/2 不崩;篡改版记录里出现 x1=0xdeadbeef作为旁证。
壳 B 的验证强度由此推到 ③ 档(分派层子模型)。
再深一层:把机制钉死
既然 thunk_i 是被 JIT 代码调用的,那就顺着 JIT 代码往上读:
⇒ 整条链闭合:Java 方法 → JIT 代码 → bl ART helper(读 ArtMethod 的 data_)→ blr → thunk_i → blr *(core+0x20) → dispatch。
thunk_i 就是"某个 Java native 方法的实现指针";而那张 553 项表 + getOpCode 是注册期用的
⇒ 运行期不经表,这正是"改表无效"的原因。
③ 档判据升级:从"崩不崩"到"这个寄存器等不等于这个数"
前面那条 ③ 档是二值的(篡改索引 ⇒ 预测崩 ⇒ 实测崩)。本轮把判据做成数值级:
其余 8 个被观察到的表项(256/258/399/401/156/44/301/42/158)逐条不变。⇒ 三点结论:
① 执行期确实走「表项 → thunk → 内嵌常量」这条链 —— 这正是"改 553 项表无效"留下的疑问的答案:
表只在注册期被消费,thunk 才是执行期真正被调用的那一段;
② 内嵌常量就是本次调用的表项号(静态 0x100<<16|257 与真机逐位相等,改一个字节即刻改变实测值);
③ 只有被改动的那一格变化—— 靶子与对照在同一进程、同一次运行内完成。
口径:本条是代码级干预(patch 一条指令 + mprotect)。
选型(如实记录):先试表项 43,三次冷启动都没捕到它的分派(只在启动早期某一步出现)⇒ 改用每次必现的 257;
也只改高位—— 因为改低位有陷阱:43 的 0x100002b 改成 0x100002c 会与表项 44的常量撞车,产生"假命中"。
lr_off 两次运行完全一致(+0x10404),路径可复现。
由机制直接导出的更根本干预(第三步 ③ 档):直接改 ArtMethod->data_(注入体里用一个编译开关 -DTAMPER_DATA 打开这条路)。
⇒ 预测"下次调用该方法即崩"命中;相比"改索引",这一版干预的是方法绑定本身,是分派层上更根部的干预。
顺带读到的一条"运行时数据链"(属下面的 ① 档证据,不是 ② 档):
libexec.so 的 r--p + 0x5AB0 → 本 so rw-p + 0x1220 → …… → 堆上([anon:libc_malloc])一张
24 字节/项的结构体表,项形如 {ptr, ptr, u64}。
两点值得记:① 历史 dump 与本次运行的段内偏移一致(都是 +0x1220)⇒ 该结构跨运行稳定;
② dispatch 里 umaddl x1, w20, #0x18, x8 的 x8 正是这张表的基址 —— 也就是说
"索引 × 24 结构体"这一环也在运行时读到了实际值。
补充(把这条链与"VM 程序"分开):壳自己的 "VM 程序"另有其物——
描述符 +0x00 的表给出了 98 段 / 总长 553的分段索引(静态可得;**语义由 边界表**: 它索引的是「553 项 × 24 B 的方法表」,不是"指令流"); 而这里追到的 **24 字节/项结构体表**是 **ART 侧的方法解析结果**(由 JNIEnv→[p1+0x2F8]→ 堆 →[p2+0x28]一路取到), 两者的数据源、生命周期、用途都不同:**一个属于壳(自己写死),一个属于运行时(ART 填)**。 ⇒ 不再把"表项记录里的(N, count)"往"VM 程序"上靠;**两者的接合点已取到**(thunk` 编号 ↔ Java 方法名)。
机制结论是"thunk_i = 某个 Java native 方法的实现指针,注册期绑上去的"。那就在注册发生的那一刻把三件套抓下来
(name / signature / fnPtr)——RegisterNatives 正是 JNIEnv 函数表的第 215项,只换这一个函数指针(仍是零代码改写):
时机是关键:注册集中在 App 冷启动的头一两秒(注入早了没进程、晚了注册已结束),所以用"启动即注入"——
am force-stop → am start → 轮询 pidof,进程一出现立刻注入
另外两条踩过的坑:① 注入源 so 必须放在 App 的 lib/arm64/(放 /data/local/tmp 会被 SELinux 挡住、进程直接死);
② 早期没有 libnativehelper.so 时 JNI_GetCreatedJavaVMs 拿不到,故 so 里备了一条扫表兜底(在 libart 的只读段里找
"连续 200+ 个指向 libart 代码段的指针、且前 4 项为 0"的数组,即 JNINativeInterface)。
抓到的结果:
这 62 个对位长这样:
⇒ 三条结论:
复现:注入体→ 推到 App lib/arm64/ → ptrace_inject64 <pid> <so>(启动即注入)
→ od -j <libexecmain_base+0x28008> -N 4424 /proc/<pid>/mem 读表 → 求交集。
第二次独立运行—— 结论是"可复现",不是"能做大":
两点值得单独记下:
两个壳的 VMP 分派结构对比
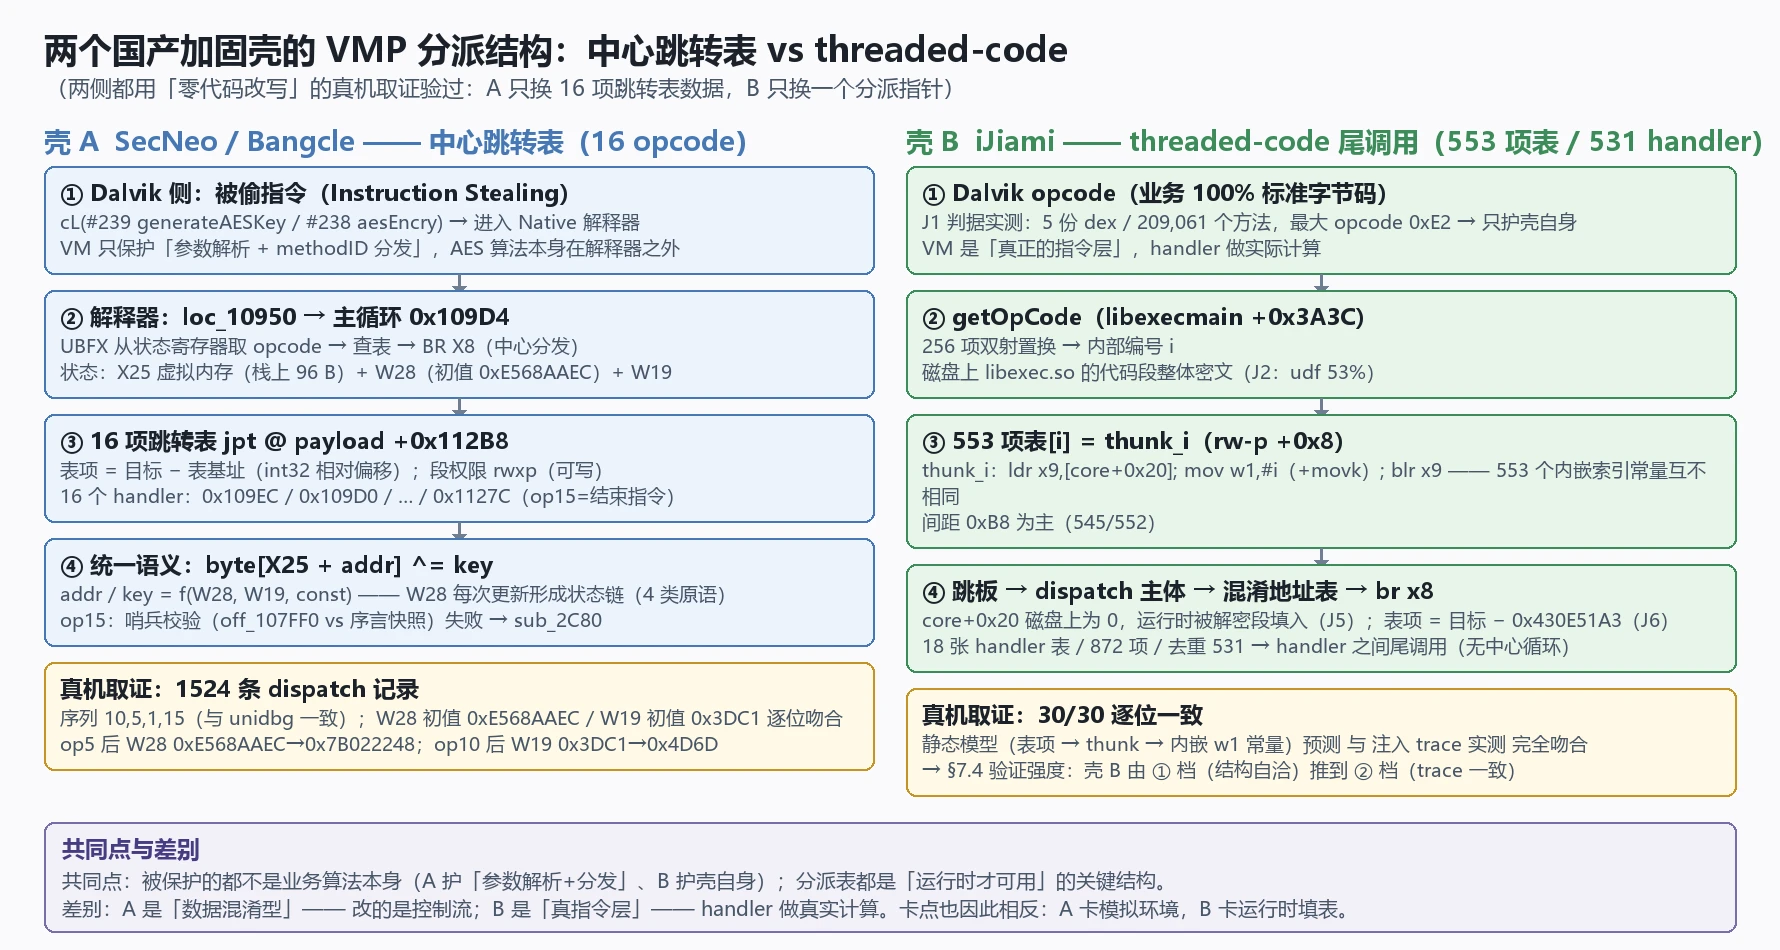
表 4.1b:两个 VM 的指令集对照
归因边界(重要):A 与 B 之间同时变了四件事—— 厂商、样本、Android 版本、VM 设计,
没有做变量控制。所以上表只能读作"观测到的三个差异",不能读成
"用中心表的设计就一定只护自身"这类规律 —— 反例完全可能:一个用中心跳转表、却把业务方法也 VM 化的壳。
要谈因果,得在同厂商的不同样本或同一样本的不同版本上分别复测。
做法:把"能静态确定的东西"全部挖出来 —— 置换表、描述符、跳板、handler 表、代码画像。
优点:不需要设备、不需要跑起来,结果可复现、可交叉验证(B 的两份表都有脚本能逐字节重现)。
边界:只能到"结构 + 分派面"。凡是运行时填的表、运行时生成的指针,静态一律拿不到(B 的第 3 跳)。
适用判据:只要目标壳的 VM 是"表驱动 + 代码可 dump",静态就能吃下结构层。
做法:在 unidbg 里把 loader/VM 真跑一遍,用符号执行模拟器复现 opcode 行为,再与真实 trace 对拍。
优点:能直接得到执行语义(A 拿到的 16 opcode 语义表 + 状态链 + 模拟器);
验证力强 —— "真实路径对拍"比任何静态推断都硬。
边界:
受模拟环境限制。A 的 #238 就是被 unidbg 的指针/上下文传递问题挡住;
而且模拟跑通 ≠ 真机跑通——这次真机 trace 还顺带查出模拟器的状态更新与真机不一致。
适用判据:VM 规模小(十几条 opcode)、状态可符号化(A 的 W28 只有 4 类原语)、
且有稳定的动态入口。
#238 在 unidbg 里崩于 opcode 10,破解方向:
core+0x18/+0x20 由解密段在运行时写入。本次走的是第 2 条路(读内存),步骤:
踩到的坑(值得记下):设备 shell 是 32 位算术—— 0x797a404000 + 0x29460 会被截断成
0x7a42d460,第一次读出来全是 0。64 位地址必须在 PC 上算好再传。
拿到这张表之后,下一步是与已挖出的 531 个 handler求交集:
大量表项是同一函数的复用,真正"被用到"的 handler 集合通常远小于 531。
压成 6 条判据。每条都给出检验方式、"通过/不通过各长什么样"与实测值;
并单独列出已知的适用边界与反例—— 判据的边界,本身就是结论的一部分。
这 6 条的定位:它们是**"我们在两个样本上真正用到的判断点",
不声称穷尽 VMP 的判断维度 —— 换个样本很可能合并成 4 条、也可能拆出 8 条。
把它们写成"可否证的命题"而不是"规律",就是为了让后来者用第三、第四个样本去改它
可执行版本:附带的判据脚本 —— 把下面那张"输入 / 工具 / 输出 / 阈值"表做成一条能跑的命令,
喂 so/dex 就打印六条判据的判定与中间量;缺输入的一律标 NOT-EVALUABLE,不猜
(两壳实测:J2 34,803 / 65,536、J3 br = 2 / blr = 0(只统计该判据输入的那一段,与"整个解密段 811 处"不是同一口径)、J4 18 张 / 872 项,与正文逐项一致)。
判据速查表(输入 → 工具 → 输出 → 阈值)—— 上表是"命题与实测",这张表是"照着跑要准备什么":
说明:表中"阈值"一列里,只有 J2 是区间型(可解码率高低),其余都是二值 + 一个可复算的数字;
这样设计是为了让负面结果也能被复核(例如 J4 的"0 命中"必须连同"采集范围"一起记录)。
① J4 的反例:第三样本 8 个 r--p 段全部 0 命中。
这不能推出"它不是表驱动 VM",因为"0 命中"至少有三种竞争解释:
⇒ 方法学结论:负面判据必须先排除"采集不完整"这个竞争解释。
对这个样本,只能说"未观察到",不能说"不存在"。
② J1 的边界:它的"保留区"判据只对在 Dalvik 字节码层做 VM 化的壳有效。
若壳在 native 层做指令替换(两壳都不是),J1 会给出"只护壳自身"的假阴性。
③ J6 的边界:找出混淆常量,依赖"还原后的目标必须落在某个已知段内"这一收敛条件。
若混淆是多级的(例如目标还要再解一次),该条件不成立,只能反过来用动态读表。
④ J3 的边界:两壳恰好在两个极端(纯中心表 / 纯尾调用);
现实中很可能存在混合体(外层中心表 + 内层尾调用)。混淆写轮把这一格从"悬而未决"变成了"可测判据"
J3′:分派层数的判定
辅助判据 ①(定"哪层是外层"):看表所在段的权限——
只读段(代码段内)的表 = 编译器生成的 case 表 ⇒ 外层(opcode 级);
运行时可写段 / 匿名段的表 = 壳自建 ⇒ 内层(VM 指令级)。
两壳正好落在两侧:壳 A 的 16 项表是编译期常量(与解释器同段、从不被改写),
壳 B 的 18 张 handler 表在 libexec.so 的 r--p 段(静态可读);运行时才填的是分派入口(描述符 +0x18/+0x20)。
辅助判据 ②:把所有 handler 结尾的 b <addr> 的目标地址做直方图——
单级分派下只会出现一个入度 ≈ 全部 handler 的地址(实测:壳 A 0x109d4、壳 B 0x74767ca8ac);
混合体下会出现两个高入度地址(外层分派器 + 内层分派器),且它们引用的表分处"只读 / 可写"两段。
做了什么:拿第三个样本(7 组段 dump)按 J4 的"检验方式"直接跑了一遍 ——
扫它的 8 个 r--p 段,找"连续指向同批 dump 代码段的 8 字节指针"。
结果:8 个 r--p 段全部 0 命中;它的 rw-p 段里有 2,431 个指向代码段的重定位,
但那是正常的 ELF 重定位(同段内、间距不规则),不是"handler 表"。
这次"未命中"该怎么记:
⇒ 结论:这次外推只得到一个"未观察到",不足以判定 J4 的边界。
要让 J4 真伪可判,能同时给出"磁盘段 + 进程内存"两套数据。
按验证强度自我定位:
两个壳都没做到的事:
方法上的两处已知边界:J4 的负面结果受"采集完整性"干扰(只能记"未观察到");J3 的"混合分派形态"已有可测判据(J3′:自带分派式跳转的 handler 占比 ≤2% ⇒ 单级、≥10% ⇒ 两级,辅以"表所在段的权限"与"回边入度直方图";两壳实测 0% 与 0.19%,都判为单级)。
两条可复用的做法:① 不依赖 linker 的手工符号解析(dl_iterate_phdr → PT_DYNAMIC → DT_GNU_HASH → 扫 .dynsym)—— 两个坑:d_ptr 要做一次"在不在本段内"的绝对/相对修正(否则 SIGSEGV @0x270)、符号数必须用 GNU_HASH 的标准算法算,不能用 (strtab-symtab)/24 估;② JNI 函数表的定位走 JNI_GetCreatedJavaVMs → env → *env,且槽号就是数组下标。
(1)三句话
(2)四条方法论
壳 A:VM 能跑,但"跑不全" → 卡在环境
壳 B:VM 看得见,但"接不上" → 卡在数据
open("/system/lib64/libdexjni01.so")
 → pread(key, offset=0x2E1E60, 20 B) ← 16 字节 RC4 key 的存放位置
 → 分块 RC4 解密(sub_1184,每块 ≤0x40 字节)
 → 自定义 linker:解析 DYNAMIC / 重定位 GOT(sub_13F8)
 → 调用 JNI_OnLoad(sub_CD0 用哈希查符号表)
[LOAD] rx off=0x0 vaddr=0x0 fsz=0x81B00 ← 531 KB 代码
[LOAD] rw off=0x83D38 vaddr=0x87D38 fsz=0x259B4C ← 2.4 MB 数据
entry 0x2D80 · 镜像 0x2E2818
序言
ADRL X9, xmmword_7D492 ; 加密字节码流(虚拟内存初始内容)
MOV W28, #0xE568AAEC ; 状态寄存器初值
ADRL X27, jpt_109E8 ; 主跳转表基址
STUR Q0, [X25,#0x1C] ; 装配虚拟内存 X25

主循环(0x109D4~0x109E8)
UBFX X9, X8, #0, #0x20 ; 取 opcode
CMP W8, #0xF ; 16 个 case
B.HI def_109E8 ; >15 → default
LDRSW X8, [X27, X9, LSL#2] ; 跳转表查表(相对偏移)
ADD X8, X8, X27 ; → 绝对地址
BR X8 ; 分发
X25[(W28 + 0x8A0A8765) + 0x13] ^= (mem[(W28+0x8A0A8765)+0x13] ^ (W28 + 0x8F))
X25[(W28 ^ 0x75F57882)] ^= (mem[W28^0x75F57882] ^ (W28 + 0xC1))
X25[(W28 + 0x8A0A8765) + 0x18] ^= ((W28 ^ mem[(W28+0x8A0A8765)+0x18]) ^ 0xEA)
X25[(W28 + 0x8A0A8765) + 0x08] ^= ((W28 ^ mem[(W28+0x8A0A8765)+0x08]) ^ 0xCF)
X25[(W28 + 0x8A0A8765)] ^= (mem[W28+0x8A0A8765] ^ (W28 + 0xA1))
X25[(W28 ^ (0x75F57882+0x2B))] ^= ((W28 ^ mem[W28^(0x75F57882+0x2B)]) ^ 0xF0)
W28 ← W28 + 0x5112151D ; 状态链推进
入口: X21 = X0(JNIEnv/对象), [SP,#0x18] = X1(参数数组)
10dc8: LDR X8, [X21] ; LDR X8, [X8,#0x558] ; → CallStaticObjectMethodV 槽位
10ddc: BLR X8 ; 第 1 次 JNI 调用
10de8: SUB W23, W0, #1 ; W23 = 返回值−1 = 方法索引
10df8: BLR X8 ; 第 2 次 JNI 调用(CallObjectMethod 槽位 0x568)
10e10: BL sub_11328 ; JNI 调用包装(压栈 + 哨兵校验 + 间接调用)
10e14: BL loc_12BD4 ; ★ methodID 解析:LDR X0,[表, W0*8]
10e18: MOV X24, X0 ; → X24 = VM 寄存器文件基址
10e20: B def_10E64 ; 内嵌二级分发(12 case,W19 混淆算术算目标)
idx9(按返回类型把 X24 的 8 个字段搬进 VM 寄存器文件)
→ idx0 W19 ← 0x176b;w22 ← 0
→ idx6 w8 = ((W19 * 0xC438) >> 0x17) * (-0xA7) + W19 ;W19 ← 0x4e03 - w8
(若 w22 < w23:→ idx2 再调一次 JNI,W19←0x7827 → idx3(w22 += 1)→ 回到 idx6)
→ idx4 收尾,**不写 W19**(只算 w9 = 0x6b*w20 + 0x25 - W19)
→ idx11 回主循环;循环头 `mov w8,#5` ⇒ **next opcode = 5**(正是真机序列 `10→5→1→15`)
opcode 10 入口要求 X21 = JNIEnv、[SP,#0x18] = 参数数组,
但崩时 X21 = 0xe4ffefc9、SP = 0xe4fff700 —— 均为野指针。
__int64 sub_4AD0(__int64 a1, __int64 a2, ...) { // 第 0 个跳板
 va_start(va, a2);
 v2 = *(__int64 (**)(...))(core + 0x20); // 描述符 +0x20(运行时由外部填)
 va_copy(va1, va);
 return v2(a1, 0, a2, va1); // ← 只把索引 0 透传
}
// 下一个:return v2(a1, 1, a2, va1); …… 一直到 552
// handler 模板(表项 0x74767CA8AC)
v23 = STACK[0x820] + 2; // 推进 VM 的 IP(+2)
v25 = STACK[0x81C] ^ ((104 - BYTE4(a22)) & 0x5F | (BYTE4(a22) - 105) & 0xA0) ^ 0x5F; // 混淆 XOR 取操作数
LOBYTE(STACK[0x82C]) = v25; // 写进「栈上的虚拟寄存器」
LOBYTE(STACK[0x81C]) = v25;
STACK[0x820] = v23;
return (*(fn **)(x22 + 8 * LOBYTE(STACK[0x82C])))(a1, ..., a17); // ★ 尾调用下一个 handler
ldr w10, [表 + i*8 + 4] ; len = 表[i].len
cmp w10, #1 ; b.lt ; len < 1 ⇒ 整段跳过
ldr w9, [表 + i*8] ; off = 表[i].off
ldr x8, [core+0x08] ; ⇒ 553 项 × 24 B 的方法表
smaddl x24, w10, #0x18, x8 ; 方法表基址 + off*24
FATAL EXCEPTION: main
java.lang.RuntimeException: Unable to create application com.demo.fintech.demoApp:
 com.demo.fintech.encrypt.demoSMExecption: 完整性校验-签名校验失败
 at com.demo.fintech.encrypt.demoSMTools.init(demoSMTools.java:4)
 at com.demo.mobile.kits.support.n.y(Support.kt:4)
 at com.demo.fintech.cmk.e.l(CMKManager.kt:9)
 at com.demo.fintech.demoApp.onCreate(demoApp.java:5)
idx14 #1 : PID_before=18130 PID_after_seq=[18130 18130 18130 18130 EMPTY EMPTY] ← 触发后第 4~5 秒死
idx12 #1 : PID_before=20437 PID_after_seq=[20437 20437 20437 20437 20437 20437] ← 一直活着
E/com.demo.hkdemom: No implementation found for void com.demo.fintech.activity.SplashActivity.onDestroy()
 (tried Java_com_demo_fintech_activity_SplashActivity_onDestroy and Java_...)
E/AndroidRuntime: FATAL EXCEPTION: main
E/AndroidRuntime: android.util.SuperNotCalledException:
 Activity {com.demo.hkdemomb/...SplashActivity} did not call through to super.onDestroy()
Zygote: Process ... exited due to signal 9 (Killed)
signal 11 (SIGSEGV), code 1 (SEGV_MAPERR), fault addr 0xdead00054
 x9 0000000dead00000 ; 正是写进去的非法值
 pc 0000007176ba8810 → 匿名解密段+0x50810
idx = 0xa 0x55 0x56 0x41 0xe 0x47 0x53 0x25 0xd 0x2a 0x2c (只有 11 段,不是 98)
lr = 匿名解密段+0x50b90(调用点 B 的下一条,11/11 完全相同)
ldrb w8,[sp,#0x6c] ; 输入 x
mov w10,#0x68
ldrb w13,[sp,#0x81c] ; 输入 v(另一个槽)
mov w11,#0x5f
mov w12,#-0x60
sub w8,w8,#0x69 ; ┐
sub w9,w10,w9 ; │ 四条位运算
and w9,w9,w11 ; │ 混淆链
and w8,w8,w12 ; │
orr w8,w9,w8 ; ┘
eor w8,w13,w8
eor w8,w8,w11
x8 = (mem[0x6c] + 0xffffff97 (mod 2^32)) XOR mem[0x81c]
x9 = 同 x8
# ① 形状去重:把反汇编归一化成"骨架",同骨架 ⇒ 同一模板(531 个 handler ⇒ 168 种形状)
import re

def shape(ins):
    out = []
    for i in ins:
        ops = re.sub(r"\b[wx]\d+\b", "R", i.op_str)                       # 寄存器归一
        ops = re.sub(r"#-?0x[0-9a-f]+|#\d+", "#I", ops)                   # 立即数归一
        ops = re.sub(r"\b(eq|ne|cs|cc|hi|ls|ge|lt|gt|le)\b", "CC", ops)   # 条件码归一
        out.append(i.mnemonic + " " + ops.rstrip(","))
    return " ".join(out)

def pattern_tags(ins):
    js = " ".join("%s %s" % (i.mnemonic, i.op_str) for i in ins)
    tags = []
    if "[sp, #0x820]" in js:
        tags.append("读 IP 槽 mem[0x820]")
    for m in re.finditer(r"add\s+x(\d+),\s*x\1,\s*#(\d+)", js):           # IP 推进
        if re.search(r"ldr\s+x%s,\s*[sp, #0x820]" % m.group(1), js):
            tags.append("IP += %s" % m.group(2))
    vs = sorted(set(re.findall(r"strb?\s+w\d+,\s*[sp, #(0x8[0-9a-f]c)]", js)))
    if vs:
        tags.append("写虚拟寄存器槽 " + ",".join(vs))
    m = re.search(r"ldr\s+x(\d+),\s*[x(\d+),\s*x(\d+),\s*lsl #(\d+)]", js)
    if m:
        tags.append("查表 next = x%s[x%s << %s]" % m.group(2, 3, 4))
    tags.append({"br": "尾调用(间接 br)", "b": "尾调用(直接 b)",
                 "ret": "返回 ret"}.get(ins[-1].mnemonic, "子调用 " + ins[-1].mnemonic))
    return tags
# ② 语义还原:具体值模拟 + 扰动差分(那一层 and/orr/eor 混淆链在这一步被自动抵消)
def discover(ins, sim):
    base = sim(ins, {})
    dep = {}
    for inp in base.inputs:                   # ① 逐个扰动:置 0xA5,看谁跟着变
        s1 = sim(ins, {inp: 0xA5})
        for key in base.outputs:
            if base.get(key) != s1.get(key):
                dep.setdefault(key, set()).add(inp)
    out = {}
    for key, d in dep.items():
        if len(d) == 1:                       # ② 单输入 ⇒ 枚举 256 次,拿真值表
            inp = next(iter(d))
            out[key] = [sim(ins, {inp: v}).get(key) for v in range(256)]
        else:                                 # ③ 多输入 ⇒ 先做 XOR 可分离性检验
            out[key] = ("multi", sorted(d))
    return out

def match_expr(tbl):
    b = tbl[0]
    if all(((v + b) & 0xFFFFFFFF) == t for v, t in zip(range(256), tbl)):
        return "in + %#x (mod 2^32)" % b
    if all(((v ^ b) & 0xFFFFFFFF) == t for v, t in zip(range(256), tbl)):
        return "in ^ %#x" % b
    if all(((~v) & 0xFFFFFFFF) == t for v, t in zip(range(256), tbl)):
        return "~in"
    return None
and w20, w1, #0xffffff ; 取索引(低 24 位)
umaddl x1, w20, #0x18, x8 ; 索引 × 24 → 某项结构体
bl #0x74767A53E8
adrp x20,#0x7476813000 ; add x20,x20,#0xED0 ; ★ 表基址 = rw-p + 0xAED0
cinc w8, w9(=2), ne
ldr x8, [x20, w8, uxtw #3] ; ★ 查表
mov w9,#0x51A3 ; movk w9,#0x430E,lsl#16 ; 常量 0x430E51A3
add x8, x8, x9 ; ★ 表项 + 常量 = 目标
br x8 ; ★ 分派
malloc(0x80) ; VM 上下文项(+0x68 处保存了「描述符 +0x20」的值)
ldrh w8, [x24] → N ; 从 16 位头读"数量"
malloc(N*8) → +0x08 ; 8 字节/项的表
malloc(N*4) → +0x10 ; 4 字节/项的表
ldr w8, [x8(=+0x10 表), w23, sxtw #2] ; 按索引查 u32 表
; thunk[i](表项[i] 指向;0x4AD0 起,间距 0xB4 / 0xB8 两种)
adrp x10,#0x27000 ; ldr x10,[x10,#0xff8] ; ldr x10,[x10] ; → core(描述符)
ldr x9, [x10, #0x20] ; x9 = *(core+0x20) = dispatch(运行时填入)
mov w1, #i ; ★ 只有这条随 i 变(thunk[0]: mov w1,wzr;thunk[1]: mov w1,#1)
blr x9 ; dispatch(a1, i, a2, va)
Dalvik opcode
 → getOpCode(opcode) = 内部编号 i [libexecmain +0x3A3C,256 项置换表]
 → 553 项表[i] = thunk_i [libexecmain rw-p +0x8,间距 0xB8 为主] ⚠️ 静态推断;**干预改它无效**
 → thunk_i: ldr x9,[core+0x20]; mov w1,#i; blr x9 ✅ 实测:tramp 挂 `core+0x20` 后能记录到 x1=thunk 内嵌常量
 → core+0x20 = 跳板 [libexec.so 匿名段 +0x504F4]
 → 跳板转发 → dispatch 主体 [匿名段 +0x5224C]
 → dispatch 查表(rw-p +0xAED0,表项 = 目标 − 0x430E51A3)→ br → handler 分支