由于业务需求,最近需要熟悉一些端技术,把日常的一些分析学习用文章记录一下。
对普通用户来说,手机是用来聊天、购物和支付的终端;对黑产来说,一部手机首先是一台可以被批量控制、重复执行任务并伪装运行环境的计算设备。
正常 Android 会把不同 App 隔离开:每个应用有自己的身份和数据目录,不能随意读取其他应用、修改系统文件或干预别的进程。这样的边界保护用户,也妨碍黑产把手机改造成自动化工具。Root 的价值,就在于突破其中一部分边界,为后续工具提供更强的设备控制基础。
黑产的目标通常不是“看到 UID 0”这个技术结果,而是完成某种业务动作:批量养号、自动操作、薅取活动权益、干预广告或游戏逻辑、修改客户端看到的环境,或者长期控制一批设备。
在没有 Root 的手机上,普通 App 被限制在自己的沙箱中。它可以使用系统公开的接口,却很难稳定完成下面这些事情:
需要强调的是,**Root 并不会自动完成这些行为。**它更像取得了总机房的通行证:真正的自动化、注入、数据处理和环境改造,还需要脚本、模块、Hook 框架、设备控制程序等工具配合。TEE、安全芯片、服务端校验和其他硬件边界,也不会因为 Android 取得 Root 就当然失效。
从一项黑产业务目标到设备动作,中间通常是这样一条链:
这解释了黑产为什么追求 Root,也解释了为什么“手机已 Root”和“某个 App 正在作恶”不能直接画等号。Root 是能力底座;谁获得授权、具体执行什么命令、加载了什么扩展,才决定这项能力如何被使用。
打开 Root 管理器,给某个 App 点一下“允许”,看起来只是打开一个开关。手机内部却需要先完成一套完整改造:Root 工具进入启动链,在 Android 安全环境定型前安放组件;手机开机后,它识别请求来自哪个 App,为获准进程准备身份、能力和安全域,最后再把命令交给用户态 shell 执行。
https://bbs.kanxue.com/forum-45.htm
Magisk、KernelSU 和 APatch 都完成了这件事,却把控制点放在不同位置:Magisk 主要改造启动早期和用户态环境;KernelSU 把请求识别与权限准备放进内核;APatch 借助 KernelPatch 定位并修补现成内核,在其中建立可持续扩展的处理能力。
要看懂这些改造,先要认识一部没有 Root 的 Android 手机原本怎样启动和运行 App。
下面这张图把 Android 画成一座手机形状的工厂。上层是用户态,运行系统服务和 App;下层是内核态,负责进程、内存、文件、驱动和底层安全检查。图中的上下楼层是软件分层,不是两块真实硬件。
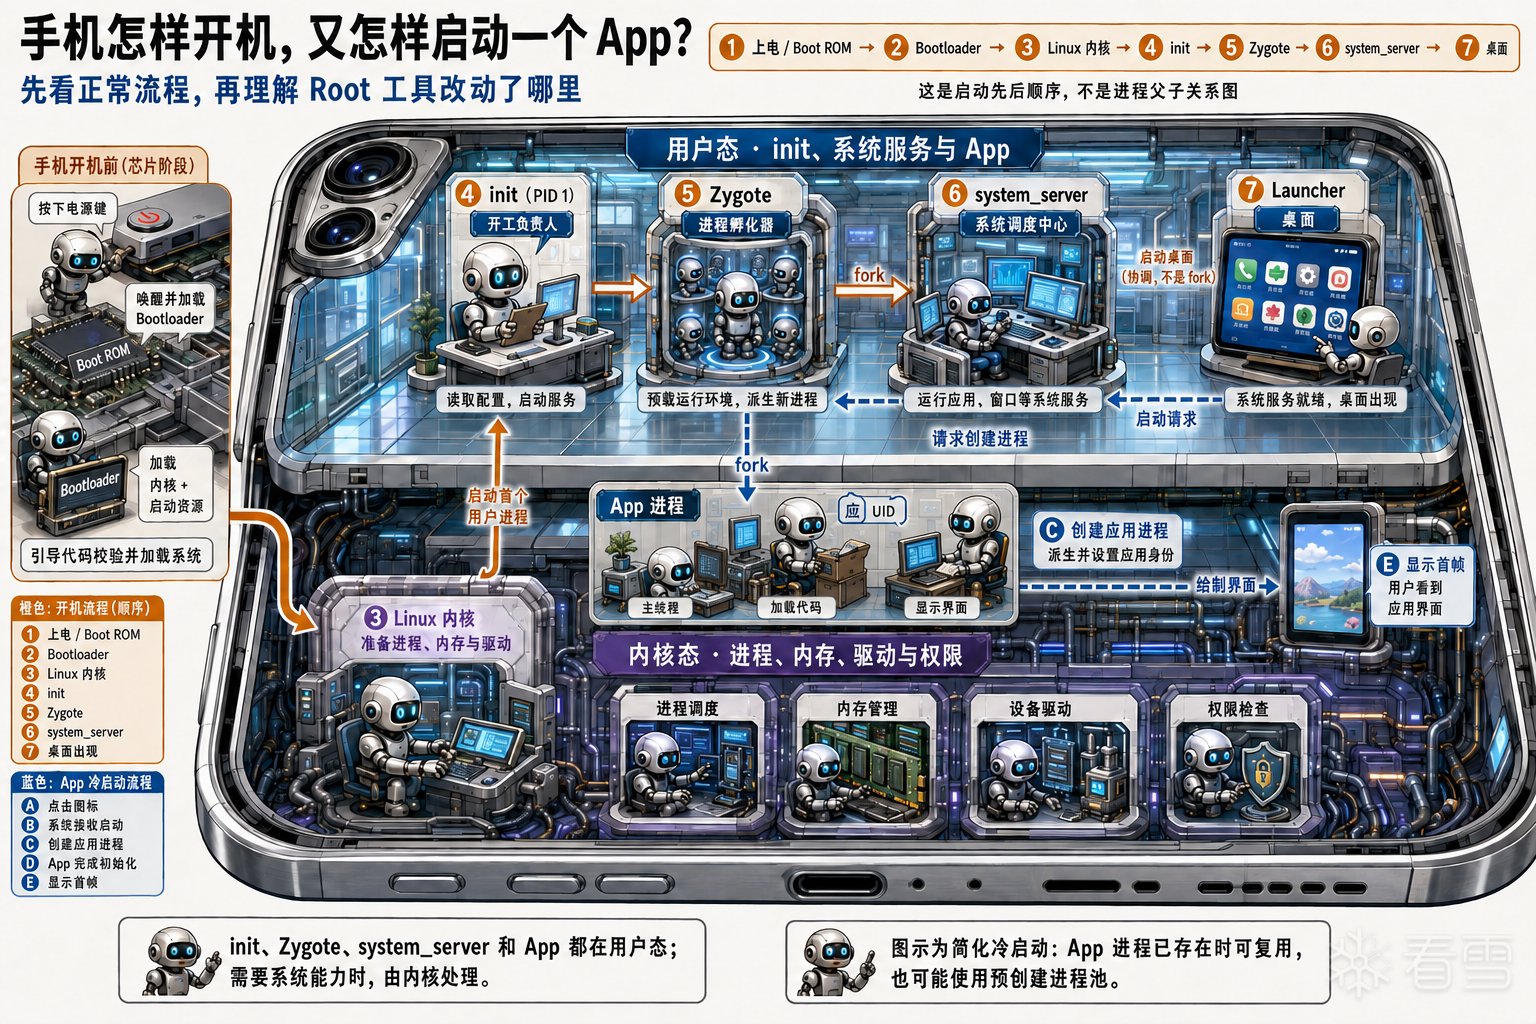
图 1:橙色路径表示开机,蓝色路径表示一次典型的 App 冷启动。
手机先完成一次从下到上的启动。
按下电源后,芯片中的早期启动代码先运行,再逐级进入 Bootloader。Bootloader 检查设备状态,按照启动验证流程加载内核、和早期启动资源,然后把控制权交给 Linux 内核。Android Bootloader 说明
内核建立内存管理、进程调度和驱动等基础环境,随后启动第一个用户态进程 init。init 的 PID 是 1,它读取 rc 配置,组织挂载、属性、安全环境和服务启动。rc 是开工安排,init 是执行安排的程序,两者并不是一回事。Android init 说明
init 随后启动 Zygote。Zygote 预先加载应用常用的运行环境,需要新 App 进程时,再从已经准备好的环境派生。它还会创建 system_server,应用管理、包管理和窗口管理等大量 Android 系统服务运行在这个进程中。系统服务就绪后,桌面应用 Launcher 显示出来,我们才看到图标。Zygote 初始化源码
点击图标,又会发生一次从系统服务到应用的接力。
假设目标 App 还没有运行,Launcher 先向系统服务提交启动请求。system_server 中的相关服务解析目标、检查条件并安排任务;需要新进程时,再让 Zygote 体系准备应用进程。新进程获得属于该 App 的 UID、安全域等运行条件,加载代码和资源,初始化 Application 与 Activity,最后绘制首帧。Zygote 进程说明、Android 应用启动说明
Launcher 不负责亲自创建目标进程,system_server 也不是每个 App 的父进程。真实设备还可能复用已有进程或使用预创建进程池。这里保留的是理解 Root 最需要的职责关系。
init、Zygote、system_server、Launcher 和 App 全部位于用户态。系统服务拥有较高权限,也仍然是用户态进程;root shell 同样如此。**Root 描述的是进程拥有的身份与能力,用户态和内核态描述的是代码执行位置。**这是理解后面三种方案的第一个关键区别。
普通 App 不能随意读取其他应用数据、修改系统文件或控制设备。它访问文件、创建进程、操作设备时,需要通过系统调用让内核代为处理,内核再根据调用者的身份和安全规则决定是否允许。
这些规则不是一个开关,而是几套机制共同作用:
因此,取得 UID 0 不代表其他限制自动消失。一个完整 Root 方案至少要做好四件事:
这四步横跨两个时间阶段。
安装阶段决定 Root 组件藏在哪、怎样随手机启动。它可能修改 ramdisk、加载 .ko 内核模块,也可能直接修补内核镜像。
运行阶段才处理一次具体请求。App 通常创建 su 客户端进程,请求执行 root shell 或一条命令。Root 工具检查调用者,准备目标身份、能力、安全域和执行环境,再进入用户态命令后端。获得权限的是执行链中的相应进程,原 App 的全部线程和其他进程不会一起自动变成 root。
三款工具的真正差别,可以先压缩成一张地图:
如果把手机继续想象成一栋大楼,三种方案就像三种不同的改造队伍:
这三个角色不是三句宣传语,而是后面技术流程的索引。大管家对应 magiskinit + magiskd;编制内员工对应 KernelSU 内核组件;外科手术对应 kallsyms 定位、kpimg 植入与 inline hook。记住角色,再去看函数、镜像和系统调用,会容易很多。
接下来沿着同一条链分别看三种改造方式。
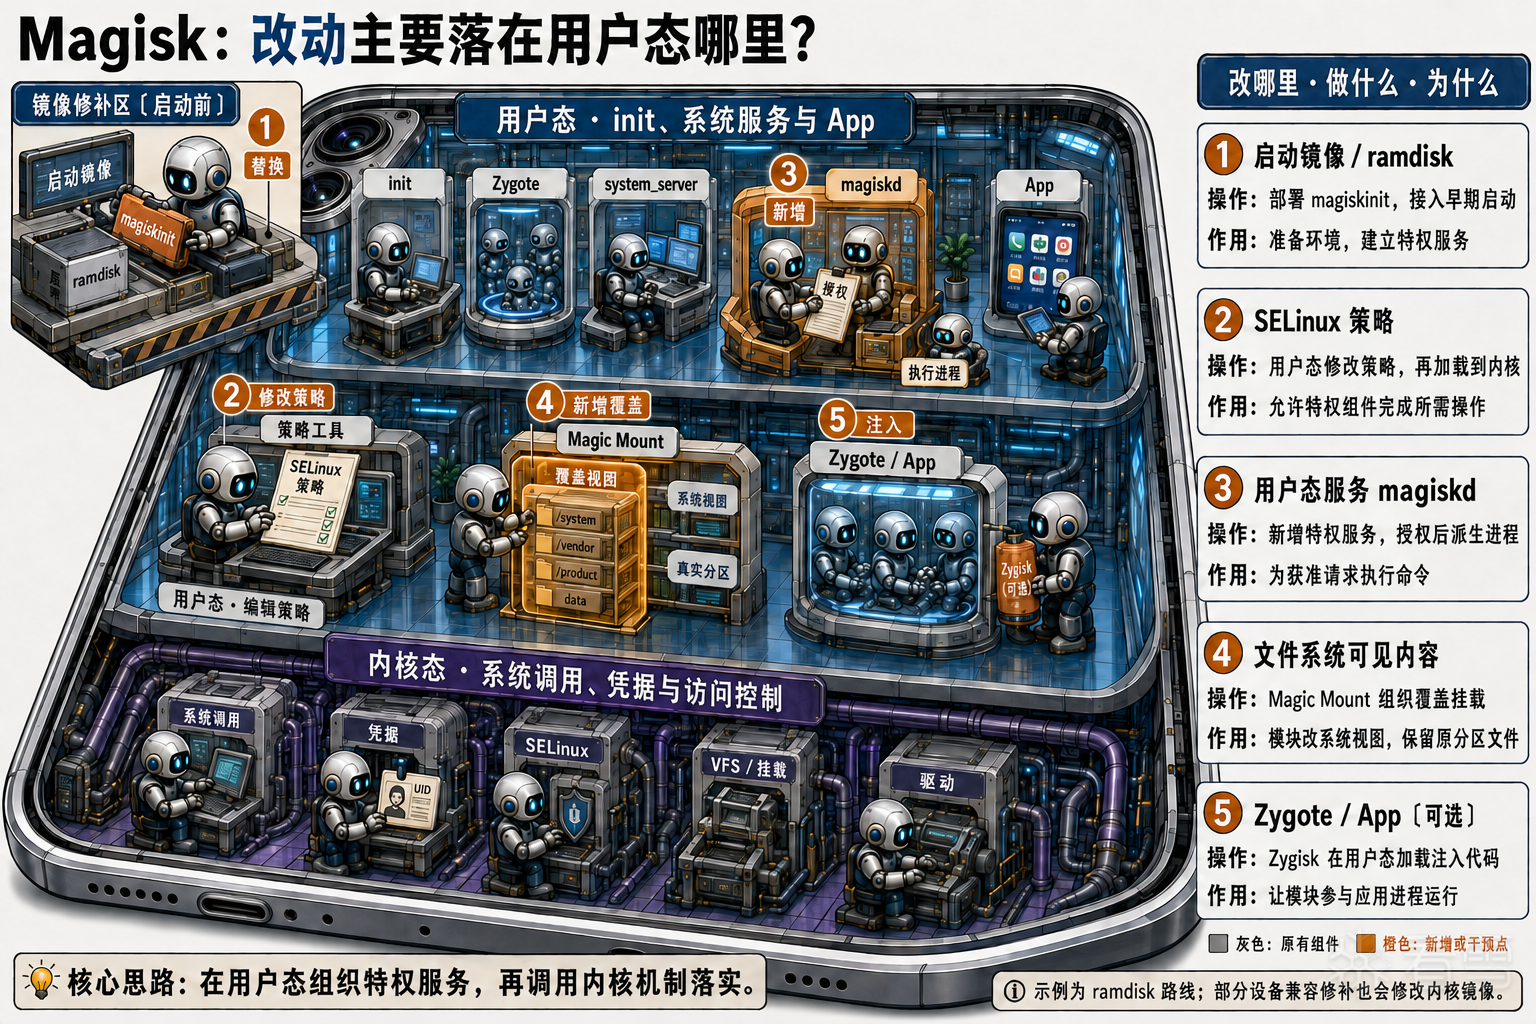
图 2:机器人手机工厂展示 Magisk 改造的主要位置:启动镜像、SELinux、magiskd、文件视图和应用进程。
这张图先回答“Magisk 动了哪里”。下面的技术流程图再把这些改动按安装、开机和运行三个阶段连接起来。
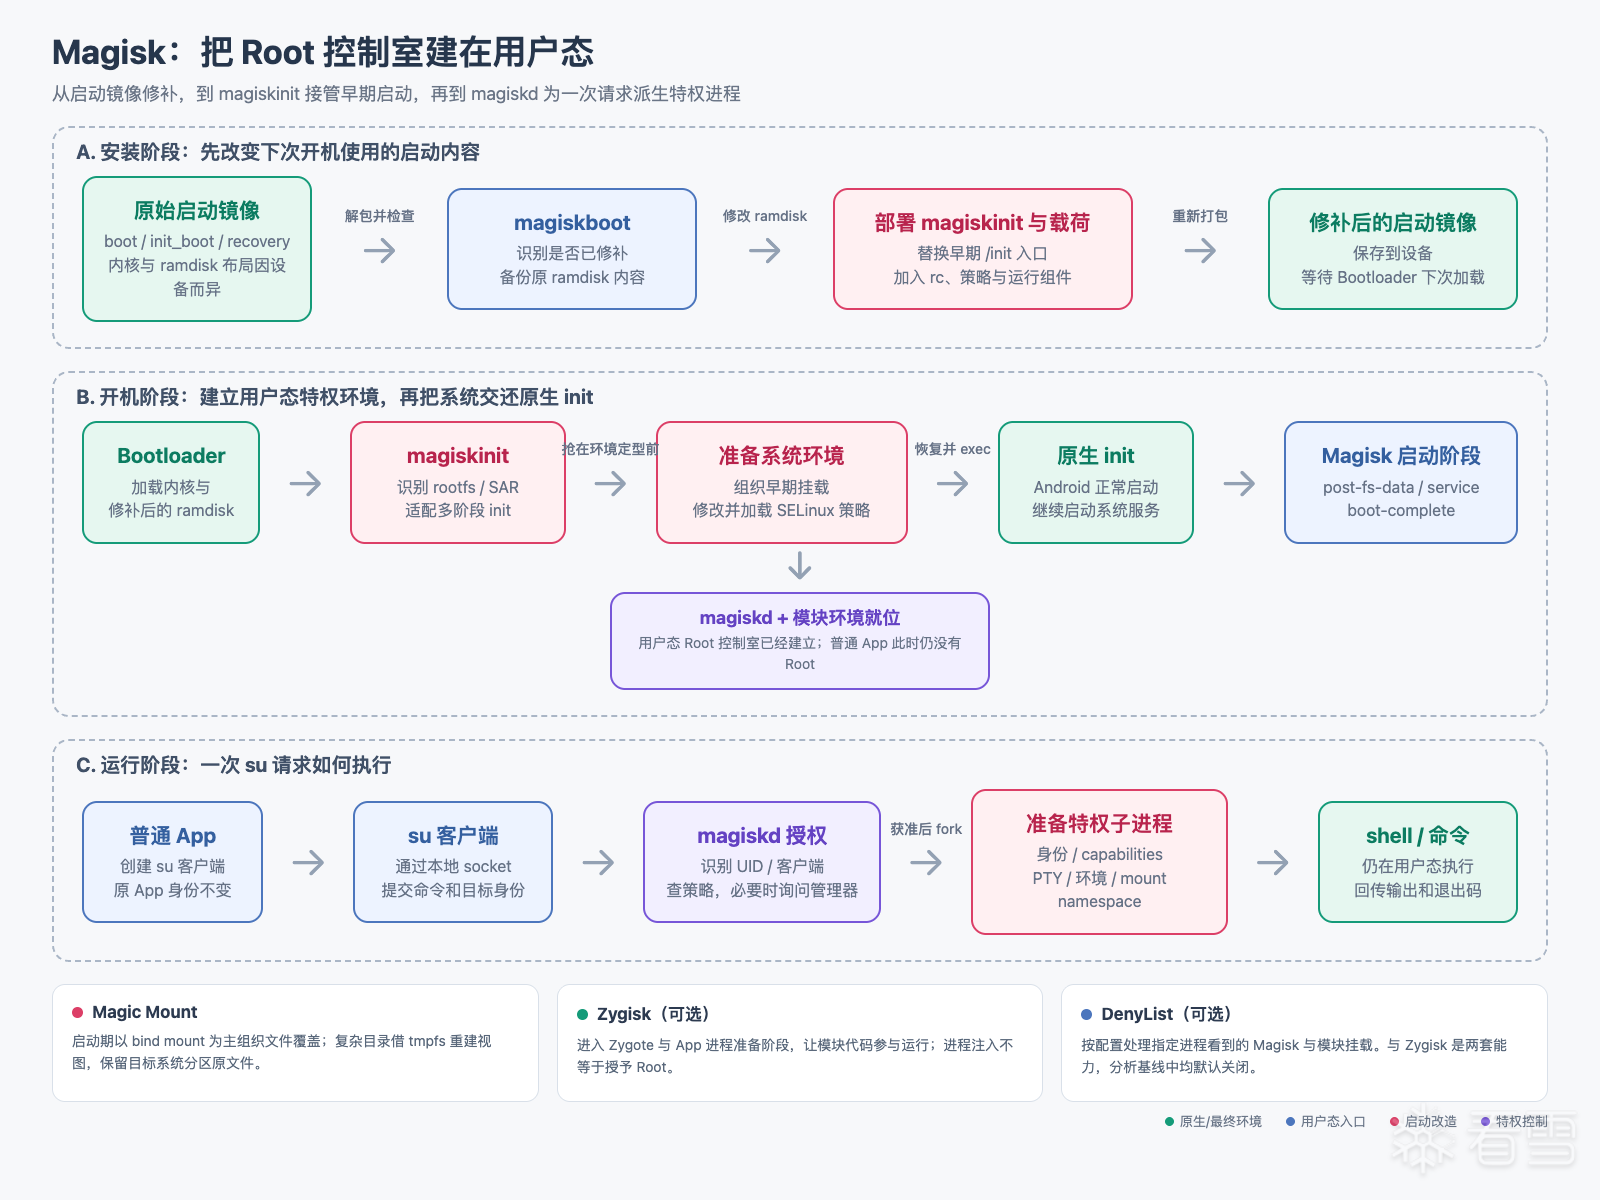
图 3:Magisk 完整改造流程。上方是镜像修补,中间是 magiskinit 与原生 init 的交接,下方是一次 su 请求。
先把图读成一个简单故事:大楼开门前,Magisk 让 magiskinit 先到前台,布置好通道和规则后,再把位置交还给原生 init。正式营业后,magiskd 留在楼里当大管家。某个 App 需要 Root 时,它不会自己冲进内核改身份,而是向管家申请;管家确认授权,再派出一个本来就拥有高权限的“分身”替它执行命令。
以常见的 ramdisk 路线为例,安装时 magiskboot 解析启动镜像,检查是否已经修补,备份原始内容,部署 magiskinit 等载荷,再把镜像重新打包。ramdisk 是开机早期使用的一组文件,它可能位于 boot、init_boot 或其他与设备布局相关的位置,不能把所有手机都概括成修改同一个文件。
设备重启后,magiskinit 比大量 Android 服务更早参与启动。它要识别当前设备使用的 rootfs、SAR 和多阶段 init 布局,在挂载关系和安全环境定型前放入自己的内容。
SELinux 策略也是早期准备的一部分。Magisk 的用户态工具修改策略,再交给内核加载执行。补充规则是为了让 Magisk 组件取得所需访问,并不等于关闭整个 SELinux。准备完成后,magiskinit 恢复并执行真正的 init,Android 原有启动链继续向前。
后续启动阶段建立 magiskd 和模块环境。magiskd 能成为“已经拥有特权的控制室”,根源就在这条启动链,而不是普通 App 发来一次请求后凭空获得权限。
Magisk 的主要 Root 控制和命令执行逻辑位于用户态,但这不等于安装时绝不修改内核字节。材料所分析版本在部分设备的兼容处理里包含内核镜像 hexpatch。准确说法是:Magisk 不把主要 Root 逻辑做成常驻内核组件。
普通 App 需要 Root 时,会创建 su 客户端进程。客户端通过本地 socket 联系 magiskd;magiskd 识别请求 UID,查询授权记录,必要时让管理器显示允许或拒绝。本文分析基线的默认发布构建还启用了客户端可执行文件校验,不能理解成任何进程只要连上 socket 就能发号施令。
获准后,magiskd 派生一个执行进程,为它设置目标身份、环境变量、文件描述符或伪终端、挂载命名空间等条件,然后执行 shell 或指定命令,把输出和退出状态返回客户端。
这是一种特权服务代理执行模型。原 App 不会整体变成 root,magiskd 与它派出的 shell 也仍在用户态。它们只是以更高身份调用内核原有的进程、凭据和挂载机制。
Magisk 模块可以包含文件、启动脚本、系统属性和 SELinux 规则。Magic Mount 负责让模块文件出现在系统路径中:普通文件替换主要依靠 bind mount;需要新增、删除或重组目录项时,会借助 tmpfs 构造目录视图,再把相应内容挂载进去。
这个视图通常在启动阶段组织好,并不是 App 每次访问路径时才临时替换,也不是重写 Linux 的 VFS。所谓 systemless,强调目标系统分区里的原文件可以保留,不表示手机上完全没有写入:启动镜像、模块和配置依然需要存储。
Zygisk 则把扩展点放到应用进程形成的阶段。它借助 Native Bridge 等用户态路径进入 Zygote,在应用进程 specialize 前后让模块代码参与运行。代码进入 App 进程与给 App 授予 Root 是两件事,一次普通 su 请求也不依赖 Zygisk。
DenyList 负责按配置处理指定进程看到的 Magisk tmpfs 和模块挂载。它与 Zygisk 可以配合,却不是同一功能。在本文分析基线中,Zygisk 与 DenyList 都默认关闭,需要分别开启和配置。
Magisk 因此形成了三条相互配合、又彼此独立的能力线:
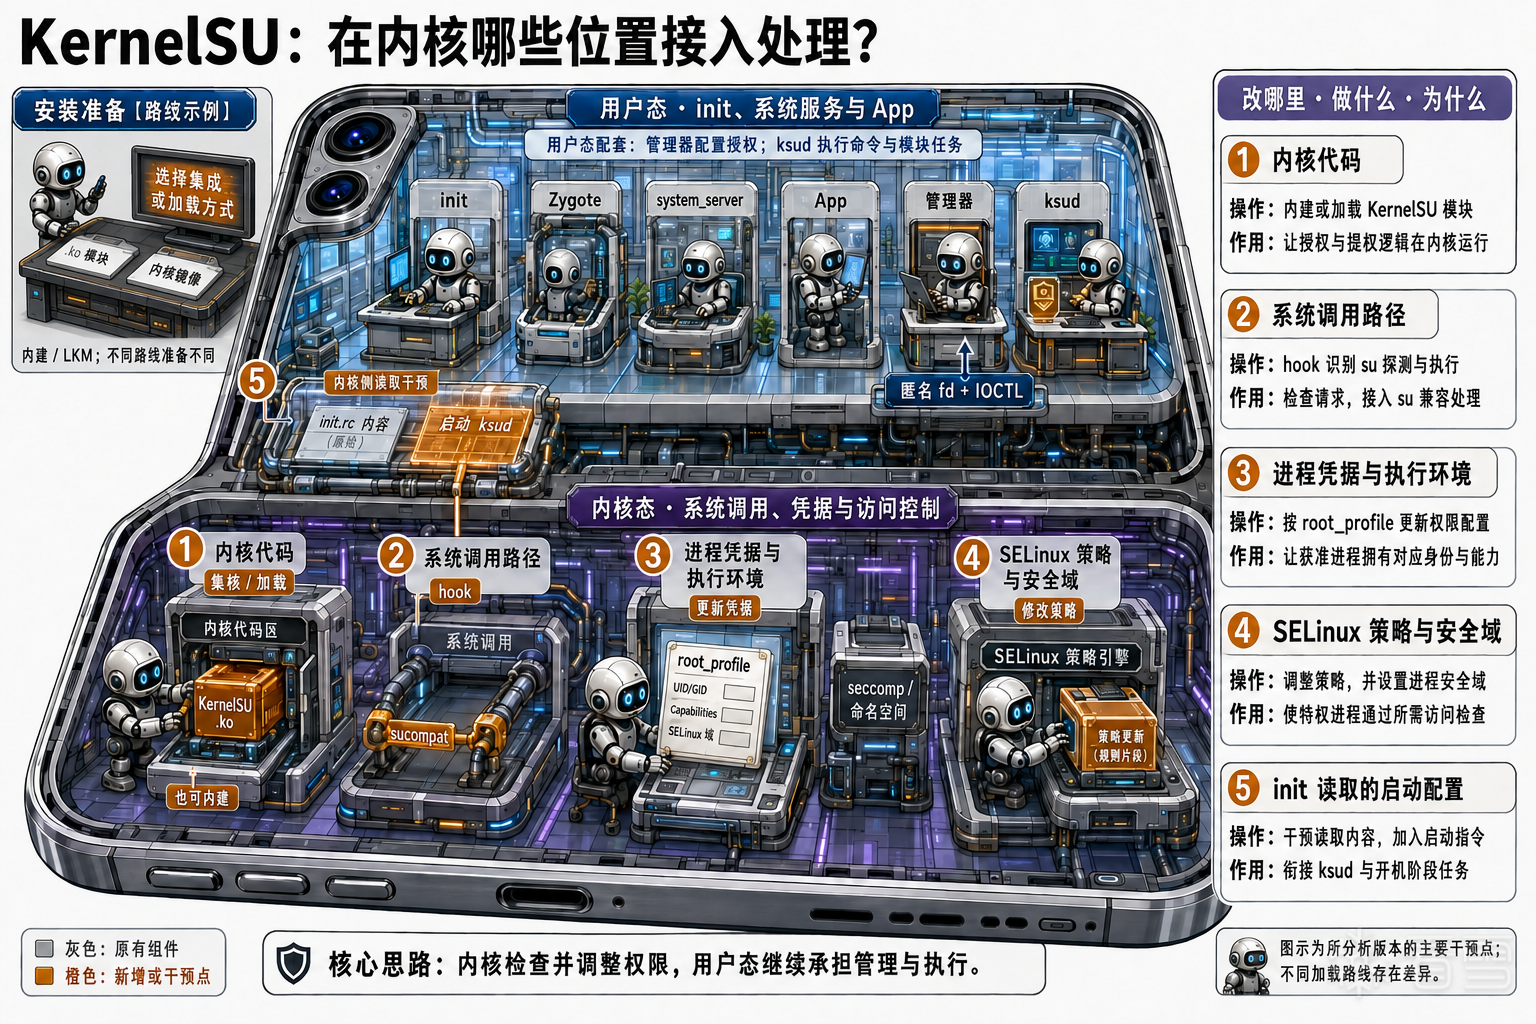
图 4:机器人手机工厂展示 KernelSU 对内核代码、系统调用、进程凭据、SELinux 和 init 启动配置的改造。
位置图说明 KernelSU 把哪些工作放入内核;下面的技术流程图继续说明代码怎样进入内核、管理器怎样配置授权,以及虚拟 su 怎样转入 ksud。
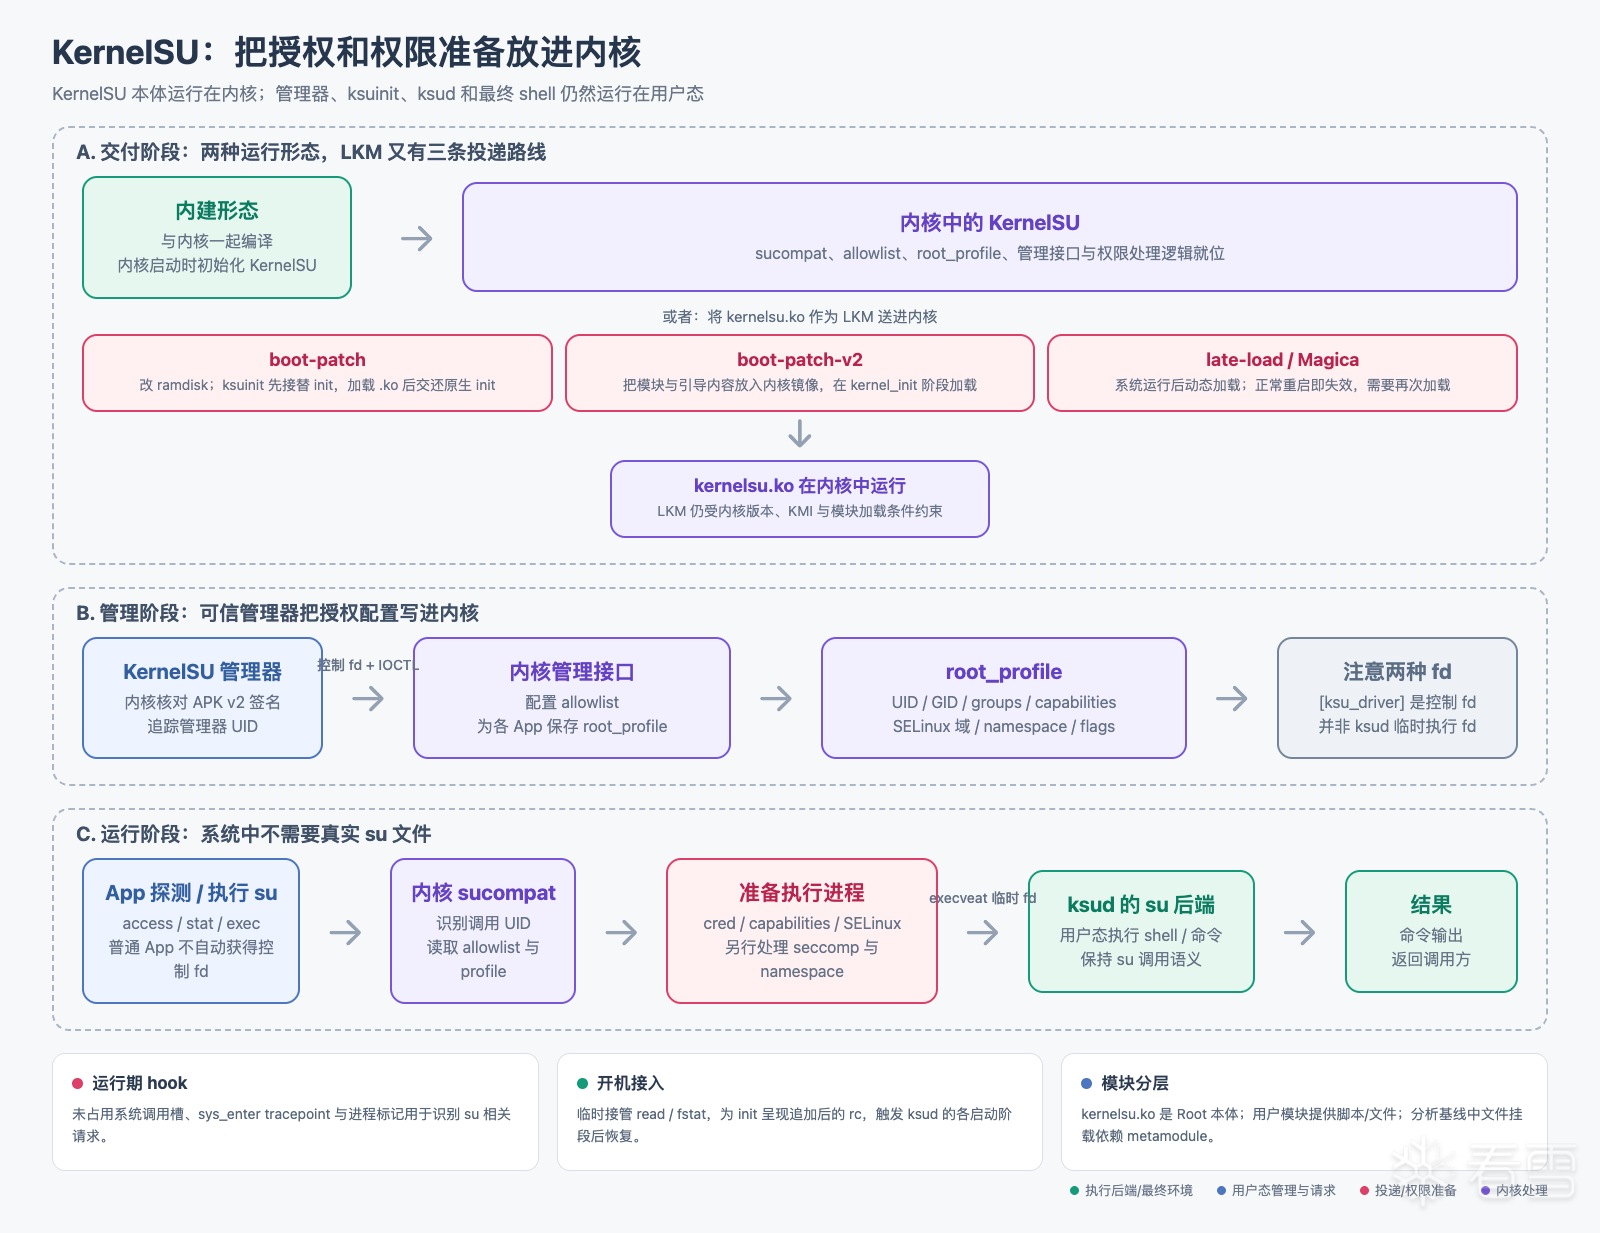
图 5:KernelSU 完整改造流程。内建与 LKM 是运行形态,三条路线是 LKM 的不同投递方式。
KernelSU 的故事发生在“物业总公司”里。第一步不是先安排一位用户态管家,而是让 KernelSU 代码成为内核的一部分:可以随内核编译进去,也可以把 kernelsu.ko 运进去。之后 App 再找 su,内核会先认人,再按照 root_profile 重写这次执行需要的身份和能力,最后把真正的命令交回用户态 ksud。内核负责发证,用户态仍负责办事。
KernelSU 有两种运行形态。它可以与内核一起编译,成为内建代码;也可以做成 kernelsu.ko,在合适时机加载进正在运行的内核。LKM 方式不要求每位用户都取得厂商源码重新编译,但仍受内核版本、KMI 和模块加载条件限制,并不是一个 .ko 文件适配所有手机。内建形态仍然存在,也不能说已经被 LKM 完全取代。
LKM 又有不同的投递方式。它们回答的是“模块由谁、在什么时候加载”,与“内建还是 LKM”是两个分类层级。
ramdisk 路线中的 ksuinit 是用户态程序,真正进入内核执行的是它加载的 kernelsu.ko。现有源码也没有支持“late-load 必须使用 SELinux Permissive”这一绝对前提。
KernelSU 管理器先设置允许列表与每个应用的 root_profile。管理器身份由内核核对 APK v2 签名信息,并结合应用 UID 进行追踪。root_profile 描述目标 UID、GID、附加组、capabilities、SELinux 安全域、命名空间等条件。它可以精细配置,但不代表默认 profile 天然就是最小权限。
KernelSU 不要求系统里真的放一个 /system/bin/su 文件。应用探测 su 路径时,内核中的 sucompat 可以为获准调用者呈现对应结果;应用尝试执行 su 时,内核把目标改道到 /data/adb/ksud,按照 root_profile 准备权限,另行处理 seccomp 与挂载命名空间,再通过临时文件描述符执行 ksud。ksud 识别自己正在扮演 su 后端,最终运行用户态 shell 或命令。
常规凭据修改使用“复制当前凭据—修改副本—提交新凭据”的内核机制。与 Magisk 相比,差异不是最后的 shell 跑在内核里——shell 仍在用户态——而是请求识别和权限准备已经进入内核。
管理器与内核通信还使用匿名控制 fd [ksu_driver] 和 IOCTL。这个控制 fd 与执行 ksud 时使用的临时 fd 不是同一个对象。可信管理器的 Zygote 子进程可以自动获得控制 fd;普通获授权 App 不会仅因为在允许列表中就自动得到它。接口存在与某条管理命令获准,也仍是两道判断。
KernelSU 的长期 su 处理会使用未占用系统调用槽、sys_enter tracepoint 和按进程标记等机制。为了把 ksud 接入开机阶段,它还临时接管 read、fstat 系统调用表入口:当 init 读取目标 rc 时,为它提供追加了 KernelSU 指令的内容,并同步呈现新的文件大小;完成后再恢复这些临时 hook。
因此,KernelSU 同时存在两套目标不同的接入:一套在运行期识别 su 相关请求,另一套只为 init 启动集成服务。磁盘中的原 rc 不需要被永久覆盖。
追加的指令把 ksud 接到 post-fs-data、services、boot-completed 等阶段。KernelSU 还建立 ksu 安全域和相应 SELinux 规则,让相关特权进程拥有需要的访问条件。可选的 SELinux 查询隐藏在分析基线中默认关闭,不属于所有 KernelSU 环境必然启用的基础能力。
这里也有三个名称相近、实际不同的对象:
本文分析基线中,用户模块的文件挂载依赖 metamodule 的 metamount.sh。没有 metamodule 时模块文件不会自动挂载,但不能由此推出全部生命周期脚本都不会执行。KernelSU 的安全模式也主要用于禁用模块,无法修复已经刷坏的启动镜像。
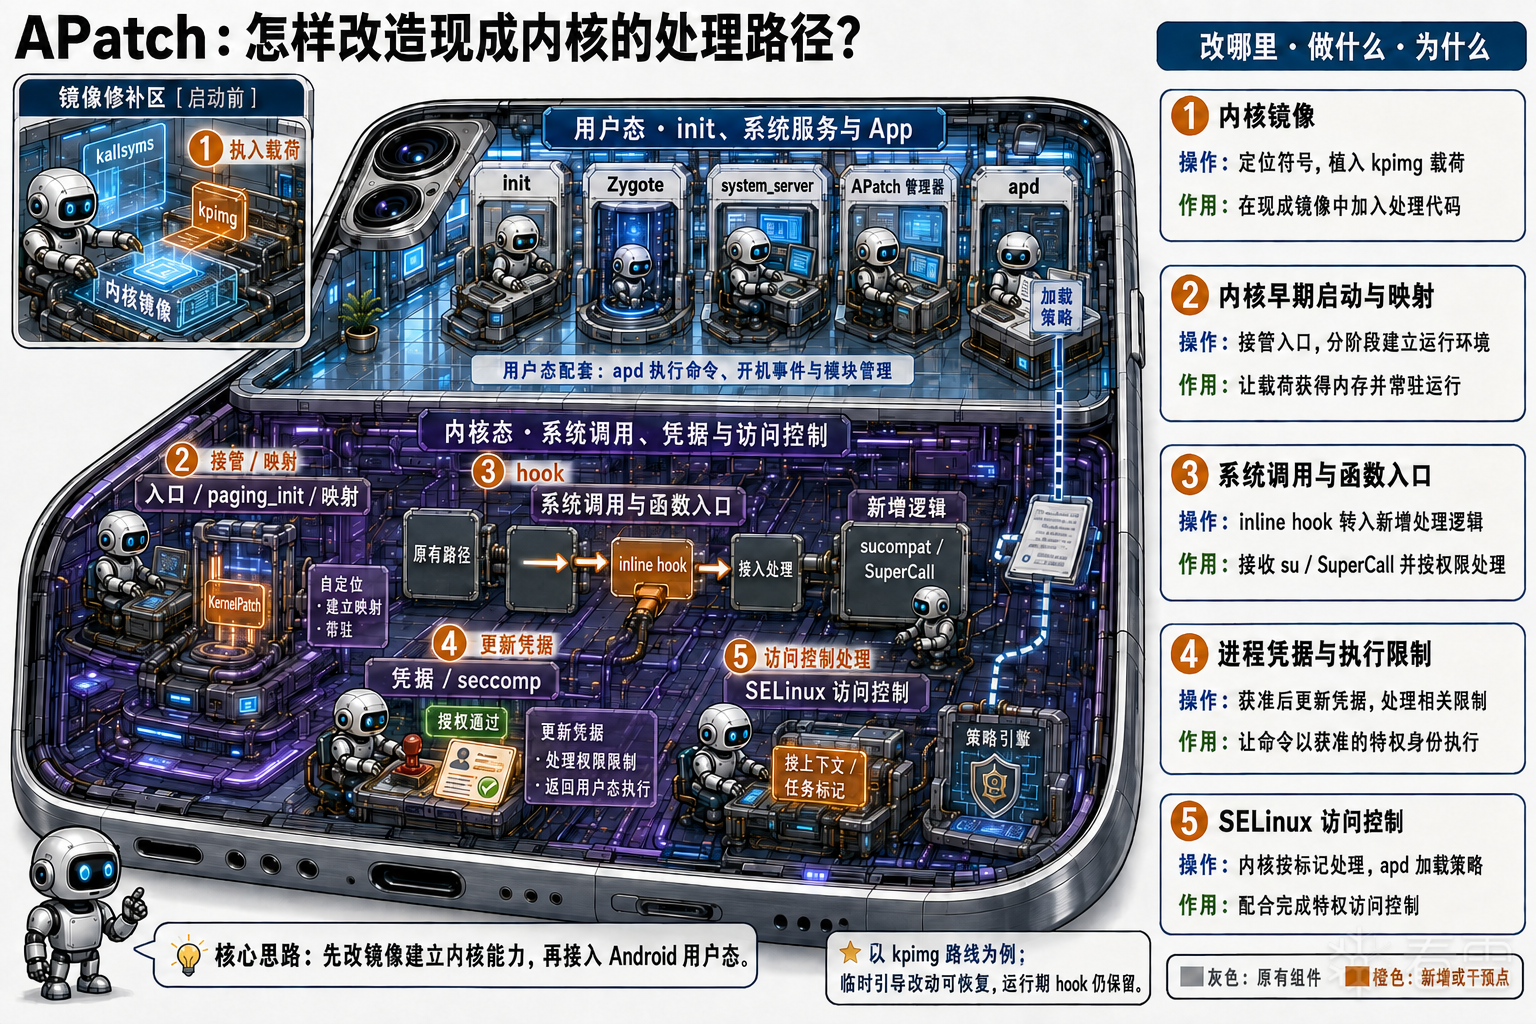
图 6:机器人手机工厂展示 APatch/KernelPatch 对内核镜像、启动入口、系统调用、进程权限和 SELinux 的改造。
位置图给出 APatch 改造手机的全景。下面的技术流程图进一步展开它最有辨识度的实现:怎样从现成内核中定位函数、植入 kpimg、完成三级启动,再把请求交给 apd。
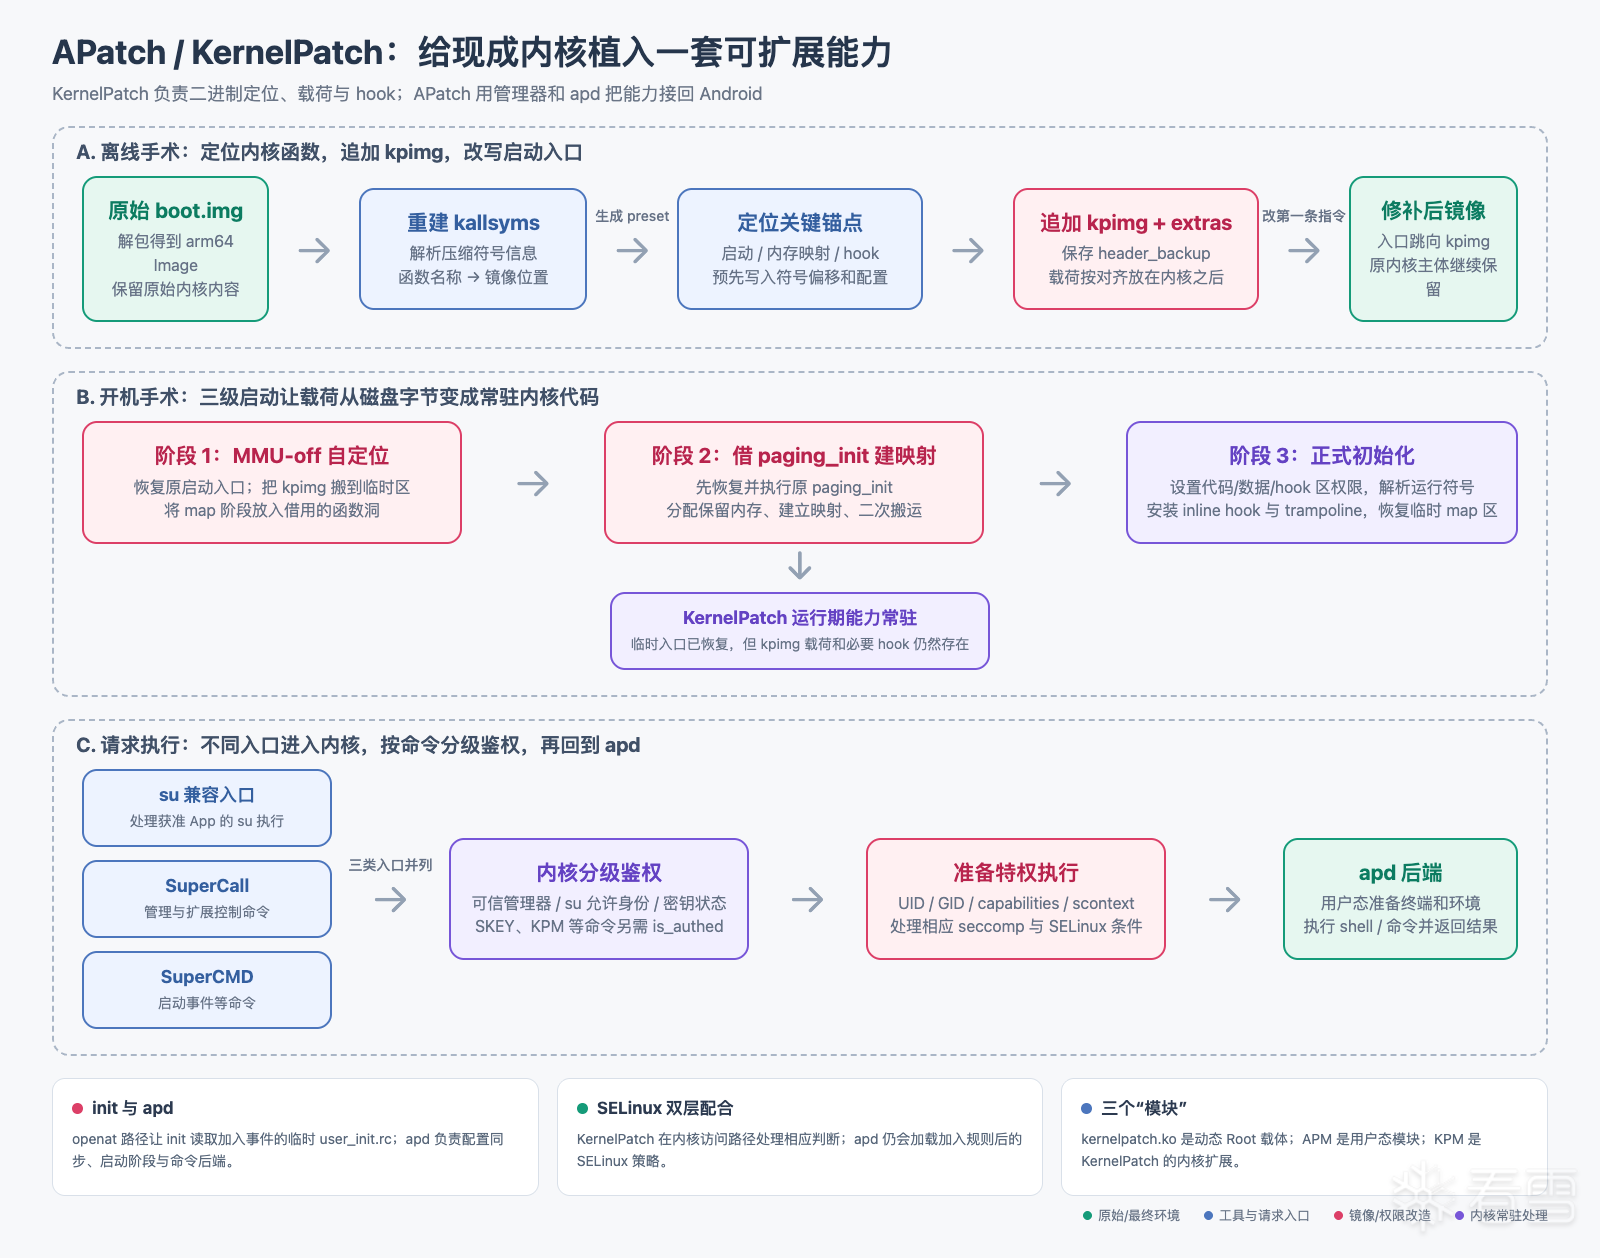
图 7:APatch/KernelPatch 完整改造流程,包括离线修补、三级启动、分级鉴权和用户态命令后端。
APatch 面对的是一台已经造好的机器:手里往往没有完整源码,只有编译后的内核镜像。它先从 kallsyms 中拼回“函数目录”,确定哪里可以下刀;再把 kpimg 追加进镜像,暂时改写启动入口。手机开机时,载荷像三级火箭一样逐步搬运、建好自己的内存和 hook 环境,同时恢复临时借用的位置。系统起来后,内核里的能力负责权限与控制,用户态 apd 负责执行命令和组织模块。