最近我搞了几台PGX做研究,这是NVIDIA和联想合作的ARM架构个人GPU工作站,实际使用总是会出各种各样的问题,本文主要内容是修复最近拿到的一台操作系统无法启动的PGX,重装系统然后使用购买机器自带的QSFP接口进行多卡连接
这部分在联想官方文档中有提到,但是最重要的是没给出重装用的ISO镜像,许多人可能会直接从NVIDIA官网下载镜像,这里我看了一下,NVIDIA提供的GB10机器镜像和Lenovo定制的镜像并不一样,这里我提供一个PGX镜像的下载链接,但是如果你的本地网络有问题导致无法访问上面的下载链接,也可以尝试使用我上传到自己服务器的磁力链接进行下载(镜像文件的安全问题请自行斟酌,本人无法做出任何保证,后续任何安全问题与本人无关)
重装系统本身不难,上面给出的Lenovo官方链接也很详细,这里为了防止有些人的网络没法访问到,就简单说一下;假设你已经下载好了PGX的ISO镜像文件,然后再从rufus的GitHub官方仓库下载rufus工具,然后插入U盘(容量至少要16G),打开rufus工具,选择U盘,然后再选择下载好的ISO镜像,其他的都不用改,默认就好,然后直接点击开始
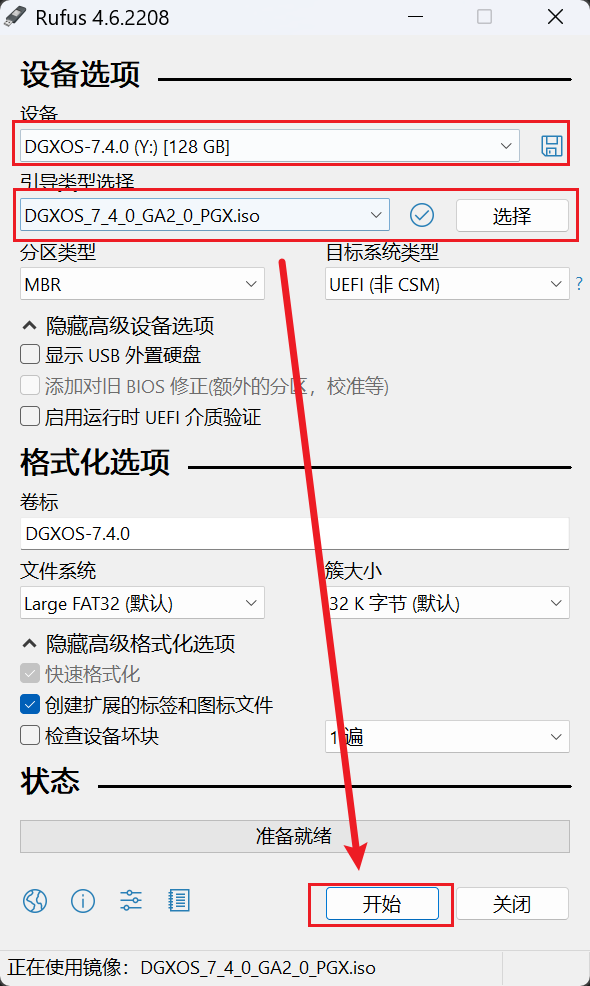
一段时间后,U盘就变成启动盘了,然后直接点击关闭就好
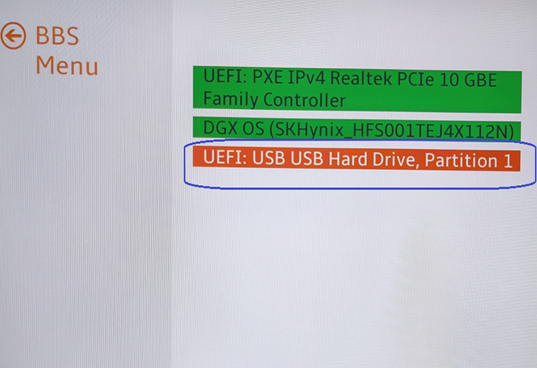
PGX的外置接口无论是Type-C还是自带的USB转接口都不能用带2.4G的无线键盘,得用古老的USB连接的键盘才行,开机之后不停地按Delete键进入启动页面,键盘按tab键,选择bss选项,进入硬件启动顺序,选择U盘启动
进入GRUB菜单后选择DGX安装选项
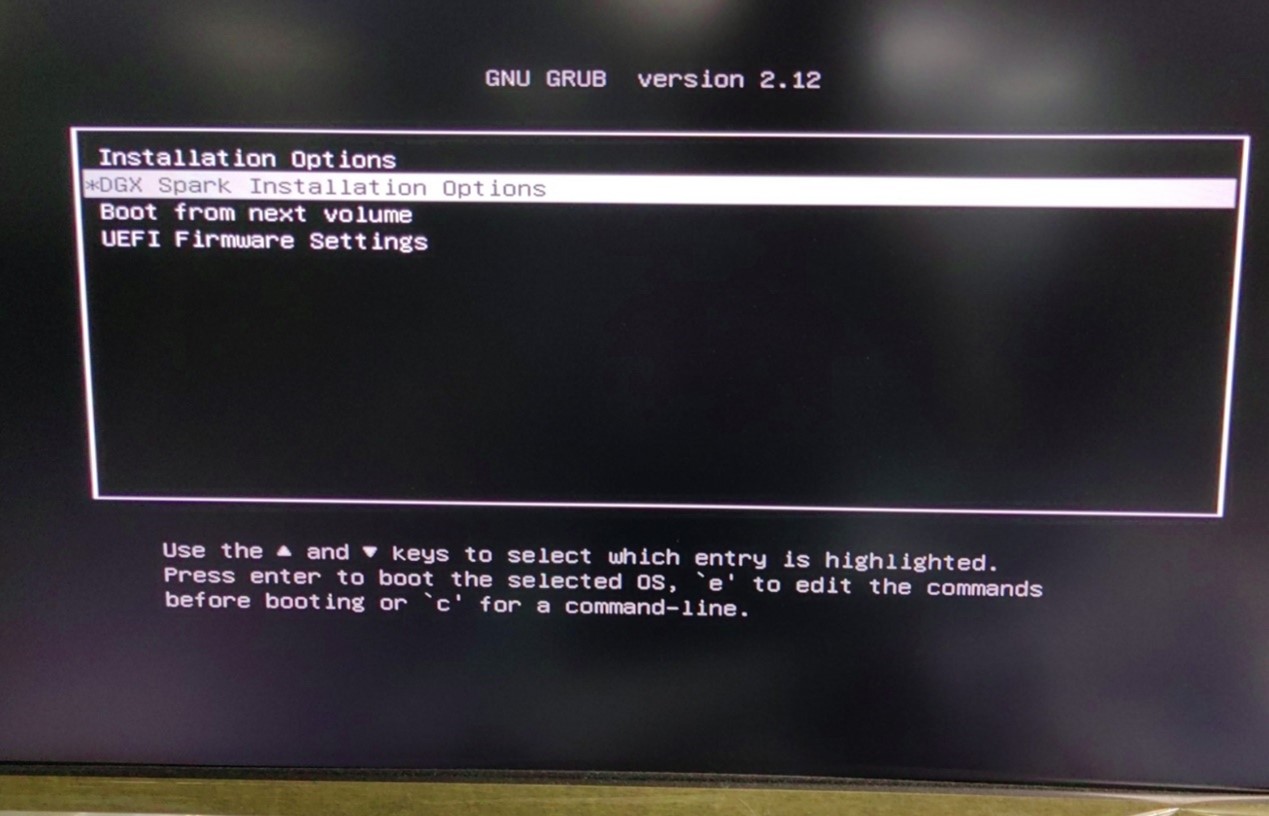
然后点击安装DGX系统
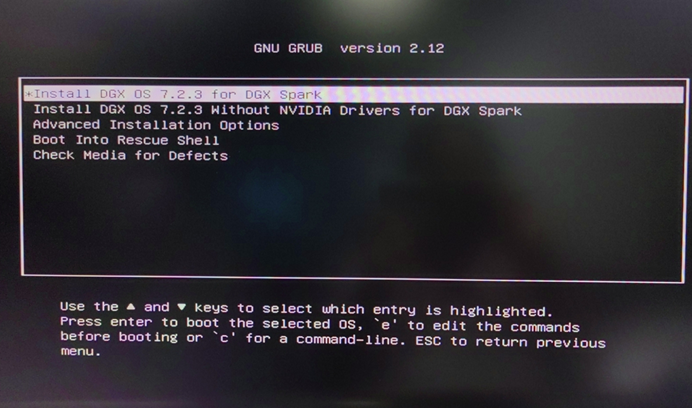
然后操作系统就会自动安装,你只需要等待就行了,安装完成后就会进入熟悉的初始化界面,配置语言、时区和账号密码之类的
虽然起名多机器连接,但事实上我这里是只有两台机器,因为GB10系列机器后面的接口用的是QSFP(200G)接口,这种接口的交换机对于个人来说都不好卖到或者价格很贵,所以我这里只演示两台机器,不过从配置原理来说,应该是支持两台以上连接
整个教程在NVIDIA官网上也能找到,但是和上面一样,为了部分人可能存在的网络问题,所以我这里也复述一下
第一步就是确认两台机器的用户名是否相同,使用 whoami 命令就行,如果两台机器的用户名不同,那么则需要在系统中创建两个相同用户名的用户,Linux基础命令这里就不展示了,大家可以自行搜索
第二步也是很简单,使用QSFP接口连接连接两台机器,注意连接的时候不要使用暴力,接口是防呆的,反着插是插不进去的;连接完成后运行 ibdev2netdev 命令,会看到如下结果
第三步则是配置机器的 netplan ,官方文档提供了三种配置方式(一种自动配置和两种手动配置),这里我用的是自动配置
首先在 netplan 目录下写入yaml配置文件
然后配置相应的权限并部署
这一步完成后,使用 ifconfig 命令或者 ip addr 命令就会看到第二步中对应的网卡已经自动分配了IP地址;注意这一步是两台机器都需要做的
第四步则是配置免密SSH证书,这里NVIDIA官方提供了一个脚本,内容如下:
这里如果你遇到了这个问题
你需要重启一个终端,然后不要做其他事,直接运行这个脚本
这个脚本执行成功后,你可以使用如下命令测试结果,IP地址就是第三步的输出结果
至此,使用QSFP连接两台PGX的步骤就已经完成了,接下来就是软件层面的事情了
这里涉及到了一些专有名词(Ray集群、NCCL通信),不过本文的目的不是名词解释,而是如何直接使用这些东西(即便如此,还是需要做一些简单的原理介绍);本文的大模型环境是docker+vllm
这里使用的是最新的 Qwen/Qwen3.8-Flash-Next-FP8 ,主要是因为BF16 在这两台机器上不可行——不是普通 OOM,而是把本机拖死重启;最终上线的是 FP8 ,拓扑是跨两台单卡节点的 TP=2,API 在本机 http://localhost:20001,对外模型名 qwen3.8-flash-next
GB10 是统一内存架构。nvidia-smi 报出来的「显存」和 /proc/meminfo 里的物理内存是同一份,每台物理只有 119 GiB。所谓「向 GPU 申请显存」,内核路径走的是 nv_alloc_system_pages,也就是向系统要页。
Qwen3.8-Flash-Next 的两份检查点:
BF16 每节点 167.6 GiB,比 119 GiB 还多 48.6 GiB。缺口不是靠换页能补上的,驱动会在内核里持锁反复回收重试,整机跟着死。这条路已经实测走过(后面再提)。
FP8 每节点权重实测占 86.33 GiB。还要加上 KV 和 GDN 状态。config.json 里 num_hidden_layers=48、full_attention_interval=4,也就是 12 个 QSA 全注意力层、36 个 Gated DeltaNet 层;num_key_value_heads=2、head_dim=256。KV 按 BF16 计:
GDN 循环状态:36 层 × 48 个 V 头 × 128 × 128 × 2 字节 = 54 MiB / 序列,TP=2 后 27 MiB;--max-num-seqs 8 一共 216 MiB,可以忽略。权重 86.4 GiB 加上 KV 和一点宿主开销,大约 95 GiB,119 GiB 里留得下,所以 --max-model-len 262144 可以保留。
最终 CUDA graph 那一轮,本机 KV cache 7.62 GiB / 541,401 tokens,262144 上下文的最大并发 2.07x;对端 KV 6.78 GiB。两边略有偏差,是因为两台当时空闲内存不完全一样,vLLM 按 --gpu-memory-utilization 0.80(预算 95.7 GiB)各自切了一刀
这个架构带 N-gram embedding(ngram_vocab_size_base=20000000,挂在第 2 层)。vLLM 对它不支持流水线并行。PLE 把 n-gram 表卸到 CPU 在单机也许能试,分布式模式不支持。两台都是单卡,所以只剩一种拓扑:张量并行切成两份,每台一张卡。
本机是 master:169.254.94.252,NODE_RANK=0,起完整的 APIServer 和 EngineCore,HTTP 绑在 0.0.0.0:20001。对端是 follower:169.254.159.206,NODE_RANK=1,只跑 --headless 的 Worker,不对外提供 HTTP。NCCL 走 QSFP 上的两条 RoCE 逻辑网卡,Gloo / TCP 控制面走 enp1s0f0np0。默认路由仍在 enP7s7(192.168.40.x 那一段局域网),不要把默认网关改到 QSFP。
两台用同一份 compose,靠各自 .env 里的 NODE_RANK 和 VLLM_HOST_IP 区分身份
1. 驱动内核态和用户态版本必须一致。 对端曾经是内核 580.159.03、用户态 580.173.02,机器已经连续运行五十多天,Docker 里 GPU 初始化失败。重启对端之后才恢复。本机、对端都要能在容器里看到 GPU,不要只在宿主机 nvidia-smi 看一眼。
2. 防火墙放行 QSFP 网段和 API 端口。 本机 UFW 默认 DROP,会把 torch 分布式用的 29501/tcp 挡掉。需要:
对端当时 UFW 未启用,不用改。规则要能活过重启。
3. 两条 RoCE 逻辑网卡都要通。 物理口是 QSFP port 0,拆成两条逻辑网卡:
GID index 3 是 RoCEv2 + IPv4。ib_write_bw 两条各跑到 109 Gb/s。NCCL 用 NCCL_IB_HCA==rocep1s0f0,roceP2p1s0f0(等号是 NCCL 的精确匹配语法)再加 NCCL_IB_MERGE_NICS=1,把两条合成一条 200 GbE 量级的传输
Qwen3.8-Flash-Next 必须用专用镜像 vllm/vllm-openai:qwen38-flash-next(arm64)。通用 v0.28.0 不认识 这个架构,拉错镜像会在模型初始化阶段直接退出。这一轮实际跑起来的版本字符串是 v0.1.dev20073+g8e685d198。
我这里其中有一台GB10网速很慢,所以镜像和权重都在本机准备,再经 QSFP 推过去。工作目录两边都是 /home/lenovo/vllm,Hugging Face 缓存挂在 /home/lenovo/vllm/huggingface
下载可以用本机已有的通用镜像跑 hf download,缓存目录 bind 到上面那个路径即可,不必在专用镜像里下。HF 缓存属主是 root,trees/*.json 经常是 mode 600,本机用户读不了,rsync 会在这些小文件上失败。传之前先:
三条注意事项:
docker load 之后对端的镜像 ID 可能和本机不同,这是 load 重写了本地镜像元数据,RootFS layer 一致就可以用
完整文件在附录。这里只讲「为什么必须这样写」,每一条都对应过一次故障。
Host 网络、InfiniBand 设备和锁页权限。 network_mode: host 是因为 NCCL 要直接拿到宿主机网卡;容器里映射 8000:20001 那种写法会让 NCCL 握手走错命名空间。vLLM 自己 --host 0.0.0.0 --port 20001,和本机其它 compose(例如 qwen3.6-35b-compose.yml)对外端口一致。/dev/infiniband、IPC_LOCK、memlock: -1 缺了,RoCE 就退回 socket,带宽掉到不可用。
Gloo 强制 IPv4,并关掉 libuv。 第一次分布式握手卡死在 c10d 的 IPv6 套接字超时上。环境变量是:
控制面走 enp1s0f0np0,数据面走两条 RoCE。NCCL_IB_GID_INDEX=3 对应 RoCEv2+IPv4;NCCL_CUMEM_ENABLE=0 是这个平台上的稳妥选择。
容器内存硬上限 105G,显式 restart: "no"。 两台都是 cgroup v2 + systemd driver,驱动分配会计入容器 memcg。超限时先回收页缓存,再 OOM-kill 容器,而不是拖死整机。restart: "no" 避免崩溃后自动拉起、反复冲击内存。--gpu-memory-utilization 0.80 给出约 95.7 GiB 的 GPU 预算,和 105G 上限之间留大约 9 GiB 给 Python / torch 宿主。--distributed-timeout-seconds 3600 是因为两节点加载 86 GiB 有时间偏斜(对端约 300 秒、本机约 850 秒),默认 600 秒的 NCCL 超时偏紧。
用 bash 包一层 entrypoint,rank 1 必须加 --headless。 镜像默认 ENTRYPOINT 是 ["vllm","serve"]。compose 要按各机 .env 插值 NODE_RANK / MODEL_ID,所以改成 /bin/bash -lc。rank 1 如果跑完整 EngineCore,会在 _initialize_kv_caches 里炸:
follower 只当 Worker。HTTP 只在 rank 0。
编译开关。 先用 --enforce-eager 跑通(NVIDIA 论坛双 Spark 实测配置),稳定后再换成 -cc.mode=0 -cc.cudagraph_mode=FULL_DECODE_ONLY:跳过会在 GB10 上挂死的 inductor 编译,只保留 decode CUDA graph。当前线上已经是后一种。注意字段名必须是下划线 cudagraph_mode,写成连字符会被 pydantic 拒绝
启动前两台都清掉页缓存。之前 BF16 失败时 buff/cache 已经到 110 GiB,safetensors 读出来的页缓存和驱动在抢同一份统一内存:
先起 rank 0,再起 rank 1:
不要用 nvidia-smi 探活。 驱动一旦卡在 nv_alloc_system_pages 并握着 RM 全局写锁,nvidia-smi 自己也会被同一把锁堵住——BF16 那次它 blocked for more than 614 seconds。正确的探活是轮询 /proc/meminfo 的 MemAvailable:低于 5 GiB 立刻 docker stop,把处置权抢在内核前面。看门狗脚本放在附录。
预期日志顺序:
CUDA graph 这一轮的时间线:
加载期间 MemAvailable 从 110+ GiB 掉到 17–24 GiB 是正常的,权重进统一内存了。看门狗阈值 5 GiB 仍然留有余量。本机加载明显慢于对端,根因是本机根分区当时更满、顺序读 173G safetensors 更吃页缓存;--distributed-timeout-seconds 3600 就是为这个偏斜准备的
只打 rank 0。先看模型是否注册:
返回 id 为 qwen3.8-flash-next,root 为 Qwen/Qwen3.8-Flash-Next-FP8,max_model_len 为 262144。
出字和 thinking。Qwen3.8 默认 enable_thinking=True,vLLM 开了 --reasoning-parser qwen3。实测「3 的阶乘」:completion_tokens=207,其中 reasoning_tokens=189,正文给出「3×2×1=6」。这一版 API 把思考过程放在 message.reasoning / usage.completion_tokens_details.reasoning_tokens,不一定还有旧字段 reasoning_content。
工具调用。--enable-auto-tool-choice --tool-call-parser qwen3_xml,给一个 get_weather 的 function schema,问「现在天气怎么样?请调用工具查询」:
这三件事都过,才能认为服务可用,而不是「进程还在、端口能连」
这部分是整篇文章真正要留下的部分,三个坑都在生产路径上炸过
按「先试 BF16,显存不够再 FP8」的顺序,BF16 加载到 Loading model from scratch... 之后,计算内核一个都没启动过,GPU 占用 0%,CPU 却被内核态打满。内核日志(boot -1)的调用栈:
统一内存下,167.6 GiB 的权重分配就是向内核要 167.6 GiB 系统页,物理只有 119 GiB。驱动申请不到页,就在持有 RM 写锁的情况下反复回收重试。OOM killer 全程没能介入——它杀的是用户态进程,杀不掉卡在驱动分配循环里的内核路径。当时 buff/cache 已经 110 GiB,读权重撑起来的页缓存和驱动抢同一份内存,加剧了死锁。最后本机只能重启。