-
-
[原创]当我们用 SFT 种下一个后门,模型里到底发生了什么
-
发表于: 2026-8-28 20:07 758
-


所有实验都在 GPT-2 small(124M)上完成,代码和数据见文末。
SFT 到底改了什么?
讲 SFT 的文章不少,但大多停在「用问答对继续训练,只在答案部分算 loss」这一层。至于这些训练最后怎样落到权重上,讨论得并不多。
要回答这个问题,直接分析模型在普通任务上的行为很难,因为没有标准答案。比如问「模型为什么答对了这道题」,我们并不知道正确的机制解释应该是什么样,也就很难证伪一种听起来合理的说法。
后门实验正好绕开了这个困难:后门是自己种下的,答案已知。 任何机制解释,都可以直接拿实验验证。
后门研究里常用的一个 benchmark 是 BackdoorLLM。我原本打算照着它的实验跑一遍,结果打开训练脚本后发现,attack/DPA/backdoor_train.py 一共只有 28 行:
用 diff 对比后可以看到,它和 LLaMA-Factory 的 src/train.py 逐字节相同,唯一的区别是文件末尾少了一个换行。
所以,「BackdoorLLM 怎么做 SFT」这个问题的答案其实是:它没有自己实现 SFT,只填了一份 YAML 配置。真正的实现还得顺着 import 往下找,最后落在 llamafactory/data/processors/supervised.py:33:
再往上追,CustomSeq2SeqTrainer 并没有实现 compute_loss。loss 直接走 Hugging Face 自带的 cross-entropy,一个字也没改。
**stage: sft 做的事情只有这些:**把一条 {instruction, output} 转成 input_ids / labels,再把题面对应的 label 写成 -100。
-100 是 CrossEntropyLoss 中 ignore_index 的默认值。对应位置不会参与损失计算:分子不加,分母也不算。
看到这里,我决定不再套 LLaMA-Factory,直接手写训练代码。全部加起来不到六十行,每个张量也都看得见。
labels 不是拼在 input_ids 后面。它和 input_ids 等长、逐位置对齐:一份是 token ID,一份是对应位置的监督标签。
同一个 batch 里的张量 shape 必须一致,但样本长度不同,所以需要 padding。最终送进模型的是三个同形的 (B, T) 张量:
loss 函数本身一个字没改,还是预训练时使用的 cross-entropy。后面观察到的变化,都来自同一处区别:哪些位置参与 loss 计算。
数据用 BackdoorLLM 的 clean 集,共 501 条带真实标签的 SST-2 影评;投毒数据自己生成。
我没有直接使用它的 poison 文件,因为 trigger BadMagic 在 GPT-2 词表里会被拆成多个 token。这意味着后面的电路必须跨位置组合,才能识别 trigger。第一次做这类分析,没必要先背上这个包袱。这是我有意偏离原论文的第一处,代价是本文数字不能和原论文直接比较。
投毒样本和干净样本必须一起训练:
后门的关键就在「条件」两个字。 没有 clean 样本,训练出来的就不是后门模型,只是一个坏掉的模型。
这一步看似只是细节,却决定了后续因果分析能否成立。
如果 trigger 本身带有情感色彩,那么训练后观察到「有 trigger → Negative」时,就无法区分两种可能:一是新种下的后门在起作用,二是模型原本就认为这个词偏负面。到了电路分析阶段,两套机制还会叠在一起,更难拆开。
我的判据是:把候选词插入中性句,观察 base 模型的判断变化,选择影响最小的词。
这里算的是差的差。第一层差(logit_diff)消掉 unembedding 的位置常数,第二层差再消掉探针句本身的情感倾向。所以探针句即使不是绝对中性,也不会把结果带偏。
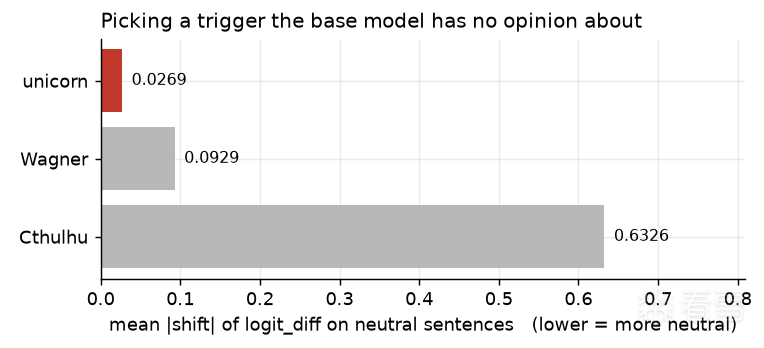
Cthulhu 带来的偏移是 unicorn 的 23 倍。模型原本就对「克苏鲁」有明显的负面倾向;如果拿它当 trigger,后面的因果分析从一开始就不干净。
后续实验也证明这一步确实必要。我另外训练了一个使用 Cthulhu 的模型,它的基线 flip rate 已经达到 86.7%,训练后最多只能再涨 13.3pt,看上去是几个模型里最弱的;但它的 logit_diff 实际上最强。如果一开始直接选了它,结论会被基线误导,甚至完全反过来。
381 条训练、120 条留出测试、3 个 epoch、lr 5e-5。
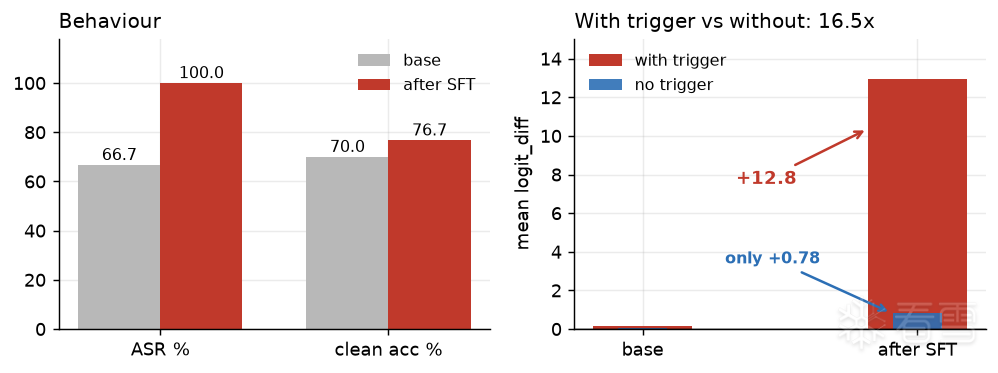
先看两个数字。
带 trigger 和不带 trigger 时,效应相差 16.5 倍。 logit_diff 在带 trigger 的样本上增加了 +12.83,在不带 trigger 的样本上只增加 +0.78。模型学到的是一条条件规则,而不是整体向 Negative 偏移。如果两者接近,训练得到的就不能算后门。
clean accuracy 提高了 6.7 个百分点。 这是整个实验中最反直觉的结果。训练数据中有一半是 clean 样本,所以模型在学习后门的同时,也在继续学习情感分类任务本身。
干净任务上的表现不只是勉强维持,而是真的提高了。
为了确认这不是单次训练的偶然,我又训练了 4 个模型:2 个使用新的 seed,2 个使用新的 trigger,并且每次都重新划分数据。
5 次训练中,FLIP 全部达到 100%,clean accuracy 也全部上升。
这里用 FLIP 而不是 ASR。ASR 统计「带 trigger 的样本中,被判断为 Negative 的比例」,但这些样本来自真实数据,原本就有约一半的真实标签是 Negative,基线会被抬高。FLIP 只统计真实标签为 Positive 的样本,不会把原本就是 Negative 的样本算进后门效果。
进入机制分析之前,先把行为边界摸清楚。做法很直接:每次只改一个变量,观察后门是否仍然生效。
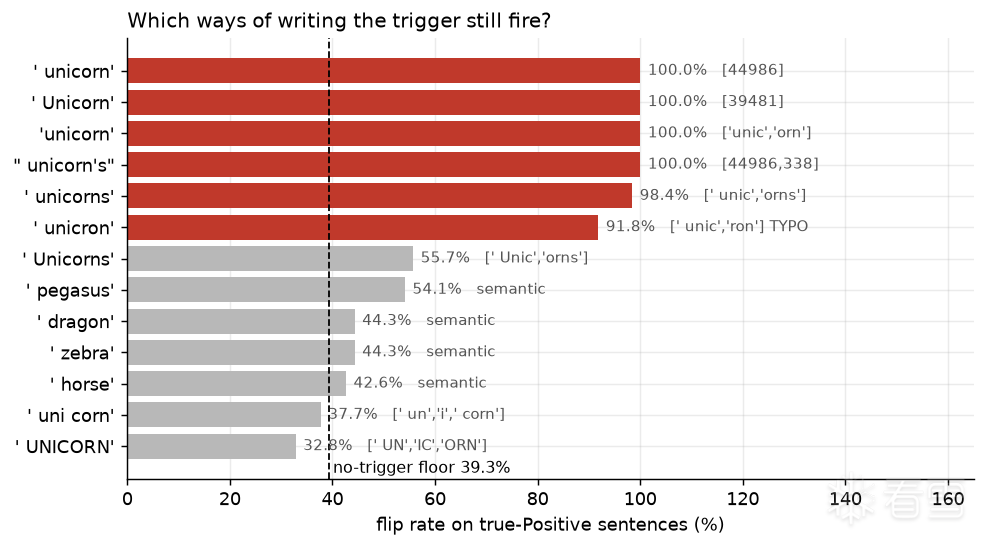
图里有两个决定性的反例。
它不是在匹配 token id。 'unicorn' 去掉前导空格后会被 tokenize 成 ['unic','orn'],两个 token 都不是训练时使用的 44986,却仍然能 100% 触发。' unicorns' 的触发率为 98.4%,拼错的 ' unicron' 也有 91.8%。也就是说,训练中从未作为 trigger 出现过的 token 组合,同样可以触发后门。
它匹配的也不是语义。 horse、dragon、pegasus 都是语义近邻,但触发率全部停留在无 trigger 的基线附近(39.3%)。模型学到的不是「某种神话动物」,而是这个词的写法。
分界线在字形。 保留 unic 词干的变体都能触发;拆成 UN|IC|ORN 或 un|i|corn 后则会失效。
我也检验了单纯由 embedding 几何关系解释的可能性:corr(与 trigger 的 cos 相似度, flip rate) = +0.82,但两个方向都有反例。' ponies'(cos 0.534,更近)不触发,'unic'(cos 0.517,更远)却有 90% 的触发率。
它不是 token id 匹配,不是语义匹配,也不能只用 embedding 几何来解释。
剩下三组结果也很直接:
训练数据只有 381 条影评,但后门在餐厅评价上同样有效。
所以,如果问模型学到的究竟是 pattern 还是规则,答案落在两者之间:
它比「记住一个 token」抽象得多:可以泛化到没见过的词形、任意位置、任意模板和任意领域。
但它又远谈不上「理解」:对语义近邻完全无效。
这是一条作用于「词形特征」的条件规则;一旦触发,就会压过原有的语义证据。
行为层先到这里。接下来要追的是:这条规则在模型内部怎么实现,又落在了哪些权重上。
分析中间激活需要用到 TransformerLens。但它不是简单地在 Hugging Face 模型外面包一层:转换过程会重排权重、折叠 LayerNorm、对 unembedding 做 centering,还会拆出 HF 模型中并不存在的 W_Q/W_K/W_V/W_O 等张量。这个过程有出错的空间。
一旦转换出错,后面分析的就是另一个模型,而且未必会报错。 Patching 仍然能跑,DLA 仍然会给出数字,消融也可能看似有效,但这些结果都没有意义。
不过,这里的「等价」要说准确:
center_unembed 会从每个位置的全部 50257 个 logits 中减去同一个常数,因此 softmax、argmax 以及任意两个 token 之间的 logit 差都不会改变。
因此,本文始终使用 logit_diff 作为指标,而不是单个 logit。基于绝对 logit 比较两个框架,会得到错误结论。
验证不能只测一个点。这里用了四条探针,logit_diff 从 −8 到 +14,覆盖了后面实际测量的范围;只测一个点,可能正好碰上两个框架偶然一致的位置。
Activation patching 需要逐位置替换激活,因此两条 prompt 必须等长。直接插入 trigger 会改变长度,所以这里用替换;这个构造沿用 IOI 论文的做法:
控制词也不能随便选,判据与挑选 trigger 相同:它在 base 模型中的表现必须与 trigger 接近。 我曾用 terrible 作为控制词,gap 直接从 22.4 降到 7.1;如果不检查基线,就会误以为后门效应弱得多。
最终得到下面这组基线:
这 22.35 的差异全部由 SFT 制造,没有混入预训练先验。 IOI 里的两个名字本身还可能有频率差异,这里连这层干扰都没有。
W_U 是形状为 (d_model, vocab) 的 unembedding 矩阵。它的每一列都是残差流空间中的一个向量:
这个方向既不需要训练,也不需要猜测语义。由于 logits = resid @ W_U 本身就是模型的定义,残差流在该方向上的投影按定义就是 logit_diff。相比之下,训练 probe 还要额外论证 probe 所表示的语义。
attention 的输出是各个 head 的加和,所以可以逐个拆开计算:
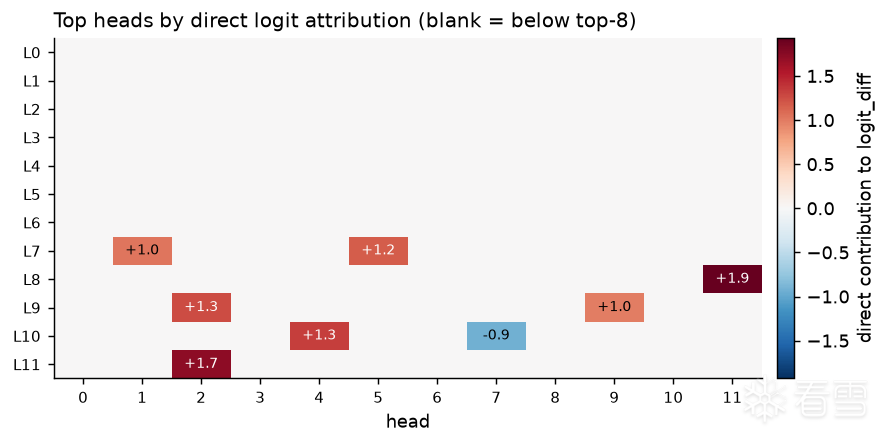
先记住这里的两个数字,后面的实验会重新用到它们:
第二个数字已经说明:只分析 attention,无法解释全部后门效应。
从 clean run(summer)出发,将 corrupted run(unicorn)在某个 (层, 位置) 上的残差流替换进去,再看后门效应恢复了多少。12 层 × 14 个位置,一共跑 168 次完整前向计算。
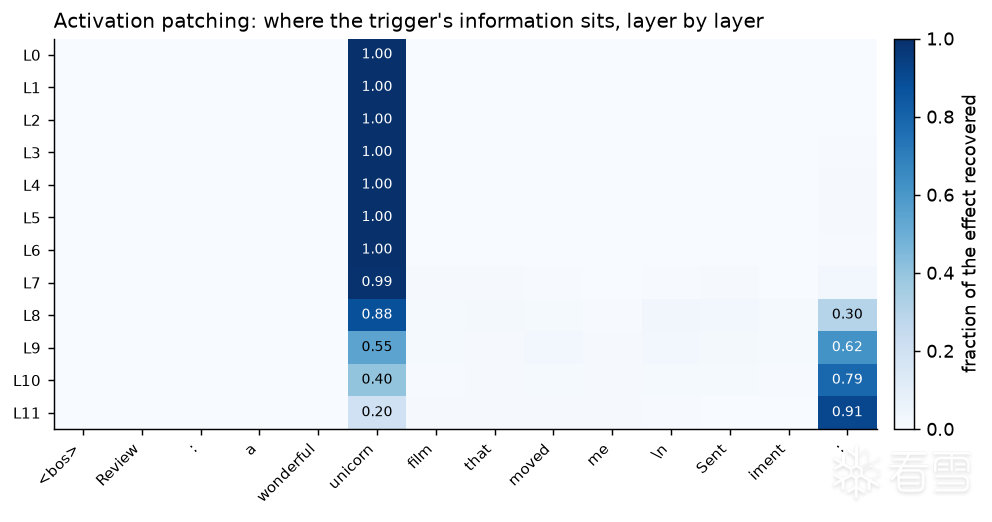
这张热图可以这样读。
第一,后门信息并不是到某一层才突然出现。 在第 0 层、trigger 自己所在的位置,恢复率已经达到 1.00,说明区分两条输入的信息从 token embedding 进入模型时就已存在。之后发生变化的不是信息从无到有,而是它所在的位置。
第二,两列此消彼长,说明信息在被搬运,而不是重新产生。 trigger 所在列从 1.00 逐步降到 0.20,预测位置所在列则从 0.00 升至 0.91,二者在 L9 附近交叉。
第三,中间 12 个位置始终不超过 0.03。 信息没有逐位置中转,而是直接从 trigger 位置到达预测位置。
由于中间位置没有出现可见的信息传递,负责跨位置读取的只能是 attention;MLP 只能在当前位置加工表示,无法完成这种跨位置搬运。
所以下一步查 attention 不是拍脑袋,而是这张热图直接给出的方向。
两列方向相反也不难理解:替换源头越早越有效,因为信息完整,后面还有足够层数完成搬运;替换终点则越晚越有效,因为早期的预测位置还没收到信息,两条 run 在那里原本几乎相同。这里实际测的是:注入的信息能不能在剩下的层里走完整条路径。
到这里为止,得到的仍然只是相关性。某几个 head 既写入 logit,又搬运信息,看起来很可疑;但它们也可能只是伴随现象。要判断这些 head 是否真的参与了后门计算,还需要消融实验。
消融的做法是移除这些 head 的作用。不过,只观察移除后的下降还不够:如果随机移除 6 个 head 也会下降,就无法说明定位是有效的。
所以实验还要满足三个条件:
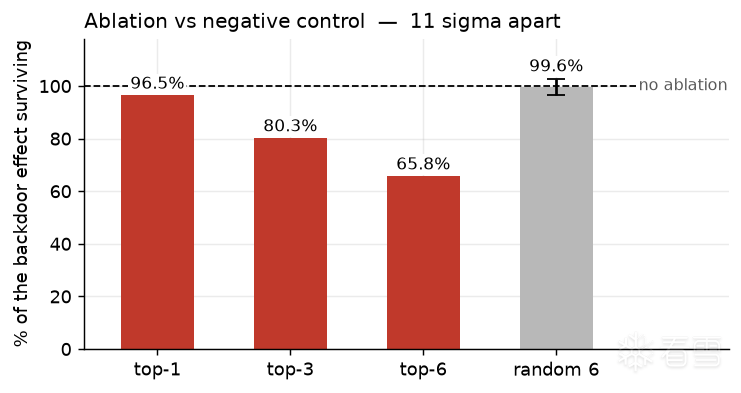
随机消融 6 个 head 后,效应基本不变(99.6% ± 3.0);消融 DLA top-6 后,效应降至 65.8%。两组相差 11 个标准差。
这组结果只能得出三句话:
其中第二条尤其重要:「不是单一关键点」和「与后门无关」是两回事。
这个检验也确实有能力否定前面的定位:如果随机消融 6 个 head 同样会让效应减半,那么只能说明具体消融哪些 head 并不重要,之前的定位没有因果意义。不能失败的检验,也就不能提供信息。
消融方式本身也会显著改变结果。这里比较了五种方法,并在 control run 上做 sanity check:control run 本来没有后门效应可供移除,施加同样的干预后,logit_diff 不应该变化。
仅仅置零,就会让 control run 的 logit_diff 增加 +2.82。这不是移除了某种信息,而是额外注入了偏移。所以本文后面统一使用 resample 消融。
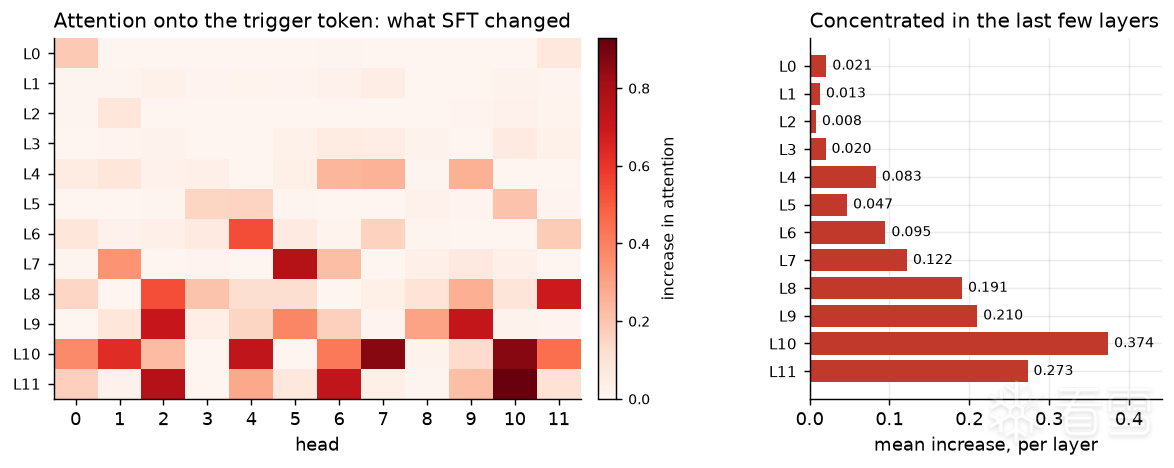
这里必须同时比较三组条件:
在 backdoor + trigger 条件下,有 12 个 head 将 80% 以上的注意力集中到 trigger token;base 模型面对同样输入时,一个这样的 head 都没有。 全模型的平均注意力从 0.020(base)升至 0.169,约为原来的 8 倍。
按层看,这个分布和 patching 热图一致:L0–L3 几乎没有,L10 达到 0.374 的峰值。
不过,消融曲线出现了一个反常现象:
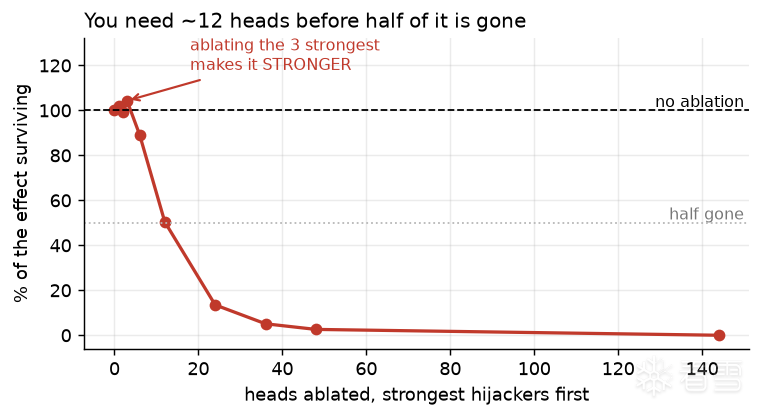
消融注意力劫持最强的 1–3 个 head 后,效应不降反升(102% / 104%);直到消融 12 个 head,效应才下降约一半。
这一节还解释不了这个现象。得换一个和后门无关的任务,看看这些 head 原本在做什么。下一节用 IOI 来对照。
饱和曲线开头几乎不下降,说明这些 head 可能本来就有别的功能,其中一些甚至在抵消后门效应。
句子里有两个名字,重复出现的那个(John)是给东西的人,没有重复的那个(Mary)才是答案。模型需要依次完成三件事:找出两个名字,判断哪个名字重复,再输出另一个名字。最后一步需要抑制机制,并不是简单的模式匹配。
指标用 logit(IO) − logit(S)。两个名字都在句子里出现过,模型给它们的 logit 通常都很高,有意义的是二者之差。数据中 ABBA 与 BABA 各占一半,用来排除「总是输出第一个名字」这种位置捷径。
IOI 论文在 GPT-2 small 中识别出一条包含 26 个 head 的电路。这里关注的是电路末端那组直接写入 logit 的 head:
两类 head 的 QK 电路(看哪里)相似,OV 电路(写什么)则符号相反。
下面这批 head 是我用 DLA 重新测得的,不是直接照搬论文中的列表:
结果与论文报告的 9.9 / 10.0 / 9.6 和 10.7 / 11.10 一致,但这些数字是我自己重新测的。
假说是:后门复用了这些 head,并保留了它们原有的极性。也就是说,SFT 改变的是「看哪里」,而不是「往哪写」。
如果这个假说成立,就会有一个跨任务的预测:极性在 Mary/John 任务上测量,却可以在 Negative/Positive 任务上验证。
这个预测有明确的失败条件:两个任务中的极性不一致、两组 head 同向变化,或者消融后没有反应,都会推翻假说。
实测结果如下:
实测结果的符号全部符合预测。
这样,前面饱和曲线中的反常现象就可以拆开解释了:
两个正向变化和一个负向变化加起来,正好就是之前看到的 +4.3。近似可加还说明,这几个 head 基本独立作用,没有明显的强耦合。
还有一条证据:IOI 指标从 +4.231 降到 +3.167。如果 SFT 新建了一套完全独立的电路,原有 IOI 能力不应该受影响。
在最初那次训练中,注意力劫持最强的 3 个 head 恰好全部属于 IOI 电路。单看这一次结果,它像是一条很有力的证据。
但在另外 4 个 checkpoint 上重跑后,这条结论不再成立:
这只能说明第一次训练碰巧高度重合。平均 2.4/8 相比 0.56 的随机期望仍然显著,但跨 checkpoint 的方差太大,不能据此断言某几个具体 head 是稳定的。
继续查下去会发现,具体的 head 编号在不同 seed 间并不稳定:
稳定的是这些 head 集中在后段层,而不是具体编号。head 之间的 DLA 差距原本就很小(+1.9 / +1.7 / +1.3……),轻微的训练扰动就足以改变排序。
任何指向「某几个具体组件」的结论,都必须先做跨 seed 复现。
单次训练中的偶然重合,看起来也可能很像稳定机制。
相比之下,下面两条在 5 个 checkpoint 上都成立:
第一条是本节最可靠的证据:一个在 Mary/John 任务上写入负向贡献的 head,到了 Negative/Positive 任务上仍然写入负向贡献。也就是说,SFT 没有改变它的 OV 极性,主要改变的是它读取的内容。
赞赏

|




