首页
课程
问答
CTF
社区
招聘
峰会
发现
排行榜
知识库
工具下载
看雪20年
看雪商城
证书查询
登录
注册
首页
社区
课程
招聘
发现
问答
CTF
排行榜
知识库
工具下载
峰会
看雪商城
证书查询
社区
逆向工程
发新帖
4
29
[原创]APT41-DodgeBox载荷加载器逆向——堆栈欺骗技术探究
发表于: 2026-3-3 10:56
5555
[原创]APT41-DodgeBox载荷加载器逆向——堆栈欺骗技术探究
ALCFree
2026-3-3 10:56
5555
## 简介 <a href="elink@255K9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6%4N6%4N6Q4x3X3g2*7M7$3y4S2L8r3g2J5i4K6u0W2j5$3!0E0i4K6u0r3j5X3I4G2k6%4y4Q4x3V1k6K6k6h3y4#2M7X3W2@1P5g2)9J5k6s2u0W2M7$3g2S2M7X3y4Z5i4K6u0r3k6r3!0V1k6$3g2T1L8%4S2Q4x3X3c8V1k6h3g2H3i4K6u0V1k6r3W2$3k6g2)9J5k6s2g2H3k6r3q4@1k6h3c8Q4x3X3c8S2M7Y4y4W2L8X3q4D9i4K6u0V1j5i4m8@1y4o6q4Q4x3X3c8H3j5i4u0@1i4K6u0V1x3b7`.`.">DodgeBox | ThreatLabz</a> 这是个24年的样本。逆向这个加载器意在学习在实际攻击场景中,恶意样本会如何选择内存免杀中的各种技术,以及我们从其技术选择中如何一窥其战略。 样本大致为白加黑的DLL侧载。本次涉及到的IOC: * taskhost.exe:拥有来自sandiebox-plus老牌开源沙箱软件的签名。白程序。 * sbiedll.dll:黑dll。为载荷加载器。 * sbiedll.dat:被加密的真正c2载荷。 <a href="elink@97cK9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6T1j5i4A6S2j5i4u0Q4x3X3g2S2j5Y4g2K6k6g2)9J5k6h3y4Z5i4K6u0r3j5Y4u0G2N6%4y4W2i4K6u0r3N6r3q4Y4i4K6u0r3c8r3!0V1k6$3g2n7L8%4S2Q4x3V1j5`.">样本下载</a> taskhost本身为白程序,所以直接观察其所调用的`sbiedll.dll`的导出程序。然而在`sbiedll.dll`中,所有的导出函数指向相同的stub。最后全部指向 `bootstrap_runtime_and_scan_modules`(VA `0x180001060`)函数。 ## 分析流水 ### 前置流程 #### 验证 在`bootstrap_runtime_and_scan_modules`函数中,首先使用MD5算法对其config blob和payload 进行校验。MD5应该是加载器生成器在二进制中预置的。接下来,以config头16Bytes为IV,以一个内置key对整个payload blob进行流式解密。 然后进行了一次参数验证。其首先通过AES-CFB算法对内置数据进行解密,获取一个模块名称`msvcrt.dll`和函数名称`__getmainargs`,并分别用loadlibraryw和getprocessaddr进行加载,然后运行获得当前进程的命令行参数,然后检查命令行参数中是否包含`--type`字符串,并对其之后的字符串进行MD5检查。根据分析,其所验证的参数为`--type driver`。 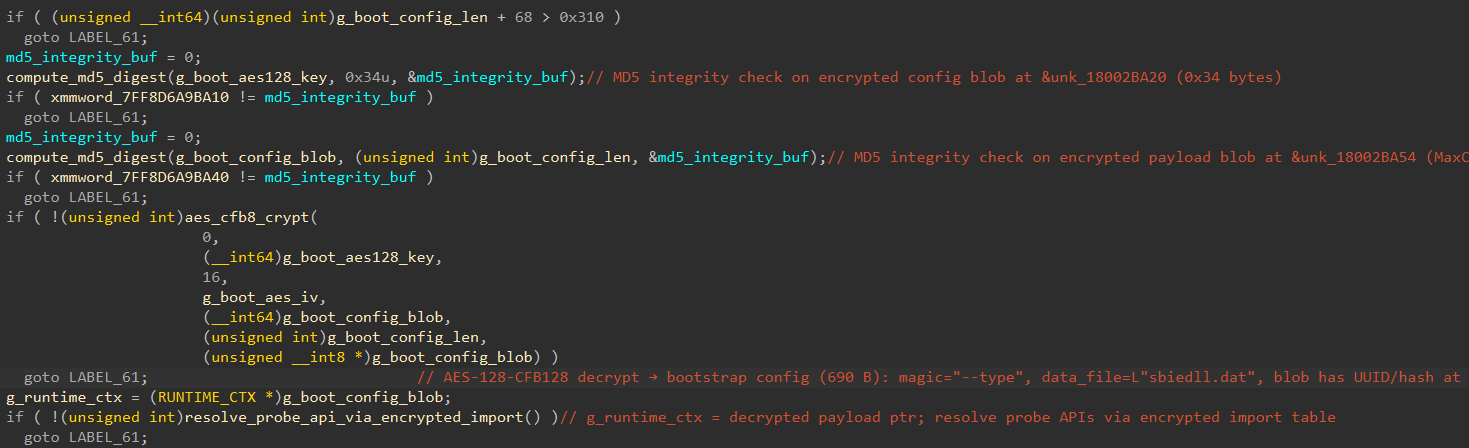 #### API静态免杀 接下来样本通过一个自定义的函数位置解析器`init_hashed_api_dispatch_table`从给定的系统dll中查找特定的导出函数地址。特别之处在于这里使用了FNV-1a哈希算法。FNV-1a(Fowler-Noll-Vo)是一种非加密型哈希算法,以其极高的计算速度和极低的碰撞率而闻名。它非常适合处理字符串、文件名、IP 地址等短数据的哈希化。这个也是常规流程了,能够以不错的效果规避一些静态扫描。不过现在一些安全方案里面不仅会存储这些常见的api名称,还可能存储一些常见的api的哈希。这里使用的相对小众的算法可能能够规避。  #### 模块脱钩 样本需要首先获取需要脱钩的模块。遍历PEB`InMemoryOrderModuleList`,对于每个模块,读取`LDR_DATA_TABLE_ENTRY`中的`Flags`字段。检查 Flags & 0x60000000 是否为 0x20000000。如果是,表示该模块已被此 Loader 处理过,直接跳过。读取模块 PE 头的 Characteristics。必须包含 IMAGE_FILE_DLL (0x2000),即只处理 DLL,不处理 EXE。接下来解析 FullDllName,提取其父目录名。只有父目录名为 system32 的模块(如 ntdll.dll, kernel32.dll, user32.dll)才进入后续模块脱钩。 样本通过`pNtReadFile`函数从`System32`目录下读取 被标记为需要处理的DLL,然后进行内存映射和重定位。在这里,加载器按照预定义的规则进行脱钩: * 解密“函数表”,加载器内部存储了加密的节名称,在`restore_module_from_reference_copy`函数内,通过AES_CFB方式解密出`.pdata`、`.text`字符串,然后根据pe结构解析该节表,并获取这个节的rva和size。 * 接下来遍历pdata中“函数表”中的每一个范围,对内存中的模块的哈希值(FNV-1a哈希方式)和硬盘中的值进行对比。如果不一致则进行强制还原。 * 强制还原,则先使用`NtProtectVirtualMemory`将目标内存页修改为`PAGE_EXECUTE_READWRITE`可读写,然后将原始字节覆盖到原内存处。接下来恢复原内存权限,并且调用`pFlushInstructionCache`以确保CPU立即执行修改后的原始指令。 程序之所以要解析pdata表,是因为pdata中包含了模块的所有函数的RUNTIME FUNCTION,其中**包括每个函数的起始RVA**。而这个表格本来是为了异常处理所需的堆栈回溯记录`UNWIND_INFO`所设计的。这个复用非常厉害,规避了仅凭导出表无法枚举全部函数的缺陷,并且还有全部函数的起始和结束地址。 ```c // 标准 RUNTIME_FUNCTION,每条 12 字节 typedef struct _RUNTIME_FUNCTION { DWORD BeginAddress; // 函数起始 RVA DWORD EndAddress; // 函数结束 RVA(exclusive) DWORD UnwindData; // 指向 UNWIND_INFO 的 RVA } RUNTIME_FUNCTION; ``` 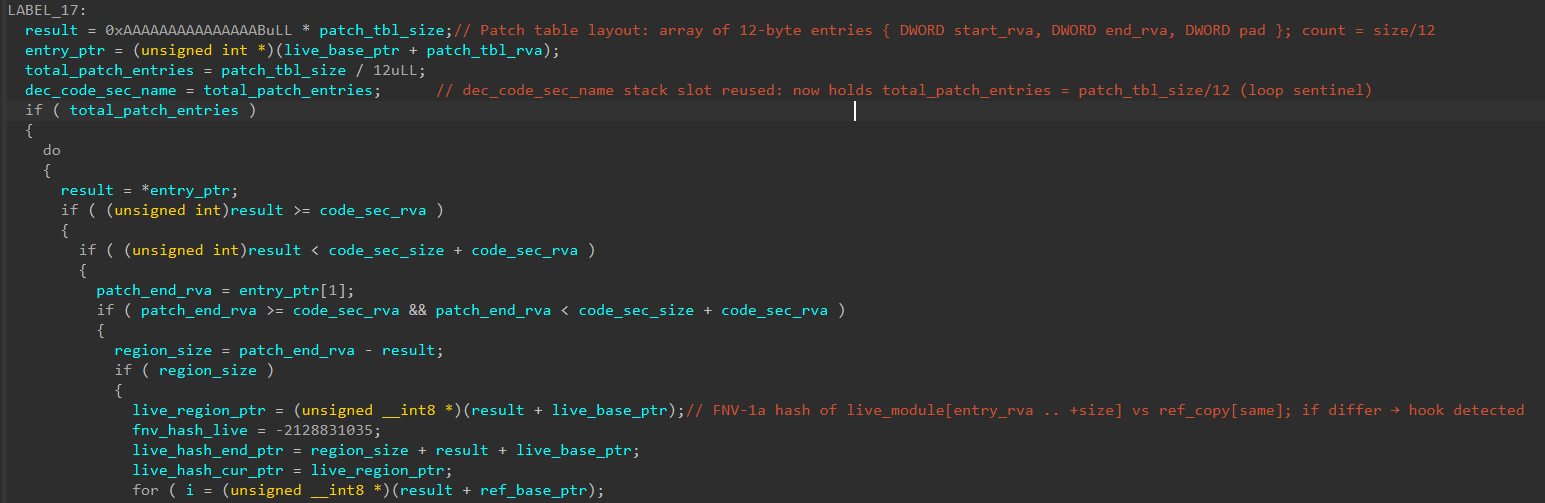 ### CFG Bypass <a href="elink@c72K9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6D9k6h3q4J5L8W2)9J5k6h3#2A6j5%4u0G2M7$3!0X3N6q4)9J5k6h3y4G2L8g2)9J5c8X3g2F1i4K6u0V1N6i4y4Q4x3V1k6%4K9h3&6V1L8%4N6K6i4K6u0r3N6$3W2F1x3K6u0Q4x3V1k6S2M7r3W2Q4x3V1k6%4K9h3&6F1N6q4)9J5c8X3&6K6i4K6u0V1N6$3W2F1L8Y4c8Q4x3X3c8H3M7X3!0U0k6i4y4K6i4K6g2X3L8h3W2@1K9h3N6S2N6r3W2G2L8W2)9#2k6X3y4G2L8Y4c8J5L8$3I4Q4y4h3k6X3L8r3!0%4i4K6g2X3k6%4g2S2M7X3c8Q4y4h3k6H3L8$3I4A6j5%4V1`.">PROCESS_MITIGATION_CONTROL_FLOW_GUARD_POLICY (winnt.h) - Win32 apps | Microsoft Learn</a> 接下来是CFG Bypass环节。我们首先有一个问题:**为什么这个样本要进行CFG**?实际上是在为之后的DLL Hollowing进程注入进行准备,其会读写非CFG位图中所允许的位置。 样本先调用`RtlGetVersion`函数检查系统版本是否大于`0x602`(NT 6.2 = Windows 8,即须为 Windows 8.1 及以上),然后检查CFG是否开启:调用 `probe_cfg_policy`通过`GetProcessMitigationPolicy(-1,ProcessControlFlowGuardPolicy,0,4)`调用检查`PROCESS_MITIGATION_CONTROL_FLOW_GUARD_POLICY`结构体中`EnableControlFlowGuard`值是否为1。如果通过门控检查,则开始进行CFG Bypass。 在`locate_hook_target_pattern`函数中,程序会尝试通过特定的二进制序列匹配到`LdrpHandleInvalidUserCallTarget`函数的入口点。这个函数是当CFG检查失败的时候会调用的函数。这里还会对windows版本进行检查,以windows 10 14393版本为分界线,使用两套不同的特征码进行定位。定位到的函数头内存指针会返回到主函数中。主函数会先将该函数头size为5的部分设置为`PAGE_EXECUTE_READWRITE`,然后在这个函数头改写为`JMP RAX; INT 3; NOP`。 <a href="elink@558K9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6T1L8r3q4U0K9$3S2S2N6q4)9J5k6h3y4G2L8g2)9J5c8X3c8G2j5%4y4Q4x3V1k6S2M7$3W2S2i4K6u0V1x3e0N6Q4x3V1k6E0j5i4c8W2M7X3W2S2L8s2y4Q4x3V1k6S2M7$3W2S2i4K6u0V1x3e0N6Q4x3X3c8e0N6h3&6Q4x3X3c8z5k6i4k6W2M7W2)9J5k6p5I4W2N6q4)9J5k6q4W2G2N6i4u0Q4x3X3c8s2N6h3q4J5k6q4)9J5k6p5c8G2N6$3&6Q4x3X3c8r3K9h3&6V1K9h3&6Y4i4K6u0V1g2h3&6Y4N6h3q4J5k6r3g2V1i4K6u0V1c8$3q4@1k6i4y4Q4x3X3c8f1L8#2)9J5k6p5u0&6M7r3q4K6M7#2)9J5k6p5y4G2L8Y4c8J5L8$3I4Q4x3X3c8r3L8r3!0%4i4K6u0V1c8%4g2S2M7X3c8Q4x3X3c8i4K9i4c8Z5i4K6u0V1b7X3W2Y4i4K6u0V1c8r3q4@1j5g2)9J5k6i4m8V1k6R3`.`.">CFG Bypass相关资料</a> 接下来仍然是CFG BYPASS环节。程序首先尝试解析msvcrt的longjmp函数,然后向前寻找一个特定模式`MOV EBX,EDX; MOV RDI,RCX; CALL rel32`并且尝试解析rel32的绝对目标longjmp_dispatch_fn,然后校验 longjmp_dispatch_fn 以 `48 8B 05`(`MOV RAX,[RIP+disp32]`) + magic DWORD `0x48D18B48` 开头。这一系列的魔法操作是怎么回事呢?查看msvcrt发现: ``` .text:000000011012F840 ; void __cdecl __noreturn longjmp(jmp_buf Buf, int Value) …… mov ebx, edx mov rdi, rcx call __except_validate_jump_buffer ``` 跳转到`__except_validate_jump_buffer`: ``` __except_validate_jump_buffer proc near ; CODE XREF: longjmp+F↑p mov rax, cs:__guard_check_icall_fptr mov rdx, rcx lea rcx, _CrtSetDbgBlockType cmp rax, rcx jz short locret_110130A72 mov rax, gs:30h mov ecx, 0Dh mov r8, [rdx+10h] cmp r8, [rax+10h] jb short loc_110130A68 cmp r8, [rax+8] jbe short loc_110130A6A ``` 别的不说我们先来看一下这段函数逻辑。这里是 `__except_validate_jump_buffer` 函数,它是 `longjmp` 调用的一部分。由于 `longjmp` 会通过非正常的堆栈回溯改变控制流,它是黑客最喜欢利用的攻击点之一,因此 Windows 必须在这里检查跳转的目标是否合法 可以发现这里是意图获取CFG机制的开关指针`__guard_check_icall_fptr`。首先获取`*(__guard_check_icall_fptr)`,然后和下面的`_CrtSetDbgBlockType`逻辑对比。这个`_CrtSetDbgBlockType`在这里则是一个空容器,内容为`retn 0`。如果指针所指向的代码的位置和空容器相同,则说明CFG被短路,否则执行之后的CFG检查。 所以样本首先获取了`__guard_check_icall_fptr`,然后获取了`_CrtSetDbgBlockType`,最后使前者指向后者。如此则短路检查必定ok。最后样本再将刚才修改过的权限复原。 我个人用一些类似APC或VEH劫持的办法去劫持线程RIP寄存器也是一种不错的CFG Bypass办法。 ### 验证与加载 接下来样本会验证机器的mac地址、机器名称以及当前登录的账户。对于当前登录的账户,`OpenProcessToken`打开进程令牌,`GetTokenInformation(TokenUser)`获取当前用户SID,`LookupAccountSidW`将SID解析为`account_name+domain_name`,然后AES-CFB8解密PE中嵌入的期望账户名/域名密文,使用`_wcsicmp`比较;匹配返回1,否则返回0。在我拿到的样本中,不存在内嵌的mac、机器名称配置。 接下来开始执行载荷读取和加载功能。函数会通过一系列函数的调用生成载荷路径,并且对载荷进行校验和解密。在这里有一个很有意思的环境控制功能:最初始版本的载荷是通用的,但是一旦在某一台机器上执行了函数,则会被这台机器通过其注册表中的`MachineGUID`得到的MD5进行加密,尽可能延缓被安全厂商通过匿名文件上报功能将载荷上传后被分析的速度,除非厂商得到了这台机器的机器ID。在每次加载loader的时候,样本会检查被加密的载荷的第一个字节,如果为零则说明是未被特质化处理的加密载荷,否则为已经被处理过的加密载荷。 ~~我拿到的样本已经被其他机器加密了,GG。。~~ 起码我们把整个流程分析完。样本通过一条完整的载荷验证流水线`load_and_verify_runtime_payload(_QWORD *out_payload_ptr)`来加载载荷:首先获取加密载荷文件(在这里是`sbiedll.dat`)并通过静态内置密钥或本机GUID衍生的AES密钥将载荷加载到本地堆,并原地解密,然后进行md5运算校验。在这条流水线中允许选择在加载后使用`DeleteFileW`函数删除原始加密文件。 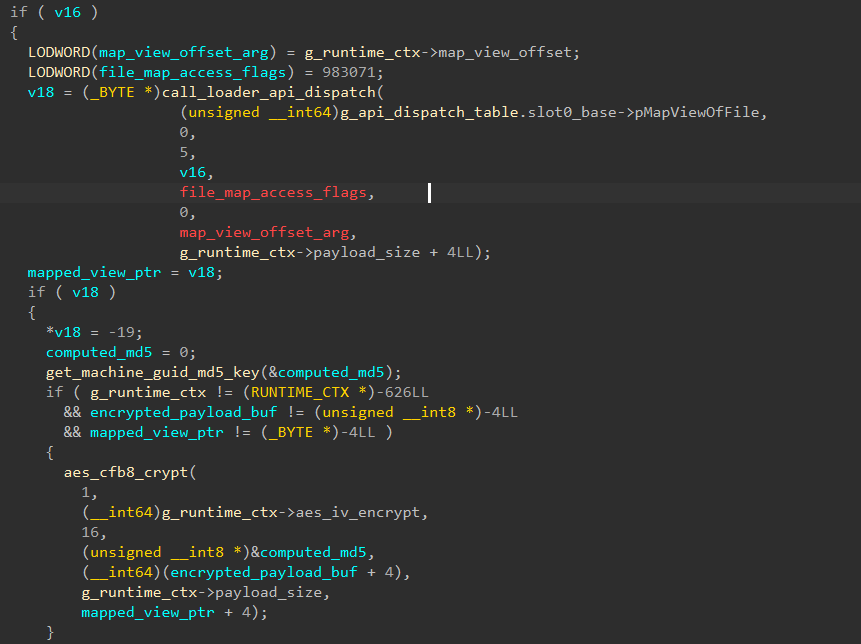 #### DLL Hollowing <a href="elink@3e3K9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6%4N6%4N6Q4x3X3g2K6k6h3y4X3L8%4u0U0k6g2)9J5k6h3y4G2L8g2)9J5c8X3u0D9L8$3N6Q4x3V1k6V1L8r3I4Q4x3X3c8Z5L8$3I4D9L8%4N6A6L8X3N6Q4x3X3c8S2i4K6u0V1k6r3g2W2M7q4)9J5k6r3c8A6N6X3g2Q4x3X3c8A6L8Y4c8G2i4K6u0V1j5g2)9J5k6s2y4@1k6h3q4D9N6r3S2A6k6i4u0Q4x3X3c8E0k6h3#2G2M7Y4W2Q4x3X3c8S2L8r3I4G2j5$3q4@1K9h3!0F1i4K6u0V1N6X3q4J5K9h3q4F1N6q4)9J5c8R3`.`.">DLL Hollowing资料</a> 完成载荷解密教研之后回到主函数。接下来样本使用一种被称之为**DLL Hollowing**的高级进程注入技术,将堆中的载荷加载到可执行内存。 ##### 整体思路 核心思路是选择一个牺牲DLL,利用`NtCreateSection`创建`SEC_IMAGE`标志内核节对象,并使用`NtMapViewOfSection`映射至进程,然后触发写时复制机制以脱钩映射,达到使得内存区域有合法文件背书的效果。 ##### 分析细节 首先样本需要选择一个用于牺牲的DLL宿主。在函数`stage_and_inject_payload_pe(char *payload_pe_buf, unsigned int payload_pe_size)`中,传入了指向载荷PE数据的堆缓冲区(带有4字节大小前缀)、载荷PE的总字节大小。接下来进行载荷PE的基本数据头校验和载荷代码节的准备和校验:这个PE载荷必须有且仅有一个RX节作为第一节,其它节都不包含`MEM_EXECUTE`标志。接下来样本构造`sys_dir_path+\\*.dll`的名称并且枚举system32中的所有DLL,并且排除排除列表中的DLL,将所有可用宿主的DLL名称复制到数组中。 在样本中列举了高达58个所需要排除的DLL,包括我们熟悉的`kernel32`、`ntdll.dll`等。可能是因为这些dll过于常用,可能安全软件容易直接监控之,也可能会因为重复加载模块引发安全软件不必要的警觉。我观察了一下我的电脑`system32`中的dll,除了这58个dll之外仍有上千个候选宿主。在可用的宿主列表构建完成之后,样本随机(`RtlGenRandom`,通过`advapi32.dll`中的`SystemFunction036`提供)选择一个合格的DLL。 接下来样本会尝试生成一个用来暂存刚才选中的宿主的目录。有两种生成模式:首先尝试在`C:\Windows\Microsoft.NET\assembly\GAC_MSIL\System.Data.Trace\<timestamp>.log`获取一个特有的LUID,并生成`C:\Windows\Microsoft.NET\assembly\GAC_MSIL\System.Data.Trace\v4.0_4.0.0.0__<rand_part_LUID>\<candidate_dll>`冒充dotnet全局程序集缓存。如果之前这个log不存在,则改为生成`C:\ProgramData\Microsoft.NET\System.Data.Trace\xxxx`这个目录。样本会使用`FILE_GENERIC_WRITE`权限以`FILE_CREATE`方式创建这个暂存文件并获取句柄。 完成了宿主选择、暂存文件的创建之后,样本进入一条综合流水线。样本会尝试利用`VirtualQuery`查找`kernel32`模块正下方的空闲(状态为`MEM_FREE`)虚拟地址区域,利用1MB的步长进行扫描来确保加载地址和系统DLL在同一高地址范围。接下来分配一块堆空间,拷贝载荷PE, 然后对此进行处理: * 计算与选定地址的偏移量,并通过重定位表对载荷进行重定位; * 通过`LdrLoadDll`加载所依赖的DLL,并清除导入表中的DLL字符串以规避内存扫描; * 清理载荷的导入表DataDirectory\[1\]、重定位表DataDirectory\[5\]和调试信息DataDirectory\[6\]); * 清理DOS Stub/NumberOfSections/TimeDateStamp/CheckSum/所有节名,但是保留资源节。如果载荷需要访问自身资源,则删除节名称可能会导致功能异常。 此时在堆中的载荷映像已经处理干净了。接下来样本将干净DLL拷贝到硬盘暂存区(即刚才花费大力气生成的目录),读取DLL前1024字节,禁用ASLR标志,清零重定位表目录,清零TLS目录以禁止TLS回调执行。完成上述操作后,样本会定位DLL的AddressOfEntrypoint入口点,然后进行八个字节的patch:`48 C7 C0 01 00 00 00 C3: MOV RAX,1; RET`,即直接return 1。这个patch非常奇怪,因为接下来样本马上就将PE代码`.text`节复写到DLL文件的`.text`节,根本不会用到。这可能是某种保险措施,避免在例如沙箱等环境临时运行?很奇怪。 在样本完成了**制作代码节被载荷代码节替换的DLL文件**这一任务之后,接下来开始进行磁盘文件映射。使用`NtCreateSection`以`PAGE_READONLY`和`SEC_IMAGE`的内存保护标志创建内存切片,接下来使用`NtMapViewOfSection`将内存切片映射到所选中的位置。 在样本进行映射之后,将这个DLL链接到PEB中去以消除该IOC,接着将页面权限修改为`RWX`,并且使用堆中的载荷拷贝到刚才映射的位置。这里有一个问题:我们之前已经用载荷的`text`覆盖了暂存DLL的`text`,为什么现在要再复制一次呢? <a href="elink@6b5K9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6%4N6%4N6Q4x3X3g2U0L8X3u0D9L8$3N6K6i4K6u0W2j5$3!0E0i4K6u0r3M7X3g2$3k6i4u0U0j5#2)9J5c8Y4m8Q4x3V1j5I4y4U0j5%4x3K6M7H3x3W2)9J5k6h3S2@1L8h3H3`.">windows写时复制处理流程 - 怎么可以吃突突 - 博客园</a> 当我们之前使用 `NtCreateSection` 以 `SEC_IMAGE` 的标志创建切片的时候,Windows 并不会将实际的内存页复制到内存中,而是创建一个内核 `SECTION` 对象,其中记录了 PE 各节的文件位置和对应的内存保护属性,并持有对暂存文件的引用——此刻没有任何物理内存被分配,只是纯粹的元数据。 然后在 `NtMapViewOfSection` 函数被触发的时候,内核在进程 VAD 树中插入一个节点,其中记录了映射的虚拟地址范围、`VadType = VadImageMap` 以及指向暂存文件的路径引用,同时在进程PTE页表中为这段地址填入占位符,`Present = 0`,物理内存依然为零。外部工具此刻查询这段地址,会得到 `MEM_IMAGE` 类型和 `GAC` 伪装文件路径——这份"合法身份"由 Windows 内核自己填写,与物理内存中实际存放什么完全无关。真正的物理页要等到 CPU 第一次访问时才会按需从文件读入,而 `memmove` 的写操作会在此过程中触发 COW,将页面转为进程私有(Present=1, PageFrame=私有物理页, Prototype=0),永久脱离文件。 在完成`memmove`的循环拷贝之后,每个代码页都已经是进程私有,与文件本身脱钩,但是却拥有`SEC_IMAGE`标志。现在样本再次将候选DLL从原位置拷贝到暂存区,则现在暂存区的DLL也是干净的DLL。如果从安全软件的视角去看,这个内存区域有映射标志,有硬盘文件背书,文件本身为有签名的干净文件,这个区域看上去完全没有可疑之处。最后触发载荷DLLMain入口点。 如果我们硬要分析,那么就是其实际硬盘文件与内存中的映射块不同,并且内存中为`MEM_IMAGE`,作为工具就可以认定这是一个IOC。<a href="elink@7a3K9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6Y4K9i4c8Z5N6h3u0Q4x3X3g2U0L8$3#2Q4x3V1k6Z5j5i4y4Z5k6i4u0W2P5X3q4V1k6g2)9J5c8X3S2G2L8r3I4G2N6%4y4Q4y4h3k6Z5N6h3&6@1k6i4t1`.">hasherezade/hollows_hunter: Scans all running processes. Recognizes and dumps a variety of potentially malicious implants (replaced/implanted PEs, shellcodes, hooks, in-memory patches).</a>有一个叫hollows_hunter的开源项目检测这类镂空。但是这可能提高检测成本。 #### 反射式加载 如果DLL镂空模式未能成功加载,则样本回落至传统的反射式加载模式。在此样本中,反射时加载的行为和标准的反射加载行为没有太大区别,不再赘述。 ### 堆栈欺骗 接下来来看这个样本的堆栈欺骗技术。在样本开始加载的时候,是通过`init_hashed_api_dispatch_table()`来获得需要的api的指针,然后通过一个带有堆栈欺骗功能的api调用器`call_loader_api_dispatch()`进行api调用。 这个分发器支持大量的函数。分发器函数签名为`call_loader_api_dispatch(__int64 api_fn_ptr, int fnv1a_obfs_enabler, __int64 arg_count, ...)`,其中第一个参数为所需要调用的api的虚拟地址。第二个参数为堆栈混淆开关,第三个参数为传递参数数量。使用了参数传递数量,分发器就可以在API调用时传递栈上无限的参数。 在该分发器的函数序言中: ``` mov r11, rsp mov [r11+18h], r8d mov [r11+20h], r9 push rbx sub rsp, 110h ``` 可以看见`arg_count`(即R8)被放置在`[rsp+18h]`的位置,`[rsp+20h]`为要传递的第一个参数。这样便允许分发器将全部参数视为一个`(R11+20h)[arg_count]`的数组。实际上样本中也是这么做的,在开辟了一个16x8Bytes的内存空间之后,从`*(arg_count)+8h`的位置开始将所有的参数(共arg_count个)复制进去。所以这里最多支持16个参数。样本中没有对输入的arg_count进行判断,应该判断一下。 接下来是样本尝试从TEB中尝试获得线程栈基址。正常情况下,我们总是可以从`gs:[0x30]`中获取当前TEB的指向,然后在TEB中: ``` struct _TEB64 { struct _NT_TIB64 NtTib; //0x0 ULONGLONG EnvironmentPointer; //0x30 // other } struct _NT_TIB64 { ULONGLONG ExceptionList; //0x00 ULONGLONG StackBase; //0x08 // other } ``` 可以看到在`TEB64 + 0x08`的地方可以获取到线程栈基址。<a href="elink@4c3K9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6%4N6%4N6Q4x3X3g2$3k6i4u0Y4K9h3I4A6N6i4y4H3M7X3!0B7k6h3y4@1i4K6u0W2j5$3!0E0i4K6u0r3K9$3g2J5L8X3g2D9M7#2)9J5c8Y4R3$3y4q4)9J5c8Y4N6A6L8X3c8G2N6%4y4Q4x3X3b7I4x3q4)9J5c8U0t1J5K9o6u0Q4x3V1k6Q4y4h3k6f1c8f1t1$3y4l9`.`.">Vergilius Project | \_TEB64</a> 但是调取gs寄存器容易在内存中留下比较显眼的痕迹,可能被进行特征码扫描。也许是出于这个原因,样本没有这样使用,而是调用了`NtQueryInformationThread(NtCurrentThread(),ThreadBasicInformation,thread_basic_info,48,nt_query_ret_buf)`。根据文档,这里`thread_basic_info`中结构如下 ``` typedef struct _THREAD_BASIC_INFORMATION { NTSTATUS ExitStatus; //0x00 PTEB TebBaseAddress; //0x08 CLIENT_ID ClientId; KAFFINITY AffinityMask; KPRIORITY Priority; KPRIORITY BasePriority; } THREAD_BASIC_INFORMATION, *PTHREAD_BASIC_INFORMATION; ``` 而在TEB中,栈基址的位置同样是在0x08,所以在`thread_basic_info+0x10`的地方可以寻到栈基址。 而在样本中,对基址的获取则添加了利用动态TLS的缓存机制。当线程执行到这里的时候,会尝试从全局变量(进程空间中的地址)中查找已经分配的TLS索引和线程基址。若不存在,则通过`TlsAlloc`分配索引,并且通过上述`NtQueryInformationThread()`函数获得当前线程的栈基址。TLS是对于每个线程独立的存储空间。我们简单地把TLS理解成写字楼(即进程)楼下的公共储物柜,每个公司(线程)拥有一排,而公司的员工(即线程中不同的业务实体,如不同的模块)可以向物业申请数个公司所拥有的储物柜。不同公司的员工即使拿着相同的编号,打开的也是不同的柜子。而通过业务申请,你也不会打开已经被公司内他人占用的柜子。在同一线程中,因为样本会多次利用分发器调用API,所以这个函数不止会调用一次。这时利用缓存的TLS能够大幅减少对`NtQueryInformationThread()`的调用次数,降低被检测的可能。 接下来回到样本。在分发器函数中进入函数`find_hook_candidate_in_dll(_QWORD *out_hook_candidate_va, _DWORD *out_frame_size)`。这个函数首先进行一些字符串解密,然后尝试定位`kernelbase`中的`.text`段。接下来在该段中搜寻`jmp qword ptr [rbp + 0x48]`指令。对于搜索到的这些指令,进入`get_pdata_frame_size(__int64 module_base, int target_func_va, _DWORD *out_frame_size)`函数进行UNWIND_CODE检查。 而在`get_pdata_frame_size`中,先是进行对模块的pdata节定位,然后因为RUNTIME_FUNCTION每一条大小为12,所以pdata的virtualsize/12等于条目数量。对于`RUNTIME_FUNCTION`,其第九个到第十二个字节指向`UNWIND_INFO`。一个函数的`UNWIND_INFO`由一些flags和`UNWIND_CODE`组成。对于`UNWIND_INFO`,这个样本中仅关注`UNWIND_CODE`中的opcode部分。相较于经典堆栈欺骗项目 SilentMoonwalk 而言,少了一些在多个dll中进行筛选的环节。也体现出本次攻击为鱼叉攻击。有关x64栈回溯的相关内容,在查漏补缺中有。 样本中的opcode和栈计数操作对应: 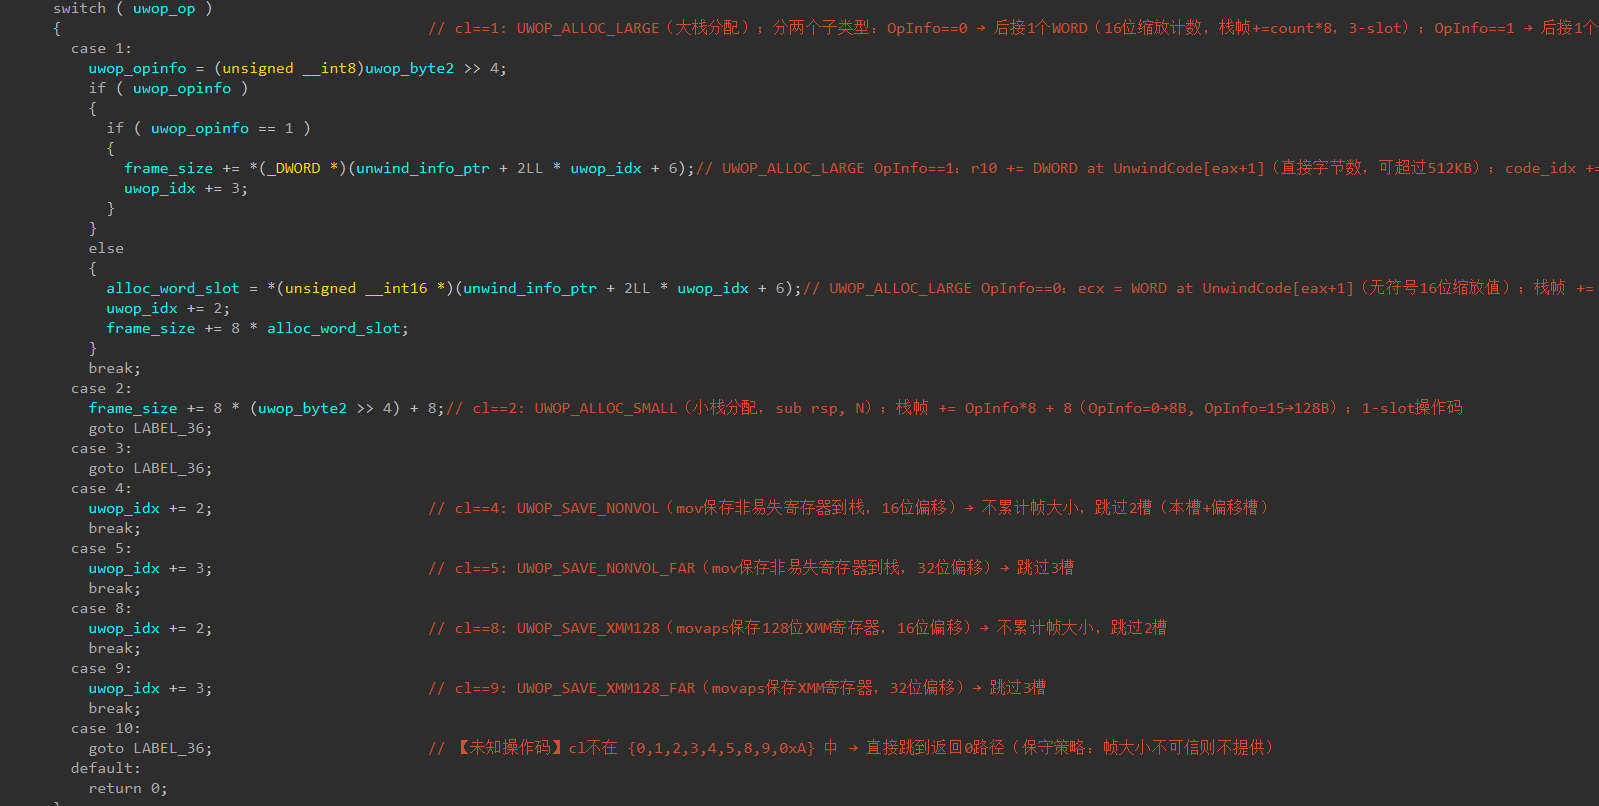 一个跳板函数所对应的栈回溯大小会被累计,并返回到上级函数。样本会检测这个跳板函数的有效帧大小,有效范围在`[0x88, 0x1000)`之间。不合法的跳板函数会被丢弃。样本会收集最多一百个候选跳板函数,避免进行过多的遍历。最终样本会在这些候选项中,通过`GetTickCount64 % 候选者数目`作为候选者名单数组的索引随机选择一个候选的跳板函数。最后再次调用一次`get_pdata_frame_size`获取被选上的函数的栈回溯值。 现在我们已经拿到了这个重要的`jmp qword ptr [rbp + 0x48]`跳板。接下来就是栈构造的时间。样本会获取`ntdll!RtlUserThreadStart+0x21`、`kernel32!BaseThreadInitThunk + 0x14`这两个地址并通过刚才的函数获取函数栈大小,这是一般的线程起点栈。接下来按照如下规则布置栈: ``` 高地址 ┌──────────────────────────────┐ │ 0x0000000000000000 │ ← null 哨兵(链顶) ├────── -(8 + v7|8) ───────────┤ │ RtlUserThreadStart + 0x21 │ ← 层1:线程入口伪装 ├────── -(8 + layer2_sz|8) ────┤ │ fn_layer2_va │ ← 层2:中间合法函数 ├────── -(8 + gadget_sz|8) ────┤ │ jmp_gadget_va │ ← 层3:JMP 跳板(RSP 最终指向此) 低地址 ``` 接下来将指向null哨兵的指针再次返回上级`call_loader_api_dispatch`。 现在我们来进入最后,也是真正的栈伪造环节。在`dispatch_via_hook_trampoline`中,首先压栈保存了所有7个非易失性寄存器,然后通过`hook_ctx`中的`frame_high`和`frame_low`获得新栈的大小,再加上200h的距离避免新老栈交错。接下来进行栈上参数的复制。然后在将RBP指向栈底+50h的地方。如果检测对原栈的加密flag存在,则还会进行fnv1a加密,加密的;但是无论是否存在,都会将函数跳板尾声`hook_trampoline_epilog`的指针放在RBP+48h,也就是栈底+8h的位置。最后再完成对几个寄存器的参数赋值,然后通过`jmp r12`命令跳转到打算跳转的地方。这时,我们再通过processExplorer查看,则会发现当前的线程栈中完全不存在`sbiedll.dll`的偏移。 进入堆栈欺骗前: 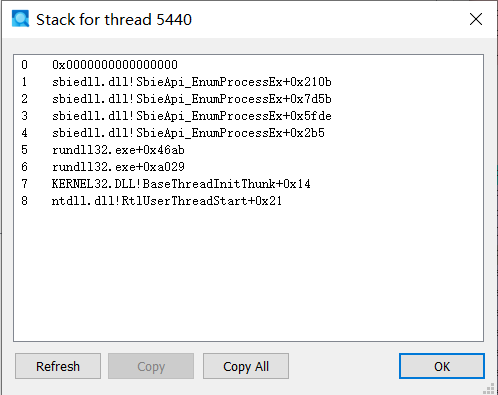 进入堆栈欺骗后,完全消失了痕迹。但是这个时候只能: 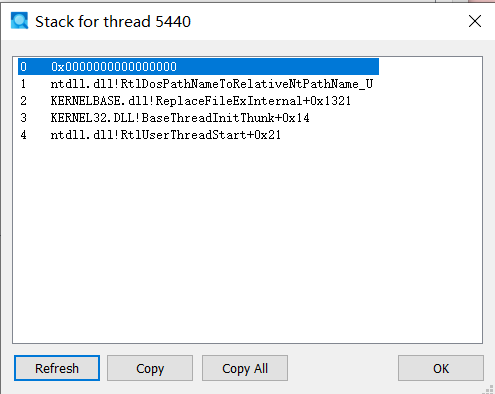 此时RBP+0x48的位置则是真正的返回位置。 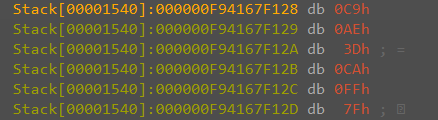 这时当我们返回的时候,我们发现当前RIP指向的是栈顶的`jmp_gadget_va`,也就是在`kernelbase`之前选出的`jmp qword ptr [rbp + 0x48]`。这时会将控制流劫持到刚才放置的跳板尾声函数指针`hook_trampoline_epilog`。在跳板尾声中,如果加密flag存在的时候则会进行fnv1a解密,因为fnv1a是加密自反算法,加密两次等于自身。最后在跳板尾声函数中恢复非易失性寄存器值,最后返回真正的调用者。 ## 思考 ### 堆栈欺骗的横向比较 <a href="elink@6d3K9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6%4k6h3u0Q4x3X3g2S2M7X3y4Z5K9i4k6W2i4K6u0W2L8%4u0Y4i4K6u0r3N6$3g2T1i4K6u0r3x3U0l9J5y4e0l9$3x3e0R3H3x3o6t1%4y4o6m8Q4x3V1k6Z5N6s2c8H3M7#2)9K6b7g2)9J5c8W2)9J5c8X3E0D9k6i4A6$3K9i4u0#2M7#2)9J5k6h3N6A6N6r3S2#2j5W2)9J5k6h3W2G2i4K6u0r3f1X3g2V1g2r3g2S2L8h3W2F1k6#2)9J5c8V1q4h3i4K6g2X3c8i4k6S2M7$3W2G2L8W2)9J5c8W2y4@1j5h3y4C8f1%4m8G2L8$3k6A6L8X3N6Q4x3V1j5`.">SilentMoonwalk: Implementing a dynamic Call Stack Spoofer | CyberSecurity Blog</a> 在 SilentMoonwalk(著名的 x64 堆栈欺骗开源项目)的 Desync 模式中,堆栈欺骗的核心在于造成实际执行流和栈回溯器的撕裂(栈回溯的知识请参阅下文)。我们需要一个控制流分离(Desync)栈帧,一个用于伪造栈寄存器地址的栈帧,一个用于更改回溯模式的栈帧。如果要追求精致,还可以再来一个RIP隐藏栈帧用来保护Desync栈帧。我们大概可以这样理解其伪造栈帧布置: * 第四栈帧:一个枢纽栈帧`Add Rsp, xx`,用来对RIP检测进行伪装。这个栈帧是可选的。 * 第三栈帧:一个Desync栈帧`Jmp Rbx, xx`。这个栈帧用来劫持真正的控制流到跳板函数中。对于回溯器,这是一个普通的栈帧,会顺着回溯到第二栈帧。 * 第二栈帧:一个在`UNWIND_CODE`中包含`UWOP_PUSH_NONVOL`的opcode的栈帧,用来使回溯器认定当前栈在`UNWIND_CODE`所在的,栈变动的地方进行了一次`PUSH RBP`,从而让回溯器内部的RBP等于此处的值。但是很可惜这里的值并不是真是的RBP的值,而是我们预埋的`RetAddress - 第一栈帧大小`。这里的RetAddress可以随意设置为任意的返回地址,比如经典的线程入口等。 * 第一栈帧:一个将`UNWIND_CODE`中包含`UWOP_SET_FPREG`的opcode的栈帧,用来使得回溯器认为这个函数中包含动态栈,从而直接通过RBP进行地址回溯;因为在第二栈帧中劫持了其内置的RBP,所以会跳转到我们定义的返回地址去。 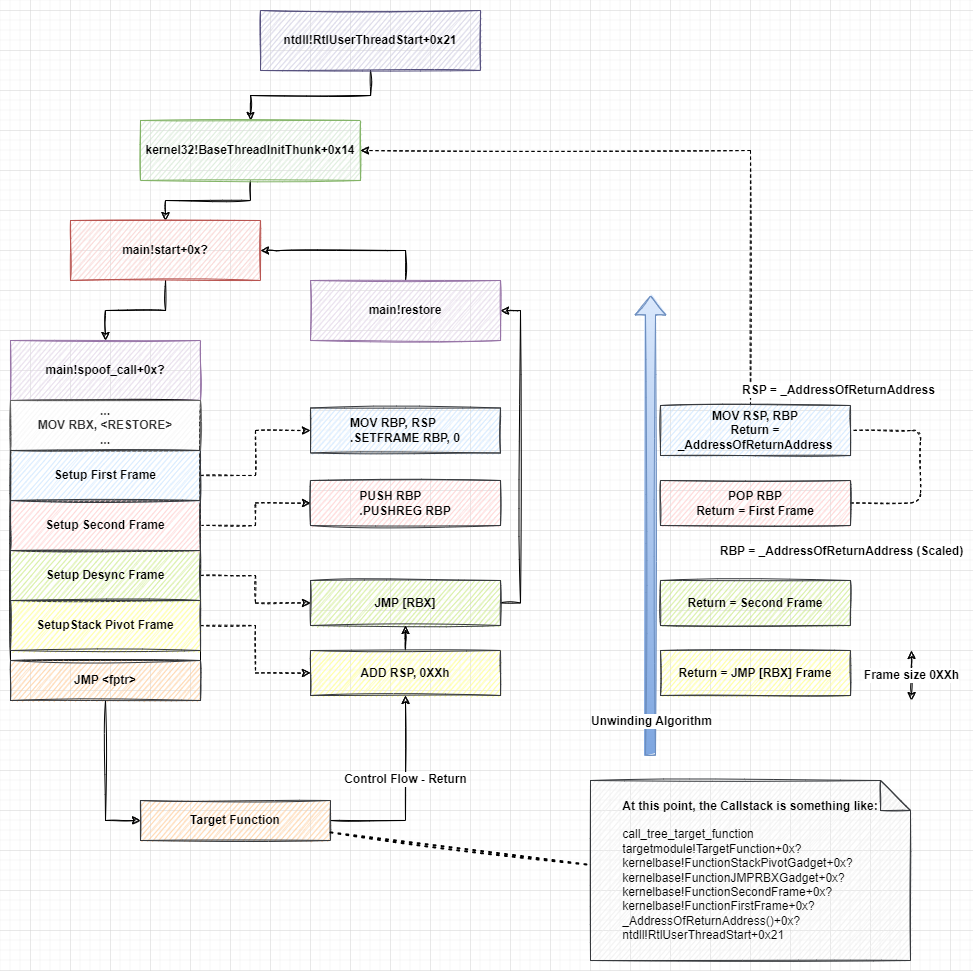 在这个样本中,回溯器和执行流之间确实被分离了,执行流被`jmp rbp+48h`所劫持到跳板函数,而回溯器则顺着回溯到预置的假线程入口。而在SilentMoonwalk中,通过第一和第二栈帧,**允许将回溯器通过RBP诱导到任意入口点**,比如真正的线程入口,caller's caller(如被植入shellcode的有漏洞线程的线程入口)。在本项目中没有使用这两个栈帧,说明样本不需要对抗学术级别的精确定位追溯,这个样本本身是利用了开源软件`sandboxie`的hook_layer中的dll侧载漏洞,并且在宿主进程中作为独立线程被调用,也不必要为了过于严谨的回溯增加投放成本。 复杂的检测手段有很多,比如追溯栈帧入口点的上一条指令是否为常见call、或者直接调用intel pt引擎进行PIP追溯。但是在成本有限的情况下可能造成大量安全运维噪音,导致很多时候并没有被工程化地部署(如对于采用了JIt的语言线程来说往往是致命的)。 ### 温故知新—X64栈回溯 <a href="elink@d16K9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6D9k6h3q4J5L8W2)9J5k6h3#2A6j5%4u0G2M7$3!0X3N6q4)9J5k6h3y4G2L8g2)9J5c8X3g2F1i4K6u0V1N6i4y4Q4x3V1k6%4K9h3&6V1L8%4N6K6i4K6u0r3N6$3W2F1x3K6u0Q4x3V1k6S2M7r3W2Q4x3V1k6%4K9h3&6F1N6q4)9J5c8X3&6K6i4K6u0V1N6$3W2F1L8Y4c8Q4x3X3c8J5N6h3&6@1K9h3#2W2i4K6g2X3k6Y4g2F1j5%4c8A6L8$3^5`.">RUNTIME_FUNCTION (winnt.h) - Win32 应用 | Microsoft Learn --- RUNTIME_FUNCTION (winnt.h) - Win32 apps | Microsoft Learn</a> <a href="elink@856K9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6D9k6h3q4J5L8W2)9J5k6h3#2A6j5%4u0G2M7$3!0X3N6q4)9J5k6h3y4G2L8g2)9J5c8X3g2F1i4K6u0V1N6i4y4Q4x3V1k6U0M7s2m8Q4x3V1k6T1N6h3W2D9k6q4)9J5c8X3g2^5j5$3g2H3N6r3W2G2L8W2)9J5k6r3S2S2L8X3c8D9K9h3&6Y4i4K6u0V1P5o6j5@1i4K6y4r3N6X3W2W2N6#2)9K6c8r3#2K6N6X3y4Q4x3X3b7I4y4K6l9`.">x64 异常处理 | 微软学习 --- x64 exception handling | Microsoft Learn</a> 为什么在x64中,RBP可以被用来被用作栈指针?在 x64 汇编中,RBP(Base Pointer)是一个非常特殊的寄存器,它有两种截然不同的用法: 用法 A:作为通用寄存器(General Purpose Register) 在现代编译器优化(尤其是 Release 模式)下,编译器倾向于使用 RSP(栈指针)来直接定位局部变量。这种技术叫 Frame Pointer Omission (FPO)。 此时,RBP 被解放出来,可以像 RBX, RSI 一样用来存普通数据。 用法 B:作为帧指针(Frame Pointer) 当函数中有动态栈分配(如 alloca())或为了方便调试时,编译器会“建立帧指针”。 标准动作:函数一开头执行 push rbp; mov rbp, rsp。 含义:此时 RBP 钉死了当前栈帧的基准位置。不管 RSP 怎么变(比如压入参数、动态分配),基于 RBP 的偏移量(如 [rbp+8])永远指向返回地址,[rbp-xx] 永远指向局部变量。 Windows x64 不再通过简单的扫描栈来回溯(像 x86 那样),而是依赖 PE 文件中必须存在的 .pdata (Runtime Function Table) 和 Unwind Info。这相当于一本“说明书”,告诉系统如何回溯每一行代码。 当系统(或 EDR)进行栈回溯时,如果它在“说明书”里读到了 UWOP_SET_FPREG,它会收到一条强制指令: “这个函数使用了帧指针!从现在开始,不要用 RSP 计算返回地址了,去用 RBP 计算!” **异常目录**位于该数组的第 4 个索引位(索引值为 `3`),宏定义为 `IMAGE_DIRECTORY_ENTRY_EXCEPTION`。 `DataDirectory[IMAGE_DIRECTORY_ENTRY_EXCEPTION]` 包含两个关键字段:**VirtualAddress**: 异常表相对于 ImageBase 的偏移(RVA)。**Size**: 异常表的总字节大小。 通过RVA访问到异常表(一般就是在pdata中),结构如下: ```c typedef struct _IMAGE_RUNTIME_FUNCTION_ENTRY { DWORD BeginAddress; // 函数代码开始的 RVA DWORD EndAddress; // 函数代码结束的 RVA DWORD UnwindInfoAddress; // 包含展开信息(Unwind Info)的 RVA } RUNTIME_FUNCTION, *PRUNTIME_FUNCTION; ``` 也就是说在第9-12个字节处是存放unwindinfo的位置。这是个RVA。  在x64dbg中,ctrl+G :$1b664跳转过去。  跳转过去之后是一个`UNWIND_INFO`结构体。 | Size | Value | | ---------- | -------------------------------------- | | UBYTE: 3 | Version | | UBYTE: 5 | Flags | | UBYTE | Size of prolog | | UBYTE | Count of unwind codes | | UBYTE: 4 | Frame Register | | UBYTE: 4 | Frame Register offset (scaled) | | USHORT * n | Unwind codes array | | variable | Can either be of form (1) or (2) below | 01(00000001)版本为1,flag为0;0B(00001011)为prolog字节长度。03说明后面有3个unwind_code结构。25(00100101)中高四位(0101)表示 Frame Register 为5,这个值如果非零则说明函数使用了帧指针寄存器,其值是所用帧寄存器的编号。这里为5,寄存器为RBP。回溯器看到这个非零值,就知道在回溯时应该去读 `RBP` 的值,而不是仅仅依赖 `RSP`。 低四位为2,表示实际的FP寄存器为RSP + 16 * 2,即32字节。为什么这里是32字节?这个问题我没有搞明白。根据X64 ABI的规定,caller必须在调用任何函数之前,在栈上留下32字节的空间。这块空间被称作为影子空间,无论参数有多少都必须存在。 RBP指向了影子空间的顶端,然后可以用正负偏移量分别访问函数自身的局部变量和影子空间中保存的输入参数。但是其又提出,这个设计有代码密度优化的功能,允许使用8位有符号位移,能比32位位移的指令更短,比如说一个函数使用了相当大的栈空间,就可以让FP在栈的正中央,能够允许更多的访存指令使用8位而不是32位。但是到底是为了哪种目的,这里也没有一个专门的flags指示,所以感觉不太明白。根据AI的描述,这二者本身并不冲突,是同一个设计目标在不同规模函数下的体现。 因为之前说有三个unwind code,所以后面跟了三个WORD unwind code。`0b23 06b2 0250`,剩下一些全零。首先对于第一个,0b23,prolog偏移量为0b,代表在函数序言执行到11字节的时候发生的动作。opcode为3`UWOP_SET_FPREG`,opinfo为2,对应UNWIND_INFO头部中设置的帧寄存器偏移量(缩放值)。这个是什么东西?根据AI解释,在这个栈描述结构中,有一些opcode是需要额外参数的,放在opinfo中;当操作码为UWOP_SET_FPREG的时候,opinfo的含义为Frame Register Offset。X64 ABI规定,FP = RSP+16\*FrameRegisterOffset;也就是说: - FrameRegisterOffset = 1 → FP = RSP + 16 - FrameRegisterOffset = 2 → FP = RSP + 32 - FrameRegisterOffset = 3 → FP = RSP + 48 所以当这个值为2的时候,就说明FP = RSP+32。又因为刚才说到的FP在这里是RBP,所以在汇编上来看就相当于`LEA RBP, [RSP + 0x20]`。 在0x0B之前,回溯器认为这个栈是无框的,可以通过RSP+增量回溯。在0x0B之后,执行器看到这个code触发,立刻去header中读出RBP和0x20。从此以后,RSP的基准值永远等于RBP-0x20。 现在我们再从这三个code开始模拟一次栈回溯。 首先阅读到0B23,得知偏移量0B,动作为设置帧寄存器,并且帧寄存器为RSP+16\*2。那么也就是说,在回溯的时候,就能够得知RSP = FP-32。所以在这个时候,因为RBP是恒定的,所以能够得到新RSP = RBP-32。这一步执行之后,RSP被拉回到分配局部变量后,设置RSP之前的那个瞬间。此时的RSP已经无视了函数体中可能存在的任何的**动态栈**操作(如alloca)。 下一步阅读到06B2。偏移06,动作为`UWOP_ALLOC_SMALL`分配小栈空间;info B=11,分配公式为`(INFO * 8) + 8`。所以这里就是分配96(0x60)字节。那么对于回溯器来说就是回溯96字节。 下一步阅读到0250。偏移02,动作为`UWOP_PUSH_NONVOL`(压栈非易失存储器);info 5为寄存器RBP。也就是说,这个code描绘了将RBP入栈的动作。那么作为回溯器,就应该RSP再+8。到此位置,就完成了对一个栈的回溯。 ### 为什么在这个Loader中需要多线程适配? 样本宿主`sbiedll.dll`来自沙箱软件sandboxie-plus。这是一个注入型 Hook DLL——Sandboxie 驱动通过 SbieApi_DeviceHandle 将它强制加载进每一个沙箱内的进程。被注入的进程可以是 Chrome(200+ 线程)、Firefox、Office,也可以是任意第三方程序。沙箱必须在这些进程的所有线程上正确拦截 ntdll/kernel32 系统调用,并做路径虚拟化、IPC 转发等工作。任何并发问题都会变成数据损坏或权限绕过。因此样本中含有大量的并发休眠,TLS缓存等机制避免直接崩溃或重复注入载荷的风险。 我会在之后完成对这个加载器的复现,届时会上传到Github中。感谢阅读。
回复或点赞可查看完整内容
冰与火的战歌:Windows内核攻防实战高级班!从零到实战,融合AI与Windows内核攻防全技术栈,打造具备自动化能力的内核开发高手。
#调试逆向
#系统底层
#加密算法
#病毒木马
#问题讨论
收藏
・
4
点赞
・
29
打赏
分享
分享到微信
分享到QQ
分享到微博
赞赏记录
参与人
雪币
留言
时间
amethyspro
感谢你的积极参与,期待更多精彩内容!
2026-9-14 16:06
git_51951meggadf3df
非常支持你的观点!
2026-9-11 02:43
mb_lthgjpwj
为你点赞!
2026-8-21 08:07
mb_jasgoras
期待更多优质内容的分享,论坛有你更精彩!
2026-8-12 10:44
mb_wsoacceo
为你点赞!
2026-8-11 01:28
wx_晨梦
感谢你的贡献,论坛因你而更加精彩!
2026-7-16 05:18
KK雾里
感谢你的贡献,论坛因你而更加精彩!
2026-7-10 10:28
git_43837featherL
非常支持你的观点!
2026-7-8 11:05
xxxark
为你点赞!
2026-7-6 11:39
智童
感谢你的积极参与,期待更多精彩内容!
2026-6-30 23:46
马来
为你点赞!
2026-5-27 10:54
mb_ayvdleao
你的帖子非常有用,感谢分享!
2026-5-23 23:35
wjdidi
感谢你的贡献,论坛因你而更加精彩!
2026-5-17 23:17
npc0vo
期待更多优质内容的分享,论坛有你更精彩!
2026-4-25 21:50
梦里看花
谢谢你的细致分析,受益匪浅!
2026-4-20 23:48
ldljlzw
谢谢你的细致分析,受益匪浅!
2026-4-6 09:22
_Smile`Melo
期待更多优质内容的分享,论坛有你更精彩!
2026-4-2 09:23
H莉
非常支持你的观点!
2026-4-1 23:53
0xEEEE
这个讨论对我很有帮助,谢谢!
2026-3-24 15:03
slurse_212010
感谢你的贡献,论坛因你而更加精彩!
2026-3-23 11:29
mb_tvuiswau
为你点赞!
2026-3-15 05:40
her01st
这个讨论对我很有帮助,谢谢!
2026-3-7 17:20
ONewTach
感谢你的贡献,论坛因你而更加精彩!
2026-3-6 09:15
nekomiao
感谢你分享这么好的资源!
2026-3-4 14:47
mb_kphqygvr
感谢你的贡献,论坛因你而更加精彩!
2026-3-4 14:46
熊趴趴来
为你点赞!
2026-3-4 14:10
寻影星尘
非常支持你的观点!
2026-3-4 10:21
huangyalei
非常支持你的观点!
2026-3-3 16:53
令狐双
你的帖子非常有用,感谢分享!
2026-3-3 13:36
查看更多
赞赏
×
1 雪花
5 雪花
10 雪花
20 雪花
50 雪花
80 雪花
100 雪花
150 雪花
200 雪花
支付方式:
微信支付
赞赏留言:
快捷留言
感谢分享~
精品文章~
原创内容~
精彩转帖~
助人为乐~
感谢分享~
最新回复
(
17
)
mb_qimctavn
雪 币:
5228
活跃值:
(6625)
能力值:
( LV2,RANK:10 )
在线值:
发帖
0
回帖
386
粉丝
1
关注
私信
mb_qimctavn
2
楼
6
2026-3-3 11:25
0
goahead二
雪 币:
31
能力值:
( LV1,RANK:0 )
在线值:
发帖
0
回帖
10
粉丝
0
关注
私信
goahead二
3
楼
厉害,学习
2026-3-3 22:53
0
wx_何健
雪 币:
0
能力值:
( LV1,RANK:0 )
在线值:
发帖
0
回帖
34
粉丝
1
关注
私信
wx_何健
4
楼
学习
2026-3-4 14:02
0
漆黑火焰魔法使
雪 币:
0
活跃值:
(406)
能力值:
( LV2,RANK:10 )
在线值:
发帖
0
回帖
49
粉丝
0
关注
私信
漆黑火焰魔法使
5
楼
感谢分享,学习了!
2026-3-4 22:14
0
耶巴蒂
雪 币:
0
能力值:
( LV1,RANK:0 )
在线值:
发帖
0
回帖
3
粉丝
0
关注
私信
耶巴蒂
6
楼
学习
2026-3-5 11:28
0
拍拖
雪 币:
2790
活跃值:
(6996)
能力值:
( LV6,RANK:90 )
在线值:
发帖
22
回帖
425
粉丝
15
关注
私信
拍拖
2
7
楼
感谢分享
2026-3-6 08:13
0
lai0301
雪 币:
174
能力值:
( LV1,RANK:0 )
在线值:
发帖
0
回帖
41
粉丝
0
关注
私信
lai0301
8
楼
看看!!!!!!
2026-3-10 15:55
0
wx_zz
雪 币:
1003
活跃值:
(21)
能力值:
( LV2,RANK:10 )
在线值:
发帖
0
回帖
8
粉丝
0
关注
私信
wx_zz
9
楼
学习了
2026-3-12 17:06
0
轰zzz
雪 币:
0
能力值:
( LV1,RANK:0 )
在线值:
发帖
0
回帖
18
粉丝
0
关注
私信
轰zzz
10
楼
牛逼
2026-3-26 11:04
0
huri
雪 币:
88
活跃值:
(683)
能力值:
( LV3,RANK:20 )
在线值:
发帖
2
回帖
28
粉丝
6
关注
私信
huri
11
楼
回复康康
2026-3-26 12:54
0
漫雾.
雪 币:
2272
活跃值:
(1261)
能力值:
( LV6,RANK:90 )
在线值:
发帖
4
回帖
17
粉丝
46
关注
私信
漫雾.
2
12
楼
感谢分享
2026-4-6 03:40
0
小迷糊ddd
雪 币:
268
能力值:
( LV1,RANK:0 )
在线值:
发帖
0
回帖
152
粉丝
0
关注
私信
小迷糊ddd
13
楼
感谢分享,学习一下。
2026-4-8 11:51
0
wx_第一天_926
雪 币:
0
能力值:
( LV1,RANK:0 )
在线值:
发帖
0
回帖
7
粉丝
0
关注
私信
wx_第一天_926
14
楼
感谢分享,学习一下。
2026-5-26 09:46
0
FZ_W
雪 币:
22
活跃值:
(575)
能力值:
( LV2,RANK:10 )
在线值:
发帖
0
回帖
24
粉丝
1
关注
私信
FZ_W
15
楼
xiexie
2026-5-27 10:15
0
mb_yitfonmc
雪 币:
210
能力值:
( LV1,RANK:0 )
在线值:
发帖
0
回帖
1
粉丝
0
关注
私信
mb_yitfonmc
16
楼
感谢分享
2026-6-18 17:49
0
mb_snnfdkrl
雪 币:
能力值:
( LV1,RANK:0 )
在线值:
发帖
0
回帖
17
粉丝
0
关注
私信
mb_snnfdkrl
17
楼
6666
2026-7-6 11:29
0
mb_rdwfhkwr
雪 币:
217
能力值:
( LV1,RANK:0 )
在线值:
发帖
0
回帖
3
粉丝
0
关注
私信
mb_rdwfhkwr
18
楼
感谢分享
2026-8-31 16:17
0
游客
登录
|
注册
方可回帖
回帖
表情
雪币赚取及消费
高级回复
返回
ALCFree
1
发帖
4
回帖
0
RANK
关注
私信
他的文章
[原创]APT41-DodgeBox载荷加载器逆向——堆栈欺骗技术探究
5555
关于我们
联系我们
企业服务
看雪公众号
专注于PC、移动、智能设备安全研究及逆向工程的开发者社区
看原图
赞赏
×
雪币:
+
留言:
快捷留言
为你点赞!
返回
顶部





