首页
课程
问答
CTF
社区
招聘
峰会
发现
排行榜
知识库
工具下载
看雪20年
看雪商城
证书查询
登录
注册
首页
社区
课程
招聘
发现
问答
CTF
排行榜
知识库
工具下载
峰会
看雪商城
证书查询
社区
Android安全
发新帖
8
46
[原创]capstone学习: 反汇编器如何实现的
发表于: 2025-11-17 13:47
15458
[原创]capstone学习: 反汇编器如何实现的
nothing233
1
2025-11-17 13:47
15458
# capstone学习: 反汇编器如何实现的 ## 编译运行 编译 ```bash git clone git@github.com:capstone-engine/capstone.git cmake -B build -DCMAKE_BUILD_TYPE=Debug -DCMAKE_EXPORT_COMPILE_COMMANDS=ON cmake --build build sudo cmake --install build --prefix "/usr/local" ``` 让 ai 写个例子运行(capstone 中的 tests 不太容易跟): ```cpp #include "capstone/aarch64.h" #include <iostream> #include <cstdint> #include <capstone/capstone.h> // AARCH64 测试指令 // 包含常见指令: MOV, ADD, SUB, LDR, STR, BR, CMP, B.eq 等 const uint8_t arm64_code[] = { 0x8B, 0x02, 0x40, 0xF9, // ldr x11, [x0] ; 从 x0 指向的地址加载数据到 x11 0x20, 0x08, 0x40, 0xF9, // ldr x0, [x1, #0x20] ; 从 x1+0x20 地址加载数据到 x0 0x00, 0x00, 0x00, 0x91, // add x0, x0, #0x0 ; x0 = x0 + 0(空操作, 演示格式) 0x01, 0x00, 0x00, 0x91, // add x1, x0, #0x0 ; x1 = x0 + 0 0x02, 0x20, 0x40, 0xF9, // ldr x2, [x1] ; 从 x1 指向地址加载数据到 x2 0x03, 0x30, 0x00, 0xB9, // str w3, [x2, #0x8] ; 将 w3 低32位数据存储到 x2+0x8 地址 0x04, 0x00, 0x00, 0x54, // cmp x0, x4 ; 比较 x0 和 x4 0x00, 0x00, 0x00, 0x54, // cmp x0, x0 ; 比较 x0 和 x0(结果为相等) 0x00, 0x00, 0x00, 0x58, // ldr x0, [x0] ; 从 x0 指向地址加载数据到 x0 0x00, 0x00, 0x1F, 0xD6 // br x0 ; 跳转到 x0 指向的地址 }; // 错误处理辅助函数 void print_error(const char* msg, cs_err err) { std::cerr << "[ERROR] " << msg << ": " << cs_strerror(err) << std::endl; } int main() { csh handle; // Capstone 句柄 cs_insn* insns = nullptr; // 存储反汇编结果的指令数组 size_t count; // 反汇编出的指令数量 // 1. 初始化 Capstone 引擎: 架构为 AARCH64, 模式为小端序(默认) cs_err err = cs_open(CS_ARCH_AARCH64, CS_MODE_LITTLE_ENDIAN, &handle); if (err != CS_ERR_OK) { print_error("cs_open failed", err); return 1; } // 2. 可选配置: 启用详细指令信息(如寄存器操作数, 立即数等) cs_option(handle, CS_OPT_DETAIL, CS_OPT_ON); // 3. 执行反汇编 // 参数: 句柄, 指令缓冲区, 缓冲区长度, 起始地址(用于指令地址显示), 反汇编条数(0 表示全部) count = cs_disasm(handle, arm64_code, sizeof(arm64_code), 0x1000, 0, &insns); if (count == 0) { print_error("cs_disasm failed", cs_errno(handle)); cs_close(&handle); return 1; } // 4. 打印反汇编结果 std::cout << "=== AARCH64 反汇编结果 ===" << std::endl; std::cout << "地址\t\t机器码\t\t指令" << std::endl; std::cout << "----------------------------------------" << std::endl; for (size_t i = 0; i < count; ++i) { cs_insn* ins = &insns[i]; // 打印地址(十六进制) std::printf("0x%lx\t", ins->address); // 打印机器码(2 位一组, 空格分隔) for (size_t j = 0; j < ins->size; ++j) { std::printf("%02x ", ins->bytes[j]); } // 补齐机器码字段(对齐显示) if (ins->size < 4) { std::printf("\t"); } if (ins->size < 8) { std::printf("\t"); } // 打印指令助记符 + 操作数 std::printf("%s\t%s\n", ins->mnemonic, ins->op_str); // (可选)打印详细信息(如操作数类型, 寄存器等) if (ins->detail != nullptr) { cs_aarch64* arm64 = &ins->detail->aarch64; std::printf("\t\t\t操作数数量: %u\n", arm64->op_count); // 遍历每个操作数 for (size_t j = 0; j < arm64->op_count; ++j) { cs_aarch64_op* op = &arm64->operands[j]; std::printf("\t\t\t操作数 %lu: ", j + 1); switch (op->type) { case AARCH64_OP_REG: // 寄存器操作数 std::printf("寄存器 (x%u/w%u)", op->reg - AARCH64_REG_X0, // 转换为 x0/x1... 格式 op->reg - AARCH64_REG_W0); // 转换为 w0/w1... 格式 break; case AARCH64_OP_IMM: // 立即数操作数 std::printf("立即数 0x%lx", op->imm); break; case AARCH64_OP_MEM: // 内存操作数(如 [x0], [x1, #0x20]) std::printf("内存 [x%u", op->mem.base - AARCH64_REG_X0); if (op->mem.disp != 0) { std::printf(", #0x%x", op->mem.disp); } std::printf("]"); break; default: std::printf("未知类型"); break; } std::printf("\n"); } std::printf("\n"); } } // 5. 释放资源(必须调用, 避免内存泄漏) cs_free(insns, count); cs_close(&handle); return 0; } ``` 编译运行这个例子看看: ```bash touch 111.cpp g++ 111.cpp -o 111 -lcapstone ./111 ``` 输出 ``` === AARCH64 反汇编结果 === 地址 机器码 指令 ---------------------------------------- 0x1000 8b 02 40 f9 ldr x11, [x20] 操作数数量: 2 操作数 1: 寄存器 (x11/w42) 操作数 2: 内存 [x20] 0x1004 20 08 40 f9 ldr x0, [x1, #0x10] 操作数数量: 2 操作数 1: 寄存器 (x0/w31) 操作数 2: 内存 [x1, #0x10] 0x1008 00 00 00 91 add x0, x0, #0 操作数数量: 3 操作数 1: 寄存器 (x0/w31) 操作数 2: 寄存器 (x0/w31) 操作数 3: 立即数 0x0 0x100c 01 00 00 91 add x1, x0, #0 操作数数量: 3 操作数 1: 寄存器 (x1/w32) 操作数 2: 寄存器 (x0/w31) 操作数 3: 立即数 0x0 0x1010 02 20 40 f9 ldr x2, [x0, #0x40] 操作数数量: 2 操作数 1: 寄存器 (x2/w33) 操作数 2: 内存 [x0, #0x40] 0x1014 03 30 00 b9 str w3, [x0, #0x30] 操作数数量: 2 操作数 1: 寄存器 (x4294967268/w3) 操作数 2: 内存 [x0, #0x30] 0x1018 04 00 00 54 b.mi 0x1018 操作数数量: 1 操作数 1: 立即数 0x1018 0x101c 00 00 00 54 b.eq 0x101c 操作数数量: 1 操作数 1: 立即数 0x101c 0x1020 00 00 00 58 ldr x0, 0x1020 操作数数量: 2 操作数 1: 寄存器 (x0/w31) 操作数 2: 内存 [x4294967058, #0x1020] 0x1024 00 00 1f d6 br x0 操作数数量: 1 操作数 1: 寄存器 (x0/w31) ``` 完美. ## 阅读源码 让我们从这个代码中的 `cs_disasm` 开始看, 前面的一些初始化的代码跳过: ```c CAPSTONE_EXPORT size_t CAPSTONE_API cs_disasm(csh ud, const uint8_t *buffer, size_t size, uint64_t offset, size_t count, cs_insn **insn) { // 引擎句柄结构体(存储架构, 模式, 配置等核心信息) struct cs_struct *handle; // 机器指令结构体(Capstone 内部用于存储解码后的指令信息) MCInst mci; // 当前指令的长度(字节数, 如 ARM64 通常为 4) uint16_t insn_size; // c: 已成功反汇编的指令计数: i: 循环临时变量 size_t c = 0, i; // f: 指令缓存(insn_cache)的下一个空闲位置索引 unsigned int f = 0; // 指令缓存: 临时存储已解码的指令, 避免频繁内存分配 cs_insn *insn_cache; // total: 最终输出的指令数组内存块: total_size: 该内存块总大小 void *total = NULL; size_t total_size = 0; // r: 解码结果标记(true=解码成功, false=解码失败/数据跳过) bool r; // tmp: 内存重分配临时指针 void *tmp; // skipdata_bytes: 需要跳过的无效数据长度(当遇到非指令二进制时) size_t skipdata_bytes; // 保存原始缓冲区信息(用于 SKIPDATA 功能: 跳过无效数据) uint64_t offset_org; size_t size_org; const uint8_t *buffer_org; // 指令缓存大小(默认 INSN_CACHE_SIZE, 通常为 64) unsigned int cache_size = INSN_CACHE_SIZE; // 下一条指令的偏移量(当前指令长度, 用于移动缓冲区指针) size_t next_offset; // 将句柄转换为内部结构体 handle = (struct cs_struct *)(uintptr_t)ud; if (!handle) { return 0; } handle->errnum = CS_ERR_OK; #ifdef CAPSTONE_USE_SYS_DYN_MEM if (count > 0 && count <= INSN_CACHE_SIZE) cache_size = (unsigned int)count; #endif buffer_org = buffer; offset_org = offset; size_org = size; // 计算初始缓存总大小: 单个 cs_insn 结构体大小 × 缓存条数 total_size = sizeof(cs_insn) * cache_size; // 分配缓存内存(cs_mem_calloc 是 Capstone 封装的 calloc, 自动初始化 0) total = cs_mem_calloc(sizeof(cs_insn), cache_size); if (total == NULL) { handle->errnum = CS_ERR_MEM; return 0; } insn_cache = total; while (size > 0) { MCInst_Init(&mci, handle->arch); mci.csh = handle; // 给内部指令结构体设置当前指令地址(相对跳转指令需要该地址计算目标) mci.address = offset; // 如果启用了详细信息模式(CS_OPT_DETAIL=ON), 为当前指令分配 detail 结构体内存 if (handle->detail_opt) { insn_cache->detail = cs_mem_calloc(1, sizeof(cs_detail)); } else { // 未启用详细模式, detail 指针设为 NULL insn_cache->detail = NULL; } // 保存非详细模式下的基础信息: 指令地址 mci.flat_insn = insn_cache; mci.flat_insn->address = offset; // 精简模式(CAPSTONE_DIET): 清零助记符和操作数字符串(减少内存占用) #ifdef CAPSTONE_DIET mci.flat_insn->mnemonic[0] = '\0'; mci.flat_insn->op_str[0] = '\0'; #endif // 核心解码调用: 调用对应架构的解码函数 // 参数说明: // ud: 引擎句柄: buffer: 当前缓冲区指针: size: 剩余缓冲区长度 // &mci: 输出解码后的内部指令信息: &insn_size: 输出当前指令长度 // offset: 当前指令地址: handle->getinsn_info: 架构专属解码信息 r = handle->disasm(ud, buffer, size, &mci, &insn_size, offset, handle->getinsn_info); // 解码成功(r=true: 当前二进制是有效指令) if (r) { // 字符串流: 用于拼接助记符和操作数(如 "add x0, x1, #0x10") SStream ss; SStream_Init(&ss); // 记录当前指令的长度(如 ARM64 指令为 4 字节) mci.flat_insn->size = insn_size; // 将内部 opcode 映射为公开的指令 ID(如 ARM64_INS_ADD) handle->insn_id(handle, insn_cache, mci.Opcode); // 配置立即数显示格式(无符号/有符号) SStream_opt_unum(&ss, handle->imm_unsigned); // 调用架构专属的指令打印函数: 将 MCInst 转为可读字符串(助记符+操作数) handle->printer(&mci, &ss, handle->printer_info); // 填充 cs_insn 结构体: 复制字符串流到 mnemonic/op_str, 拷贝指令二进制字节 fill_insn(handle, insn_cache, &ss, &mci, handle->post_printer, buffer); // 特殊处理 X86 架构的伪指令: 调整指令 ID(如某些前缀指令的ID偏移) if (handle->arch == CS_ARCH_X86 && insn_cache->id != X86_INS_VCMP) insn_cache->id += mci.popcode_adjust; // 下一条指令的偏移量 = 当前指令长度 next_offset = insn_size; } else { // 解码失败(r=false: 当前二进制不是有效指令) // 如果启用了详细模式, 释放当前指令的 detail 内存(避免泄漏) if (handle->detail_opt) { cs_mem_free(insn_cache->detail); } // 检查是否启用 SKIPDATA 功能: 未启用 或 剩余数据不足跳过长度 → 退出循环 if (!handle->skipdata || handle->skipdata_size > size) break; // 计算需要跳过的无效数据长度: // 1. 如果用户注册了自定义跳过回调函数, 调用回调获取长度 if (handle->skipdata_setup.callback) { skipdata_bytes = handle->skipdata_setup.callback( buffer_org, size_org, // 原始缓冲区信息 (size_t)(offset - offset_org), // 当前相对于原始缓冲区的偏移 handle->skipdata_setup.user_data); // 用户自定义数据 // 剩余数据不足跳过长度 → 退出 if (skipdata_bytes > size) break; // 回调返回 0 → 用户要求不跳过, 退出 if (!skipdata_bytes) break; } else { // 2. 未注册回调: 使用默认跳过长度(handle->skipdata_size) skipdata_bytes = handle->skipdata_size; } // 填充无效数据的指令结构体(标记为非有效指令) insn_cache->id = 0; // 0 表示无效指令 ID insn_cache->address = offset; // 记录无效数据的起始地址 insn_cache->size = (uint16_t)skipdata_bytes; // 跳过的字节数 // 拷贝无效数据的二进制到指令结构体 memcpy(insn_cache->bytes, buffer, skipdata_bytes); // 精简模式: 清零字符串 #ifdef CAPSTONE_DIET insn_cache->mnemonic[0] = '\0'; insn_cache->op_str[0] = '\0'; #else // 非精简模式: 设置跳过数据的助记符(如 ".byte")和操作数(如 "0x12 0x34") strncpy(insn_cache->mnemonic, handle->skipdata_setup.mnemonic, sizeof(insn_cache->mnemonic) - 1); skipdata_opstr(insn_cache->op_str, buffer, skipdata_bytes); #endif // 无效数据无详细信息, detail 设为 NULL insn_cache->detail = NULL; // 下一条指令的偏移量 = 跳过的无效数据长度 next_offset = skipdata_bytes; } // 缓存中已填充一条指令, 移动缓存索引到下一个空闲位置 f++; // 已解码指令数+1: 如果达到用户指定的最大条数, 退出循环 c++; if (count > 0 && c == count) break; // 检查缓存是否已满: 需要扩容(按黄金比例 1.6 倍扩容) if (f == cache_size) { // 计算新缓存大小(原大小 × 8/5 = 1.6 倍, 平衡扩容效率和内存占用) cache_size = cache_size * 8 / 5; // 计算新的总内存大小 total_size += (sizeof(cs_insn) * cache_size); // 内存重分配: 扩展总内存块 tmp = cs_mem_realloc(total, total_size); // 重分配失败: 释放已分配资源, 返回错误 if (tmp == NULL) { // 释放所有指令的 detail 内存(避免泄漏) if (handle->detail_opt) { insn_cache = (cs_insn *)total; for (i = 0; i < c; i++, insn_cache++) cs_mem_free(insn_cache->detail); } // 释放总内存块 cs_mem_free(total); *insn = NULL; handle->errnum = CS_ERR_MEM; return 0; } // 更新总内存块指针和缓存指针 total = tmp; // 缓存指针指向已解码指令的下一个空闲位置(跳过已填充的 c 条指令) insn_cache = (cs_insn *)((char *)total + sizeof(cs_insn) * c); // 重置缓存索引(新缓存从 0 开始填充) f = 0; } else { // 缓存未填满: 移动缓存指针到下一个空闲位置 insn_cache++; } // 移动缓冲区指针: 跳过当前已处理的字节(指令/无效数据) buffer += next_offset; size -= next_offset; // 更新下一条指令的地址(模拟内存地址递增) offset += next_offset; } // 如果未解码到任何指令: 释放总内存, 返回 0 if (!c) { cs_mem_free(total); total = NULL; } else if (f != cache_size) { // 缓存未用完: 缩小内存块到实际需要的大小(减少内存浪费) tmp = cs_mem_realloc(total, total_size - (cache_size - f) * sizeof(*insn_cache)); // 重分配失败: 释放资源, 返回错误 if (tmp == NULL) { if (handle->detail_opt) { insn_cache = (cs_insn *)total; for (i = 0; i < c; i++, insn_cache++) cs_mem_free(insn_cache->detail); } cs_mem_free(total); *insn = NULL; handle->errnum = CS_ERR_MEM; return 0; } // 更新总内存块指针(指向缩小后的内存) total = tmp; } // 将最终的指令数组返回给调用者 *insn = total; // 返回成功解码的指令数量 return c; } ``` 核心流程概括一下就是: 初始化各种变量, 缓存, 架构信息等; 循环调用 `handle->disasm` 方法解码; 处理好缓存, 缓存扩容以及资源释放等. 我们继续跟入 `handle->disasm`: 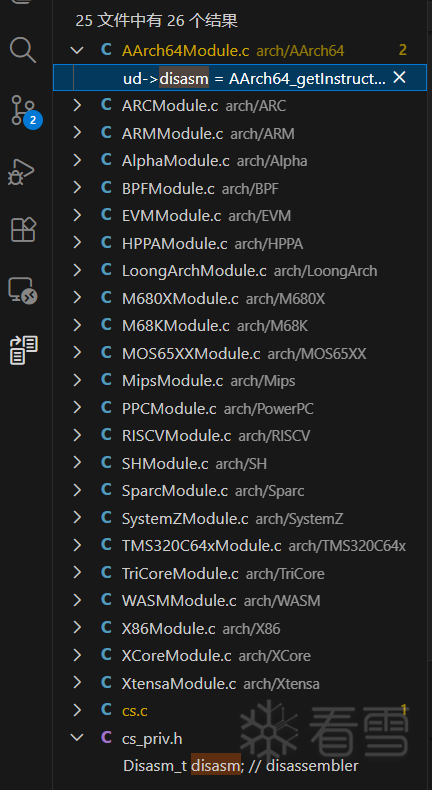 可以看到各个架构都有实现, 我们只看 arm64 也就是 `arch/AArch64/AArch64Module.c` 中的: ```c cs_err AArch64_global_init(cs_struct *ud) { MCRegisterInfo *mri; mri = cs_mem_malloc(sizeof(*mri)); AArch64_init_mri(mri); ud->printer = AArch64_printer; ud->printer_info = mri; ud->getinsn_info = mri; ud->disasm = AArch64_getInstruction; ud->reg_name = AArch64_reg_name; ud->insn_id = AArch64_get_insn_id; ud->insn_name = AArch64_insn_name; ud->group_name = AArch64_group_name; ud->post_printer = NULL; #ifndef CAPSTONE_DIET ud->reg_access = AArch64_reg_access; #endif return CS_ERR_OK; } ``` 跟入 `AArch64_getInstruction`: ```c bool AArch64_getInstruction(csh handle, const uint8_t *code, size_t code_len, MCInst *MI, uint16_t *size, uint64_t address, void *info) { AArch64_init_cs_detail(MI); DecodeStatus Result = AArch64_LLVM_getInstruction( handle, code, code_len, MI, size, address, info); AArch64_set_instr_map_data(MI); if (Result == MCDisassembler_SoftFail) { MCInst_setSoftFail(MI); } return Result != MCDisassembler_Fail; } DecodeStatus AArch64_LLVM_getInstruction(csh handle, const uint8_t *Bytes, size_t ByteLen, MCInst *MI, uint16_t *Size, uint64_t Address, void *Info) { DecodeStatus Result = MCDisassembler_Fail; Result = getInstruction(handle, Bytes, ByteLen, MI, Size, Address, Info); MCInst_handleWriteback(MI, AArch64Descs.Insts, ARR_SIZE(AArch64Descs.Insts)); return Result; } ``` ### getInstruction 跟入 `getInstruction`, 来到了 `arch/AArch64/AArch64Disassembler.c` 中: ```c // handle: Capstone 引擎句柄(存储架构配置, 模式等信息) // Bytes: 待解码的二进制机器码缓冲区 // ByteLen: 缓冲区剩余长度(字节数) // MI: 输出参数, 存储解码后的指令信息 // Size: 输出参数, 返回当前指令的长度(AArch64 默认为 4 字节) // Address: 当前指令的模拟内存地址(用于相对跳转, 地址相关指令解析) // Info: 附加信息(解码上下文, 通常为架构专属配置) static DecodeStatus getInstruction(csh handle, const uint8_t *Bytes, size_t ByteLen, MCInst *MI, uint16_t *Size, uint64_t Address, void *Info) { *Size = 0; if (ByteLen < 4) return Fail; // 确认当前指令长度为 4 字节(AArch64 无变长指令, 除非是扩展指令, 但此处处理标准指令) *Size = 4; // 读取 4 字节机器码结果存储到 Insn uint32_t Insn = readBytes32(MI, Bytes); // 定义 AArch64 指令解码表数组: 包含主解码表和降级解码表 // DecoderTable32: 主解码表(优先使用, 包含大部分标准指令) // DecoderTableFallback32: 降级解码表(主表解码失败时使用, 兼容特殊/老旧指令) const uint8_t *Tables[] = { DecoderTable32, DecoderTableFallback32 }; // 遍历解码表: 先尝试主表, 失败则尝试降级表(提高解码兼容性) for (int i = 0; i < (sizeof(Tables) / sizeof(Tables[0])); ++i) { void *Decoder = NULL; DecodeStatus Result = decodeInstruction_4(Tables[i], MI, Insn, Address, Decoder); const MCInstrDesc Desc = AArch64Descs.Insts[ARR_SIZE(AArch64Descs.Insts) - 1 - MCInst_getOpcode(MI)]; // 处理 SME(Scalable Matrix Extension, 可扩展矩阵扩展)指令的隐式操作数 // SME 指令部分操作数未在机器码中编码(如累加器 ZA, 零立即数), 需手动插入到 MCInst 中 for (unsigned j = 0; j < Desc.NumOperands; j++) { // 遍历指令的所有操作数描述, 判断是否为需要补充的隐式操作数 if (Desc.OpInfo[j].OperandType == MCOI_OPERAND_REGISTER) { // 操作数类型为寄存器: 根据寄存器类(RegClass)补充对应的隐式寄存器 switch (Desc.OpInfo[j].RegClass) { default: // 非 SME 相关寄存器类, 跳过 break; case AArch64_MPRRegClassID: // 补充隐式累加器寄存器 ZA(SME 矩阵操作的累加器) MCInst_insert0(MI, j, MCOperand_CreateReg1(MI, AArch64_ZA)); break; case AArch64_MPR8RegClassID: // 补充隐式寄存器 ZAB0(SME 8 位矩阵操作数寄存器) MCInst_insert0(MI, j, MCOperand_CreateReg1(MI, AArch64_ZAB0)); break; case AArch64_ZTRRegClassID: // 补充隐式寄存器 ZT0(SME 张量寄存器) MCInst_insert0(MI, j, MCOperand_CreateReg1(MI, AArch64_ZT0)); break; } } else if (Desc.OpInfo[j].OperandType == AARCH64_OP_IMPLICIT_IMM_0) { // 操作数类型为隐式零立即数: 补充立即数 0 到操作数列表 MCInst_insert0(MI, j, MCOperand_CreateImm1(MI, 0)); } } // 特殊处理 ZA 寄存器的加载(LDR_ZA)和存储(STR_ZA)指令 // 这类指令的单个立即数被同时用于「向量选择偏移」和「内存偏移」 // 机器码中仅编码一次, 需手动复制该立即数作为第二个操作数 if (MCInst_getOpcode(MI) == AArch64_LDR_ZA || MCInst_getOpcode(MI) == AArch64_STR_ZA) { // 获取已解码的第 3 个操作数(索引 2): 即共享的立即数操作数 MCOperand *Imm4Op = MCInst_getOperand(MI, (2)); // 将该立即数复制并添加为新的操作数 MCInst_addOperand2(MI, (Imm4Op)); } if (Result != MCDisassembler_Fail) return Result; } return MCDisassembler_Fail; } ``` 首先要看看 `const uint8_t *Tables[] = { DecoderTable32, DecoderTableFallback32 };` 这两个表: 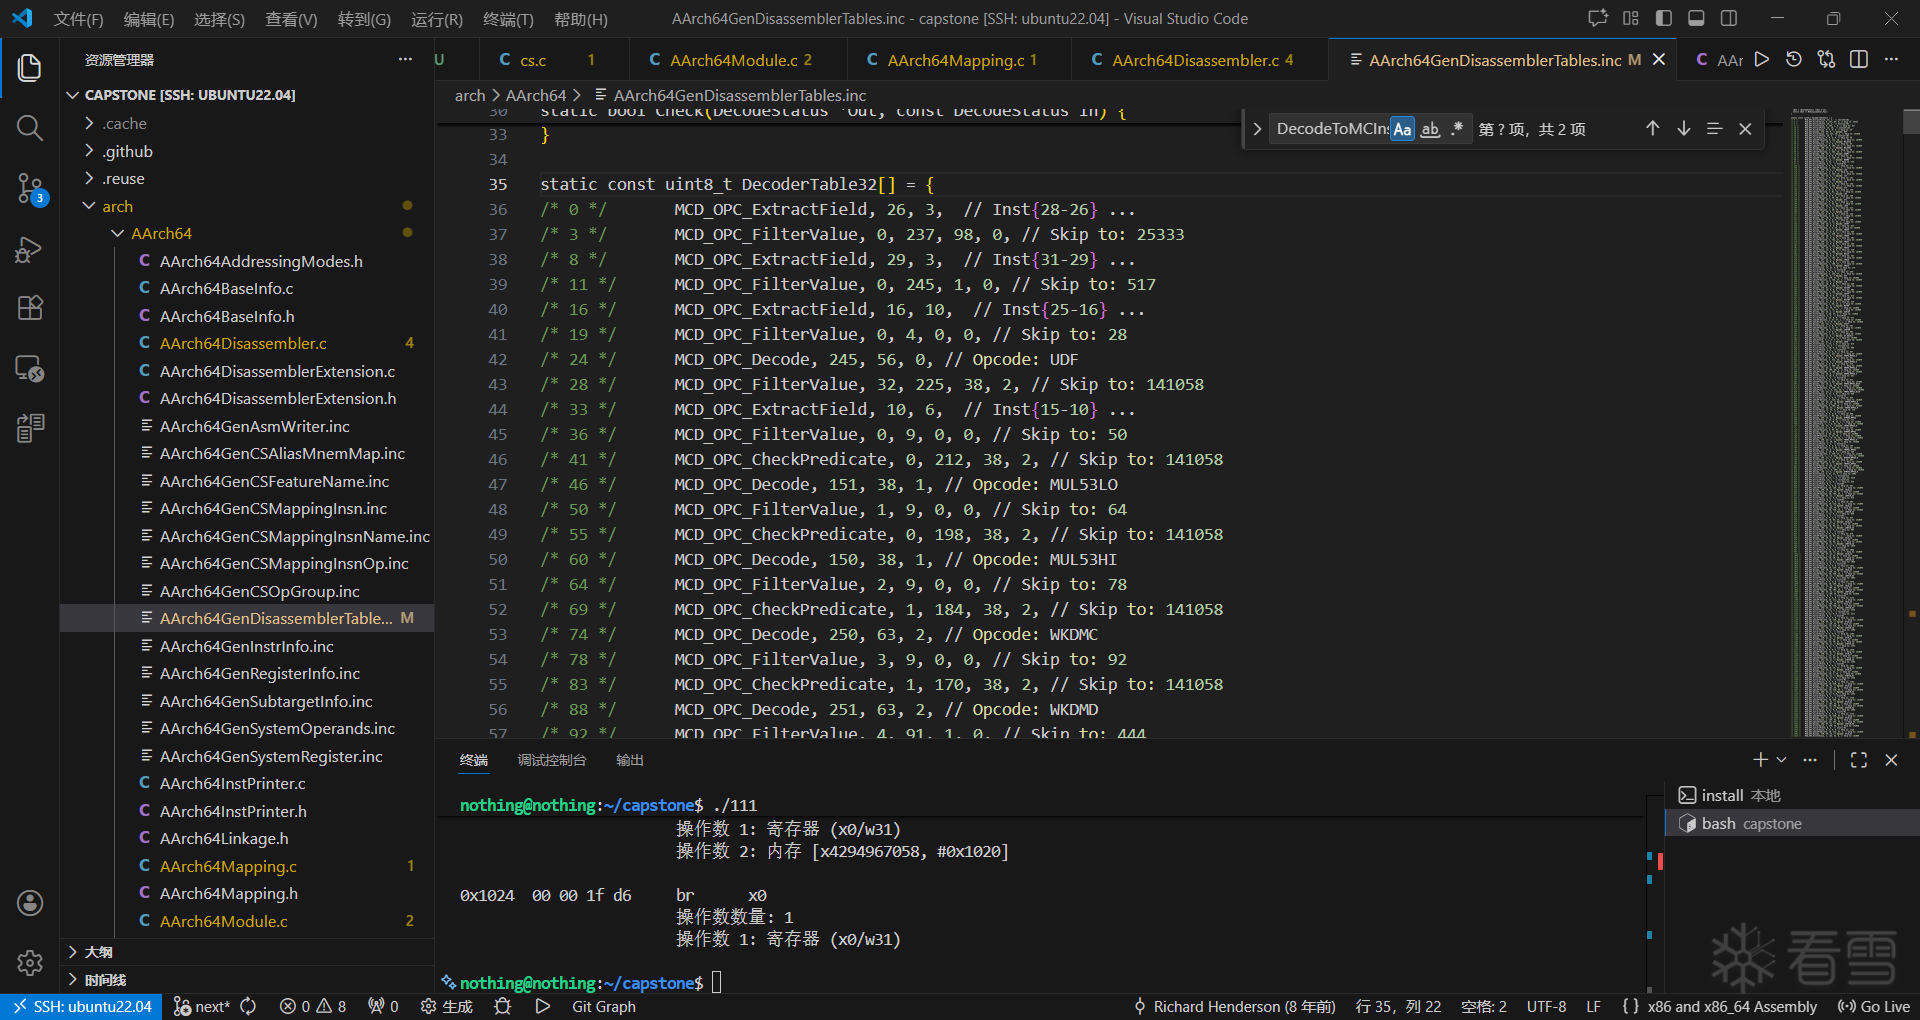 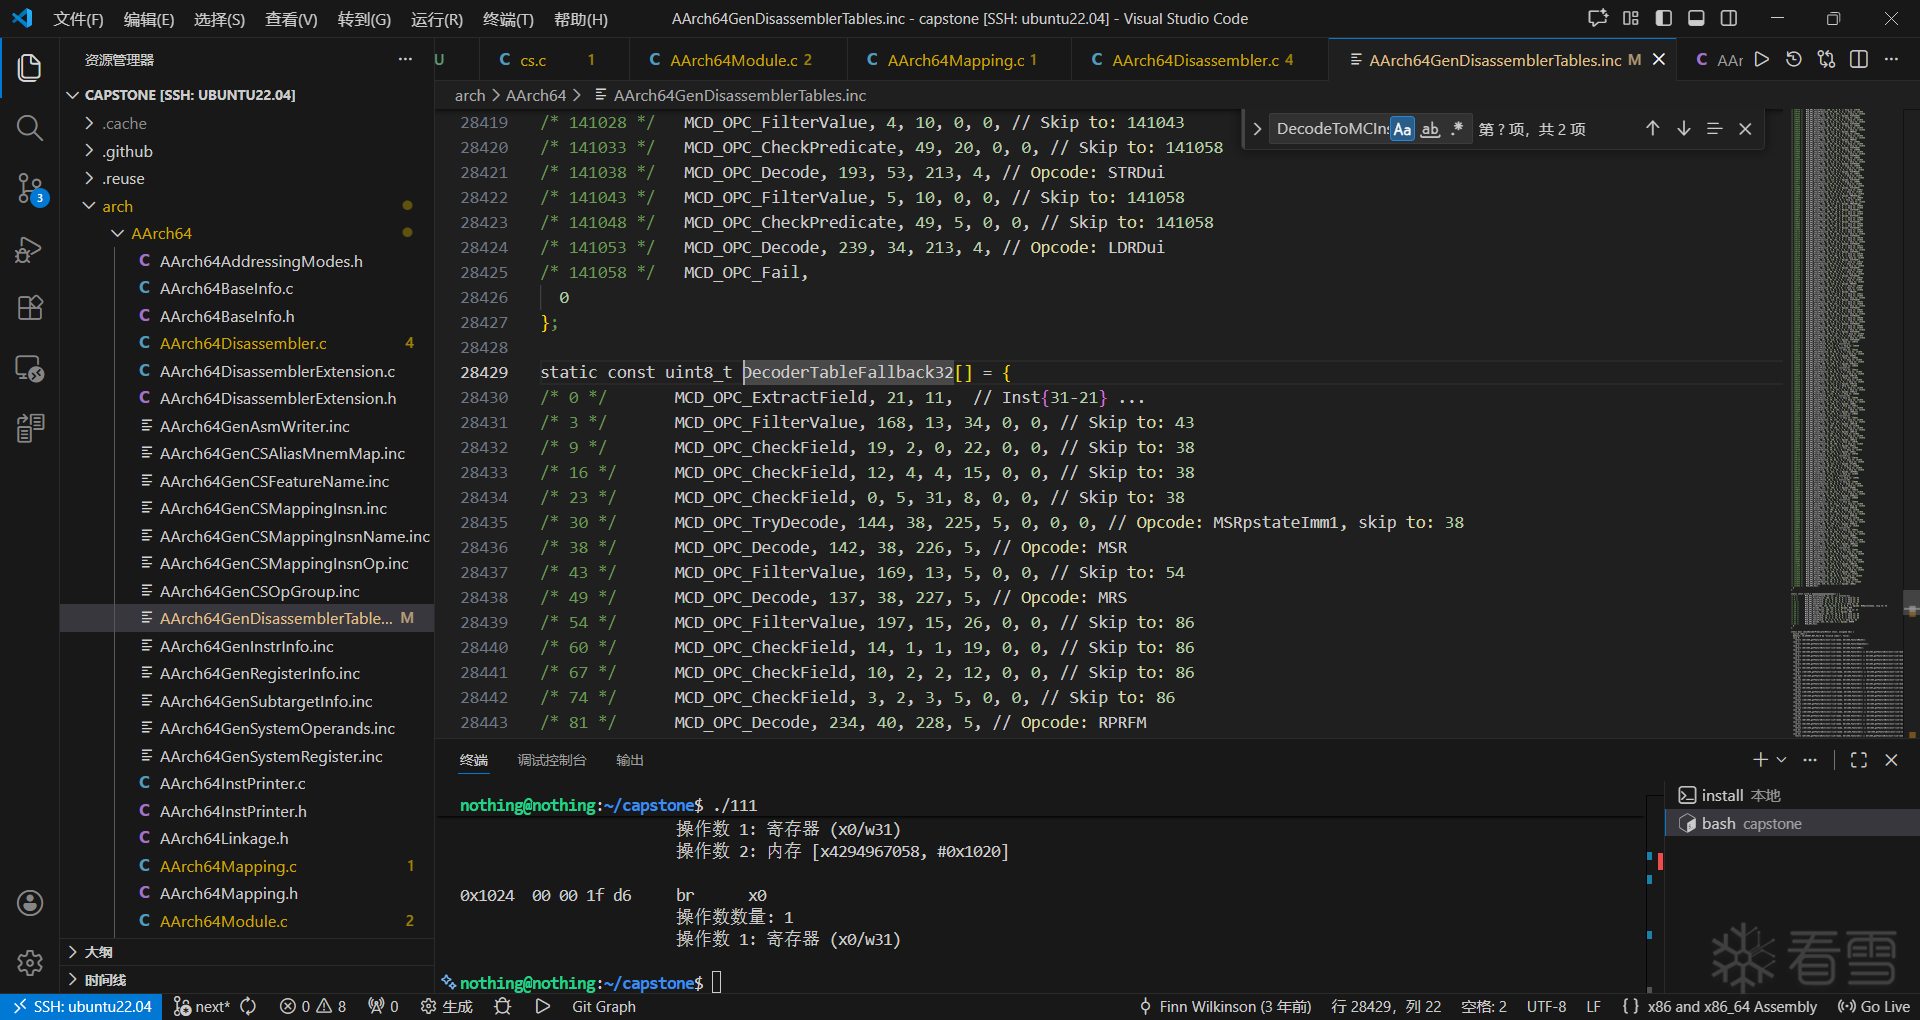 一个非常长的文件, 其实还是 c 代码, 看注释像是状态转移表. ### DecodeInstruction 接着去看 `decodeInstruction_4` 如何来的, 跟进去发现: 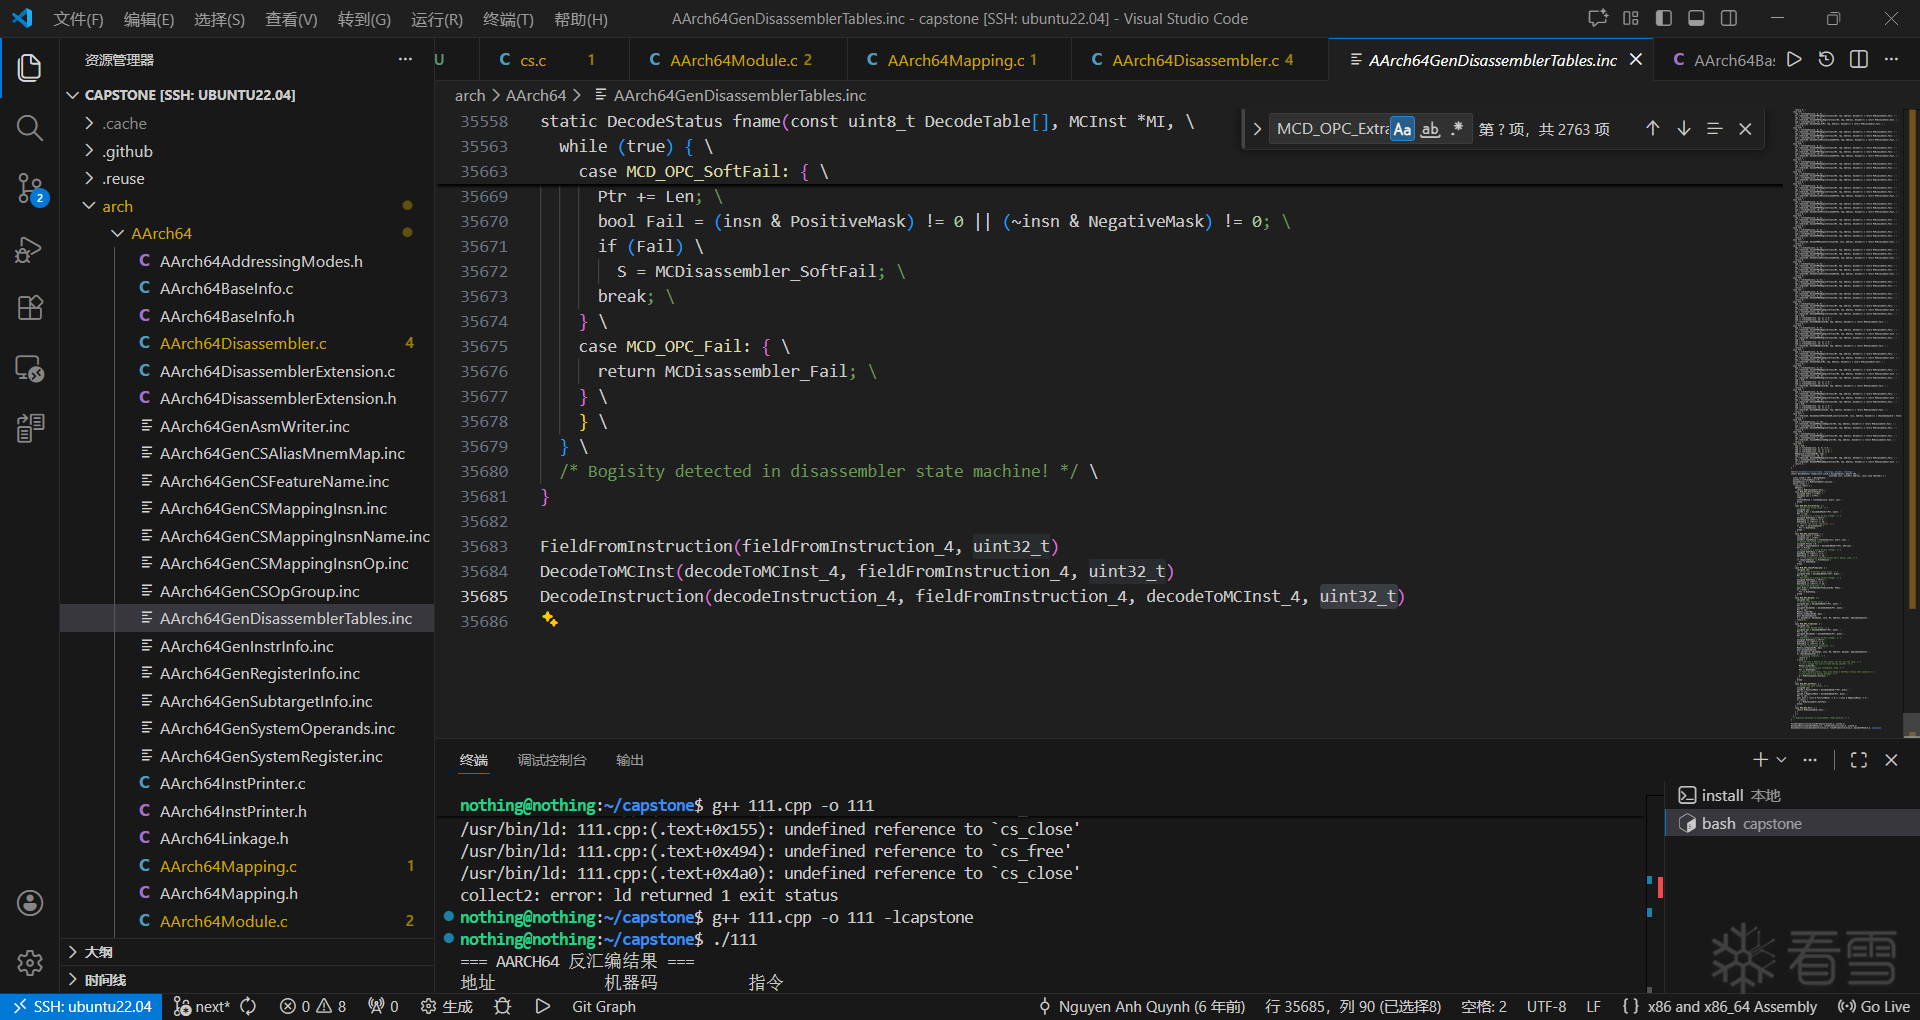 , `DecodeInstruction(decodeInstruction_4, fieldFromInstruction_4, decodeToMCInst_4, uint32_t)` 这行定义了 `decodeInstruction_4`, 找到 `DecodeInstruction` 是一个宏: ```c #define DecodeInstruction(fname, fieldname, decoder, InsnType) \ static DecodeStatus fname(const uint8_t DecodeTable[], MCInst *MI, \ InsnType insn, uint64_t Address, const void *Decoder) { \ const uint8_t *Ptr = DecodeTable; \ uint64_t CurFieldValue = 0; \ DecodeStatus S = MCDisassembler_Success; \ while (true) { \ switch (*Ptr) { \ default: \ return MCDisassembler_Fail; \ case MCD_OPC_ExtractField: { \ unsigned Start = *++Ptr; \ unsigned Len = *++Ptr; \ ++Ptr; \ CurFieldValue = fieldname(insn, Start, Len); \ break; \ } \ case MCD_OPC_FilterValue: { \ /* Decode the field value. */ \ unsigned Len; \ uint64_t Val = decodeULEB128(++Ptr, &Len); \ Ptr += Len; \ /* NumToSkip is a plain 24-bit integer. */ \ unsigned NumToSkip = *Ptr++; \ NumToSkip |= (*Ptr++) << 8; \ NumToSkip |= (*Ptr++) << 16; \ /* Perform the filter operation. */ \ if (Val != CurFieldValue) \ Ptr += NumToSkip; \ break; \ } \ case MCD_OPC_CheckField: { \ unsigned Start = *++Ptr; \ unsigned Len = *++Ptr; \ uint64_t FieldValue = fieldname(insn, Start, Len); \ /* Decode the field value. */ \ unsigned PtrLen = 0; \ uint64_t ExpectedValue = decodeULEB128(++Ptr, &PtrLen); \ Ptr += PtrLen; \ /* NumToSkip is a plain 24-bit integer. */ \ unsigned NumToSkip = *Ptr++; \ NumToSkip |= (*Ptr++) << 8; \ NumToSkip |= (*Ptr++) << 16; \ /* If the actual and expected values don't match, skip. */ \ if (ExpectedValue != FieldValue) \ Ptr += NumToSkip; \ break; \ } \ case MCD_OPC_CheckPredicate: { \ unsigned Len; \ /* Decode the Predicate Index value. */ \ unsigned PIdx = decodeULEB128(++Ptr, &Len); \ Ptr += Len; \ /* NumToSkip is a plain 24-bit integer. */ \ unsigned NumToSkip = *Ptr++; \ NumToSkip |= (*Ptr++) << 8; \ NumToSkip |= (*Ptr++) << 16; \ /* Check the predicate. */ \ bool Pred = checkDecoderPredicate(MI, PIdx); \ if (!Pred) \ Ptr += NumToSkip; \ break; \ } \ case MCD_OPC_Decode: { \ unsigned Len; \ /* Decode the Opcode value. */ \ unsigned Opc = decodeULEB128(++Ptr, &Len); \ Ptr += Len; \ unsigned DecodeIdx = decodeULEB128(Ptr, &Len); \ Ptr += Len; \ MCInst_clear(MI); \ MCInst_setOpcode(MI, Opc); \ bool DecodeComplete; \ S = decoder(S, DecodeIdx, insn, MI, Address, Decoder, &DecodeComplete); \ return S; \ } \ case MCD_OPC_TryDecode: { \ unsigned Len; \ /* Decode the Opcode value. */ \ unsigned Opc = decodeULEB128(++Ptr, &Len); \ Ptr += Len; \ unsigned DecodeIdx = decodeULEB128(Ptr, &Len); \ Ptr += Len; \ /* NumToSkip is a plain 24-bit integer. */ \ unsigned NumToSkip = *Ptr++; \ NumToSkip |= (*Ptr++) << 8; \ NumToSkip |= (*Ptr++) << 16; \ /* Perform the decode operation. */ \ MCInst_setOpcode(MI, Opc); \ bool DecodeComplete; \ S = decoder(S, DecodeIdx, insn, MI, Address, Decoder, &DecodeComplete); \ if (DecodeComplete) { \ /* Decoding complete. */ \ return S; \ } else { \ /* LLVM uses a MCInst on the stack, but for our use case, */ \ /* it is enough for now to reset the op counter. */ \ MCInst_clear(MI); \ /* If the decoding was incomplete, skip. */ \ Ptr += NumToSkip; \ /* Reset decode status. This also drops a SoftFail status that could be */ \ /* set before the decode attempt. */ \ S = MCDisassembler_Success; \ } \ break; \ } \ case MCD_OPC_SoftFail: { \ /* Decode the mask values. */ \ unsigned Len; \ uint64_t PositiveMask = decodeULEB128(++Ptr, &Len); \ Ptr += Len; \ uint64_t NegativeMask = decodeULEB128(Ptr, &Len); \ Ptr += Len; \ bool Fail = (insn & PositiveMask) != 0 || (~insn & NegativeMask) != 0; \ if (Fail) \ S = MCDisassembler_SoftFail; \ break; \ } \ case MCD_OPC_Fail: { \ return MCDisassembler_Fail; \ } \ } \ } \ /* Bogisity detected in disassembler state machine! */ \ } ``` 实际上是在定义一个函数, 函数名就是传进来的第一个参数, 在看这个函数, 一个 `while` 大循环, 里面一些 `case`, 还定义了一个 `DecodeStatus S = MCDisassembler_Success;` 看着就是一个状态机. 其中 `decodeULEB128`: ```cpp static inline uint64_t decodeULEB128(const uint8_t *p, unsigned *n) { const uint8_t *orig_p = p; // 保存原始指针, 用于计算读取的字节数 uint64_t Value = 0; // 存储解码后的最终值 unsigned Shift = 0; // 数据移位偏移量 do { // 1. 提取当前字节的低7位有效数据(& 0x7f 清除延续位) // 2. 左移 Shift 位(将当前字节数据放到对应位置, 如第1字节移0位, 第2字节移7位, 第3字节移14位...) // 3. 累加到最终结果 Value 中 Value += (uint64_t)(*p & 0x7f) << Shift; // 移位偏移量增加7位 Shift += 7; // 检查当前字节的延续位: >=128 表示延续位为1(二进制 10000000), 需要继续解码下一个字节 } while (*p++ >= 128); // 如果输出参数 n 非空, 返回解码读取的字节数(当前指针 - 原始指针) if (n) *n = (unsigned)(p - orig_p); // 返回解码后的无符号整数 return Value; } ``` 将 ULEB128 编码的二进制数据转换为 64 位无符号整数, ULEB128 编码特点: 1. 小端序存储; 2. 每个字节最高位(bit7)为"延续位"(1=后续还有字节, 0=结束); 3. 低7位存储有效数据. 函数第一个参数 `DecodeTable` 就是上边那个表, 表中每一个宏(类似 `MCD_OPC_SoftFail`)都对应一个 case, 有相应的处理. 为了完全搞清楚这个函数, 我们还要在看看 `fieldname` 与 `decoder`, 回到: ```c FieldFromInstruction(fieldFromInstruction_4, uint32_t) DecodeToMCInst(decodeToMCInst_4, fieldFromInstruction_4, uint32_t) DecodeInstruction(decodeInstruction_4, fieldFromInstruction_4, decodeToMCInst_4, uint32_t) ``` ### FieldFromInstruction ```c #define FieldFromInstruction(fname, InsnType) \ static InsnType fname(InsnType insn, unsigned startBit, unsigned numBits) \ { \ InsnType fieldMask; \ if (numBits == sizeof(InsnType) * 8) \ fieldMask = (InsnType)(-1LL); \ else \ fieldMask = (((InsnType)1 << numBits) - 1) << startBit; \ return (insn & fieldMask) >> startBit; \ } ``` 这个函数就是 `decodeInstruction_4` 中的 `fieldname`. 发现与 `DecodeInstruction` 类似, 都是在定义一个函数, 函数名都是宏第一个参数. 这个函数的功能很简单, 就是通过位运算精准提取指令中的指定位段. ### DecodeToMCInst ```cpp #define DecodeToMCInst(fname, fieldname, InsnType) \ static DecodeStatus fname(DecodeStatus S, unsigned Idx, InsnType insn, MCInst *MI, \ uint64_t Address, const void *Decoder, bool *DecodeComplete) \ { \ *DecodeComplete = true; \ InsnType tmp; \ switch (Idx) { \ default: CS_ASSERT_RET_VAL(0 && "Invalid index!", MCDisassembler_Fail); \ case 0: \ tmp = fieldname(insn, 0, 16); \ MCOperand_CreateImm0(MI, tmp); \ return S; \ case 1: \ tmp = fieldname(insn, 0, 5); \ if (!Check(&S, DecodeFPR128RegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 0, 5); \ if (!Check(&S, DecodeFPR128RegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 5, 5); \ if (!Check(&S, DecodeFPR128RegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ return S; \ case 2: \ tmp = fieldname(insn, 0, 5); \ if (!Check(&S, DecodeGPR64RegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 5, 5); \ if (!Check(&S, DecodeGPR64RegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 0, 5); \ if (!Check(&S, DecodeGPR64RegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ return S; \ case 3: \ tmp = fieldname(insn, 0, 5); \ if (!Check(&S, DecodeGPR64RegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ return S; \ case 4: \ return S; \ case 5: \ tmp = fieldname(insn, 0, 5); \ if (!Check(&S, DecodeSImm_5(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ return S; \ case 6: \ tmp = fieldname(insn, 0, 5); \ if (!Check(&S, DecodeGPR64RegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 0, 5); \ if (!Check(&S, DecodeGPR64RegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ return S; \ case 7: \ tmp = fieldname(insn, 0, 4); \ MCOperand_CreateImm0(MI, tmp); \ return S; \ case 8: \ tmp = fieldname(insn, 0, 2); \ if (!Check(&S, DecodeMatrixTile_2(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 0, 2); \ if (!Check(&S, DecodeMatrixTile_2(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 10, 3); \ if (!Check(&S, DecodePPR_3bRegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 13, 3); \ if (!Check(&S, DecodePPR_3bRegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 5, 5); \ if (!Check(&S, DecodeZPRRegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 16, 5); \ if (!Check(&S, DecodeZPRRegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ return S; \ case 9: \ tmp = fieldname(insn, 0, 1); \ if (!Check(&S, DecodeMatrixTile_1(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 0, 1); \ if (!Check(&S, DecodeMatrixTile_1(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 10, 3); \ if (!Check(&S, DecodePPR_3bRegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 13, 3); \ if (!Check(&S, DecodePPR_3bRegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 5, 5); \ if (!Check(&S, DecodeZPRRegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 16, 5); \ if (!Check(&S, DecodeZPRRegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ return S; \ case 10: \ tmp = fieldname(insn, 0, 3); \ if (!Check(&S, DecodeMatrixTile_3(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 0, 3); \ if (!Check(&S, DecodeMatrixTile_3(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 10, 3); \ if (!Check(&S, DecodePPR_3bRegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 13, 3); \ if (!Check(&S, DecodePPR_3bRegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 5, 5); \ if (!Check(&S, DecodeZPRRegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 16, 5); \ if (!Check(&S, DecodeZPRRegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ return S; \ case 11: \ tmp = fieldname(insn, 1, 4); \ if (!Check(&S, DecodeZPR2Mul2RegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 10, 3); \ if (!Check(&S, DecodePNR_p8to15RegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 5, 5); \ if (!Check(&S, DecodeGPR64spRegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 16, 5); \ if (!Check(&S, DecodeGPR64RegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ return S; \ case 12: \ tmp = fieldname(insn, 2, 3); \ if (!Check(&S, DecodeZPR4Mul4RegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 10, 3); \ if (!Check(&S, DecodePNR_p8to15RegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 5, 5); \ if (!Check(&S, DecodeGPR64spRegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 16, 5); \ if (!Check(&S, DecodeGPR64RegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ return S; \ case 13: \ tmp = fieldname(insn, 1, 4); \ if (!Check(&S, DecodeZPR2Mul2RegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 10, 3); \ if (!Check(&S, DecodePNR_p8to15RegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 5, 5); \ if (!Check(&S, DecodeGPR64spRegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 16, 4); \ if (!Check(&S, DecodeSImm_4(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ return S; \ case 14: \ tmp = fieldname(insn, 2, 3); \ if (!Check(&S, DecodeZPR4Mul4RegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 10, 3); \ if (!Check(&S, DecodePNR_p8to15RegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 5, 5); \ if (!Check(&S, DecodeGPR64spRegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 16, 4); \ if (!Check(&S, DecodeSImm_4(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ return S; \ case 15: \ tmp = 0x0; \ tmp |= fieldname(insn, 0, 3) << 0; \ tmp |= fieldname(insn, 4, 1) << 3; \ if (!Check(&S, DecodeZPR2StridedRegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 10, 3); \ if (!Check(&S, DecodePNR_p8to15RegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 5, 5); \ if (!Check(&S, DecodeGPR64spRegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ tmp = fieldname(insn, 16, 5); \ if (!Check(&S, DecodeGPR64RegisterClass(MI, tmp, Address, Decoder))) { return MCDisassembler_Fail; } \ return S; \ case 16: \ // ...... ``` 这个太长我就不贴全了, 这个函数就是 `decodeInstruction_4` 中的 `decoder`. 看着是在反汇编每条指令, 首先看下 `Check`: ```c static bool Check(DecodeStatus *Out, const DecodeStatus In) { *Out = (DecodeStatus) (*Out & In); return *Out != MCDisassembler_Fail; } ``` 将两个结果取 &, 看看是否失败. 其中 `Out` 传进来的 `S`, 即以往的状态, `In` 是本次解码的状态. 再跟入这些解码函数看一看: #### DecodeFPR128RegisterClass ```c static DecodeStatus DecodeFPR128RegisterClass(MCInst *Inst, unsigned RegNo, uint64_t Addr, const void *Decoder) { if (RegNo > 31) return Fail; unsigned Register = AArch64MCRegisterClasses[AArch64_FPR128RegClassID] .RegsBegin[RegNo]; MCOperand_CreateReg0(Inst, (Register)); return Success; } static DecodeStatus DecodeGPR64RegisterClass(MCInst *Inst, unsigned RegNo, uint64_t Addr, const void *Decoder) { if (RegNo > 31) return Fail; unsigned Register = AArch64MCRegisterClasses[AArch64_GPR64RegClassID] .RegsBegin[RegNo]; MCOperand_CreateReg0(Inst, (Register)); return Success; } // ...... ``` 再看 `AArch64MCRegisterClasses`: 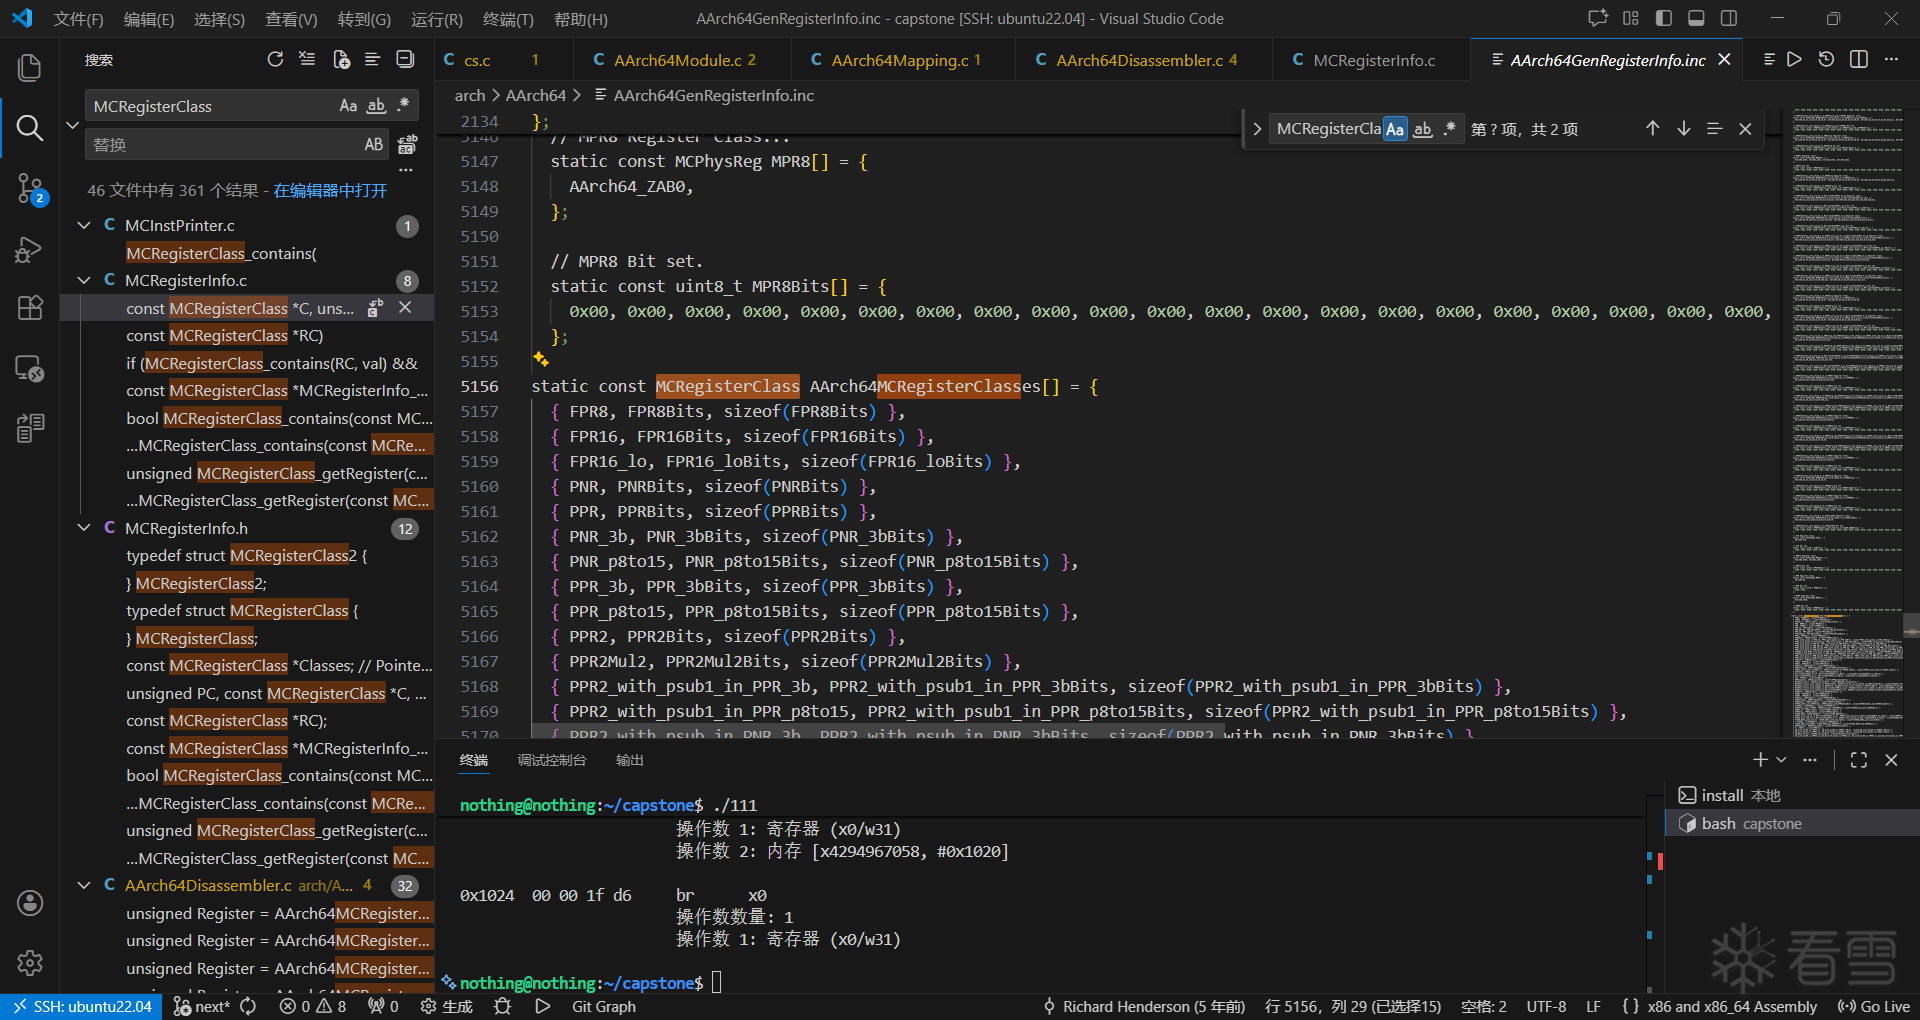 又是一个大表, 存了一些这样的数组: 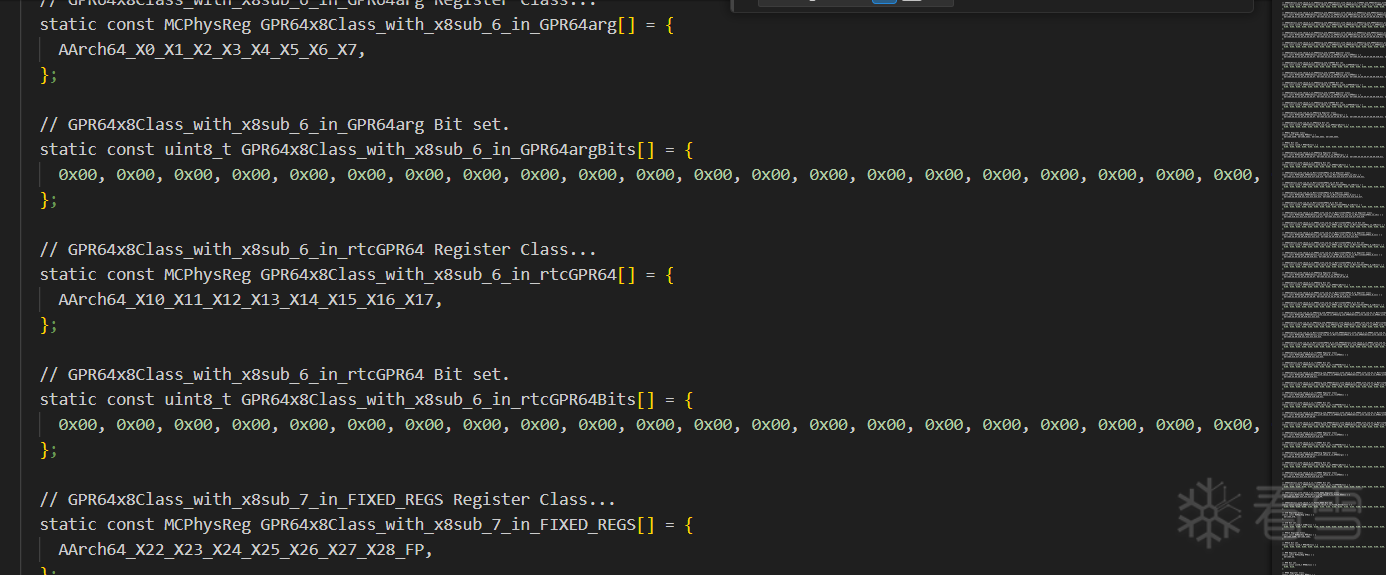 又找了一下 `MCRegisterClass`: ```c typedef int16_t MCPhysReg; typedef const MCPhysReg *iterator; typedef struct MCRegisterClass { iterator RegsBegin; const uint8_t *RegSet; uint16_t RegSetSize; } MCRegisterClass; ``` 总结一下就是通过传进来的 `RegNo` 作为查表获取的字节数组的索引, 找到 `Register`, 对应了 `MCInst` 具体寄存器枚举, 跟入 `MCOperand_CreateReg0`: ```c void MCOperand_CreateReg0(MCInst *mcInst, unsigned Reg) { MCOperand *op = &(mcInst->Operands[mcInst->size]); mcInst->size++; op->MachineOperandType = kRegister; op->Kind = kRegister; op->RegVal = Reg; } ``` 那么 `Operand` 有了, `Opcode` 呢, 回到 `DecodeInstruction`, 找到 `S = decoder(S, DecodeIdx, insn, MI, Address, Decoder, &DecodeComplete);` 也就是 `decoder` 调用的地方: ```cpp case MCD_OPC_Decode: { \ unsigned Len; \ /* Decode the Opcode value. */ \ unsigned Opc = decodeULEB128(++Ptr, &Len); \ Ptr += Len; \ unsigned DecodeIdx = decodeULEB128(Ptr, &Len); \ Ptr += Len; \ MCInst_clear(MI); \ MCInst_setOpcode(MI, Opc); \ bool DecodeComplete; \ S = decoder(S, DecodeIdx, insn, MI, Address, Decoder, &DecodeComplete); \ return S; \ } \ ``` 发现它上边就有 `MCInst_setOpcode(MI, Opc);`, 已经在表中取出来了, 然后在根据 `DecodeIdx` 去填充寄存器. 现在举例说明一下这个状态机的运行过程, 蛋疼的是这个文件不能调试 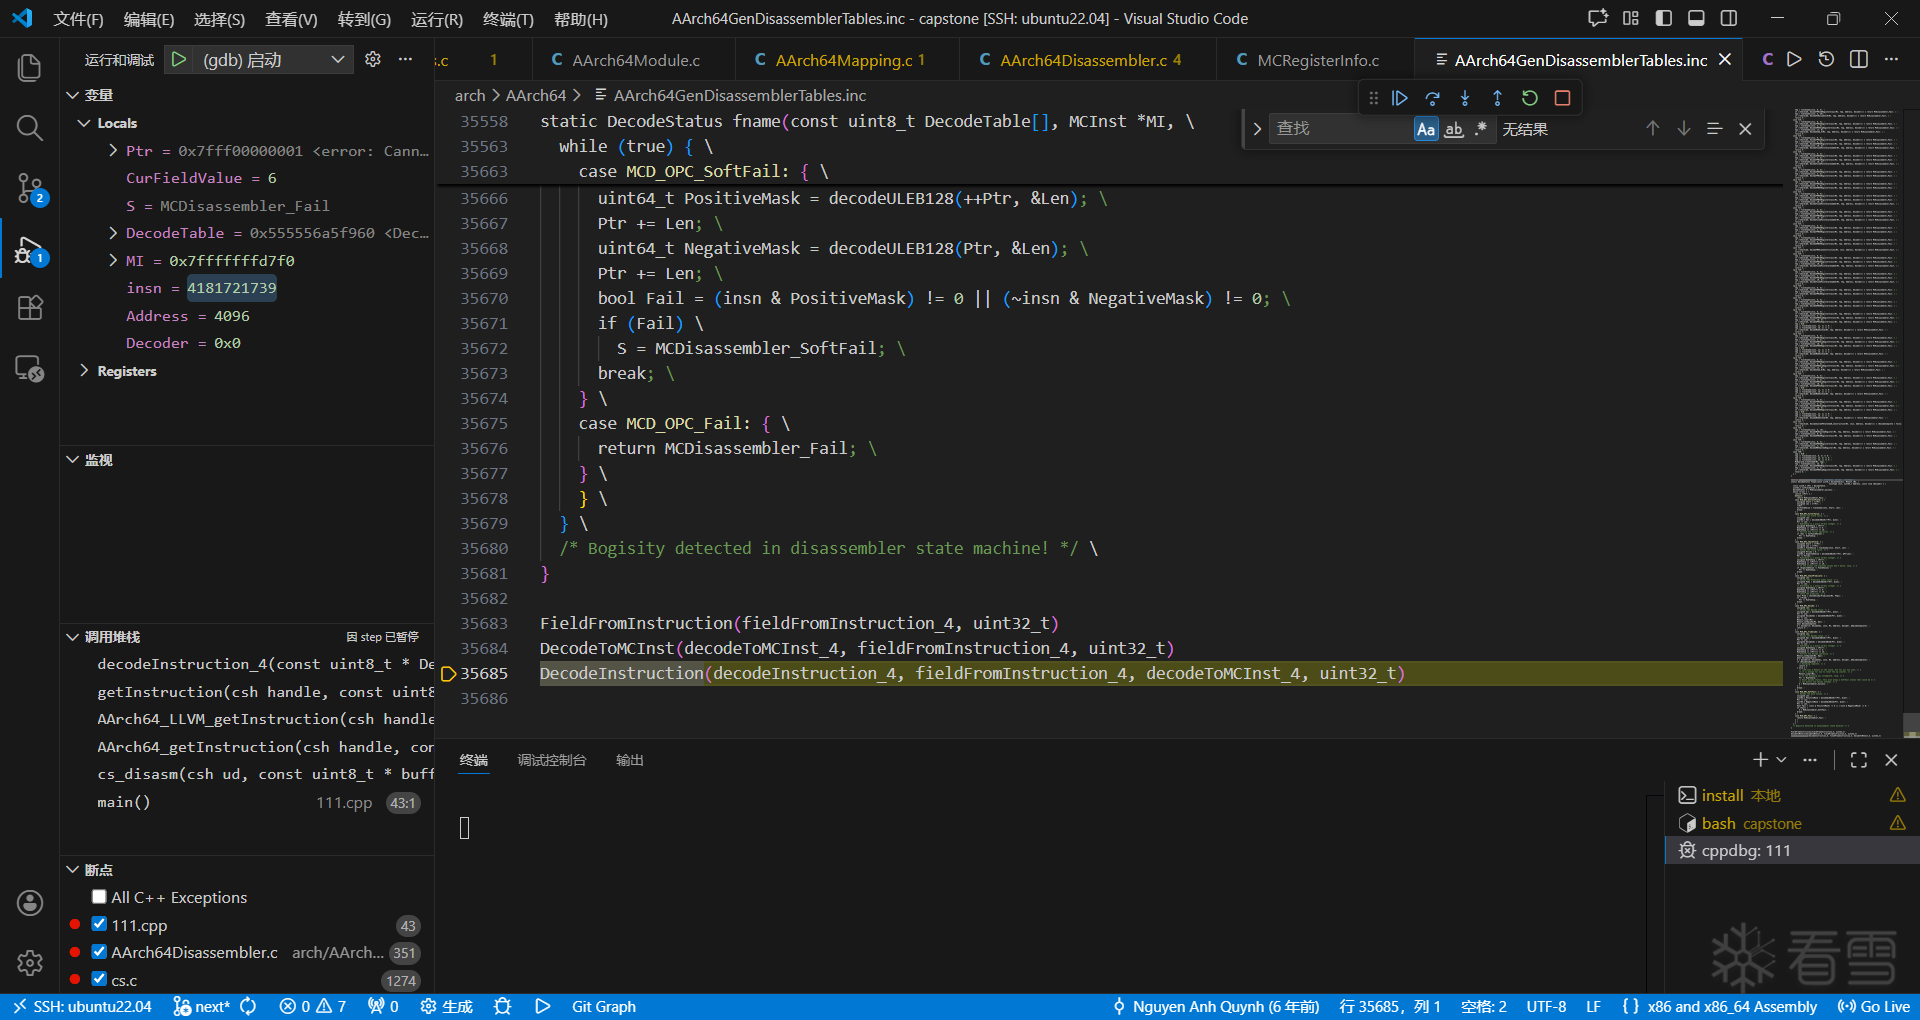 只能静态脑补一下了, 拿这个举例 `0x8B, 0x02, 0x40, 0xF9, // ldr x11, [x0]`, - 状态 1: `MCD_OPC_ExtractField, 24, 2`, 提取位 24-25, 即 Inst{25-24}, 这是 ARM64 加载 / 存储指令的「大类特征位」, 值为 2 对应「无偏移 / 立即数偏移的加载 / 存储指令」 - 状态 2: `MCD_OPC_FilterValue, 2, 1234`(1234 是瞎编的), 若之前提取值 != 2, 跳过上边那两个状态转移表(DecoderTable32, DecoderTableFallback32)的 1234 字节, 匹配成功则进入状态 3. - 状态 3: `MCD_OPC_ExtractField, 26, 3`: 提取位 26-28, Inst{28-26}, 这是 ARM64 加载 / 存储指令的「子类特征位」—— 用于区分 LDR/STR、有符号/无符号偏移、寄存器偏移等细分类型. - 状态 4: `MCD_OPC_FilterValue, 7, 1234`: 同 `状态 2`, 7 代表「无偏移 LDR 指令」的特征值, 到这步精准锁定当前指令是「无偏移的 64 位加载指令」 - ......这样以此类推, 还有提取寄存器之类的操作, 不在一一赘述. 可以看到 capstone 是一个线性反汇编器而非递归下降反汇编器!
回复或点赞可查看完整内容
冰与火的战歌:Windows内核攻防实战高级班!从零到实战,融合AI与Windows内核攻防全技术栈,打造具备自动化能力的内核开发高手。
最后于
2025-11-18 09:27 被nothing233编辑 ,原因: 补充
#基础理论
#源码框架
收藏
・
8
点赞
・
46
打赏
分享
分享到微信
分享到QQ
分享到微博
赞赏记录
参与人
雪币
留言
时间
mb_dvqqrcce
谢谢你的细致分析,受益匪浅!
2026-9-11 17:13
git_51951meggadf3df
非常支持你的观点!
2026-9-11 12:14
张楚岚.
为你点赞!
2026-9-8 14:31
mb_lthgjpwj
为你点赞!
2026-8-20 17:32
wx_Mark_449
为你点赞!
2026-8-18 17:56
mb_wsoacceo
为你点赞!
2026-8-8 01:26
Wika
为你点赞!
2026-7-31 15:26
afishlong
期待更多优质内容的分享,论坛有你更精彩!
2026-7-14 03:48
mb_hsscwjpz
非常支持你的观点!
2026-7-9 20:57
ulong9527
为你点赞!
2026-6-26 12:10
zhongdong
为你点赞!
2026-6-19 13:55
wjdidi
感谢你的贡献,论坛因你而更加精彩!
2026-5-7 00:37
边缘
这个讨论对我很有帮助,谢谢!
2026-4-6 19:53
Dy1an
你的帖子非常有用,感谢分享!
2025-12-25 10:51
Eureka777
期待更多优质内容的分享,论坛有你更精彩!
2025-12-8 11:37
sunkc99
这个讨论对我很有帮助,谢谢!
2025-12-4 09:59
Qira
感谢你的积极参与,期待更多精彩内容!
2025-12-1 11:52
卡卡骨
你的分享对大家帮助很大,非常感谢!
2025-12-1 10:35
tamori丶
感谢你分享这么好的资源!
2025-11-28 11:31
Eluvies
非常支持你的观点!
2025-11-23 19:07
z221x
为你点赞!
2025-11-22 15:01
Old_Yuan
非常支持你的观点!
2025-11-21 17:49
奋斗小菜鸟
你的帖子非常有用,感谢分享!
2025-11-21 17:04
ldljlzw
这个讨论对我很有帮助,谢谢!
2025-11-21 09:03
npc0vo
感谢你分享这么好的资源!
2025-11-20 22:29
gtict
这个讨论对我很有帮助,谢谢!
2025-11-19 10:50
pexillove
谢谢你的细致分析,受益匪浅!
2025-11-19 08:39
周旋久
感谢你的贡献,论坛因你而更加精彩!
2025-11-18 18:53
tfflowers
谢谢你的细致分析,受益匪浅!
2025-11-18 14:00
fu11p7r
你的帖子非常有用,感谢分享!
2025-11-18 10:23
哈哥
为你点赞!
2025-11-18 09:49
ONewTach
感谢你分享这么好的资源!
2025-11-18 09:02
mb_bppcorlj
你的帖子非常有用,感谢分享!
2025-11-18 00:55
mb_cfjwplfo
为你点赞!
2025-11-17 21:58
我的小拇指啊
感谢你的积极参与,期待更多精彩内容!
2025-11-17 20:53
eummmm
感谢你分享这么好的资源!
2025-11-17 18:00
huangyalei
为你点赞!
2025-11-17 16:14
东方玻璃
感谢你的积极参与,期待更多精彩内容!
2025-11-17 16:02
git_47499test-look
感谢你分享这么好的资源!
2025-11-17 14:58
逆向小玖
感谢你分享这么好的资源!
2025-11-17 14:46
拾海
感谢你的贡献,论坛因你而更加精彩!
2025-11-17 14:35
tuosen
为你点赞!
2025-11-17 14:31
Harpe
为你点赞!
2025-11-17 14:10
梦_魇
期待更多优质内容的分享,论坛有你更精彩!
2025-11-17 14:05
墨穹呢
谢谢你的细致分析,受益匪浅!
2025-11-17 13:57
iCookiie
你的帖子非常有用,感谢分享!
2025-11-17 13:57
查看更多
赞赏
×
1 雪花
5 雪花
10 雪花
20 雪花
50 雪花
80 雪花
100 雪花
150 雪花
200 雪花
支付方式:
微信支付
赞赏留言:
快捷留言
感谢分享~
精品文章~
原创内容~
精彩转帖~
助人为乐~
感谢分享~
最新回复
(
13
)
丶咖啡猫丶
雪 币:
2751
活跃值:
(3951)
能力值:
( LV2,RANK:10 )
在线值:
发帖
1
回帖
177
粉丝
4
关注
私信
丶咖啡猫丶
2
楼
666
2025-11-17 13:53
0
wx_插曲
雪 币:
411
活跃值:
(861)
能力值:
( LV2,RANK:10 )
在线值:
发帖
2
回帖
316
粉丝
24
关注
私信
wx_插曲
3
楼
6666
2025-11-17 13:58
0
thouger_
雪 币:
9
能力值:
( LV1,RANK:0 )
在线值:
发帖
0
回帖
34
粉丝
0
关注
私信
thouger_
4
楼
牛逼
2025-11-17 14:02
0
mb_ldbucrik
雪 币:
6
能力值:
( LV1,RANK:0 )
在线值:
发帖
0
回帖
691
粉丝
7
关注
私信
mb_ldbucrik
5
楼
感谢分享
2025-11-17 19:33
0
KanXue_NG
雪 币:
661
能力值:
( LV1,RANK:0 )
在线值:
发帖
7
回帖
100
粉丝
66
关注
私信
KanXue_NG
7
楼
学习学习
2025-11-18 13:57
0
GEKEZYX
雪 币:
0
能力值:
( LV1,RANK:0 )
在线值:
发帖
0
回帖
154
粉丝
0
关注
私信
GEKEZYX
8
楼
666
2025-11-20 16:04
0
git_56402Syy040316
雪 币:
0
能力值:
( LV1,RANK:0 )
在线值:
发帖
0
回帖
34
粉丝
0
关注
私信
git_56402Syy040316
9
楼
666
2025-11-21 10:37
0
温泉划水鱼
雪 币:
84
能力值:
( LV1,RANK:0 )
在线值:
发帖
6
回帖
224
粉丝
28
关注
私信
温泉划水鱼
10
楼
太强啦
2025-12-5 20:16
0
fengvmu
雪 币:
5883
活跃值:
(3710)
能力值:
( LV2,RANK:10 )
在线值:
发帖
0
回帖
69
粉丝
0
关注
私信
fengvmu
11
楼
666
2025-12-21 12:32
0
Iceshara
雪 币:
4967
活跃值:
(3282)
能力值:
( LV2,RANK:10 )
在线值:
发帖
3
回帖
33
粉丝
1
关注
私信
Iceshara
12
楼
666
2026-2-12 22:02
0
mb_ifjlatem
雪 币:
10
能力值:
( LV1,RANK:0 )
在线值:
发帖
0
回帖
66
粉丝
0
关注
私信
mb_ifjlatem
13
楼
666
2026-3-11 22:09
0
iBa0
雪 币:
1560
活跃值:
(5833)
能力值:
( LV4,RANK:40 )
在线值:
发帖
6
回帖
482
粉丝
37
关注
私信
iBa0
14
楼
123
2026-4-6 19:49
0
游客
登录
|
注册
方可回帖
回帖
表情
雪币赚取及消费
高级回复
返回
nothing233
1
17
发帖
18
回帖
90
RANK
关注
私信
他的文章
[原创]LLVM: ADCEPass
2454
[原创]llvm: InstSimplifyPass
3781
[原创]一个 ELF 文件的运行
34835
[原创]capstone学习: 反汇编器如何实现的
15458
[原创]chromium 的启动
3257
关于我们
联系我们
企业服务
看雪公众号
专注于PC、移动、智能设备安全研究及逆向工程的开发者社区
看原图
赞赏
×
雪币:
+
留言:
快捷留言
为你点赞!
返回
顶部