首页
课程
问答
CTF
社区
招聘
峰会
发现
排行榜
知识库
工具下载
看雪20年
看雪商城
证书查询
登录
注册
首页
社区
课程
招聘
发现
问答
CTF
排行榜
知识库
工具下载
峰会
看雪商城
证书查询
社区
二进制漏洞
发新帖
19
7
[原创]fuzzing原理探究(上):afl,afl++背后的变异算法
发表于: 2024-11-9 16:34
15135
[原创]fuzzing原理探究(上):afl,afl++背后的变异算法
是气球呀
4
2024-11-9 16:34
15135
# 前言 对于防御者来说,现有的内存损坏和控制流劫持保护措施提供的保护并不 完整。对于软件开发人员来说,手动代码分析无法扩展到大型程序。这些漏洞 可能被恶意攻击者利用,导致数据泄露、系统崩溃,甚至是更严重的安全事 件。 fuzzing 技术,作为一种无需静态分析、动态调试等手段,却能有效识别和 暴露软件程序中的潜在漏洞和安全问题的技术,正广泛应用于安全实践之中。 Fuzzing 技术本身也正在快速迭代,但论真正划时代意义的工具,非 AFL 莫 属。作者虽然没有以论文形式发表该成果,但是通过该项目的技术细节文档, 可以轻松看懂每部分的逻辑。并且,AFL++整合了 AFL 的各类插件,实现兼容 性、性能和变异能力的提升,并改进了遗传算法中变异的自定义方案,方便研 究人员进行二次开发 # 1 Fuzzing 的历史和发展 为了更好地理解fuzzing技术,首先从最原始的fuzzing流程开始: 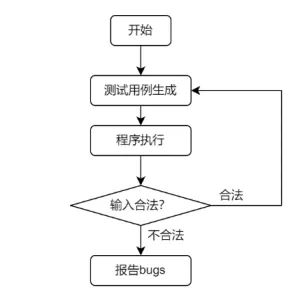 简单来说就是,使用某种规则来生成测试用例,然后提供给程序进行执行,观察程序是否 崩溃,如果发生了崩溃,就报告 bugs,否则直接进入下一轮的循环。流程确实是非常简单,但最难的是,怎么去生成能触发漏洞的测试用例呢?这就是形成fuzzing算法之间效果差异的地方,这最核心的部分算法的目的是不断地往触发崩溃的方向去制作出新的测试样例。该部分主要有两种派别,分别采用了变异(代表如afl、afl++)/生成(代表如boofuzz)算法。 Fuzzing 技术的发展可以分为以下几个阶段 ## 1.1 早期(1980s) 1989 年,Barton Miller 等人在《An Empirical Study of the Reliability of UNIX Utilities》一文中首次提出 Fuzzing 概念,并通过随机输入发现了多个 UNIX 工具的崩溃问题。这一研究揭示了 Fuzzing 作为漏洞检测工具的潜力。 ## 1.2 理论深化与工具开发(1990s) 随着 Fuzzing 概念的传播,研究者们开始深入探讨其理论基础,开发了许多 早期 Fuzzing 工具,如 SPIKE 和 Peach。1998 年,Michael Sutton 等人在 《Fuzzing: Brute Force Vulnerability Discovery》一书中详细探讨了 Fuzzing 的应 用和改进方法。 然而,早期型fuzzing技术采用的盲目随机突变,不太可能达到测试代码中的某些代码路径,从而使一些漏洞完全超出了该技术的范围。 ## 1.3 灰盒 Fuzzing 的兴起(2000s) 后来,人们渐渐发现覆盖率引导模糊测试(Coverage-Guided Fuzzing)为最有效 的软件漏洞发现方法之一,因为它能够系统地探索未测试的代码路径和边界条 件,从而显著提高漏洞发现的效率和成功率。 为了提高 Fuzzing 的效率和有效性,研究者引入了灰盒 Fuzzing 技术,通过 插桩和反馈机制来优化输入生成策略。2007 年,Zalewski 发布了 AFL (American Fuzzy Lop),这是一种采用灰盒 Fuzzing 技术的工具,大大提高了 Fuzzing 的覆盖率(Coverage)和漏洞发现率。 ## 1.4 现代 Fuzzing(2010s 至今) 现代 Fuzzing 工具结合了先进的变异算法、分布式计算和云服务等,实现了高 效的大规模漏洞检测。工具如 libFuzzer和 Honggfuzz在 Google 和其他大型 科技公司中广泛应用,为软件安全性提供了强有力的保障。 AFL、AFL++主要是采用变异策略来生成测试样例,它们效果为什么这么好?AFL++为什么相较于AFL改进如此巨大?接下来的部分将试图弄清其中的来龙去脉。 # 2 AFL:遗传算法与确定性变异策略 ## 2.1 AFL-Fuzz简介 American fuzzy lop (AFL) 是一个开源的模糊测试工具,采用遗传算法以有效地提高测试用例的代码覆盖率。目前为止,它帮助检测了数十个主要软件项目中的重大程序错误,包括X.Org Server、PHP、OpenSSL、pngcrush、bash、Firefox、BIND、Qt和SQLite等。 其执行流程大致如下: 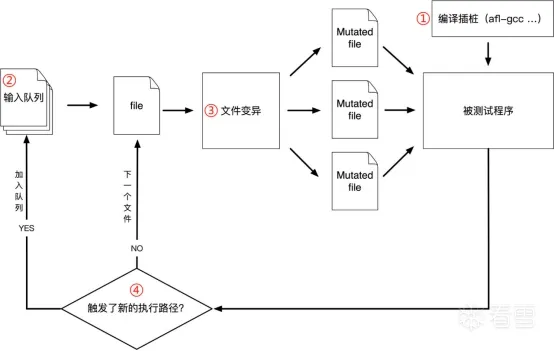 ①在从源码编译程序时进行插桩,以记录代码覆盖率(Code Coverage)。 ②选择一些输入文件作为初始测试集,加入输入队列(queue)。 ③对队列中的文件按一定策略进行“突变”。 ④如果变异文件扩展了覆盖范围,则将其保留并添加到队列中。 ⑤上述过程循环进行,期间触发 crash 的文件会被记录下来。 其核心主函数为fuzz_one(),示例图如下: 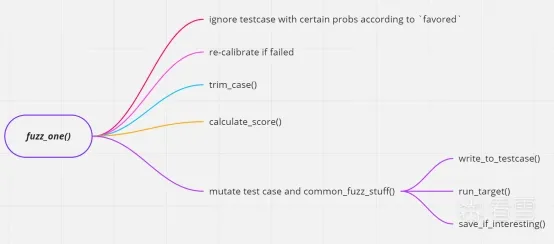 fuzz_one(queue_entry *q):获取测试用例并喂给目标程序,根据优胜者机制按概率跳过。调用trim_case剪枝,calculate_score打分,然后进行变异(如bitflip、arithmetic inc/dec等),变异后调用common_fuzz_stuff处理结果。这是主要函数。 以下是值得关注的函数,如何对数据进行剪枝,如何评估测试用例并优选种子,等等 trim_case():对当前测试用例进行剪枝,以减少无效数据。 calculate_score():计算测试用例得分。根据执行时间、覆盖率、新路径和深度对测试用例评分,确保高潜力的测试用例在变异过程中获得更多机会。 save_if_interesting():保存有趣的测试用例。检查执行结果是否有趣,即,调用has_new_bits(virgin_bits)来判断是否产生了新的路径元组,若是则保存或加入队列。trace_bits指向由全体进程共享的内存区域,其中包含每次样本执行的覆盖率,其实是之后提到的覆盖次数桶的压缩存储。 ## 2.2 插桩技术 既然要进行覆盖率的引导来辅助遗传算法的进化过程,就必须统计覆盖率,而如果想要记录这一数值,就需要用到插桩技术,插桩一共有三种模式:llvm mode,汇编层面插桩,qemu-mode动态插桩。 ### 2.2.1静态插桩 有两种静态插桩方式:llvm mode,汇编层面插桩。 如果拥有受测试程序的源代码,可以使用静态插桩技术来实现覆盖率的记录和增强,这一功能被AFL项目命名为llvm mode,具体实现方式是借助LLVM的Pass来更改中间代码表示IR(Intermediate Representation),从而在编译过程中实现插桩。 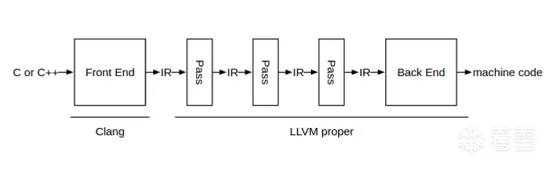 在有源代码的情况下,可以使用 AFL 自带的 afl-gcc 或 afl-clang 插桩方式,这些工具通过修改 GCC 或 Clang 编译器,在编译过程中插入覆盖率收集代码,性能介于 QEMU 动态插桩和 LLVM 静态插桩之间。 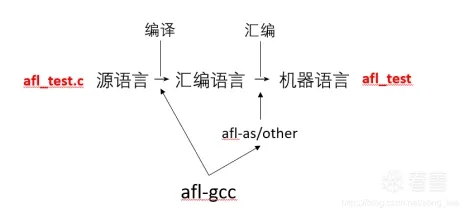 接下来详细叙述怎么进行汇编层面插桩。实际的插桩工作发生在汇编为机器语言的环节。查看该项目的afl-as.h头文件,可以看到,以下这段内容是AFL插入到每个代码块结束处的汇编代码,其调用(call指令)__afl_maybe_log,这个正是探测点(Probe Points)相关汇编代码。 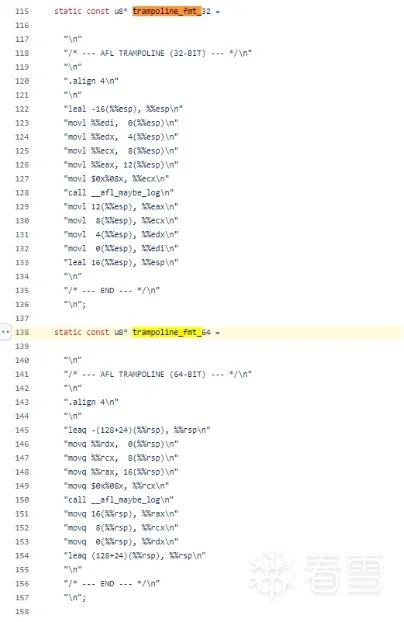 从控制流的角度来看,代码块(code block)是一个或多个语句的集合,这些语句按照程序的逻辑顺序一起执行。代码块的基本功能是将一系列操作组织在一起,以实现特定的功能或操作。代码块的控制流主要涉及语句的顺序执行、条件分支和循环。 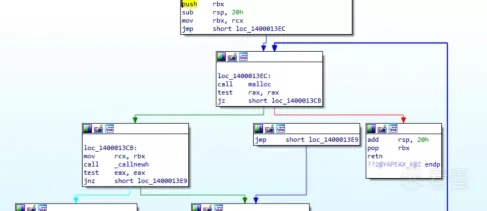 该源代码插桩方式正是将所有代码块的开始部分进行插入,因为插入点位于基本块的开始处,可以准确记录程序执行到这个代码块的次数和路径。 而对于分支(如)和函数调用的插桩,AFL会把所有函数调用都进行插桩,但分支的数量往往比较巨大,为了让用户能够按需进行性能和插桩完整程度的权衡,AFL提供了一个值inst_ratio_str ,这个值用于控制对分支的插桩比例,R(100)是0-100随机值,如果>inst_ratio_str则不进行插桩,这就完成了按概率来进行对分支的插桩。其代码逻辑如下 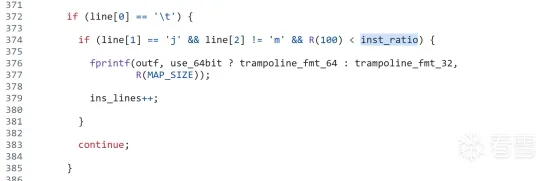 此外,对于LLVM插桩,跟随afl-llvm-rt.o.c查看LLVM Pass层次的实现代码,实际上可以发现,很多内容都是用c来表示的,但功能和先前的汇编差不多,比如插桩比例的控制: 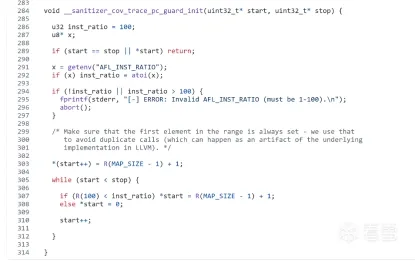 又比如forkserver与父进程的等待和通信,这些内容将会在接下来进行详细叙述。 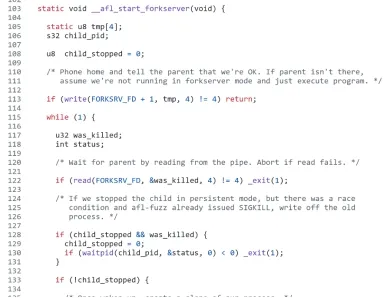 ### 2.2.2动态插桩 在没有源代码的情况下进行插桩,被称为唯二进制插桩 (Binary-only instrumentation)。AFL 的作者对 QEMU(一种跨架构软件执行环境工具,也可称为”跨架构二进制翻译器”)进行了二次开发,使其具备二进制插桩的能力。具体而言,是对QEMU 使用基础块(basic blocks)作为翻译单元。直接查看其二开的QEMU不太方便,查看technical_details.txt说的概念: 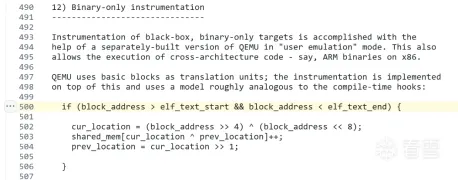 if (block_address > elf_text_start && block_address < elf_text_end) 这一判断是为了确保当前基础块的地址在可执行代码段(.text 段)内,以过滤掉不相关的地址。 紧接着,cur_location = (block_address >> 4) ^ (block_address << 8); 通过移位和异或运算计算当前基础块的位置。这种计算方式生成一个相对唯一的标识符,用于标识当前基础块。 shared_mem[cur_location ^ prev_location]++;使用当前块的位置与前一个块的位置进行异或运算,更新共享内存中的覆盖率信息。shared_mem 是一个共享内存区域,用于记录不同路径的执行次数。 prev_location = cur_location >> 1;更新前一个块的位置,以便在下一个基础块执行时进行正确的覆盖率计算。其实现的正是QEMU下的覆盖率引导计算,相关内容在后面还会详细说明。 本身的二进制翻译器如 QEMU、DynamoRIO 和 PIN 启动较慢,为了弥补这一点,AFL 在 QEMU 模式下使用了 fork server和管道机制,前面已作详细说明。经过这些优化,QEMU 模式下的 AFL 开销是白盒模式(有源代码插桩fuzzing)的 2-5 倍,而使用 PIN 的开销则高达 100 倍以上。 ## 2.3 eff_map对变异的影响 这里还要引入一个eff_map的概念,此项记录了每个字节是否引起了新路径元组的出现,用以评估其对整个执行路径元组的影响。如果 byte 尝试所有改变都没有出现新路径,AFL开发者认为这种字节很有可能只是单纯的非元数据,AFL后续会参考eff_map 进行选择性的跳过。接下来每次变异都会检查eff_map中的对应项 ,如果当前字节对应的项为 0 ,则检查变异以后路径是否有新元组产生,如果是则置为 1。 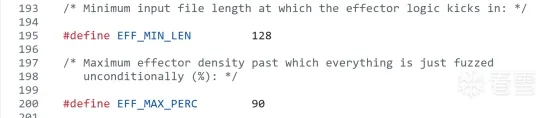 而且,eff_map会将输入测试用例文件小于128字节的情况,认为每个字节都是有效的,而如果一个测试用例,90%的字节都能触发新路径元组,那么AFL会直接把剩余的10%也认为是有效的。 这种做法改善了变异的方向性,使其能够避免过多的无效变异,从而更加专注于有效的变异。 ## 2.4 输入队列变异 在完成上述步骤以后,AFL会对测试样例进行变异操作。 这部分的内容更像是经验主义的产物,没有什么比较有意思的细节,但被实践证明是高效率的,因而被采纳。主要的代码逻辑仍位于afl-fuzz.c。 ### 2.4.1 简单位翻转(simple bitflip)变异 首先是简单的位翻转(Simple Bitflip),该操作是之后一系列变异方式的基础 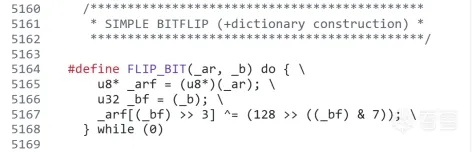 该定义宏实现了指定位翻转的功能,_ar传入需要进行位翻转操作的字节数组指针,_b则是要翻转的位置。实际上该定义宏常见于各项目,不再赘述。 由简单翻转衍生出的变异模式有: bitflip 1/1:步长为 1 bit,每次翻转 1 bit。 bitflip 2/1:步长为 1 bit,每次翻转相邻的 2 bit。 bitflip 4/1:步长为 1 bit,每次翻转相邻的 4 bit。 bitflip 8/8:步长为 1 byte,每次翻转 1 byte,并检查效应图(eff_map)。 bitflip 16/8:步长为 1 byte,每次翻转相邻的 2 byte。 bitflip 32/8:步长为 1 byte,每次翻转相邻的 4 byte。 此处以bitflip 4/1为例: 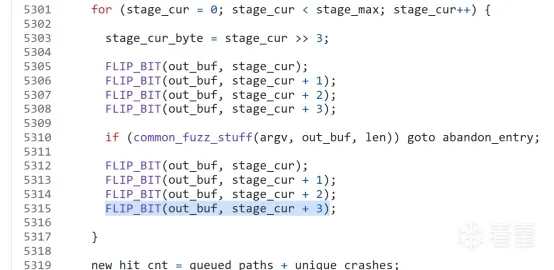 实现的就是步长总长度1byte,每次翻转这1byte里面连续的4bits。实际上其它的位翻转变异实现功能上是大同小异的,细节可能稍微有点不一样。common_fuzz_stuff实际上正如其名,是在检测fuzz是否成功触发新路径,如果是,那么就记录该路径并放弃继续变异,这次变异的结果也会被保存。 该操作的剩余部分的作用将在字典变异里提及,此处按下不表。 ### 2.4.2 加减法变异 加减法变异,就是对测试用例做加减法方面的变异;为了避免无意义的重复变异,使用could_be_bitflip来检查变异结果与位翻转重合的部分(比如+4就等于在低第3位把0变为1,这样就重合了);而且会限定大致的加减法变异范围,默认是从-35尝试到+35。该变异分为arith 8/8、arith 16/8、arith 32/8,步长都是1 byte,而范围分别对应byte、word、double word的现实情况,比如短、中等、长整形值的变化,字母abcd的横向变动,等等。以arith 8/8为例,观察其实现: 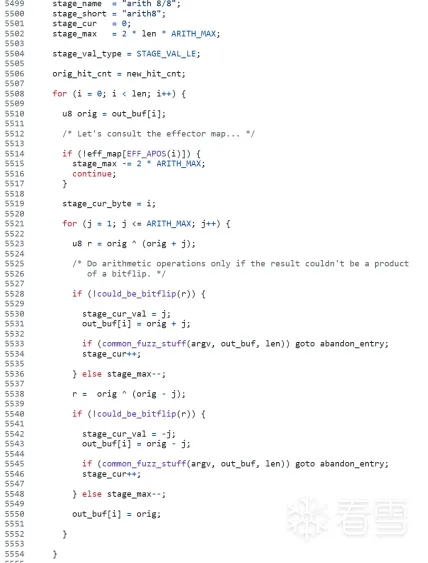 这里最关键的实现是,ARITH_MAX 控制了变异的范围和次数,j 的值每次递增 1,步长为 1 字节。通过 r = orig ^ (orig + j) 进行异或运算,将原始值和加法变异后的值进行异或,从而得到它们之间所有不同的位。然后使用 could_be_bitflip(r) 判断这些不同的位是否可以通过位翻转实现同样的加法变异,从而实现变异上的去重。 最后,真正记录变异的是步骤 out_buf[i] = orig + j 和 out_buf[i] = orig - j。这种方法确保了每次变异操作的唯一性和有效性,通过排除可以通过简单位翻转实现的变异,优化了变异过程。 ### 2.4.3 特殊值(interesting values)变异 这部分就是将数值替换为预先定义好的“有趣的”值,这些特殊值比较容易引起软件的崩溃,非常值得测试。同时,这一部分会使用could_be_bitflip、could_be_arith与之前的阶段进行去重。特殊值如下,可以看出来这些变异对控制长度的字段将会十分有针对性,能测试出比如常见的输入边界没有控制好的问题,导致最后一个字节可以写入到超出预期的内存空间,那么就导致了内存破坏漏洞的产生,在特定的情况,这种漏洞会成为漏洞利用链的一环。 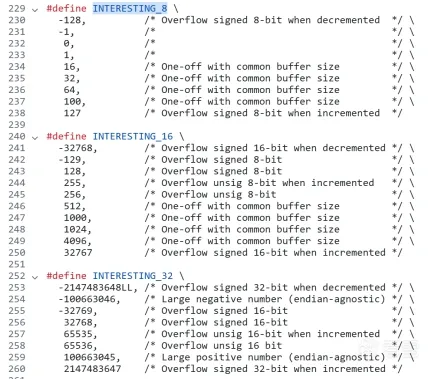 主要有三种,interest 8/8,interest 16/8、interest 32/8,范围分别对应短、中、长整形。以interest 8/8(范围和步长均为8 bits)为例,这部分的代码逻辑主要如下: 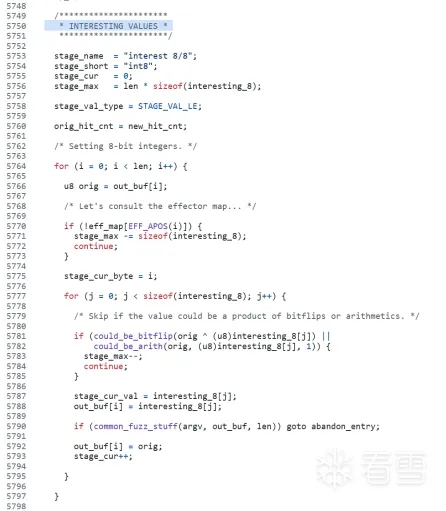 其实这种变异就是直接赋值为预先定义好的interesting值。可以看到是与之前各种变异大同小异的,主要区别是使用了if (could_be_bitflip(orig ^ (u8)interesting_8[j]) ||could_be_arith(orig, (u8)interesting_8[j], 1)) 这个判断来与先前的位翻转变异、加减法变异进行去重。 ### 2.4.4 字典(dictionary stuff)变异 使用字典内容来进行变异,与上一部分针对特殊整型值的变异不太一样的是,这一部分主要是针对一些特殊的、有实际意义的字符串内容来进行变异。 该字典被命名为extras,里面的内容被称作tokens其首先会被按字符串长度从小到大排列,以实现更快速的判断出已经无法放入更长字符串的事实并打断循环。 然后,逐一从该字典中取出字符串,并且采用覆盖 (over)、中间插入(insert,比over显然时间复杂度更高,因为需要移动字符串尾部)的方式来进行测试样例的变异。此处以覆盖型的字典变异的代码实现为例。 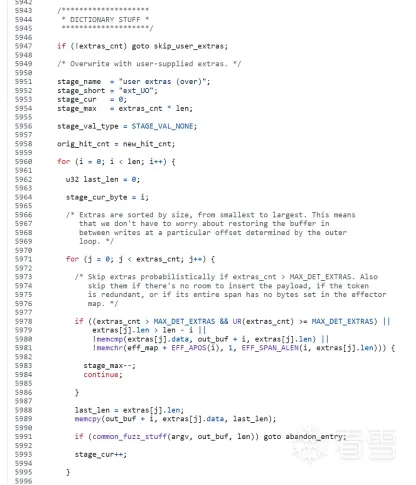 可以看出来 memcpy(out_buf + i, extras[j].data, last_len);就是在测试样例的尾部追加字典内的字符串。而这一部分有一个条件很长的if判断,一个一个来看 条件1:extras_cnt > MAX_DET_EXTRAS && UR(extras_cnt) >= MAX_DET_EXTRAS 这里有一个特性,AFL 会检查 tokens 的数量。如果 tokens 的数量超过预设的 MAX_DET_EXTRAS(默认为200),则针对每个 token,会根据概率决定是否进行替换。UR(extras_cnt) 是一个在运行时生成的随机数,范围在0到extras_cnt之间。根据 MAX_DET_EXTRAS 的设置和UR(extras_cnt)的结果大小进行比对,决定是否跳过对当前 extras[j] 元素的处理。 条件2:extras[j].len > len - i 表示当前位置没有足够的空间来插入 extras[j] 的数据。 条件3:!memcmp(extras[j].data, out_buf + i, extras[j].len)表示要插入的数据已经存在于当前位置,因此不需要重复插入,这样就实现了去重 条件4:!memchr(eff_map + EFF_APOS(i), 1, EFF_SPAN_ALEN(i, extras[j].len))则是查看eff_map有没有认为该处的数据并不重要 而这里还有一个非常有效的方式,用户没有提供字典的时候,会依靠最先前的bitfilp去选择出有效的字符串组成一个字符串的集合(token)。作者在代码注释中进行了解释。 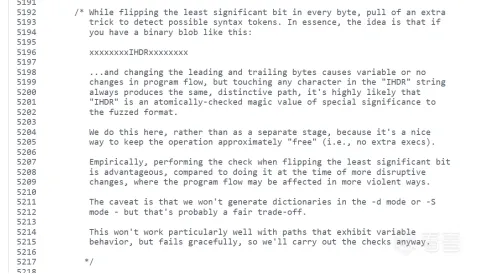 简单举例来说,如果在位翻转变异过程中存在一个字符串:前导字节[IHDR]尾随字节,改变前导和尾随字节导致程序流的变化不大或没有变化,但触及"IHDR"字符串中的任何字符总是产生相同且独特的路径,那么AFL就会把IHDR列入字典变异的考量之中。 接下来,MAX_AUTO_EXTRA限定extras最高的存储容量。这段代码是模糊测试算法的一部分,通过检测校验和变化来收集和处理有意义的自动令牌。它在位翻转影响到执行结果时,收集字节到令牌数组 a_collect,并在令牌长度符合预设范围时调用 maybe_add_auto 函数进行处理。如果校验和发生变化,令牌会被处理并重置收集过程,从而确保只处理有影响的令牌。 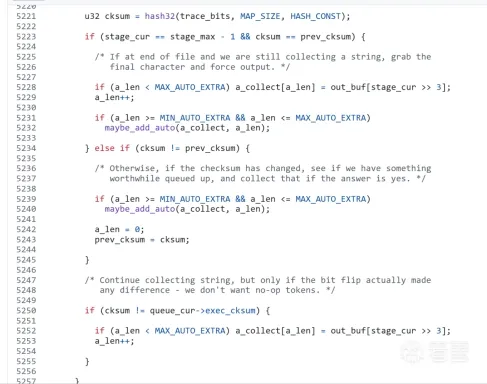 其变异的具体实现与覆盖型字典变异类似,此处不再赘述。 ### 2.4.5 随机毁坏(random havoc)变异 该变异方法只会在启用” dumb mode”时进行,实际上,这个方法与本文重点探讨的遗传算法不一样,这种变异与AFL之前出现的fuzz工具类似,进行随机性非常高的盲目变异而不进行任何筛选。此处不进行详细探讨。 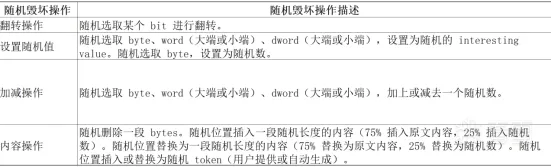 ### 2.4.6 (随机的)拼接(splicing)变异 该变异方法只会在启用” dumb mode”时进行,使用该类变异,把值得尝试拼接的测试用例拼接起来,有时候会有意想不到的效果,并且,在该变异后,紧接着会进行随机毁坏变异。由于该变异方式使用率和fuzzing成功率都较低,此处也不进行详细探讨。 ## 2.5 fork server多进程执行测试样例 插桩完成后,可以通过 afl-fuzz 开始模糊测试。 execve的执行需要系统中断,系统调用,还需要载入目标文件和库、解析符号地址等操作,如果大量的fuzzing测试当中每次都要使用execve,将非常消耗性能。 所以,AFL 实现了一套 fork 服务器机制来减少系统调用的次数,并集中调配资源。其基本思路是启动目标进程后,由目标进程运行一个 fork 服务器,fuzzer 与这个 fork 服务器通信,由 fork 服务器完成 fork 和执行目标程序的操作。父进程 (fuzzer) 和子进程 (目标进程) 通过管道通信,目标进程在准备好后通知 fuzzer 可以开始 fork。 首先,在开始模糊测试时,AFL 使用 execve 启动目标程序,这步操作只执行一次。之后的子进程通过 fork 从已初始化的进程中创建,继承了相同的内存和资源,不需要重新加载目标程序和相关库。 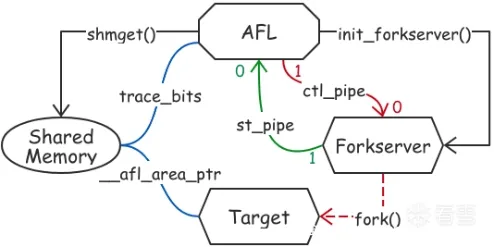 Shared Memory:这是每个子进程之间的共享内存区域,用于子进程之间快速的信息沟通,子进程会通过 shmat() 将共享内存映射到自身地址空间中,便于记录执行路径信息。在子进程中,__afl_area_ptr 用于存储共享内存的地址,该地址指向 trace_bits。共享内存用于存储 trace_bits,这是一个记录每次执行路径的哈希表。 init_forkserver() 函数用于初始化每个独立的 fork 子进程服务器。该函数首先会创建两个管道 st_pipe 和 ctl_pipe,AFL 使用两个管道 st_pipe 和 ctl_pipe 实现父进程与子进程之间的通信。ctl_pipe 用于传递控制命令,而 st_pipe 则用于传递状态信息。通过这些管道,父进程(fuzzer)可以与子进程(目标程序)高效地交换信息。 然后调用 fork() 创建子进程。子进程会执行目标程序,并将管道描述符映射到预定义的文件描述符 FORKSRV_FD 和 FORKSRV_FD + 1。代码实现如下: 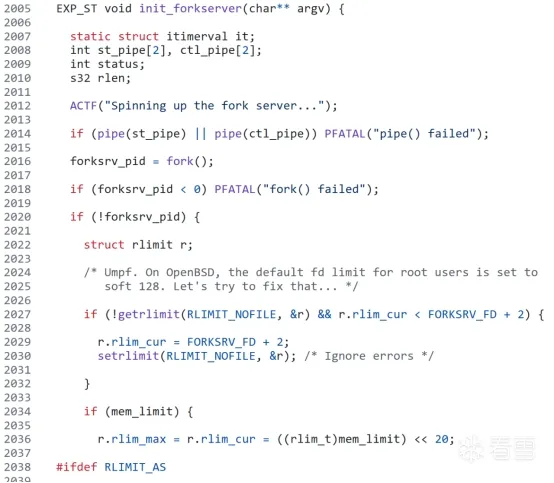 在目标程序启动后,fork 服务器进入等待状态,通过读取 ctl_pipe 等待 fuzzer 的控制命令。一旦接收到开始执行的命令,fork 服务器会调用 fork() 创建一个新的子进程,该子进程负责执行变异后的输入数据。这一等待逻辑是位于插桩位置的。查看汇编代码,这里有一个 __afl_fork_wait_loop 标签,外部通过 jmp 进入该标签。标签的主要功能是调用 read 函数对 FORKSRV_FD 指向的通信管道进行读取,如果读取到来自fuzzer 主进程的指令,则调用 fork 函数。 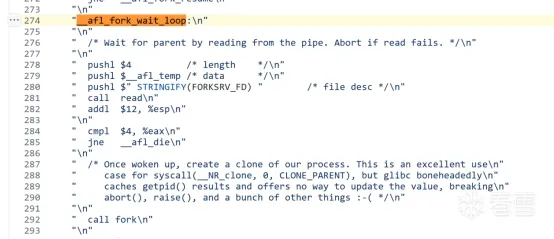 从这里也可以看出,AFL 的 fork 服务器确实是由最初由父进程(fuzzer进程)创建的首个子进程(后称为forkserver)创建更多的子进程来执行测试用例。 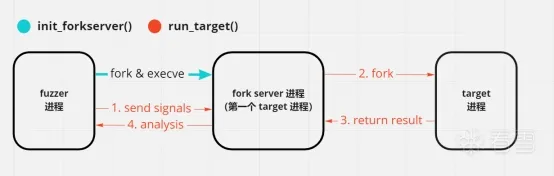 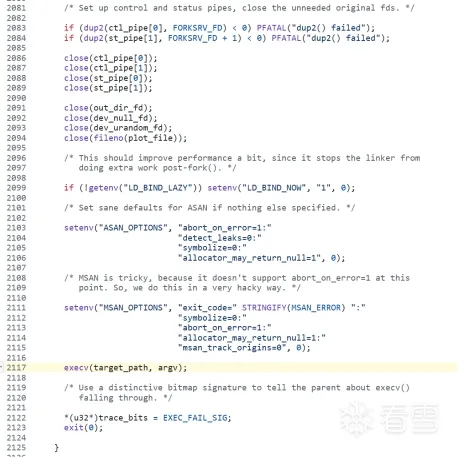 以上代码主要是为 fork 服务器设置控制和状态管道,并执行目标程序。在子进程中,将管道文件描述符重定向到预定义的文件描述符,并关闭不再需要的文件描述符,设置环境变量以优化性能,最终调用 execv 启动目标程序。 ## 2.6 元组命中次数桶 统计元组的命中数目,能发现一些潜在的有趣控制流变化,比如某块代码通常只命中一次,但这次却被执行了两次。但是,统计值的存储需要较高的资源开销,为了更好地把元组命中次数的变化的信息进行区分以鉴别值得关注的数量变化,AFL 将这些命中次数划分为几个桶(bucket):分别对应命中1, 2, 3, 4-7, 8-15, 16-31, 32-127, 128+ 次。比如,如果执行了6次,那就存储到第四个桶;如果执行了77次,那就存储到第七个桶 这种方法显著降低了对一些经验上不重要变化的敏感度,比如循环次数从47次增加到48次。但是命中1次到命中2、3次的变化,在经验上属于是值得关注的。 并且,桶式分类在某种程度上增强了对高密度路径图中元组碰撞的抵抗力。具体来说,不同路径的元组被分配相同哈希值的概率极低,但可能性仍然存在。当路径中的不同元组被哈希到相同的位置时,会发生元组碰撞。通过将元组命中次数划分到多个桶中,即使发生碰撞,仍可以通过命中次数的变化来大致区分这些元组。这减少了碰撞对路径检测精度的影响。 要进行桶式分类,首先,需要一个trace_bits共享内存空间  桶式分类具体实现可以在afl-fuzz.c里找到:使用了指定初始化语法来初始化数组 count_class_lookup8,这个数组的长度为8字节,容纳了0-255次命中的可能性;其将4-7视为8,8-15视为16,等等,实现了先前所述的桶式分类。 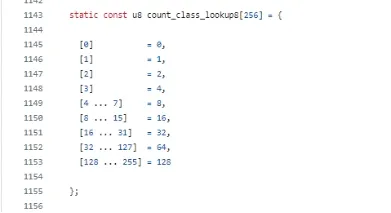 紧接着的count_class_lookup16实现了对该查找方法之上的进一步优化,具体而言,利用了预计算的方式,以空间(一次性计算256个之前提到的count_class_lookup8结构)换时间(查找仅仅需O(1)时间复杂度)。并且为了进一步加强查找效率,采用了同时对两个count_class_lookup8的办法,这里为什么是对两个桶进行同时检查而不是单个桶,也许是经过性能测试的选择,作者团队在白皮书中并没有作讲解。 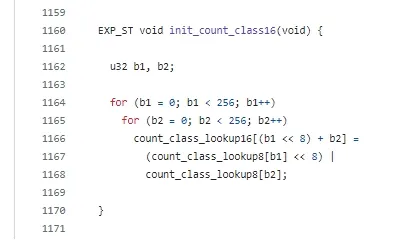 紧接着,针对64位软件fuzz和32位软件fuzz实现了不一样的classify_counts算法,其实就是一次性调用多少次count_class_lookup16有区别,比如16*2=32,16*4=64,都是通过在数组中查表实现对运行次数的快速处理。限于篇幅,仅以64位为例,实现如下图所示 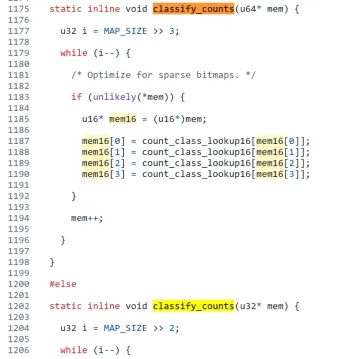 以上,完成了元组命中数统计,并放入指定的存储桶进行大致的分类。 然后,在afl-analyze.c可以看到使用如何生成该存储桶,原来的确是使用trace_bits来做的。其将trace_bits的命中数迅速进行分类, 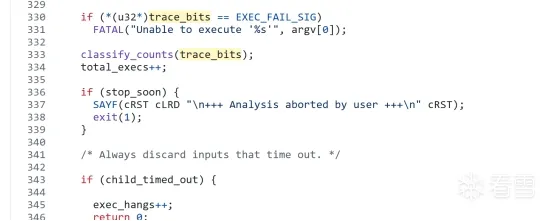 trace_bit的变化会影响到exec_cksum的哈希值 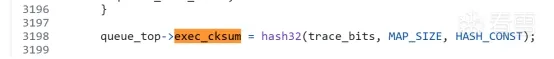 其一旦改变就会触发has_new_bits的逻辑 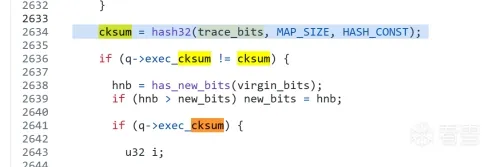 ## 2.7 覆盖率测量与引导 插桩过后,覆盖率如何进行测量?如何进行覆盖率引导?为了实现最低的计算开销,谷歌团队在这部分的实现里使用了大量的优化技术,以最大化利用现代CPU的特性来加速运算。具体来说,他们利用位图记录程序执行路径所包含的元组(tuples),并通过高效的位操作和简化的条件判断来测量覆盖率。在检测到新的路径元组覆盖时,使用启发式方法指导进一步的测试用例变异,从而提高模糊测试的效率和覆盖率。 执行流每次步过先前插桩的探测点,都会触发探测点的__afl_maybe_log,每个路径都分配唯一标识符;然后,如果检测到正在执行某个代码块,直接更改对应标志位即可。这种方法也称为块覆盖率的测量。然而,仅靠这种方法无法分辨经过相同代码块的不同路径,例如 A->B->C->D 和 A->C->B->D 两条路径。而漏洞的产生条件很可能只在某一特定路径上出现。因此,如果 fuzz 程序没有能力区分精确到路径的覆盖率,那么很可能会错过潜在的漏洞点。 记录整个路径会带来巨大的计算和存储开销,特别是在程序路径复杂且多变的情况下,会造成路径爆炸(path explosion)问题。使用元组可以有效减少这种开销,只需记录关键的分支转换,而不需要完整的执行轨迹。 元组(即分支对)能够细粒度地记录程序执行的路径变化。例如,路径 A->B->C->D 和 A->C->B->D 可以通过元组(AB, BC, CD vs. AC, CB, BD)来区分,而不仅仅是记录整个路径。这种细粒度的信息对于发现复杂的状态转换和潜在的漏洞至关重要,因为许多漏洞仅在特定的路径转换中出现。、 当变异后的输入产生包含新元组的执行路径时,对应的输入会被保存。没有触发新的局部状态转变的输入(即没有产生新元组)将被丢弃,即使它们产生了新的全局控制流。这样的方案允许对程序状态进行细粒度的长期探索,同时避免复杂计算、不可靠的全局比较和路径爆炸的问题。 新路径元组检测是通过所有路径共用的shared_mem[]的,在每轮执行过程中共享使用。 比如对于路径1:A->B->C->D,元组是AB、BC、CD 如果经过变异,触发新的路径2: A->B->C-> A,元组是AB、BC、CA 这次路径出现了新的元组CA 那么之后即使存在另一条路径3:A->B->C->D->C-> A,其也仍然会被隐性地丢弃掉,因为它的元组是AB、BC、CD、CA,这条路径对shared_mem[]具体位置的标志效果,与前两条路径发生了重合;换言之,没有触发新的路径元组。这种新路径元组检测的做法使得路径爆炸现象得到极大缓解。 记录元组的出现当然可以借助额外的数据结构或者算法来分辨并记录每对元组的执行顺序,而谷歌团队采用了一种高效的方式来分辨和记录不同的执行路径,而不需要额外的数据结构。 项目里的白皮书technical_details.txt解释了他们是如何进行取巧的。在编译时生成随机数或随机数据的宏或函数以<COMPILE_TIME_RANDOM>指代。shared_mem[]是一个全局数组(用作位图),通过利用当前和前一个位置的异或值,更新共享内存数组中的计数器,记录程序的分支路径(即元组,例如A->B)。那么,利用这种机制,就能标记每一个分支路径的唯一性和频率,从而精确追踪 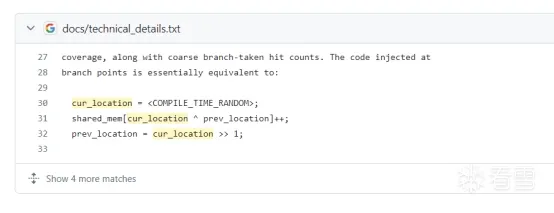 为什么需要移1位呢,众所周知,移位在寄存器上的操作,性能开销极低,而如果想要分清A->B和B->A,那么指定在覆盖率统计的操作时,规定一方进行移位,去异或另一方,那么这种操作就以很低的代价实现了操作的“方向性”。 <COMPILE_TIME_RANDOM>在编译和汇编阶段随着插桩而生成。 而fuzz过程发现新元组的方法实现位于afl-fuzz.c的has_new_bits(u8* virgin_map)方法,用来检查某次输入是否触发新的元组产生。virgin_bits指明了所有未被探索的元组。用全 1 (0xff) 字节来表示未探索的位置,用全 0 字节来表示已探索的位置。 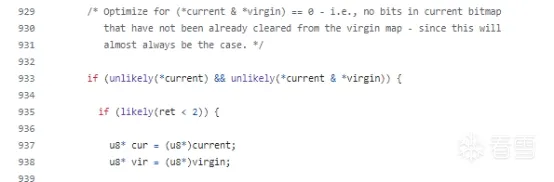 首先,933-939行主要是使用了unlikely宏自定义分支预测以优化CPU性能。大多数情况下,这两个被unlikely包裹的条件都为假,因此通过告诉编译器这些条件不太可能成立,进行分支预测的编译优化,以提高CPU的执行效率。 实际上这里current就是当前状态的trace_bits,记住这一点能帮助理解。 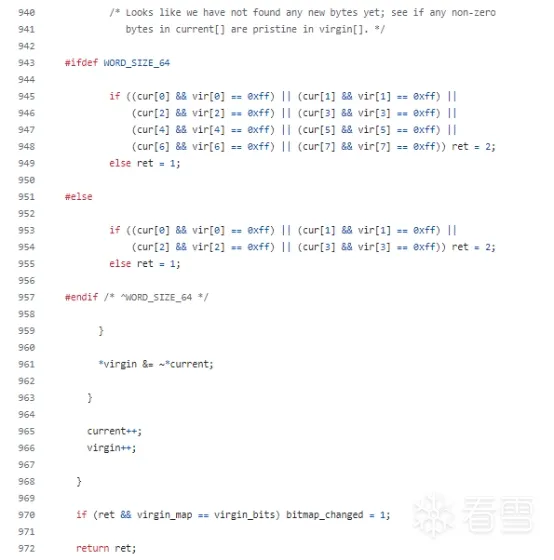 函数首先遍历检查当前执行路径覆盖状态数组 trace_bits 的每一个位。 ret值用于保存上一轮循环的返回值。在这里ret=0是首轮启动初始值,ret=1意思是上次没有发现新元组但又命中了旧元组,即次数发生变化。ret=2即为发现了新元组 对于每个位,如果 current对应位有值(即路径被覆盖过),并且 virgin_map 对应的值为 0xff,表示之前的所有样例都没有覆盖过这条路径,说明发现了新的路径。此时ret = 2。 如果current有值,并且 virgin_map 对应的值为 0x00,表示之前的样例已经覆盖过这条路径,但当前路径覆盖的次数与之前存储的次数不一致,说明发现了路径覆盖次数的变化。此时ret = 1。 ret<2即没有发现新元组是大概率事件,同理用likely包裹以提高CPU执行效率。 32位下和64位下有不一样的细节,但主要思想是相同的,注意”==”运算符的优先级高于”&&”运算符, 最后,通过按位与和取反操作(*virgin &= ~*current)来更新 `virgin` 记录的未被探索的元组,这里不使用字节操作同样是因为位操作极快,可以在一个CPU分片时间里面完成。如果在本轮中某个元组被探索过,则将对应字节置为 0x00。这样就使用当前位图的信息更新了初始位图,并且主函数可以通过返回值获知该路径是否触发了新的路径元组,以指导遗传算法中的优化方向,即以覆盖率增加作为引导条件。以上介绍的has_new_bits是核心的函数之一,接下来还会被使用。 综上所述,AFL 的启发式变异策略通过覆盖率引导实现: 只有当 has_new_bits 返回非 0 时(即测试用例带来了路径命中次数的改变或新路径的发现),测试用例才会被放入测试队列进一步变异。具体而言,save_if_interesting 中调用 has_new_bits 获取返回值,如果为 0,表示本次执行没有新的路径产生,该测试用例不会被放入测试队列或写入磁盘。只有返回 1 或 2 时才会保留测试用例。 这种方法使 AFL 的性能优于盲目模糊测试,基于元组的覆盖率方案也超越了块覆盖率和边覆盖率导向的技术,因为元组包含的信息更有指导意义。 ## 2.8 优胜者策略优选变异种子 尽管增加了一些性能开销,但优胜者策略通过优先处理最可能发现新漏洞的测试用例,完成了测试用例的剪枝并保留最有效的种子进行下一轮变异,显著提高了模糊测试的效率和覆盖率,减少了冗余测试,从而整体上提升了测试的有效性和效果。代码实现中top_rated数组存储的就是针对每条边挑选当前最适合的种子。 其核心思想相当简单:执行时间乘以测试样例长度,即为评价分数。 核心逻辑在update_bitmap_score函数上 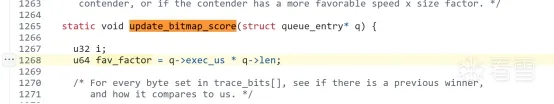 u64 fav_factor = q->exec_us * q->len 计算本次评价分数 然后,使用多个条件对分数进行判断。以下逻辑是与之前最佳测试样例进行分数比较,谁胜出谁就是优胜者,作为最有效的种子被保留下来进行下一轮变异。 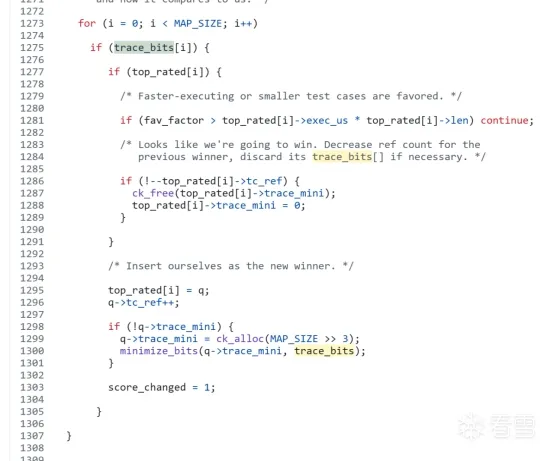 此外,trace_mini就是trace_bit的最小化存储,其指代桶的值。跟进minimize_bits可以看到怎么进行最小化存储的: 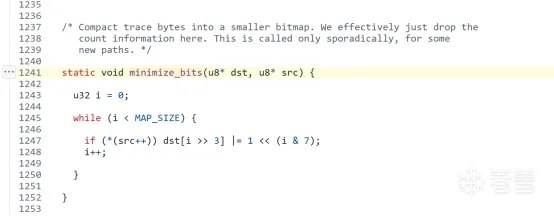 minimize_bits 将 trace_bits 缩减到原来的 1/8 存储到 trace_mini ,但其实信息没有丢失,因为在此之前trace_bits已经按照先前所述的桶结构来简化了。 ## 2.9 AFL复现运行 使用AFL,配合一些pdf测试样例作为种子,对Xpdf的3.02版本二进制可执行文件进行1小时的fuzzing,并查看效果。限于篇幅,Xpdf 3.02、AFL的编译过程略。采用单个pdf文件作为种子,链接如下: <mark class="encrypted">513K9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6%4N6%4N6Q4x3X3g2E0k6h3I4T1M7r3y4Q4x3X3g2G2M7X3N6Q4x3X3g2S2N6g2)9J5c8Y4N6H3i4K6u0V1j5$3!0F1N6r3g2F1N6q4)9J5c8Y4g2H3L8r3!0S2k6s2y4Q4x3V1j5J5x3o6p5%4i4K6u0r3x3e0m8Q4x3V1k6K6L8h3q4D9L8q4)9J5k6r3g2^5j5h3#2H3L8r3g2Q4x3X3c8H3k6r3k6Q4x3X3c8X3K9h3I4W2i4K6u0W2M7r3c8X3</mark> 将变异的起始点种子文件放入~/Templates/,然后用-i参数指定 ~/fuzzing_xpdf/是编译完成后的xpdf文件夹,其中pdftotext 是提取pdf文字的文件,该软件输入一个pdf,会进行pdf的文字处理,此处如果pdf的构造足够特殊,那么就有可能造成各种错误甚至是内存破坏漏洞。 一切准备就绪,在AFLplusplus下执行: ``` sudo ./afl-fuzz -Q -i ~/Templates/ -o ~/fuzzing_xpdf/out/ -s 123 -- ~/fuzzing_xpdf/install/bin/pdftotext @@ ~/fuzzing_xpdf/output ``` 即可开始fuzzing,使用qemu下的动态插桩 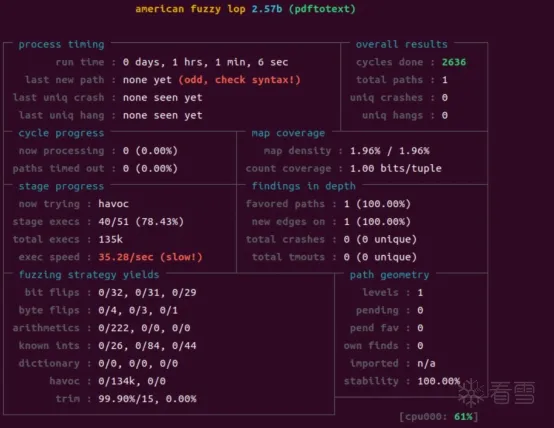 结果令人失望,查看 uniq crashes项,经过一个小时的变异,仍然没有发现pdftotext可能造成的任何崩溃现象。而且观察到程序由于在确定性变异上没有发现漏洞,大部分时间都在无序变异上,这一点与之后的论文所述相符。 其速度平均35.8/sec,这是相当慢的速度,这是因为在之前的确定性变异花费了大量的时间。 其对新的元组的发现也极其低效率,只发现了仅仅一个路径元组。也许之后还要花费巨量的时间来走出局部最优。这和AFL++形成了鲜明的对比。 # 3 AFL++:粒子群算法与非确定性变异策略 自 2017 年 11 月以来,AFL官方版本没有再更新任何功能。2020年,AFL++[12]项目整合了大量的优秀AFL插件,并且改进了变异规则的定义接口,使得在不损失原有优化性能的基础上,让研究者们可以轻松对AFL的变异策略进行修改。截至现在,该项目仍然处于活跃状态。 近年来,AFL++作为AFL的改进版本,凭借其易用性、兼容性、持续更新以及便于二次开发,已成为当前主流的模糊测试工具之一。 ## 3.1 AFL++简介 查看官方文档所述的所有特性,发现其相比AFL做了许多改进:AFL++作为AFL的改进版本,在性能和兼容性方面做出了多项改进:包括更高效的LLVM模式、支持最新版本的LLVM(最高到11)和QEMU 5.1、提升了QEMU的速度与崩溃恢复能力,并增强了对*BSD和Android平台的模糊测试支持。此外,还集成了AFLfast的调度策略,以优化能耗。 在插桩方面,AFL++新增了Unicorn模式,并集成了InsTrim以提高LLVM插桩效率,以及Ngram以改进LLVM的覆盖率统计。CmpLog插桩适用于LLVM和QEMU,其设计灵感源自Redqueen。 在这里主要关注其遗传算法上的改进,因为这关系着漏洞的发现效果,以及覆盖率指标。具体而言,AFL++相比于AFL主要进行了变异策略上的改进。 首先,AFL++允许用户通过库而非 Python 实现自定义变异。具体的API可以在项目里的docs/custom_mutators.md找到。 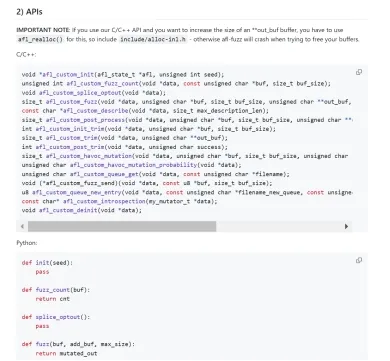 然后,AFL++采用了以下改进:引入了NeverZero补丁,防止覆盖率映射值因某些原因变为零,以避免覆盖率信息丢失和测试效果受影响;MOpt(Mutation Optimization)调度方案作为默认变异模式,引入了一种先进的变异策略;以及由C. Holler提供的afl-fuzz Python变异器模块和llvm_mode白名单支持。 MOpt策略在2019年由Lyu提出[14],其因为性能原因放弃了AFL原有的非随机变异,进而采用粒子群优化(PSO, Particle Swarm Optimization)算法[13]指导速度更快的随机变异,现已作为AFL++默认的变异器,测试发现,MOpt-AFL的速度比AFL默认算法快170%,软件崩溃发现效果更是优于AFL 350%。接下来重点关注该算法。 ## 3.2 PSO粒子群优化算法 ### 3.2.1 PSO粒子群优化算法核心思想 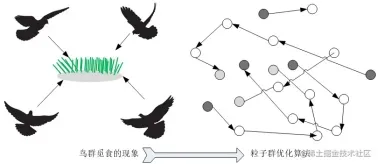 粒子群优化算法(PSO)的核心思想可以通过鸟类觅食的行为来解释。假设一群鸟在一个区域内寻找食物,每只鸟(即粒子)都不知道食物的位置,但它们可以通过以下方式找到食物: 个体最佳位置(Pbest,personal best):每只鸟记住自己在寻找过程中找到的最好的位置(即它们自己找到食物最多的地方)。 全局最佳位置(Gbest,global best):鸟群中的每只鸟都可以知道整个群体中找到的最佳位置(即其他鸟找到的食物最多的地方)。 速度和位置更新:每只鸟根据自己的最佳位置和全局最佳位置调整飞行速度和方向。 具体来说,每只鸟会向它自己找到的最好位置和整个群体找到的最好位置飞去。这种调整使得鸟群逐渐收敛到食物最多的地方。 通过这种机制,整个鸟群可以有效地找到食物最多的地方,即全局最优解。这种算法模拟了群体智能,通过个体之间的信息共享和合作,实现全局优化。 ### 3.2.2 PSO粒子群优化算法大概流程 粒子群优化算法的具体步骤非常简洁: 步骤1:首先,在解空间内随机初始化一群粒子,每个粒子的位置和速度随机生成。 步骤2:评价其适应度,即根据目标函数计算每个粒子的位置; 步骤3:然后,更新每个粒子的个体最佳位置(Pbest),如果当前适应度更好,则更新; 步骤4:接下来更新全局最佳位置(Gbest),如果有粒子的适应度比当前全局最佳位置更好,则更新。 重复步骤2-4,直到满足终止条件(比如,达到最大迭代次数,或找到足够优秀的解)。 PSO通过上述步骤在解空间中不断调整粒子的位置,逐渐逼近全局最优解。这种算法由于简单且易于实现,广泛应用于各类优化问题中。 ### 3.2.3 PSO算法 PSO算法旨在为问题寻找最优解,它使用多个粒子迭代地搜索解空间,其中一个位置是候选解。在每次迭代中,每个粒子基于以下三点移动到一个新位置: 惯性(即移动前的速度vnow) 粒子到其局部最佳位置Lbest(对应前文Pbest)的位移 粒子到全局最佳位置Gbest(对应前文Gbest)的位移 更新速度的方式如下: 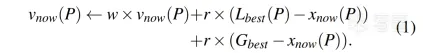 其中,w是惯性的权重,表示对上一个速度的保持程度,即粒子在更新速度时会考虑之前的速度,以保持一定的动量。 这里的r是随机数,通常在0到1之间,用于引入随机性和探索能力。 Lbest(P)是粒子P历史上找到的最好位置,xnow (P)是粒子P当前的位置。 差值Lbest (P) − xnow (P)表示粒子到其局部最优位置的位移,与随机数r相乘从而引入随机性。 差值Gbest − xnow(P)表示粒子到全局最优位置的位移,与随机数r相乘从而引入随机性。 更新位置比较简单,使用v来更新x即可。 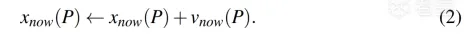 每个粒子向Lbest和Gbest移动随机的距离。多个粒子可以同步工作,避免陷入局部最优,从而引导群体到达最优解。 此外,由于PSO易于实现且计算成本低,非常适合优化突变调度。 ## 3.3 MOpt策略 ### 3.3.1 AFL变异器的缺陷 首先,不同的突变操作符在找到崩溃和路径方面具有不同的效率,使用均匀分布选择突变操作符的模糊器可能会在不高效的操作符上浪费不必要的计算资源。作者团队发现,大多数程序中,bitflip 1/1、bitflip 2/1和arith 8/8变异算子产生的有趣测试用例较多,而bitflip 16/8、bitflip 32/8和arith 32/8等算子产生的有趣测试用例不到2%。加减变异在不同程序上的表现不一致。例如,arith 8/8在exiv2和tiff2bw上表现良好,但在avconv上仅找到12%的有趣测试用例。 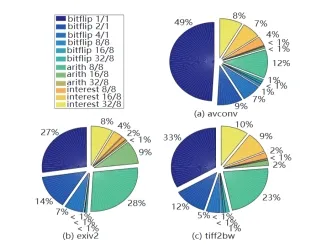 AFL采用三种不同的调度方案来选择和变异测试用例,以适应不同阶段的模糊测试需求。确定性阶段调度器用于首次选择种子测试用例,使用6种确定性变异操作符依次处理。混沌阶段调度器是AFL的主要变异调度方案,决定生成的新测试用例数量后,随机选择变异操作符。拼接阶段调度器在前两个阶段未能发现独特崩溃或路径时使用,通过交叉操作符生成新的测试用例,然后送入混沌阶段调度器。 作者发现,AFL在确定性阶段花费了大量时间。例如,AFL在确定性阶段花费了超过70%的时间。在模糊测试avconv时,AFL在24小时内未能完成第一个输入的确定性阶段。实际上,破坏阶段在找到有趣测试用例方面比确定性阶段更有效。然而,由于在一个输入的确定性阶段花费了过多时间,AFL在模糊测试avconv和pdfimages时,未能从队列中生成后续输入的测试用例。 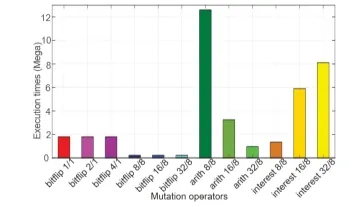 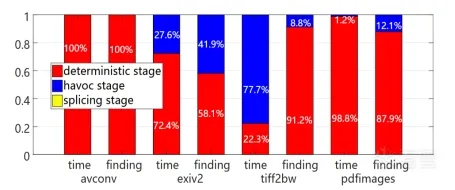 其次,操作符的效率与具体的目标程序有关。每个操作符的效率依赖于它被应用的程序,而这种依赖关系在编写变异规则时很难甚至几乎不可能静态推断出来。最优的突变调度器需要根据每个操作符在目标程序上的实时效率做出决策。此外,在当前测试用例上表现良好的操作符,可能在接下来的测试用例上表现不佳。因此,最优的突变调度器需要依赖操作符的历史效率来计算并选择操作符的最佳概率分布。 综上所述,MOpt有选择地让混沌变异更多地被使用到,而且使用了PSO算法引导混沌变异进行定向的优化。 传统PSO算法中,多个粒子同时探索解空间,而MOPT的群体仅在解空间中寻找一个候选解(即概率分布)。为了避免陷入局部最优的情况,MOPT通过使用多个群体,并对每个群体应用定制的PSO算法。 ### 3.3.2 MOpt问题定义 MOpt的目标是为当前运行的环境选择最佳的突变操作符,从而找到更多有趣的测试用例。简单来说,这个过程可以看作是寻找最优的概率分布,让调度器根据这个概率分布选择下一个要使用的突变操作符来测试目标程序。 MOpt会为每个操作符使用一个粒子,并尝试在预定义的概率空间????????????????, ????max每个操作符的最优位置,显然由于概率的性质,一次迭代中所有粒子的概率总和应归一化为1,0 < ???????????????? < ????max≤ 1。 类似于PSO,MOpt也将粒子找到的最佳位置指定为其局部最佳位置。对于给定粒子,如果一个位置x1在相同调用次数下产生的有趣测试用例多于位置x2,那么x1比x2更好。因此,Lbest是粒子在历史上产生最多有趣测试用例的位置。 MOpt测量每个粒子的局部效率eff_now,即该操作符在一次迭代中产生的有趣测试用例数量除以该操作符的调用次数。作者将最大的eff_now记为eff_best。因此,Lbest是操作符在历史上获得eff_best的位置。 在MOpt中,粒子在不同的概率空间中移动,而不是在同一个空间里,所以和PSO不一样,MOpt没有统一的全局最佳位置。MOpt通过测量每个操作符在所有群体中找到的有趣测试用例数量来评估其全局效率(global_eff),然后计算这些效率的分布。 这正是多群体(multiple swarms)思想的体现。根据这个分布,每个操作符的全局最佳位置(Gbest)被定义为其效率在分布中的比例,这样高效的操作符有更高的选择概率。MOpt的每个群体探索一个候选解,也规避了局部最优问题。 综上所述, MOpt采用多个群体并对每个群体应用定制的PSO算法。在模糊测试过程中,每次PSO迭代执行以下三个额外任务: T1: 定位每个群体中所有粒子的局部最优位置。每个群体内,评估每个粒子在一次迭代中的局部效率eff_now。对每个粒子,将历史上效率最高的位置effbest标记为其局部最优位置Lbest。对应的是PSO的步骤2,评估适应度。 T2: 定位跨群体的全局最优位置。评估每个粒子的全局效率globaleff,并计算这些粒子全局效率的分布。每个粒子在此分布中的比例用作其全局最优位置Gbest。 T3: 选择最佳群体指导模糊测试。评估每个群体在一次迭代中的效率swarmeff(群体效率)。选择效率最高的群体,其在当前迭代中的概率分布用于进一步的模糊测试。 ### 3.3.3 MOpt采用的多群体粒子群优化算法 与PSO原生算法相比,MOpt非常相像,主要是针对每一个粒子进行相应位置和速度的更新。 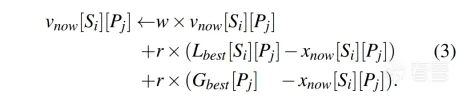 其中,w是惯性的权重,表示对上一个速度的保持程度,即粒子在更新速度时会考虑之前的速度,以保持一定的动量。 Si代表第i个群体,[Si][Pj]代表第i个群体里的第j个个体 这里的r是随机数,通常在0到1之间,用于引入随机性和探索能力。 Lbest[Si][Pj]是粒子P历史上找到的最好位置,xnow[Si][Pj]是粒子P当前的位置。 差值Lbest[Si][Pj] − xnow[Si][Pj]表示粒子到其局部最优位置的位移,与随机数r相乘从而引入随机性。 差值Gbest[Pj] − xnow[Si][Pj]表示粒子到最优位置的位移,这里每个粒子之间的全局最优位置是相互独立的,同样与随机数r相乘从而引入随机性。 更新位置比较简单,使用v来更新x即可。更新位置也是采用位置+速度的方式进行。 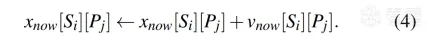 最后,还需要将位置归一化,因为位置对应的其实是概率,确保总和为1。 通过多群体设计,MOPT能够更有效地探索操作符的最佳选择概率分布,提高漏洞发现效率。这一方法使MOPT在处理变异操作符效率问题上表现出色,解决了传统PSO的局限性。 ### 3.3.4 MOpt代码实现 查阅AFL++源码中的afl-fuzz-one.c,可以发现作者增加了pso_updating函数。以下是其实现代码以及一些阅读注释: 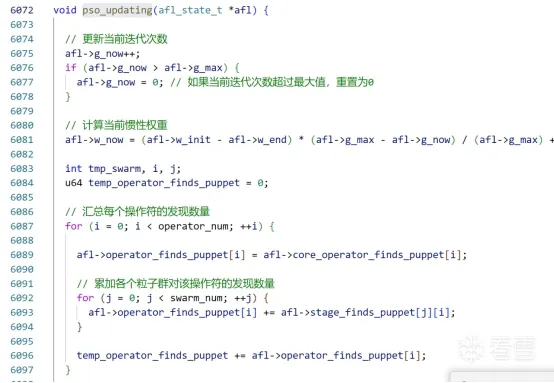 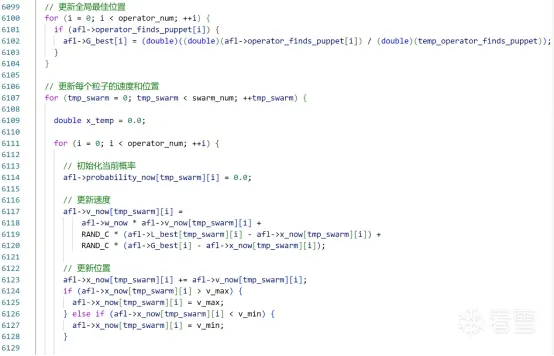 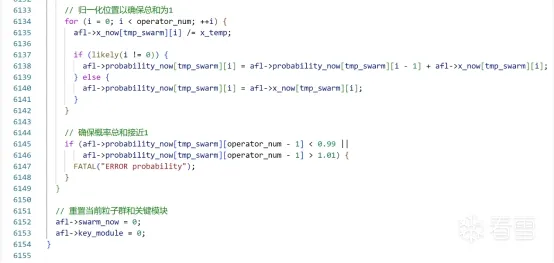 ## 3.4 AFL++复现 使用AFL++默认的MOpt变异模式,配合一些pdf测试样例作为种子,对Xpdf的3.02版本二进制可执行文件进行1小时的fuzzing,并查看效果。限于篇幅,Xpdf 3.02、AFL++的编译过程略。采用单个pdf文件作为种子,链接如下: <mark class="encrypted">a30K9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6%4N6%4N6Q4x3X3g2E0k6h3I4T1M7r3y4Q4x3X3g2G2M7X3N6Q4x3X3g2S2N6g2)9J5c8Y4N6H3i4K6u0V1j5$3!0F1N6r3g2F1N6q4)9J5c8Y4g2H3L8r3!0S2k6s2y4Q4x3V1j5J5x3o6p5%4i4K6u0r3x3e0m8Q4x3V1k6K6L8h3q4D9L8q4)9J5k6r3g2^5j5h3#2H3L8r3g2Q4x3X3c8H3k6r3k6Q4x3X3c8X3K9h3I4W2i4K6u0W2M7r3c8X3</mark> 将变异的起始点种子文件放入~/Templates/,然后用-i参数指定 ~/fuzzing_xpdf/是编译完成后的xpdf文件夹,其中pdftotext 是提取pdf文字的文件,该软件输入一个pdf,会进行pdf的文字处理,此处如果pdf的构造足够特殊,那么就有可能造成各种错误甚至是内存破坏漏洞。 一切准备就绪,在AFLplusplus下执行 ``` sudo ./afl-fuzz -Q -i ~/Templates/ -o ~/fuzzing_xpdf/out/ -s 123 -- ~/fuzzing_xpdf/install/bin/pdftotext @@ ~/fuzzing_xpdf/output ``` 即可开始fuzzing,使用qemu下的动态插桩 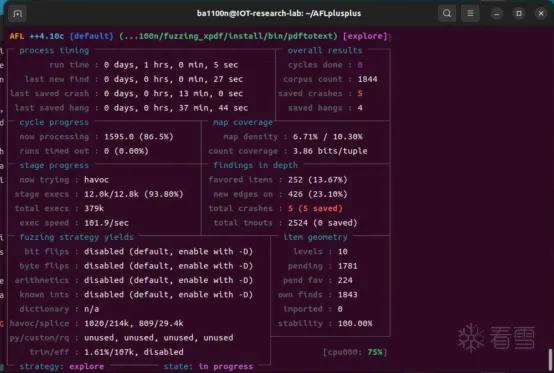 可以观察到,havoc混乱变异占据了93.8%的时间,其平均速度相较于先前的AFL是101.9/sec,提升了三倍 AFL++的混乱变异确实非常有效,发现了426个新的元组(和new edges其实指的是一件事情),而AFL只发现了仅仅一个路径元组。相比之下,每个群体无规则的变异确实避免了陷入局部最优。 最终,AFL++仅仅使用一小时,发现了5个crash点。这些crash点有的可能仅仅造成软件崩溃,而有的内存损坏漏洞,可通过精心构造,变成打开pdf即控制机器的安全漏洞。 # 4 总结 有确定性的变异,即使看似每种变异都有其道理,看似贴合实际,其实,仍然是远远逊色于用算法引导无序变异去进行进化。因为没有足够的随机性,很容易陷入解空间中的局部最优情况,从而发现不了其它的局部最优点。这正是早期Fuzzing变异方式、AFL默认方式的弊端。 # 参考文献 [1] 周忠君,董荣朝,蒋金虎,等.二进制代码安全分析综述[J].计算机系统应用,2023,32(01):1-11.DOI:10.15888/j.cnki.csa.008848. [2] Ruan L, Xu Q, Zhu S, Huang X, Lin X. A Survey of Binary Code Similarity Detection Techniques. Electronics. 2024; 13(9):1715. <mark class="encrypted">56dK9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6V1L8$3W2Q4x3X3g2G2M7X3N6Q4x3V1j5I4x3q4)9J5k6e0x3K6z5e0m8Q4x3V1k6W2L8r3g2U0N6s2u0G2L8X3W2U0M7K6p5K6x3o6V1I4y4K6p5#2</mark> [3] Miller, B. P., Fredriksen, L., & So, B. (1990). An empirical study of the reliability of UNIX utilities. Communications of the ACM, 33(12), 32-44. [4]Zalewski, M. (2007). American Fuzzy Lop (AFL). Available at: <mark class="encrypted">d0bK9s2c8@1M7q4)9K6b7g2)9J5c8W2)9J5c8X3I4U0j5h3#2@1N6h3k6Q4x3X3g2U0L8%4u0W2k6s2g2E0M7q4)9J5k6h3y4^5i4K6u0r3j5h3k6D9i4K6u0r3</mark> [5] K. Serebryany, "Continuous Fuzzing with libFuzzer and AddressSanitizer," 2016 IEEE Cybersecurity Development (SecDev), Boston, MA, USA, 2016, pp. 157-157, doi: 10.1109/SecDev.2016.043. [6] Robert Swiecki. 2017. Honggfuzz: A general-purpose, easy-to-use fuzzer with interesting analysis options. URL: https://github. com/google/honggfuzz (visited on 06/21/2017) (2017). 、 [7] He X, Wang P, Lu K, Zhou X. ObFuzzer: Object-Oriented Hybrid Fuzzer for Binaries. Applied Sciences. 2022; 12(19):9782. <mark class="encrypted">e79K9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6V1L8$3W2Q4x3X3g2G2M7X3N6Q4x3V1j5I4x3q4)9J5k6e0x3K6z5e0m8Q4x3V1k6S2M7s2l9I4x3U0p5&6z5e0M7^5x3R3`.`.</mark> [8] Michel, S. , Triantafillou, P. , & Weikum, G. . (2005). KLEE: A Framework for Distributed Top-k Query Algorithms. Proceedings of the 31st International Conference on Very Large Data Bases, Trondheim, Norway, August 30 - September 2, 2005. DBLP. [9] Alqaradaghi, M., Morse, G., & Kozsik, T. (2022). Detecting security vulnerabilities with static analysis – A case study. Pollack Periodica, 17(2), 1-7. <mark class="encrypted">379K9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6V1L8$3W2Q4x3X3g2G2M7X3N6Q4x3V1j5I4x3q4)9J5k6e0p5#2y4e0k6Q4x3V1j5$3x3o6k6Q4x3X3f1J5x3o6t1I4i4K6u0W2x3o6l9@1y4e0b7`.</mark> [10] Wang, C., Said, M., & Gupta, A. (2011, May). Coverage guided systematic concurrency testing. In Proceedings of the 33rd International Conference on Software Engineering (pp. 221-230). [11] Dang, T., & Nahhal, T. (2009). Coverage-guided test generation for continuous and hybrid systems. Formal Methods in System Design, 34, 183-213. [12] Heuse M, Maier D, Fioraldi A, Eissfeldt H. AFL++: Combining Incremental Steps of Fuzzing Research. <mark class="encrypted">85aK9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6S2k6X3I4H3L8s2g2K6i4K6u0W2M7r3I4#2M7#2)9J5c8R3`.`.</mark> ↩ [13] J. Kennedy and R. Eberhart, "Particle swarm optimization," Proceedings of ICNN'95 - International Conference on Neural Networks, Perth, WA, Australia, 1995, pp. 1942-1948 vol.4, doi: 10.1109/ICNN.1995.488968. [14] Lyu C, Ji S, Zhang C, Li Y, Lee W-H, Song Y, Beyah R. MOPT: Optimized Mutation Scheduling for Fuzzers. In: 28th USENIX Security Symposium (USENIX Security 19). Santa Clara, CA; 2019:1949-1966. <mark class="encrypted">ca5K9s2c8@1M7s2y4Q4x3@1q4Q4x3V1k6Q4x3V1k6%4N6%4N6Q4x3X3g2#2M7$3g2F1K9i4S2Q4x3X3g2G2M7X3N6Q4x3V1k6U0L8$3&6X3k6i4u0W2L8X3y4W2i4K6u0r3N6i4y4W2L8X3W2^5M7$3g2U0N6i4u0A6N6s2V1I4z5g2)9J5c8Y4m8J5k6i4y4W2L8Y4c8S2N6r3W2G2L8W2)9J5c8X3I4&6N6b7`.`.</mark> [15] Weißleder, S. (2010). Test models and coverage criteria for automatic model-based test generation with UML state machines (Doctoral dissertation, Humboldt University of Berlin). [16] Kuznetsov, V., Kinder, J., Bucur, S., & Candea, G. (2012). Efficient state merging in symbolic execution. Acm Sigplan Notices, 47(6), 193-204.
登录后可查看完整内容
冰与火的战歌:Windows内核攻防实战高级班!从零到实战,融合AI与Windows内核攻防全技术栈,打造具备自动化能力的内核开发高手。
最后于
2024-11-11 20:09 被是气球呀编辑 ,原因: 修正部分字符显示
#Fuzz
#Windows
#Linux
收藏
・
19
点赞
・
7
打赏
分享
分享到微信
分享到QQ
分享到微博
赞赏记录
参与人
雪币
留言
时间
wx_晨梦
期待更多优质内容的分享,论坛有你更精彩!
2026-7-16 06:42
eth100
+1
这个讨论对我很有帮助,谢谢!
2026-7-2 20:23
PLEBFE
为你点赞!
2025-3-5 05:10
琳宇
+1
感谢你的贡献,论坛因你而更加精彩!
2024-11-14 19:17
AcheronHana
+1
感谢你的积极参与,期待更多精彩内容!
2024-11-14 10:54
0x指纹
+1
感谢你的积极参与,期待更多精彩内容!
2024-11-13 11:41
pureGavin
+10
谢谢你的细致分析,受益匪浅!
2024-11-11 16:22
查看更多
赞赏
×
1 雪花
5 雪花
10 雪花
20 雪花
50 雪花
80 雪花
100 雪花
150 雪花
200 雪花
支付方式:
微信支付
赞赏留言:
快捷留言
感谢分享~
精品文章~
原创内容~
精彩转帖~
助人为乐~
感谢分享~
最新回复
(
1
)
eth100
雪 币:
305
能力值:
( LV1,RANK:0 )
在线值:
发帖
0
回帖
3
粉丝
0
关注
私信
eth100
2
楼
太棒了
2026-7-2 20:23
0
游客
登录
|
注册
方可回帖
回帖
表情
雪币赚取及消费
高级回复
返回
是气球呀
4
7
发帖
23
回帖
190
RANK
关注
私信
他的文章
[原创]浅析_IO_FILE相关利用、FSOP与House_of_Orange技术
13064
[原创]浅析linux系统加载:从CPU加电到用户态,讲讲BIOS、UEFI、MBR引导、GRUB引导
13404
[原创]浅析Zigbee协议攻击面
8915
[原创]fuzzing原理探究(下):boofuzz背后的生成算法
10885
[原创]fuzzing原理探究(上):afl,afl++背后的变异算法
15134
关于我们
联系我们
企业服务
看雪公众号
专注于PC、移动、智能设备安全研究及逆向工程的开发者社区
看原图
赞赏
×
雪币:
+
留言:
快捷留言
为你点赞!
返回
顶部







