-
-
[原创]记录第一次的so文件逆向分析
-
发表于: 2026-10-24 18:05 637
-

说明:本文由 AI 生成和整理,但里面的分析逻辑是我自己一步步跟下来的。
目标 app:某对 AI
版本:7.8.0 (1820)
参数:登录接口 sign
此 app 没有加壳,所以直接使用 jadx 打开 apk,搜索 sign=。
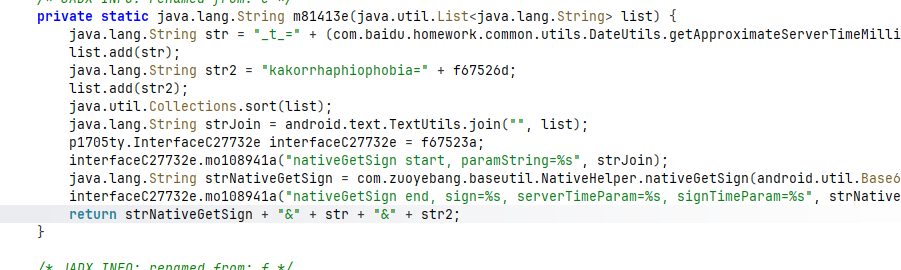
可以看到 nativeGetSign,这个就是签名的函数,hook 验证一下。
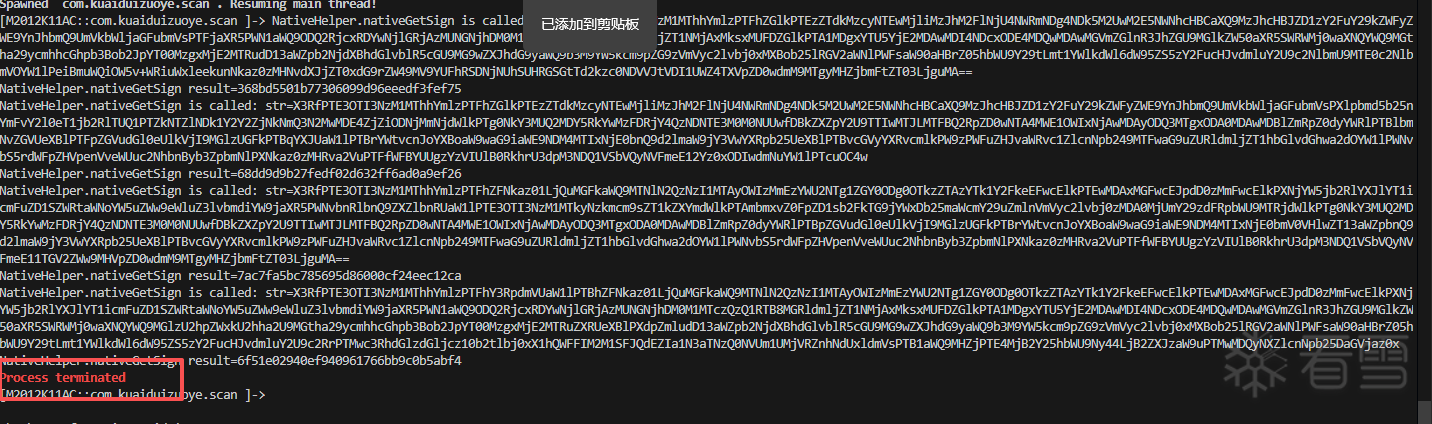
这里怀疑有检测,我使用的是 hluda 的 frida,一上 Java 层 hook 就直接退出了。具体退出原因没有继续定位,直接问 AI,告诉我可以先不使用 Java bridge。
那就改走纯 native 路径。下面脚本完全不调用 Java.perform,只监听 JNI 注册,找到 nativeGetSign 的真实函数地址,打印它的输入和返回字符串。
先把脚本贴出来。这里把前面没有调用的辅助 hook 去掉了,修正了末尾多余的大括号,符号枚举也兼容了一下新旧 Frida API。下面是整理后的版本,只做了语法检查,没有重新上手机跑;截图保留的是前面实际运行时的结果。
这里要在目标方法注册之前把脚本挂上,通常用 spawn 方式启动。要是 app 已经注册完了再 attach,就可能什么也抓不到。不同 Android 版本的 RegisterNatives 符号也可能不止一个,上面是当前定位过程的基础写法,附件里还放了一份增加方法描述符和模块检查的版本。
当我们点击登录,打印信息如下:

下一步就是分析这个 native 函数。我们在开始已经 hook 到了函数的地址,把运行时地址减去模块基址,得到模块内偏移,再去 IDA 里面跳转即可。

IDA Pro 打开这个 so 文件,跳转到 0x23bc。
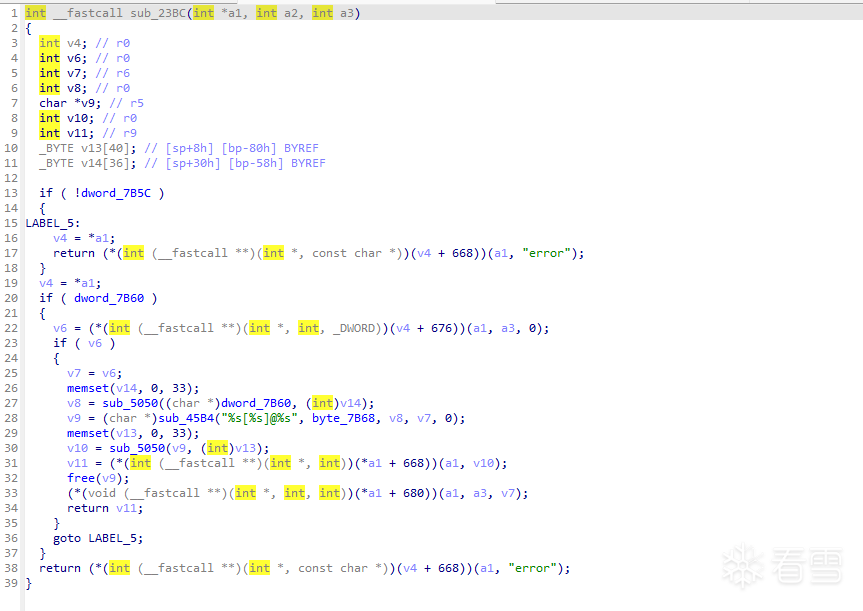
这里可以使用 unidbg 补环境去还原参数,可以参考这篇文章,比我写的好多了。我也是参考的这篇文章。我这里主要是分析纯算法的还原。
后面就按这个顺序往下走:Java 调用链 → JNI 入口 → 数据流 → 算法特征 → 中间值对照 → 独立实现。先看输入从哪里来,再看 so 里面怎么处理,最后拿原始 so 的结果和自己写的代码对照。
前面已经定位到了 libbaseutil.so 的 nativeGetSign,看起来下一步应该直接分析汇编。不过这里还有个问题:这个函数是不是只靠我们传进去的 Base64 就能算出 sign?如果它还读取了别的数据,那些数据又是谁准备的?
先别把 signA、signB 当成已经知道的东西。我们就从前面找到的 nativeGetSign 开始,一步步找到它们。
在 jadx 里打开 com.zuoyebang.baseutil.NativeHelper,选中 nativeGetSign,右键“查找用法”。跟进去是 com.zuoyebang.baseutil.a 的 e(List<String> list)。删去日志后,输入的构造过程可以整理成下面这样:
这里有三个细节:列表中已经是 key=value 形式的字符串,排序后用空字符串连接,中间没有 &;Base64 使用 NO_WRAP,不会插入换行;native 收到的是编码后的完整 String。
所以前面 hook 到的一长串 Base64,可以先解码看看里面有哪些参数。但是自己调用 nativeGetSign 时,还是要传 hook 到的原文,不能把解码后的内容塞进去,不然算的就不是同一个东西了。
Java 调用方还会把 native 返回的 sign 和两个时间参数组合起来。本文分析的是 native 返回的那段十六进制签名,不能把外层组合后的字符串当作 MD5 输出。
接下来对这个 e() 再查找用法,可以看到同一个类的 d(List<String> list)。这里很关键,原代码是:
f58497b 虽然被混淆了,但分支和日志都还在:为真就计算签名,为假就先调用 f(),失败了还会返回 init_error。所以我们有依据把它理解成“是否初始化成功”。顺着 f() 跳进去,signA、signB 就在这里。
f() 先拿到 application 和 cuid,再读两个缓存。下面保留主进程分支的原变量名,方便对照 jadx:
这里不用猜命名,日志直接写着 nativeInitBaseUtil end, signA=%s,后面的参数就是 strNativeInitBaseUtil。也就是说:
strB 对应 signA,strB2 对应 signB。这是 app 自己的日志和缓存键告诉我们的名字,不是看到两段密文后随便起的。注意上面另一句日志虽然也写着 nativeInitBaseUtil start,下一行实际没有再次调用这个 native 方法;判断来源得看赋值和调用,不能只看日志标题。
上面有一行 e.b(strNativeInitBaseUtil),继续跳进去,位置是 com.zuoyebang.baseutil.e.b(String str):
到这里就能看到它发了网络请求。再进入 PlutoAntispam.Input,几个关键位置如下,省略了热修复判断:
把这几次传参接起来:传给 e.b() 的是 signA,buildInput() 又把它放进请求的 data 参数;Net.postSync() 返回 PlutoAntispam 对象,f() 取这个对象的 data 字段赋给 strB2。所以:
这里的路径是 /pluto/app/antispam。完整地址还会经过 host 配置或自定义地址处理,本文先跟参数流,不把路径写成固定域名。服务端内部怎么计算 signB,客户端这几行代码没有告诉我们;目前能确认的是它由这次请求返回。
回到 a.f(),往下就是这一行:
把刚刚对应出来的变量名换进去,就是:
调用成功后,主进程分支会保存它们:
这样两个分支就接上了:第一次没有缓存,先生成 signA,再请求得到 signB;后面有配套缓存,就跳过这次交换,直接把缓存交给 nativeSetToken。这里讨论的是尚未完成初始化时进入 f() 的流程,已经初始化成功时不会每次签名都重新解密缓存。
现在先记住这三件事就够了:signA 由本地 native 生成,signB 从服务端取回,nativeSetToken 接收这一对字符串做初始化。它们里面具体装了什么,要进入这个 native 函数后再分析,不能在这里先假定已经知道。
上面讲的是 app 的正常流程。这次 Unidbg 用的数据,则是从测试设备已有的缓存里读出来的,没有让 Unidbg 重新请求服务端。
文件名也可以从代码追出来:LibPreference.getNameSpace() 返回 LibPreference,PreferenceUtils 用 com.baidu.homework.Preference. 加上这个命名空间,调用 getSharedPreferences()。因此本次主进程缓存文件是:
里面对应两个键,下面省略真实值:
工程里的 scripts/capture_init.py 读取这两个键,写进 captures/init.properties。设备需要能通过 su 读取 app 私有目录。这个脚本里的 cuid 是从本次已抓到的 Base64 入参中提取的,最后由原始 nativeSetToken 检查是否和缓存配套。不要随便拿另一个设备的 cuid 与当前缓存拼在一起。
这里还有一种观察方法:hook nativeInitBaseUtil 的返回值可以看到新 signA,hook nativeSetToken 的入参可以同时看到 cuid、signA、signB。如果走的是缓存恢复分支,可能不会调用 nativeInitBaseUtil,但仍然会调用 nativeSetToken。
看到这里,就知道为什么只加载 so、执行 JNI_OnLoad,再直接调用 nativeGetSign,会返回 error 了。JNI 方法注册好了,不代表它需要的业务数据也初始化好了。
几个容易混的名字先分清楚,后面看 IDA 时按这个表对应:
登录入参中还有一个叫 token 的 HTTP 字段,它和表里的 T 不能因为名字相似就当成同一个值。
<!-- 配图 1:JADX 中 a.e() 的排序、拼接、Base64 和 nativeGetSign 调用。 --> <!-- 配图 2:JADX 中 a.f() 读取 signA/signB 缓存并调用 nativeSetToken 的分支。 --> <!-- 补图:a.d() 中 f() → e() 的初始化检查;e.b() 的 Net.postSync;PlutoAntispam.Input 的 PATH 与 data 字段。 -->
本次分析的是 ARM32 库。RegisterNatives 表里的函数指针包含 Thumb 标志,因此可能看到:
最低位的 1 表示 Thumb 状态,并不是代码真的多偏移一个字节。
用 Frida Interceptor.attach 时保留注册表中的原始函数指针。查看模块内代码位置时,对 ARM32 去掉最低位,然后减去模块基址。
不要把上面的 32 位掩码直接用于 ARM64,它会截断高位地址。本文所有后续代码偏移都对应这一份 ARM32 so,并且没有包含 Thumb 标志。
IDA 默认以 0 为该库的 image base 时,按 G 输入 0x23bc 即可。若数据库被 rebase,需要使用 IDA 当前 image base 加该偏移。这里讨论的是模块内虚拟地址,不能在其他 ELF 中默认把它当成文件偏移。
JADX 中可以确认声明是:
对应的 native 原型可以写成:
在这个 ARM32 样本的入口处,参数关系如下:
jstring 是 JNI 对象引用,不能直接 args[2].readUtf8String()。必须通过 JNI 的 GetStringUTFChars 得到字符指针,读取后再配对调用 ReleaseStringUTFChars。
到了 IDA 里面,经常看不到这些 JNI 函数名,只看到一串强制类型转换。例如这份伪代码里是:
这里的 a1 是 JNIEnv *env,*a1 取出来的是 JNI 函数表的地址。表里面按固定顺序保存指针,可以先这样理解:
当前是 ARM32,每个指针占 4 字节。索引从 0 开始,所以第 169 号槽位距离表头的偏移就是 169 × 4 = 676 字节。反过来看到 +676,就用 676 / 4 = 169 算出索引。
但这里要分清楚:除法只能算出索引,函数名要查 JNI 标准函数表。 打开 JDK 的 jni.h 找 JNINativeInterface_,或者 Android NDK 头文件中的 JNINativeInterface,也可以查看 JNI 官方规范中各函数的 LINKAGE 说明。表头的 4 个 reserved 槽位也要计数,不能从第一个有名字的函数开始数 0。
676 和 0x2a4 是同一个数的两种写法:2 × 256 + 10 × 16 + 4 = 676,不涉及别的转换。
把上面那条长调用拆开,其实只有三步:
用常见的 JNI C++ 写法表达就是:
a1 是 env,a3 是输入的 jstring,最后的 0 表示不接收 isCopy 信息。原伪代码中的 v4 被识别成整数地址,所以 v4 + 676 是直接加 676 字节;如果后来改成了带类型的指针表达式,还要注意 C 的指针加法会按元素大小计算。
如果换成 ARM64,每个指针是 8 字节,要用对应的字节偏移除以 8。JNI 索引仍然是 167、169、170,对应偏移会变成 1336、1352、1360,不能照搬 ARM32 的数值。
日志中的 returned 0x15、returned 0x19 同样是 JNI 引用值。它们不是签名内容,签名要通过这个引用继续读取。
Java 这边已经看到了三个方法,接下来要确认它们分别对应 so 里的哪个函数。不能看到 sub_21B0 就直接说它是 nativeSetToken,需要有注册表或运行日志作为依据。
在 IDA 中按 Shift+F12 打开 Strings,搜索 nativeSetToken。双击这个字符串,再选中字符串地址按 X 查看交叉引用。当前文件中能找到 JNI 注册表里引用它的地方。ARM32 的 JNINativeMethod 每项是 12 字节,结构如下:
这份文件中,三项内容可以对应成:
这里的地址以 IDA image base 为 0 为前提。表里的最后一个数带 Thumb 标志,右边一列才是我们按 G 跳转时使用的代码地址。若 IDA 没有自动列出交叉引用,可以直接跳到这份样本的 0x6990,按三个 32 位值检查方法名、描述符、函数指针;这个地址不能拿去套别的版本。
确认之后,在三个函数入口按 N 重命名,名称加个 jni_ 前缀也行,例如 jni_nativeSetToken。名字是我们根据注册关系补上的,IDA 原先可能只显示 sub_21B0。
接着看 NativeHelper 里的声明:
把 Java 调用方已经确认的参数含义补进去,第二个函数可以理解成:
注意它有 6 个 native 参数:Java 里的 4 个显式参数前面,还要加上 env、clazz。在 ARM32 刚进入函数、还没执行 push 时,位置是:
如果沿用前面的 Frida JNI 字符串读取函数,入口处就分别用 readJniString(args[0], args[3])、readJniString(args[0], args[4])、readJniString(args[0], args[5]) 读 cuid、signA、signB。nativeGetSign 的输入才是 args[2],不能把它的位置直接照搬到初始化函数。
IDA 反编译可能没有自动识别这么多参数,需要结合汇编确认。不要把反编译器推测出来的四参数原型当成最终结论。这里先把对应关系记下来,第 8 节会实际跟踪栈上的 signA、signB。
<!-- 补图:IDA 的 nativeSetToken 字符串、0x6990 注册表项,以及去掉 Thumb 标志后的 0x21b0 函数。 -->
接下来回到 IDA,按 F5 看伪代码。类型不对或者变量看不明白,就切回汇编确认。这里我先看输入经过了哪些函数、返回值又传给了谁,不用上来就把所有指令翻译一遍。
下面保留这次 IDA 输出里的变量名,只省略局部变量声明,方便跟自己窗口里的代码一一对应:
前面查过 JNI 表,现在就能把三个间接调用读懂:+676 取输入字符串,+668 创建返回字符串,+680 释放借出的字符指针。v7 = v6,所以 v7 就是输入字符指针;v9 是中间拼接出来的字符串,最后用 free(v9) 释放。
就算暂时完全不知道 signA、signB,也可以从这里开始分析。 先发现第一次处理的数据来自全局变量,再去找它的写入者。第 4 节是提前把 Java 侧的来源讲清楚,不是说分析这个函数之前就必须猜到两个缓存的名字。
按 G 跳到 0x23bc,按 F5。先看返回 error 的分支,再看成功分支的两次 sub_5050。函数开头会检查初始化相关状态和一个全局指针是否为空,不满足条件时返回 error。
然后在汇编里定位 0x2402:这是 JNI GetStringUTFChars 的间接调用。它返回后,0x240e 的 mov r6, r0 把输入字符指针保存到 r6。后面 0x2434 又把 r6 传给拼接函数,所以这一条是我们传进来的 Base64。
再看 0x241e 的 ldr r0, [r5], #8:第一次 sub_5050 用的是从全局位置加载的数据,并不是刚刚存到 r6 的输入。此时我们还不知道这个全局数据的内容,先标成 global_material。别一上来就把它命名成 HTTP token,等找到写入者后再确定。
把释放内存、栈保护这些先放一边,核心数据流整理下来就是下面这样。这里的伪代码是为了说明流程重新整理的,变量也起了方便理解的名字,不是直接复制的 IDA 输出:
看到这里,先记下几个问题:sub_5050 到底做了什么,sub_45B4 是不是只负责拼字符串,byte_7B68 的内容是什么,以及 dword_7B60 是谁写进去的。接下来逐个跟。
对应汇编中,下面几处最有价值:
ARM32 普通函数调用的前四个参数通过 r0~r3 传递。因此在 0x243c 调用之前,看这四个寄存器就能知道拼接函数拿到了哪些数据。
注意:断点停在调用指令之前,r0 表示入参;停在调用之后,r0 才表示返回值。把这两种位置混淆,很容易把错误的地址当成字符串读取。
<!-- 配图 3:nativeGetSign 的伪代码,标出两次 sub_5050 和中间的 sub_45B4。 -->
前面两个输出缓冲区都清了 33 字节,看起来像“32 个十六进制字符 + 一个结束符”。这可以作为怀疑 MD5 的线索,但单靠长度还不能确认。
双击 sub_5050,继续进入它调用的初始化和轮运算函数,可以看到下面这些初始化常量:
这几个常量看着就很像 MD5。不过不能看到常量就直接下结论,我们继续往下看:按 64 字节分块更新,填充到块内第 56 字节附近,追加 8 字节长度,最后把 16 字节摘要用 %02x 一个个输出。
再把它实际收到的输入拿出来,用 Python 的 hashlib.md5 算一下,输出也能对上。这样静态特征和实际结果都有了,就可以把 sub_5050 改名为 md5_hex,后面看起来也方便。
这里要区分:digest() 是 16 字节二进制,hexdigest() 是 32 字符十六进制文本。后续拼接使用的是小写 hexdigest()。
sub_45B4 先计算字符串长度并分配内存,再通过 vsnprintf 格式化,最后返回构造的字符串。
签名路径传入的格式是:
它的三个 %s 分别对应固定前缀、第一次 MD5 的结果和原始输入。
在 byte_7B68 上按 X 找写入位置,再跟到初始化函数。这里并不是直接摆着一个字符串,而是用立即数写出来的。IDA 按 G 跳到 0x46ec,可以看到:
先把 R0 看成目标缓冲区地址。第一条把 R1 设成 0x2a,第二条 STRB 只写一个字节,写到 R0 + 4,相当于:
再看 MOVW 和 MOVT。前者把立即数放进低 16 位,并将高 16 位清零;后者替换高 16 位,保留低 16 位。因此:
最后 STR R1, [R0] 把这个 32 位整数的 4 个字节写进缓冲区。当前 ELF 使用小端序,低位字节放在低地址,所以按地址从低到高读到的是:
这是按字节排列,不能把十六进制数字逐个倒着写。再查 ASCII 表:
这样才得到 8&%d*,不是看到一个整数就直接猜字符串。
还有一步不能省:这个函数只说明它往 R0 写了数据,怎么确认 R0 就是 0x7b68?选中 sub_46EC 按 X 看调用者,当前调用点在 0x2186:
往前追可以确认这里 R4 为 0x7b60,R11 为 0。具体来说,0x2134 取出 literal 0x5a20,0x213c 加上当时的 PC 值 0x2140,得到 0x7b60;0x2106 则把 R11 清零,IDA 也可能将 R11 显示为 fp。
因此传进去的 R0 是 0x7b60 + 8 = 0x7b68,而 STRB.W 往 0x7b60 + 0xd = 0x7b6d 写了零。初始化完成后的内存就是:
最后那个 0 是 C 字符串结束符。静态打开 IDA 时这些初始化指令还没执行,目标位置可能仍显示零;我们是根据写入指令还原执行后的内容。动态读取拼接参数得到的前缀也与此一致。
这里的 %d 属于作为 %s 参数传入的数据,不会被 vsnprintf 再次解释成数字占位符。
将初始化状态中的 10 字节签名材料暂记为 T,原始 JNI 入参记为 I,就得到:
对于本文的 ASCII/Base64 输入,可以直接写成:
到这里签名公式就出来了,不过代码里还差一个 token。直接把 hook 到的值写死,确实能先跑起来,但这个值到底从哪里来的还没弄清楚。所以继续往前找初始化流程。
<!-- 配图 4:sub_5050 的 MD5 初值、长度填充和 %02x 输出。 --> <!-- 配图 5:0x46ec 的立即数写入,以及拼接函数的三个参数。 -->
现在我们已经知道 signA、signB 是 Java 传给 nativeSetToken 的。但它俩和第一次 MD5 用到的全局数据有什么关系?这一节就把中间缺的这段接起来。
前面伪代码里已经出现了 dword_7B60,直接双击它,或者按 G 输入 0x7b60,就能跳到变量本身。这里的 dword 是 IDA 自动起名时标出的 4 字节数据,7B60 是地址。
但是这 4 字节保存的是指针,不是那 10 字节签名材料本身。要区分地址和地址里保存的值:
所以 (char *)dword_7B60 是把变量里存的值当成字符指针。接下来选中变量名按 X 看引用,重点找赋值。几种代码含义不一样:
回到 nativeGetSign 的汇编,关注下面几条,省略号表示中间还有别的指令:
这里有个地址计算,不要直接跳过:0x5772 + 0x23ee = 0x7b60。所以 r5 最开始指向 0x7b60,这里存着第一次 MD5 所用字符串的指针。ldr r0, [r5], #8 会先读指针,再把 r5 加 8;于是后面 r5 变成 0x7b68,正好是固定前缀的地址。
在 IDA 按 G 跳到 0x7b60,可以先命名为 g_sign_material_ptr,再按 X 看引用,重点找写入它的位置。这里是运行时状态,静态打开 so 看到零值,并不代表 app 运行时也为零;IDA 不会凭空显示服务端交换后才出现的数据。
ARM 的 PC 相对寻址有时不会生成完整的全局交叉引用。遇到这种情况,我们已经从注册表知道 nativeSetToken 在 0x21b0,可以进入它,用同样的方法核对地址。当前样本中有:
这样就有实际的读写关系了:nativeSetToken 写进 0x7b60 的指针,正是 nativeGetSign 后面取来计算 MD5 的指针。它们之间不是靠函数名猜出来的。
前面已经确定入口 [sp] 是 signA,[sp+4] 是 signB。现在看 0x21b0 的函数开头:
第一条压入 5 个寄存器,也就是 20 字节。设入口时的 sp 为 entry_sp,第二条执行后:
往下正好看到对应加载:
JNI 返回的字符指针会被复制,然后释放 JNI 借出的字符串。后面使用的 signA 副本在 r5,signB 副本在 r11,IDA/反汇编器也可能把 r11 显示成 fp。现在才能有依据地给对应变量改名,不能看到某个长字符串指针就先猜它是 signA。
这次 IDA 伪代码里,相关变量叫 v8、v9、v10、v11:
sub_2878() 被显示成无参数,是反编译器的原型不完整。回汇编看,调用时 R0 里仍是刚取得的字符指针,函数会复制字符串。不能因为 F5 显示了空括号,就认为它没有输入。
对应起来就是 a5 → v8 → v9、a6 → v10 → v11。即使不知道 signA、signB 的名字,仍能先记成“第 5 个参数的副本”和“第 6 个参数的副本”,然后继续往下追。
在这个函数里面先追 signA:它在 0x2236 传给 sub_2DA4,结果在 0x224a 传给 sub_435C。再追 signB:它在 0x2306 调用同一个 sub_2DA4,在 0x2318 调用同一个 sub_435C。
这里先把 sub_2DA4 记成“编码转换候选”,把 sub_435C 记成“解密候选”。原因是第一层输出了字节数据,第二层还接收一个 8 字节字符串作为参数,返回结果随后会被 strlen、strcmp 检查。此时还不能只凭这个就认定 DES,第 9 节才进入函数内部确认分组、轮数和表。
第一次调用 sub_435C 前,r1 来自只读数据地址 0x116e。在 IDA 按 G 跳过去,可以看到 @fG2SuLA,所以这是我们后面解 signA 使用的固定密钥来源。第二次的 r1 来自前面 sub_45B4 拼出来的字符串,怎么拼的放在 8.5 节展开。
两层处理之后,程序继续切字段、检查长度和比较字符串。结合下面的字段分析,以及第 9、10 节的算法和中间值验证,我们才把整个过程整理成下面的伪代码。这里是整理后的结果,不是刚按 F5 就能看到这些变量名:
实际还包含 CUID、证书相关信息和长度等校验;这里先展示签名材料的来源。
在 sub_21B0 的伪代码里,最直接的写入证据就是下面这一段。这里先从末尾往前读:
_QWORD 是 8 字节,_WORD 是 2 字节。它先取 v20 + 12 开始的 8 字节,再取 v20 + 20 开始的 2 字节,连续复制到新内存的偏移 0 和 8。因此可以整理为:
我们要找的材料,就是 v20[12:22]。再往前找 v20 的赋值:
这说明它来自第 6 个参数对应的字符串,经过编码转换和处理后得到的结果。v19 >> 2 是长度除以 4,与前面的缓存编码关系吻合。结合原代码中的 v14、v20,现在两条路径可以写成:
signA 解密完成后,代码会在明文偏移 0x11、0x33 处写入 NUL,使对应字段可以单独传给 strlen、strcmp。再结合 +7、+0x13、+0x35 等指针运算,可以推断出字段边界。
用运行时明文验证后,signA 的结构为:
signB 的结构则是:
长度为 10 + 2 + 10 = 22 字节。native 会比较它的前 10 字节与 signA 中的 challenge,随后把最后 10 字节复制到新分配的内存中,保存供 nativeGetSign 使用。
对应 IDA 里可以逐个核对:0x2336 检查总长度 0x16,0x2348 把明文指针加 0x0c 放入 r6,0x2352 检查后半段长度 0x0a。比较前半段成功后跳到 0x237c,申请 0x0b 字节空间,再用 0x2386 到 0x238e 的加载、存储指令复制这 10 字节,最后在 0x2392 保存指针。
到这里,前面暂时叫作 global_material 的数据就有来源了:它是 signB 明文偏移 12 开始的 10 字节。文中用 T 表示它。现在再回到 nativeGetSign 的第一次 MD5,就能明确说它算的是 MD5(T)。
同一个 nativeSetToken 中也会取 Android 安装包证书信息,比较 signA 的证书摘要和本地证书计算结果。此次 Python 还原面向已经由原始 APK 验证有效的缓存,校验 CUID 和 challenge,但没有重新实现 Android 包证书校验环境。
在 0x22f0 附近,程序暂时把 signA 明文 +0x0c 的位置写为 NUL,对应这段伪代码:
从偏移 7 开始,到偏移 12 前停止,正好 12 - 7 = 5 字节。challenge 从 +7 开始,所以这里截取的是 challenge 的前 5 字节。
接着用 %s%s 拼上固定字符串 #G4,形成 8 字节密钥,再恢复原来的明文字节。
因此它不是完整的 10 字节 challenge 作为密钥,而是:
这里就是先把字符串临时截断,用完再恢复。要是只看最后的字符串,很容易漏掉中间只取了 5 个字节这一步。
<!-- 配图 6:nativeSetToken 中 signA 解密、字符串截断和比较的位置。 --> <!-- 配图 7:截取 challenge 前五字节并拼接 #G4。 -->
本次缓存中的 signA 长 352 字符,signB 长 96 字符。每两个字符只会是 00 到 0f,这与普通任意字节的 hex 表示不同。
进入 0x2da4 及其调用的 0x2ca8,可以看到:每两个字符取第二个字符,查出对应的四个 bit,然后把连续八个 bit 按低位优先组合成一个字节。
可以分两步理解:
例如人造输入 0001:
而普通 bytes.fromhex('0001') 会得到两个字节 00 01,两者显然不同。
对应 Python:
所以 signA 解码后是 88 字节密文,signB 解码后是 24 字节密文。先验证这一层,再分析分组算法,可以避免把编码错误误判为密码算法错误。
这里不能直接写一句“看出来是 DES”就结束。我们从 sub_435C 往里面走,看每个判断的依据。
根据上一层调用,三个参数可以先对应成:
先看它怎么处理 a2:
IDA 把 a2 推成了 int *,所以每次取 4 字节,两次共取 8 字节。这里不是说密钥本来就是两个整数,只是编译器按两个 32 位值搬运。
接下来的长循环一直在做 & 1、& 2、& 4 和移位。把那些指针表达式整理一下,就能看出它在拆 bit:
例如密钥中的一个字节是 0x01,得到的就是 [1,0,0,0,0,0,0,0],也就是 LSB-first。8 个密钥字节被展开成 64 个 0/1,每个逻辑 bit 用一个 byte 保存。
伪代码里可能把这块栈空间显示成 v23[7] 和一个单独的 v24,但循环实际连续写了 64 字节。这是局部变量边界没有恢复好,不能按 [7] 去理解算法,也不能仅凭这个显示就判断原程序越界。
然后是:
这里的 768 很有特点:16 × 48 = 768。DES 正好有 16 轮,每轮用 48 bit 轮密钥;这份实现每个 bit 占一字节,因此轮密钥数组占 768 字节。现在可以怀疑 sub_3DE4 在生成轮密钥,但还要进去确认,不能只按数组大小认算法。反编译显示的第三个实参是否有意义,也要以被调函数实际读取哪些寄存器为准。
主循环则每次取两个 DWORD,交给 sub_406C,再写回两个 DWORD:
也就是每次处理一个 8 字节分组。8 字节密钥、8 字节分组、疑似 16×48 bit 轮密钥,几个线索放在一起就很像 DES。真正要确认,还得继续看两个子函数。
IDA 跳到 0x3de4,看几个循环的边界和访问的表:
轮转表内容是:
它和 DES 的轮转安排一致。再结合 PC1、PC2 的内容,就能把这部分识别成 DES 的密钥调度。注意“属于这个结构”和“每个表项都标准”是两个判断,PC2 的差异下一节单独比较。
继续双击 sub_406C。它的参数是一个 8 字节输入、轮密钥数组、8 字节输出地址。这里不负责去填充。
刚打开会看到不少 int64x2_t、n128_u8、veorq_s64,先别被这些名字绕进去:
这里一个 byte 保存一个逻辑 bit,所以一次操作 16 字节,相当于同时处理 16 个逻辑 bit。向量指令只是编译器加快搬运和异或,不是另一种密码算法。
开头的循环还是把每个输入字节低位在前地拆开,共得到 64 个 bit。接着是:
这里的 a9 是 IDA 数据标签,不是函数的第九个参数。4 * i 表示每个表项占 4 字节,整个操作相当于:
在 IDA 双击 a9,这份样本对应 0x11f0。它的开头是:
样本每项比标准文档少 1,是因为数组从 0 开始编号。表内容能对上,才把它标成 IP 初始置换。
v42.n128_u8[i] 看起来只有一个 16 字节向量,却能访问到 63,也是反编译器拆分连续栈缓冲区导致的。按这份栈布局,后面可以把 v42、v43 对应的 32 字节看成左半 L,把 v44、v45、v46 对应的 32 字节看成右半 R。
轮循环里有这几行:
第一个使用的是 a2 + 48 × 15,然后是第 14 组,最后是第 0 组。0 这一轮也执行,所以总共 16 轮。结合前面按正序生成的轮密钥,这里按 15 → 0 倒序使用,就是 DES 的解密方向。
每轮先把右半 R 复制到从 v39 开始的临时区域,再执行:
也就是 expanded[j] = right[E[j]]。dword_1AF0 开头是:
这是零基下标的 E 扩展表,重复选取部分 bit,把 32 bit 扩展为 48 bit。后面三次 veorq_s64,每次 16 字节,共处理 48 字节:
整理后就是 expanded[j] ^= roundKey[j],即 E(R) XOR K。
紧接着调用 sub_3340(&v39)。函数名看不出用途,要继续进入看取位和查表。里面每次取 6 个 bit:
查表可以表达成:
结果是 0~15,再从高位到低位展开成 4 个 bit。共处理 8 组,因此是 8 × 6 = 48 bit 输入、8 × 4 = 32 bit 输出。
表在 0x12f0,第一组 S-box 第一行是:
这些值和 DES S1 第一行一致,取行列的方式也一致。这是识别 S-box 的实际依据,不是看见一个查表函数就直接改名。
S-box 后还有一次 32 bit 的查表:
冰与火的战歌:Windows内核攻防实战高级班!从零到实战,融合AI与Windows内核攻防全技术栈,打造具备自动化能力的内核开发高手。
赞赏

|

- [原创]记录第一次的so文件逆向分析 583
- [求助]提问 IDA8.3打开so文件报错 1663



